El ingeniero de fiabilidad de sitios (SRE) es un puesto relativamente nuevo —normalmente dentro de los equipos de ingeniería u operaciones— centrado, como cabría esperar, en mantener la fiabilidad del sitio. Por lo general, esto implica garantizar la disponibilidad de las aplicaciones, aunque también incluye su rendimiento. Es lógico, ya que hoy en día la mayoría de los usuarios finales consideran que una aplicación que no responde no está disponible.
Al consultar el informe de SRE de Catchpoint de 2018, me llamaron la atención los gráficos que comparaban los indicadores de nivel de servicio con las métricas de SRE. Normalmente, cuando la «disponibilidad» aparece como indicador de nivel de servicio de primer nivel, también se incluye el «tiempo de actividad» o el «tiempo de inactividad» como métrica. Sin embargo, no ocurre así con los SRE de esta encuesta.
Cuando se les preguntó qué indicadores de nivel de servicio eran los más importantes para sus servicios, una abrumadora mayoría del 84 % señaló la «disponibilidad para el usuario final» como el principal. La latencia quedó en segundo lugar con un 61 %, seguida de cerca por la tasa de errores, con un 60 %. El rendimiento —descrito en el informe como el tiempo de respuesta para el usuario final— obtuvo un impresionante 58 % de las respuestas.
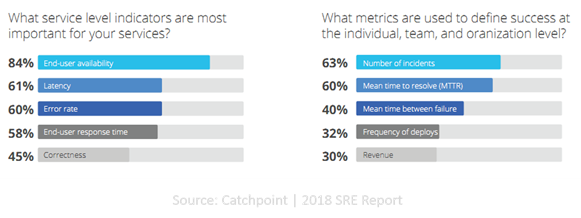
Ahora, fíjese en las métricas utilizadas para definir el éxito. En el mundo de la infraestructura y las operaciones, estamos más acostumbrados a ver métricas como el «tiempo de actividad» y expresiones llamativas como «cinco nueves».
Los SRE, en cambio, suelen medir el éxito en función de la tasa de incidentes y el MTTR. Dado que el mismo informe señalaba que el 41 % de los SRE habían desempeñado el puesto de «ingeniero de DevOps» antes de convertirse en SRE, esto no debería sorprendernos. El propio enfoque DevOps presta más atención al MTTR que al cálculo del tiempo de actividad, porque se da por sentado que habrá periodos de inactividad. La clave está en minimizarlos resolviendo los incidentes rápidamente, en lugar de perder el tiempo intentando evitarlos por completo.
Aun así, los lectores más perspicaces observarán que, al minimizar el MTTR, también se minimiza el tiempo de inactividad. Cuanto más rápida sea la resolución, menor será el tiempo de inactividad.
La sutil diferencia entre ambos es que las personas tienden a optimizar aquello por lo que se las evalúa. Si se te evalúa por las líneas de código, escribirás muchas líneas de código, las necesites o no. Si se te evalúa por los incidentes de seguridad, lo bloquearás todo y gritarás «NO» ante cualquier cambio que pueda propiciar una brecha de seguridad. Si se evalúa al personal por el tiempo de actividad, el equipo de operaciones se centrará en mantener los sistemas en funcionamiento y disponibles, pero no en diseñar e instrumentar sistemas y aplicaciones que reduzcan el MTTR.
Este es uno de esos aspectos «culturales» de DevOps —un cambio en la forma de abordar las operaciones— que debe trasladarse a NetOps. Si seguimos optimizando únicamente la disponibilidad, perderemos la oportunidad de implantar mecanismos de alerta y observabilidad (como la monitorización y un registro exhaustivo) que reduzcan el tiempo medio de resolución y nos permitan alcanzar nuestro objetivo de minimizar el tiempo de inactividad.
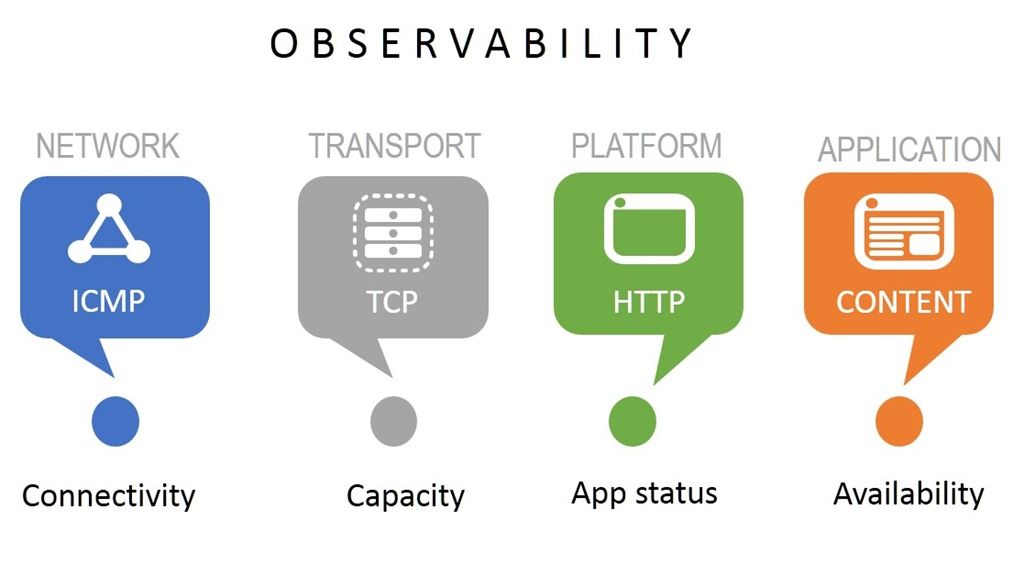
Revisar los registros —incluso los centralizados— no es una forma eficaz de llegar a la raíz de un problema y resolverlo. La supervisión en tiempo real y las alertas sobre variables clave que afectan a la disponibilidad, como la capacidad, la conectividad y el rendimiento a lo largo de toda la ruta de datos (red, infraestructura y aplicación), reducirán invariablemente el tiempo necesario para resolver las incidencias al permitir detectar los sistemas o servicios cuyo funcionamiento se esté degradando o que hayan fallado de forma repentina.
NetOps debe adoptar este enfoque en lo que respecta a la fiabilidad del proceso de producción, porque, en general, es una forma más eficaz de afrontar los fallos inevitables y está en consonancia con sus homólogos de DevOps. Al fin y al cabo, hay una razón por la que solo aspiramos a los cinco nueves, ¿no? Porque reconocimos que los fallos ocurren por mucho que nos esforcemos y que la perfección es imposible.
Pasar del tiempo de actividad/inactividad al MTTR como métrica de éxito fomenta la colaboración entre equipos y el uso de herramientas de observabilidad a lo largo de todo el proceso de producción. No es casualidad que las herramientas de monitorización y alertas encabezaran la lista de «herramientas imprescindibles» para los SRE en la encuesta. La observabilidad (con el objetivo de alertar sobre errores o incidentes), sumada a la colaboración, es una fórmula más eficaz para garantizar que todos —NetOps, DevOps y también los desarrolladores de aplicaciones— puedan cumplir su objetivo de mantener las aplicaciones rápidas y disponibles.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.