Nota del editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios (este artículo)
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios
- Cómo elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puedes descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: Microservicios: del diseño al despliegue. Además, echa un vistazo a la nueva página de soluciones de microservicios.
Este es el tercer artículo de nuestra serie sobre el desarrollo de aplicaciones con una arquitectura de microservicios. El primer artículo presenta el patrón de arquitectura de microservicios, lo compara con el patrón de arquitectura monolítica y analiza las ventajas y los inconvenientes de utilizar microservicios. El segundo artículo describe cómo los clientes de una aplicación se comunican con los microservicios a través de un intermediario conocido como puerta de enlace de API. En este artículo, analizamos cómo se comunican entre sí los servicios de un sistema. El cuarto artículo explora el problema estrechamente relacionado del descubrimiento de servicios.
Introducción
En una aplicación monolítica, los componentes se invocan entre sí mediante llamadas a métodos o funciones del propio lenguaje de programación. En cambio, una aplicación basada en microservicios es un sistema distribuido que se ejecuta en varias máquinas. Cada instancia de un servicio suele ser un proceso. Por consiguiente, como muestra el siguiente diagrama, los servicios deben interactuar mediante un mecanismo de comunicación entre procesos (IPC).
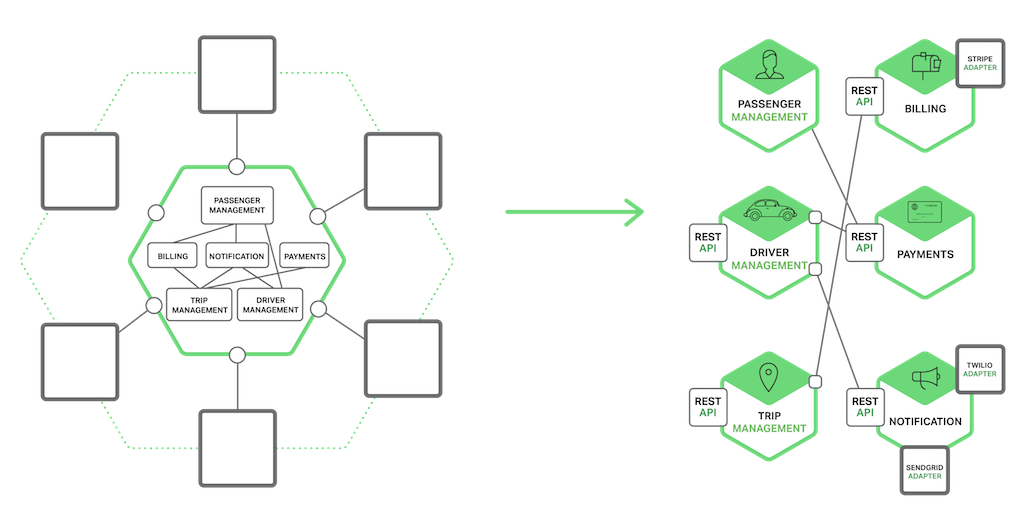
Más adelante veremos tecnologías de IPC concretas, pero primero exploremos diversas cuestiones de diseño.
Estilos de interacción
Al seleccionar un mecanismo de IPC para un servicio, resulta útil pensar primero en cómo interactúan los servicios. Existen diversos estilos de interacción cliente⇔servicio. Se pueden clasificar según dos dimensiones. La primera dimensión es si la interacción es de uno a uno o de uno a muchos:
- Uno a uno – Cada solicitud del cliente es procesada por una única instancia del servicio.
- Uno a muchos – Cada solicitud es procesada por varias instancias del servicio.
La segunda dimensión es si la interacción es síncrona o asíncrona:
- Síncrona – El cliente espera una respuesta rápida del servicio e incluso puede bloquearse mientras espera.
- Asíncrono – El cliente no se bloquea mientras espera una respuesta y esta, si la hay, no se envía necesariamente de inmediato.
La siguiente tabla muestra los distintos estilos de interacción.
| Uno a uno | Uno a muchos | |
|---|---|---|
| Síncrono | Solicitud/respuesta | — |
| Asíncrono | Notificación | Publicación/suscripción |
| Solicitud/respuesta asíncrona | Publicación/respuestas asíncronas |
Existen los siguientes tipos de interacciones uno a uno:
- Solicitud/respuesta – Un cliente envía una solicitud a un servicio y espera una respuesta. El cliente espera que la respuesta llegue en un plazo razonable. En una aplicación basada en hilos, el hilo que realiza la solicitud puede incluso bloquearse mientras espera.
- Notificación (también conocida como solicitud unidireccional) – Un cliente envía una solicitud a un servicio, pero no se espera ni se envía ninguna respuesta.
- Solicitud/respuesta asíncrona – Un cliente envía una solicitud a un servicio, que responde de forma asíncrona. El cliente no se bloquea mientras espera y está diseñado teniendo en cuenta que la respuesta puede tardar en llegar.
Existen los siguientes tipos de interacciones de uno a muchos:
- Publicación/suscripción – Un cliente publica un mensaje de notificación que es consumido por cero o más servicios interesados.
- Publicación/respuestas asíncronas – Un cliente publica un mensaje de solicitud y, a continuación, espera durante un tiempo determinado las respuestas de los servicios interesados.
Cada servicio suele utilizar una combinación de estos estilos de interacción. Para algunos servicios, basta con un único mecanismo de comunicación entre procesos (IPC). Otros pueden necesitar una combinación de mecanismos de IPC. El siguiente diagrama muestra cómo podrían interactuar los servicios de una aplicación para solicitar taxis cuando el usuario solicita un trayecto.
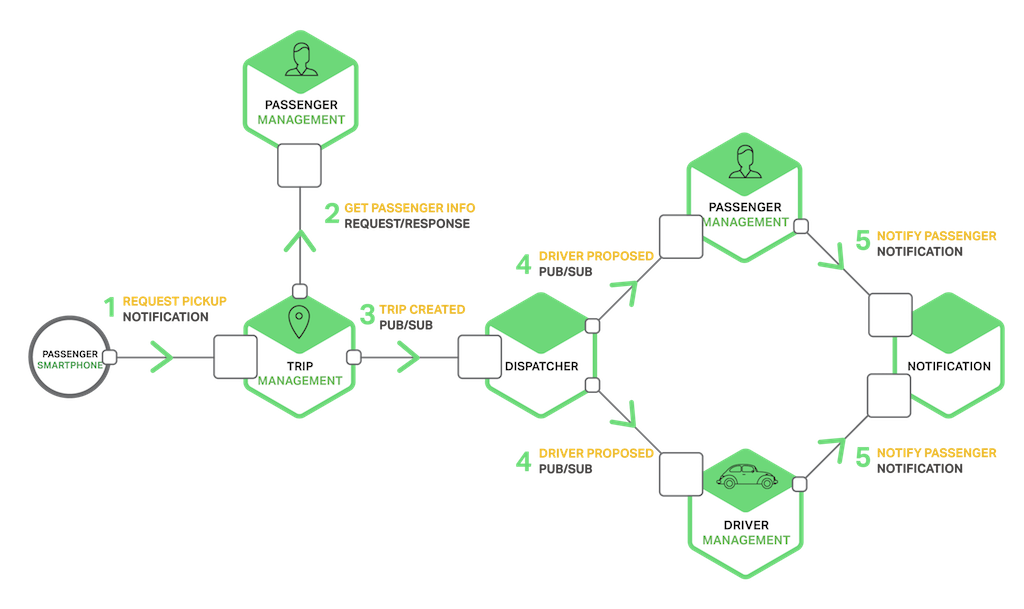
Los servicios utilizan una combinación de notificaciones, solicitud/respuesta y publicación/suscripción. Por ejemplo, el teléfono inteligente del pasajero envía una notificación al servicio de gestión de viajes para solicitar una recogida. El servicio de gestión de viajes comprueba que la cuenta del pasajero esté activa mediante una interacción de solicitud/respuesta con el servicio de pasajeros. A continuación, el servicio de gestión de viajes crea el viaje y utiliza el modelo de publicación/suscripción para notificar a otros servicios, incluido el de asignación, que localiza a un conductor disponible.
Ahora que hemos visto los estilos de interacción, veamos cómo definir las API.
Definición de API
La API de un servicio es un contrato entre el servicio y sus clientes. Independientemente del mecanismo de IPC que elijas, es importante definir con precisión la API de un servicio mediante algún lenguaje de definición de interfaces (IDL). Incluso hay argumentos sólidos a favor de utilizar un enfoque centrado primero en la API para definir los servicios. El desarrollo de un servicio comienza con la redacción de la definición de la interfaz y su revisión con los desarrolladores de los clientes. Solo después de varias iteraciones sobre la definición de la API se implementa el servicio. Realizar este diseño de antemano aumenta las probabilidades de crear un servicio que satisfaga las necesidades de sus clientes.
Como veremos más adelante en este artículo, la naturaleza de la definición de la API depende del mecanismo de IPC que utilices. Si utilizas mensajería, la API se compone de los canales y los tipos de mensajes. Si utilizas HTTP, la API se compone de las URL y los formatos de las solicitudes y las respuestas. Más adelante describiremos algunos IDL con más detalle.
Evolución de las API
La API de un servicio cambia inevitablemente con el tiempo. En una aplicación monolítica, suele ser sencillo modificar la API y actualizar todos los componentes que la invocan. En una aplicación basada en microservicios, resulta mucho más difícil, incluso si todos los consumidores de la API son otros servicios de la misma aplicación. Por lo general, no se puede obligar a todos los clientes a actualizarse al mismo tiempo que el servicio. Además, probablemente se vayan a desplegar nuevas versiones de un servicio de forma gradual, de modo que las versiones antiguas y las nuevas se ejecuten simultáneamente. Es importante contar con una estrategia para abordar estas cuestiones.
La forma de gestionar un cambio en una API depende de la magnitud del cambio. Algunos cambios son menores y compatibles con la versión anterior. Por ejemplo, se pueden añadir atributos a las solicitudes o a las respuestas. Conviene diseñar los clientes y los servicios de modo que respeten el principio de robustez. Los clientes que utilicen una API antigua deberían seguir funcionando con la nueva versión del servicio. El servicio proporciona valores predeterminados para los atributos que faltan en las solicitudes y los clientes ignoran los atributos adicionales de las respuestas. Es importante utilizar un mecanismo de IPC y un formato de mensajería que permitan hacer evolucionar las API con facilidad.
Sin embargo, a veces es necesario realizar cambios importantes en una API que rompen la compatibilidad con versiones anteriores. Como no puedes obligar a los clientes a actualizarse de inmediato, un servicio debe admitir versiones anteriores de la API durante un tiempo. Si utilizas un mecanismo basado en HTTP, como REST, una opción es incluir el número de versión en la URL. Cada instancia del servicio podría gestionar varias versiones simultáneamente. Otra opción sería desplegar distintas instancias, cada una de las cuales gestionase una versión concreta.
Gestión de fallos parciales
Consideremos, por ejemplo, el escenario de los detalles del producto de ese artículo. Imaginemos que el servicio de recomendaciones no responde. Una implementación ingenua de un cliente podría quedarse bloqueada indefinidamente a la espera de una respuesta. Esto no solo daría lugar a una mala experiencia de usuario, sino que, en muchas aplicaciones, consumiría un recurso valioso, como un hilo. Con el tiempo, el entorno de ejecución se quedaría sin hilos y dejaría de responder, como se muestra en la siguiente figura.
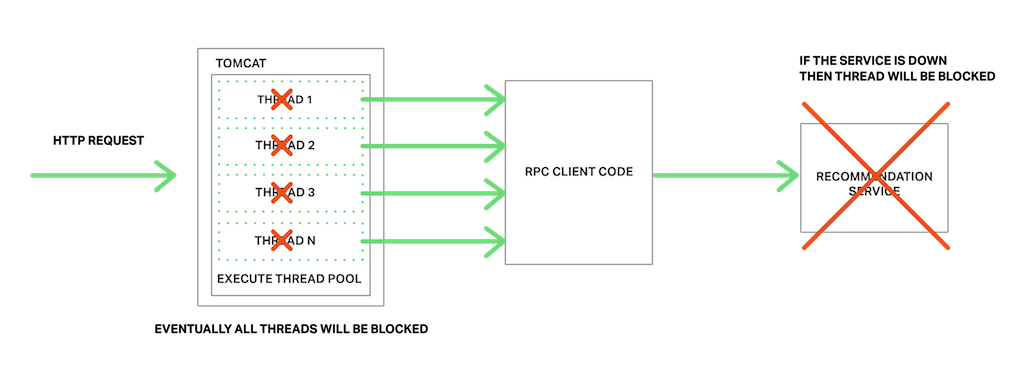
Para evitar este problema, es esencial que diseñes tus servicios para gestionar fallos parciales.
Un buen enfoque es el que describe Netflix. Las estrategias para gestionar los fallos parciales incluyen:
- Tiempos de espera de red: nunca bloquees una operación indefinidamente y establece siempre un tiempo de espera al esperar una respuesta. Así se garantiza que los recursos nunca queden ocupados indefinidamente.
- Limitar el número de solicitudes pendientes – Establece un límite máximo para el número de solicitudes pendientes que un cliente puede tener con un servicio concreto. Si se ha alcanzado el límite, probablemente no tenga sentido realizar más solicitudes, y esos intentos deben fallar de inmediato.
- Patrón de disyuntor – Lleva un registro del número de solicitudes correctas y fallidas. Si la tasa de errores supera un umbral configurado, abre el disyuntor para que los intentos posteriores fallen de inmediato. Si falla un gran número de solicitudes, es indicio de que el servicio no está disponible y de que no tiene sentido seguir enviando solicitudes. Tras un periodo de espera, el cliente debe volver a intentarlo y, si lo consigue, cerrar el disyuntor.
- Ofrecer alternativas – Aplicar una lógica alternativa cuando falle una solicitud. Por ejemplo, devolver datos almacenados en caché o un valor predeterminado, como un conjunto vacío de recomendaciones.
Netflix Hystrix es una biblioteca de código abierto que implementa estos y otros patrones. Si utilizas la JVM, sin duda deberías plantearte usar Hystrix. Y, si trabajas en un entorno sin JVM, deberías utilizar una biblioteca equivalente.
Tecnologías de IPC
Hay muchas tecnologías de IPC entre las que elegir. Los servicios pueden utilizar mecanismos de comunicación síncronos basados en solicitudes y respuestas, como REST sobre HTTP o Thrift. Como alternativa, pueden utilizar mecanismos de comunicación asíncronos basados en mensajes, como AMQP o STOMP. También existen diversos formatos de mensajes. Los servicios pueden utilizar formatos de texto legibles para las personas, como JSON o XML. Como alternativa, pueden utilizar un formato binario (que resulta más eficiente), como Avro o Protocol Buffers. Más adelante veremos los mecanismos de IPC síncronos, pero primero hablaremos de los mecanismos de IPC asíncronos.
Comunicación asíncrona basada en mensajes
Cuando se utiliza la mensajería, los procesos se comunican intercambiando mensajes de forma asíncrona. Un cliente realiza una solicitud a un servicio enviándole un mensaje. Si se espera que el servicio responda, lo hace enviando otro mensaje al cliente. Como la comunicación es asíncrona, el cliente no se bloquea a la espera de una respuesta. En su lugar, se programa dando por hecho que la respuesta no se recibirá de inmediato.
Un mensaje consta de cabeceras (metadatos como el remitente) y un cuerpo. Los mensajes se intercambian a través de canales. Cualquier número de productores puede enviar mensajes a un canal. Del mismo modo, cualquier número de consumidores puede recibir mensajes de un canal. Hay dos tipos de canales: punto a punto y publicación-suscripción. Un canal punto a punto entrega cada mensaje a uno solo de los consumidores que leen del canal. Los servicios utilizan canales punto a punto para los estilos de interacción de uno a uno descritos anteriormente. Un canal de publicación-suscripción entrega cada mensaje a todos los consumidores suscritos. Los servicios utilizan canales de publicación-suscripción para los estilos de interacción de uno a muchos descritos anteriormente.
El siguiente diagrama muestra cómo la aplicación para solicitar taxis podría utilizar canales de publicación-suscripción.
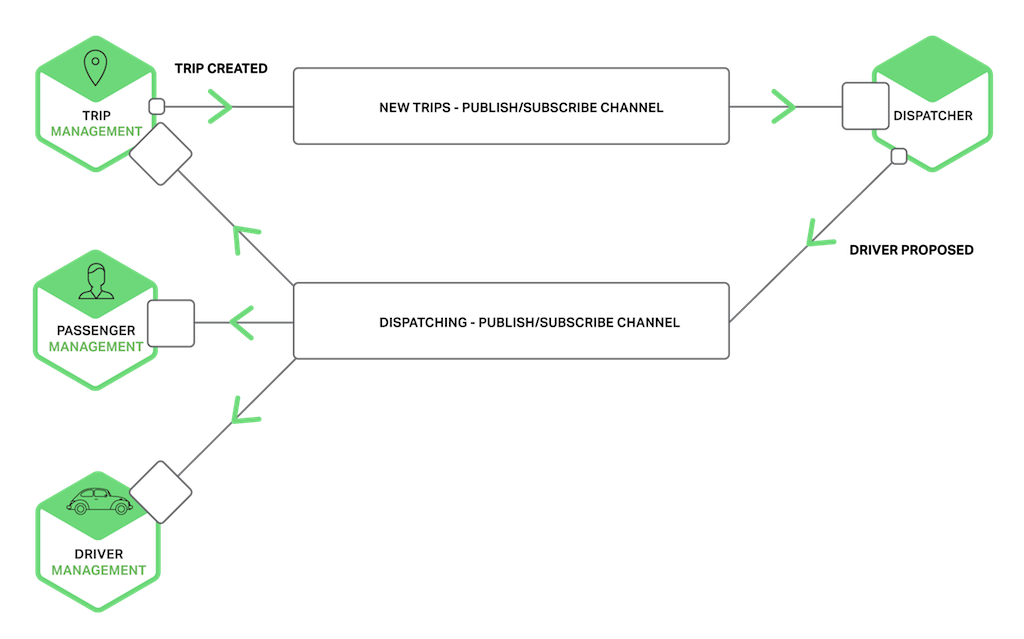
El servicio de gestión de viajes notifica a los servicios interesados, como el de asignación, que hay un nuevo viaje mediante la publicación de un mensaje de viaje creado en un canal de publicación-suscripción. El servicio de asignación encuentra un conductor disponible y notifica a los demás servicios mediante la publicación de un mensaje de conductor propuesto en un canal de publicación-suscripción.
Hay muchos sistemas de mensajería entre los que elegir. Deberías escoger uno que admita varios lenguajes de programación. Algunos sistemas de mensajería admiten protocolos estándar como AMQP y STOMP. Otros utilizan protocolos propietarios, pero documentados. Existe una gran variedad de sistemas de mensajería de código abierto entre los que elegir, como RabbitMQ, Apache Kafka, Apache ActiveMQ y NSQ. En términos generales, todos admiten algún tipo de mensajes y canales. Todos aspiran a ser fiables, ofrecer un alto rendimiento y ser escalables. Sin embargo, existen diferencias significativas en los detalles del modelo de mensajería de cada intermediario.
El uso de la mensajería ofrece muchas ventajas:
- Desacopla el cliente del servicio: el cliente realiza una solicitud simplemente enviando un mensaje al canal adecuado. El cliente no tiene conocimiento alguno de las instancias del servicio. No necesita utilizar un mecanismo de descubrimiento para determinar la ubicación de una instancia del servicio.
- Almacenamiento de mensajes en búfer – Con un protocolo síncrono de solicitud/respuesta, como HTTP, tanto el cliente como el servicio deben estar disponibles durante todo el intercambio. En cambio, un intermediario de mensajes pone en cola los mensajes enviados a un canal hasta que el consumidor pueda procesarlos. Esto significa, por ejemplo, que una tienda en línea puede aceptar pedidos de los clientes incluso cuando el sistema de gestión de pedidos funciona con lentitud o no está disponible. Los mensajes de los pedidos simplemente se acumulan en la cola.
- Interacciones flexibles entre cliente y servicio – La mensajería admite todos los estilos de interacción descritos anteriormente.
- Comunicación explícita entre procesos: los mecanismos basados en RPC intentan que invocar un servicio remoto parezca lo mismo que llamar a un servicio local. Sin embargo, debido a las leyes de la física y a la posibilidad de que se produzcan fallos parciales, en realidad son operaciones muy diferentes. La mensajería hace que estas diferencias sean muy evidentes para que los desarrolladores no caigan en una falsa sensación de seguridad.
Sin embargo, el uso de la mensajería presenta algunos inconvenientes:
- Mayor complejidad operativa – El sistema de mensajería es un componente más del sistema que hay que instalar, configurar y gestionar. Es esencial que el intermediario de mensajes tenga una alta disponibilidad; de lo contrario, la fiabilidad del sistema se verá afectada.
- Complejidad de implementar una interacción basada en solicitudes y respuestas: implementar este tipo de interacción requiere cierto esfuerzo. Cada mensaje de solicitud debe contener un identificador del canal de respuesta y un identificador de correlación. El servicio escribe en el canal de respuesta un mensaje que contiene el identificador de correlación. El cliente utiliza este identificador para vincular la respuesta con la solicitud. A menudo resulta más sencillo utilizar un mecanismo de comunicación entre procesos (IPC) que admita directamente el modelo de solicitud/respuesta.
Ahora que hemos visto cómo utilizar la comunicación entre procesos (IPC) basada en mensajería, veamos la IPC basada en solicitudes y respuestas.
IPC síncrona de solicitud/respuesta
Cuando se utiliza un mecanismo de IPC síncrono basado en solicitudes y respuestas, un cliente envía una solicitud a un servicio. El servicio procesa la solicitud y devuelve una respuesta. En muchos clientes, el hilo que realiza la solicitud se bloquea mientras espera una respuesta. Otros clientes pueden utilizar código asíncrono orientado a eventos, que puede estar encapsulado mediante Futures u Observables de Rx. Sin embargo, a diferencia de lo que ocurre al utilizar mensajería, el cliente da por hecho que la respuesta llegará en un plazo razonable. Hay numerosos protocolos entre los que elegir. Dos de los más populares son REST y Thrift. Veamos primero REST.
REST
Hoy en día está de moda desarrollar API siguiendo el estilo RESTful. REST es un mecanismo de comunicación entre procesos (IPC) que utiliza HTTP (casi siempre). Un concepto clave en REST es el recurso, que normalmente representa un objeto de negocio, como un cliente o un producto, o una colección de objetos de negocio. REST utiliza los verbos HTTP para manipular los recursos, a los que se hace referencia mediante una URL. Por ejemplo, una solicitud GET devuelve la representación de un recurso, que puede tener la forma de un documento XML o un objeto JSON. Una solicitud POST crea un nuevo recurso y una solicitud PUT actualiza un recurso. En palabras de Roy Fielding, el creador de REST:
«REST proporciona un conjunto de restricciones arquitectónicas que, al aplicarse en su totalidad, hacen hincapié en la escalabilidad de las interacciones entre componentes, la generalidad de las interfaces, el despliegue independiente de los componentes y el uso de componentes intermediarios para reducir la latencia de las interacciones, garantizar la seguridad y encapsular los sistemas heredados».
El siguiente diagrama muestra una de las formas en que la aplicación para solicitar taxis podría utilizar REST.
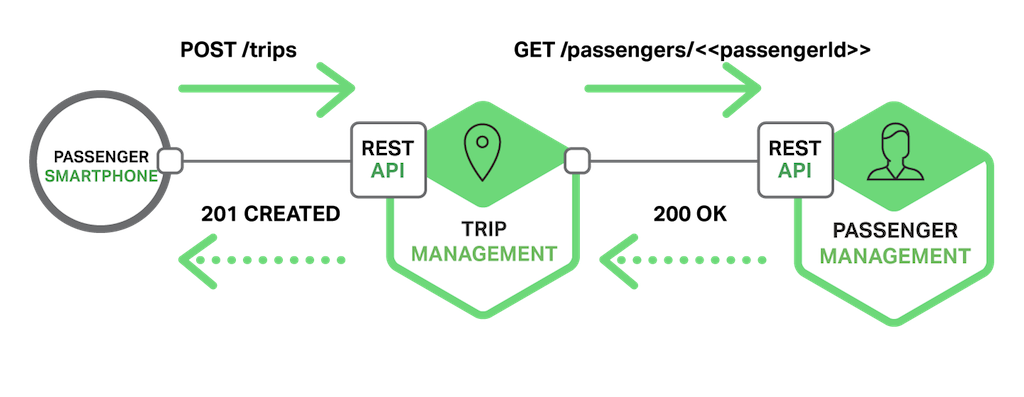
El teléfono inteligente del pasajero solicita un viaje mediante una petición POST al recurso /trips del servicio de gestión de viajes. Este servicio procesa la petición enviando una petición GET al servicio de gestión de pasajeros para obtener información sobre el pasajero. Tras comprobar que el pasajero está autorizado para crear un viaje, el servicio de gestión de viajes crea el viaje y devuelve una respuesta 201 al teléfono inteligente.
Muchos desarrolladores afirman que sus API basadas en HTTP son RESTful. Sin embargo, como explica Fielding en esta entrada de blog, no todas lo son realmente. Leonard Richardson (sin parentesco con el autor) define un modelo de madurez de REST muy útil que consta de los siguientes niveles.
- Nivel 0 – Los clientes de una API de nivel 0 invocan el servicio mediante solicitudes HTTP
POSTa su único endpoint URL. Cada solicitud especifica la acción que se va a realizar, el destinatario de la acción (p. ej., el objeto de negocio) y los parámetros correspondientes. - Nivel 1 – Una API de nivel 1 admite el concepto de recursos. Para realizar una acción sobre un recurso, un cliente envía una solicitud
POSTque especifica la acción que se va a realizar y los parámetros necesarios. - Nivel 2 – Una API de nivel 2 utiliza verbos HTTP para realizar acciones:
GETpara recuperar,POSTpara crear yPUTpara actualizar. Los parámetros de consulta y el cuerpo de la solicitud, si los hay, especifican los parámetros de la acción. Esto permite a los servicios aprovechar la infraestructura web, como el almacenamiento en caché para las solicitudesGET. - Nivel 3 – El diseño de una API de nivel 3 se basa en el principio, de nombre poco afortunado, HATEOAS (hipertexto como motor del estado de la aplicación). La idea básica es que la representación de un recurso devuelta por una solicitud
GETcontiene enlaces para realizar las acciones permitidas sobre ese recurso. Por ejemplo, un cliente puede cancelar un pedido mediante un enlace incluido en la representación del pedido devuelta en respuesta a la solicitudGETenviada para recuperar el pedido. Las ventajas de HATEOAS incluyen no tener que incorporar URL de forma fija en el código del cliente. Otra ventaja es que, como la representación de un recurso contiene enlaces para las acciones permitidas, el cliente no tiene que adivinar qué acciones se pueden realizar sobre un recurso en su estado actual.
Utilizar un protocolo basado en HTTP ofrece numerosas ventajas:
- HTTP es sencillo y conocido.
- Puedes probar una API HTTP desde un navegador utilizando una extensión como Postman o desde la línea de comandos utilizando
curl(siempre que se utilice JSON u otro formato de texto). - Admite directamente la comunicación de tipo solicitud/respuesta.
- Por supuesto, HTTP no suele tener problemas con los cortafuegos.
- No requiere un intermediario, lo que simplifica la arquitectura del sistema.
El uso de HTTP tiene algunos inconvenientes:
- Solo admite directamente el modelo de interacción de solicitud/respuesta. Puedes usar HTTP para las notificaciones, pero el servidor siempre debe enviar una respuesta HTTP.
- Dado que el cliente y el servicio se comunican directamente (sin un intermediario que almacene temporalmente los mensajes), ambos deben estar en funcionamiento durante todo el intercambio.
- El cliente debe conocer la ubicación (es decir, la URL) de cada instancia del servicio. Como se explica en el artículo anterior sobre la puerta de enlace de API, este no es un problema trivial en una aplicación moderna. Los clientes deben utilizar un mecanismo de descubrimiento de servicios para localizar las instancias de los servicios.
La comunidad de desarrolladores ha redescubierto recientemente el valor de los lenguajes de definición de interfaces para las API RESTful. Existen varias opciones, entre ellas RAML y Swagger. Algunos lenguajes de definición de interfaces (IDL), como Swagger, permiten definir el formato de los mensajes de solicitud y respuesta. Otros, como RAML, requieren el uso de una especificación independiente, como JSON Schema. Además de describir las API, los IDL suelen contar con herramientas que generan código auxiliar de cliente y esqueletos de servidor a partir de una definición de interfaz.
Thrift
Apache Thrift es una alternativa interesante a REST. Es un framework para desarrollar clientes y servidores RPC en distintos lenguajes. Thrift proporciona un IDL de estilo C para definir tus API. El compilador de Thrift permite generar stubs del lado del cliente y esqueletos del lado del servidor. El compilador genera código para diversos lenguajes, entre ellos C++, Java, Python, PHP, Ruby, Erlang y Node.js.
Una interfaz de Thrift consta de uno o varios servicios. La definición de un servicio es análoga a una interfaz de Java: es un conjunto de métodos fuertemente tipados. Los métodos de Thrift pueden devolver un valor (que puede ser void) o definirse como unidireccionales. Los métodos que devuelven un valor implementan el modelo de interacción de solicitud/respuesta. El cliente espera una respuesta y puede lanzar una excepción. Los métodos unidireccionales corresponden al modelo de interacción mediante notificaciones. El servidor no envía ninguna respuesta.
Thrift admite varios formatos de mensaje: JSON, binario y binario compacto. El formato binario es más eficiente que JSON porque se descodifica más rápido. Y, como su nombre indica, el formato binario compacto ocupa poco espacio. JSON, por supuesto, es fácil de leer para las personas y de procesar para los navegadores. Thrift también permite elegir entre varios protocolos de transporte, como TCP puro y HTTP. Es probable que TCP puro sea más eficiente que HTTP. Sin embargo, HTTP facilita el paso a través de cortafuegos y resulta más sencillo de usar tanto para los navegadores como para las personas.
Formatos de mensajes
Ahora que hemos visto HTTP y Thrift, examinemos la cuestión de los formatos de mensaje. Si utilizas un sistema de mensajería o REST, puedes elegir el formato de los mensajes. Es posible que otros mecanismos de comunicación entre procesos (IPC), como Thrift, solo admitan un número reducido de formatos de mensaje, quizá solo uno. En cualquier caso, es importante utilizar un formato de mensaje compatible con distintos lenguajes de programación. Aunque actualmente estés escribiendo tus microservicios en un único lenguaje, es probable que utilices otros en el futuro.
Hay dos tipos principales de formatos de mensajes: de texto y binarios. Algunos ejemplos de formatos de texto son JSON y XML. Una ventaja de estos formatos es que no solo son legibles para las personas, sino que también son autodescriptivos. En JSON, los atributos de un objeto se representan mediante un conjunto de pares nombre-valor. Del mismo modo, en XML los atributos se representan mediante elementos con nombre y valores. Esto permite que el consumidor de un mensaje seleccione los valores que le interesan e ignore el resto. Por consiguiente, los pequeños cambios en el formato de los mensajes pueden mantener fácilmente la compatibilidad con versiones anteriores.
La estructura de los documentos XML se define mediante un esquema XML. Con el tiempo, la comunidad de desarrolladores se ha dado cuenta de que JSON también necesita un mecanismo similar. Una opción es utilizar JSON Schema, ya sea de forma independiente o como parte de un IDL como Swagger.
Una desventaja de utilizar un formato de mensajes basado en texto es que los mensajes tienden a ser extensos, especialmente en XML. Como los mensajes son autodescriptivos, cada uno contiene los nombres de los atributos además de sus valores. Otro inconveniente es la sobrecarga que supone analizar el texto. Por ello, puede ser conveniente considerar el uso de un formato binario.
Hay varios formatos binarios entre los que elegir. Si utilizas Thrift RPC, puedes usar Thrift binario. Si puedes elegir el formato de los mensajes, algunas opciones populares son Protocol Buffers y Apache Avro. Ambos formatos proporcionan un lenguaje de definición de interfaces (IDL) con tipos para definir la estructura de los mensajes. Sin embargo, una diferencia es que Protocol Buffers utiliza campos etiquetados, mientras que un consumidor de Avro necesita conocer el esquema para interpretar los mensajes. Por ello, la evolución de las API resulta más sencilla con Protocol Buffers que con Avro. Esta entrada de blog ofrece una excelente comparación entre Thrift, Protocol Buffers y Avro.
Resumen
Los microservicios deben comunicarse mediante un mecanismo de comunicación entre procesos. Al diseñar cómo se comunicarán los servicios, hay que tener en cuenta varias cuestiones: cómo interactúan los servicios, cómo especificar la API de cada servicio, cómo hacer evolucionar las API y cómo gestionar los fallos parciales. Los microservicios pueden utilizar dos tipos de mecanismos de comunicación entre procesos (IPC): la mensajería asíncrona y la solicitud/respuesta síncrona. En el próximo artículo de la serie, abordaremos el problema del descubrimiento de servicios en una arquitectura de microservicios.
Nota del editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios (este artículo)
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios
- Cómo elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puedes descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en el libro electrónico «Microservicios: del diseño al despliegue».
El bloguero invitado Chris Richardson es el fundador de la versión original de CloudFoundry.com, una de las primeras PaaS (plataformas como servicio) de Java para Amazon EC2. Actualmente asesora a organizaciones para mejorar la forma en que desarrollan y despliegan aplicaciones. También escribe habitualmente sobre microservicios en http://microservices.io.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.