Ya está abierto el plazo de inscripción para Microservices March 2023. Consulta el programa e inscríbete aquí.
Editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios (este artículo)
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios
- Cómo elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: «Microservicios: del diseño a la implementación».
Consulta también nuestra página de soluciones de microservicios.
Actualmente, los microservicios están recibiendo mucha atención en artículos, blogs, debates en redes sociales y ponencias en congresos. Se acercan rápidamente al pico de expectativas sobredimensionadas del ciclo de sobreexpectación de Gartner. Al mismo tiempo, hay escépticos en la comunidad del software que sostienen que los microservicios no aportan nada nuevo. Sus detractores afirman que la idea no es más que un cambio de nombre de la SOA. Sin embargo, pese a la expectación y al escepticismo, el patrón de arquitectura de microservicios ofrece importantes ventajas – especialmente a la hora de facilitar el desarrollo ágil y la entrega de aplicaciones empresariales complejas.
Esta entrada de blog es la primera de una serie de siete partes sobre el diseño, la creación y el despliegue de microservicios. Conocerá este enfoque y cómo se compara con el patrón más tradicional de arquitectura monolítica. Esta serie describirá los distintos elementos de una arquitectura de microservicios. Conocerá las ventajas y desventajas del patrón de arquitectura de microservicios, si resulta adecuado para su proyecto y cómo aplicarlo.
Veamos primero por qué debería plantearse utilizar microservicios.
Creación de aplicaciones monolíticas
Imaginemos que empezaras a desarrollar una aplicación completamente nueva para solicitar taxis, destinada a competir con Uber y Hailo. Tras algunas reuniones preliminares y la recopilación de requisitos, crearías un nuevo proyecto, ya fuera manualmente o mediante un generador incluido con Rails, Spring Boot, Play o Maven. Esta nueva aplicación tendría una arquitectura hexagonal modular, como se muestra en el siguiente diagrama:
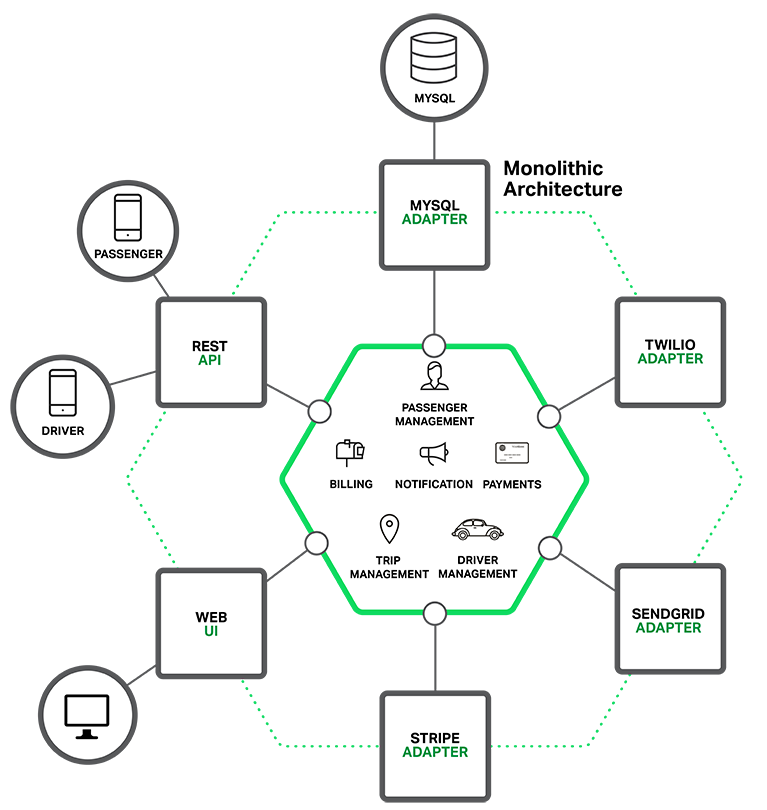
En el núcleo de la aplicación se encuentra la lógica de negocio, implementada mediante módulos que definen servicios, objetos de dominio y eventos. Alrededor del núcleo se encuentran los adaptadores que interactúan con el mundo exterior. Algunos ejemplos de adaptadores son los componentes de acceso a bases de datos, los componentes de mensajería que producen y consumen mensajes y los componentes web que exponen API o implementan una interfaz de usuario.
A pesar de tener una arquitectura modular desde el punto de vista lógico, la aplicación se empaqueta y se despliega como un monolito. El formato concreto depende del lenguaje y del framework de la aplicación. Por ejemplo, muchas aplicaciones Java se empaquetan como archivos WAR y se despliegan en servidores de aplicaciones como Tomcat o Jetty. Otras aplicaciones Java se empaquetan como archivos JAR ejecutables y autocontenidos. Del mismo modo, las aplicaciones Rails y Node.js se empaquetan como una jerarquía de directorios.
Las aplicaciones desarrolladas siguiendo este estilo son muy habituales. Son fáciles de desarrollar, ya que nuestros IDE y otras herramientas están orientados a crear una única aplicación. Este tipo de aplicaciones también es fácil de probar. Se pueden realizar pruebas de extremo a extremo simplemente iniciando la aplicación y probando la interfaz de usuario con Selenium. Las aplicaciones monolíticas también son fáciles de desplegar. Basta con copiar la aplicación empaquetada en un servidor. Además, se puede escalar la aplicación ejecutando varias instancias detrás de un balanceador de carga. En las primeras etapas del proyecto, este enfoque funciona bien.
Rumbo al infierno monolítico
Por desgracia, este sencillo enfoque tiene una enorme limitación. Las aplicaciones de éxito suelen crecer con el tiempo hasta alcanzar dimensiones descomunales. En cada sprint, el equipo de desarrollo implementa unas cuantas historias más, lo que, por supuesto, implica añadir muchas líneas de código. Al cabo de unos años, esa aplicación pequeña y sencilla se habrá convertido en un monolito monstruoso. Por poner un ejemplo extremo, hace poco hablé con un desarrollador que estaba creando una herramienta para analizar las dependencias entre los miles de archivos JAR de una aplicación con varios millones de líneas de código (LOC). Estoy seguro de que hizo falta el esfuerzo conjunto de un gran número de desarrolladores durante muchos años para crear semejante monstruo.
Una vez que la aplicación se ha convertido en un monolito grande y complejo, lo más probable es que la organización de desarrollo se encuentre en una situación muy complicada. Cualquier intento de aplicar un desarrollo y una entrega ágiles fracasará. Uno de los principales problemas es que la aplicación tiene una complejidad abrumadora. Es sencillamente demasiado grande para que un solo desarrollador pueda comprenderla por completo. Como consecuencia, corregir errores e implementar correctamente nuevas funcionalidades se vuelve difícil y requiere mucho tiempo. Además, esto suele generar una espiral descendente. Si la base de código es difícil de entender, los cambios no se realizarán correctamente. El resultado será una monstruosa e incomprensible gran bola de lodo.
El enorme tamaño de la aplicación también ralentizará el desarrollo. Cuanto mayor sea la aplicación, más tardará en iniciarse. Por ejemplo, en una encuesta reciente, algunos desarrolladores indicaron tiempos de arranque de hasta 12 minutos. También he oído casos de aplicaciones que tardan hasta 40 minutos en arrancar. Si los desarrolladores tienen que reiniciar con frecuencia el servidor de aplicaciones, pasarán gran parte de la jornada esperando y su productividad se verá afectada.
Otro problema de una aplicación monolítica grande y compleja es que supone un obstáculo para el despliegue continuo. Hoy en día, la práctica más avanzada para las aplicaciones SaaS consiste en implementar cambios en producción muchas veces al día. Esto resulta extremadamente difícil con un monolito complejo, ya que es necesario volver a desplegar toda la aplicación para actualizar cualquiera de sus partes. Los largos tiempos de arranque que he mencionado antes tampoco ayudan. Además, como normalmente no se conoce bien el impacto de un cambio, es probable que sea necesario realizar numerosas pruebas manuales. Por tanto, el despliegue continuo resulta prácticamente imposible.
Las aplicaciones monolíticas también pueden ser difíciles de escalar cuando los distintos módulos tienen requisitos de recursos incompatibles. Por ejemplo, un módulo podría implementar una lógica de procesamiento de imágenes que requiera un uso intensivo de la CPU y lo ideal sería implementarlo en instancias EC2 optimizadas para computación de Amazon. Otro módulo podría ser una base de datos en memoria y resultar más adecuado para instancias EC2 optimizadas para memoria. Sin embargo, como estos módulos se implementan juntos, hay que llegar a una solución de compromiso a la hora de elegir el hardware.
Otro problema de las aplicaciones monolíticas es la fiabilidad. Dado que todos los módulos se ejecutan dentro del mismo proceso, un error en cualquier módulo, como una fuga de memoria, puede provocar la caída de todo el proceso. Además, como todas las instancias de la aplicación son idénticas, ese error afectará a la disponibilidad de toda la aplicación.
Por último, pero no por ello menos importante, las aplicaciones monolíticas dificultan enormemente la adopción de nuevos frameworks y lenguajes. Por ejemplo, imaginemos que tiene dos millones de líneas de código escritas con el framework XYZ. Reescribir toda la aplicación para utilizar el framework ABC, más reciente, resultaría extremadamente caro, tanto en tiempo como en dinero, aunque fuera considerablemente mejor. En consecuencia, existe una enorme barrera para adoptar nuevas tecnologías. No le queda más remedio que seguir utilizando las tecnologías que eligió al inicio del proyecto.
En resumen: tiene una aplicación crítica para el negocio y de gran éxito que ha crecido hasta convertirse en un monolito monstruoso que muy pocos desarrolladores, si es que alguno, comprenden. Está escrita con tecnología obsoleta y poco productiva, lo que dificulta la contratación de desarrolladores con talento. La aplicación es difícil de escalar y poco fiable. Como resultado, el desarrollo ágil y la entrega de aplicaciones son imposibles.
Entonces, ¿qué puedes hacer al respecto?
Microservicios – Cómo abordar la complejidad
Muchas organizaciones, como Amazon, eBay y Netflix, han resuelto este problema adoptando lo que hoy se conoce como el patrón de arquitectura de microservicios. En lugar de crear una única aplicación monolítica y descomunal, la idea es dividirla en un conjunto de servicios más pequeños e interconectados.
Un servicio suele implementar un conjunto de características o funcionalidades diferenciadas, como la gestión de pedidos, la gestión de clientes, etc. Cada microservicio es una miniaplicación con su propia arquitectura hexagonal, compuesta por lógica de negocio y diversos adaptadores. Algunos microservicios exponen una API que consumen otros microservicios o los clientes de la aplicación. Otros microservicios pueden implementar una interfaz de usuario web. En tiempo de ejecución, cada instancia suele ser una máquina virtual en la nube o un contenedor Docker.
Por ejemplo, en el siguiente diagrama se muestra una posible descomposición del sistema descrito anteriormente:
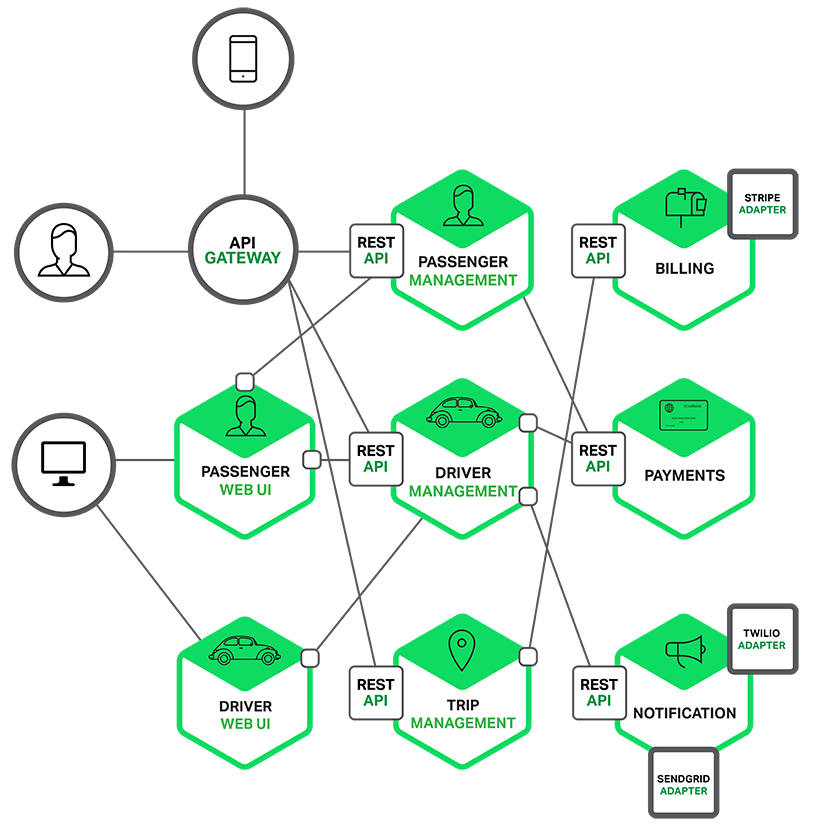
Ahora, cada área funcional de la aplicación se implementa mediante su propio microservicio. Además, la aplicación web se divide en un conjunto de aplicaciones web más sencillas (como una para pasajeros y otra para conductores en nuestro ejemplo de servicio de solicitud de taxis). Esto facilita el despliegue de experiencias diferenciadas para usuarios o dispositivos específicos, o para casos de uso especializados.
Cada servicio de backend expone una API REST y la mayoría de los servicios consumen API proporcionadas por otros servicios. Por ejemplo, Gestión de conductores utiliza el servidor de notificaciones para informar a un conductor disponible sobre un posible trayecto. Los servicios de interfaz de usuario invocan a los demás servicios para renderizar páginas web. Los servicios también pueden utilizar comunicación asíncrona basada en mensajes. La comunicación entre servicios se abordará con más detalle más adelante en esta serie.
Algunas API REST también están disponibles para las aplicaciones móviles que utilizan los conductores y los pasajeros. Sin embargo, las aplicaciones no tienen acceso directo a los servicios de backend. En su lugar, la comunicación se realiza a través de un intermediario conocido como puerta de enlace de API. La puerta de enlace de API se encarga de tareas como el equilibrio de carga, el almacenamiento en caché, el control de acceso, la medición del uso de las API y la supervisión, y puede implementarse eficazmente con NGINX. En artículos posteriores de la serie se abordará la puerta de enlace de API.
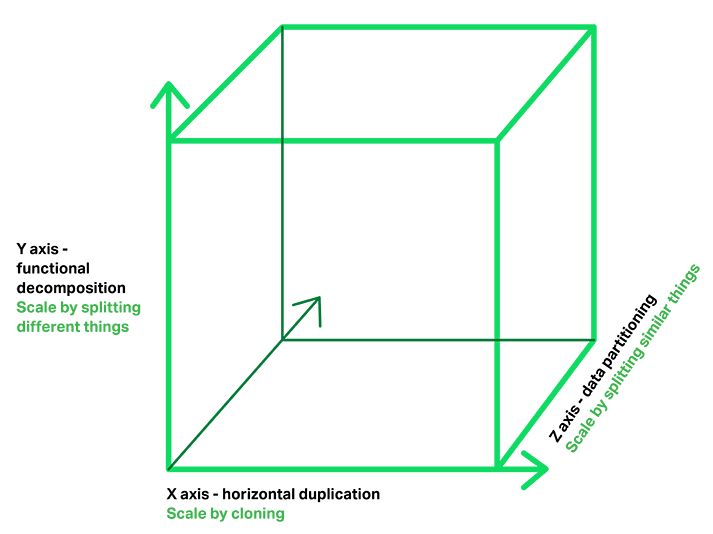
El patrón de arquitectura de microservicios se corresponde con el escalado en el eje Y del cubo de escalabilidad, un modelo 3D de escalabilidad presentado en el excelente libro El arte de la escalabilidad. Los otros dos ejes de escalado son el eje X, que consiste en ejecutar varias copias idénticas de la aplicación detrás de un balanceador de carga, y el eje Z (o particionamiento de datos), en el que se utiliza un atributo de la solicitud (por ejemplo, la clave principal de una fila o la identidad de un cliente) para dirigirla a un servidor concreto.
Las aplicaciones suelen utilizar conjuntamente los tres tipos de escalado. El escalado en el eje Y descompone la aplicación en microservicios, como se muestra en la primera figura de esta sección. En tiempo de ejecución, el escalado en el eje X ejecuta varias instancias de cada servicio detrás de un equilibrador de carga para mejorar el rendimiento y la disponibilidad. Algunas aplicaciones también pueden utilizar el escalado en el eje Z para particionar los servicios. El siguiente diagrama muestra cómo podría desplegarse el servicio de gestión de viajes con Docker ejecutándose en Amazon EC2.
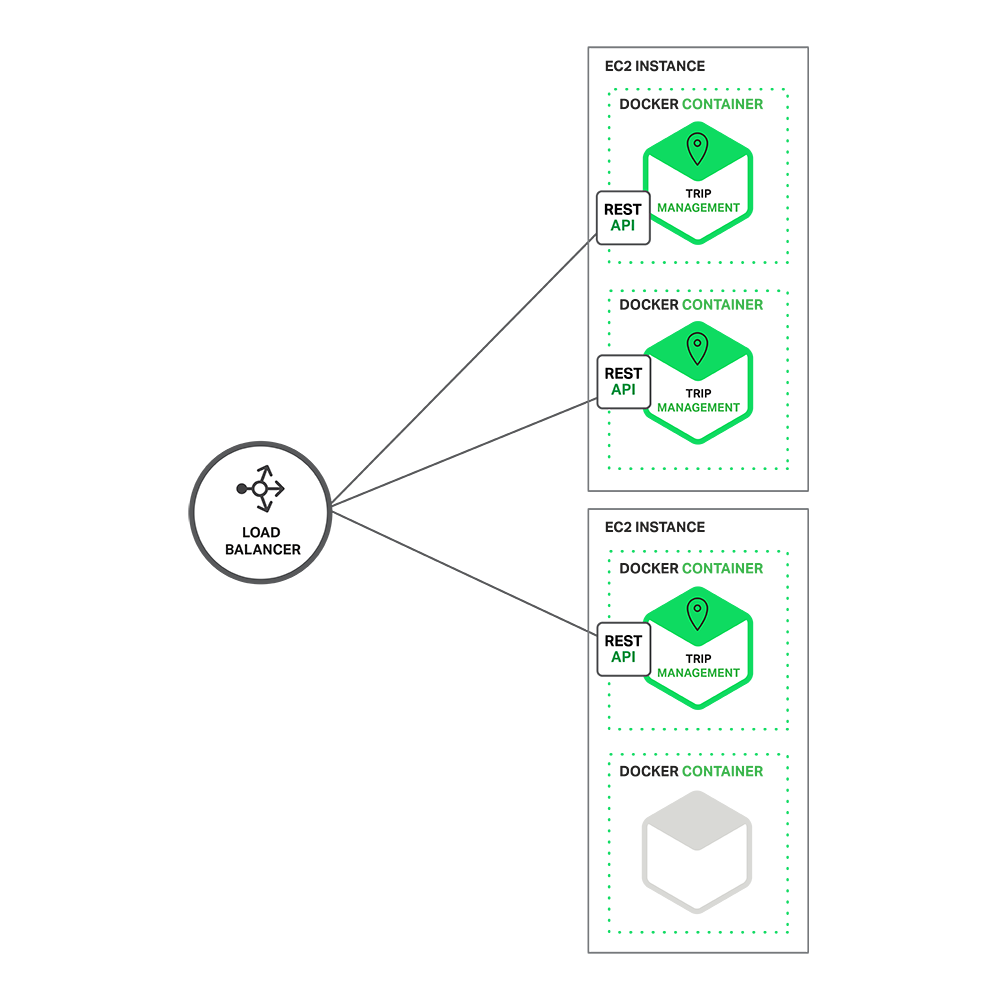
En tiempo de ejecución, el servicio de gestión de viajes consta de varias instancias de servicio. Cada instancia de servicio es un contenedor Docker. Para garantizar una alta disponibilidad, los contenedores se ejecutan en varias máquinas virtuales en la nube. Delante de las instancias de servicio hay un balanceador de carga como NGINX que distribuye las solicitudes entre las instancias. El balanceador de carga también puede encargarse de otros aspectos, como el almacenamiento en caché, el control de acceso, la medición del uso de la API, y la supervisión.
El patrón de arquitectura de microservicios influye significativamente en la relación entre la aplicación y la base de datos. En lugar de compartir un único esquema de base de datos con otros servicios, cada servicio tiene su propio esquema. Por un lado, este enfoque entra en conflicto con la idea de un modelo de datos para toda la empresa. Además, suele provocar la duplicación de algunos datos. Sin embargo, disponer de un esquema de base de datos por servicio es esencial para aprovechar las ventajas de los microservicios, ya que garantiza un acoplamiento débil. El siguiente diagrama muestra la arquitectura de la base de datos de la aplicación de ejemplo.
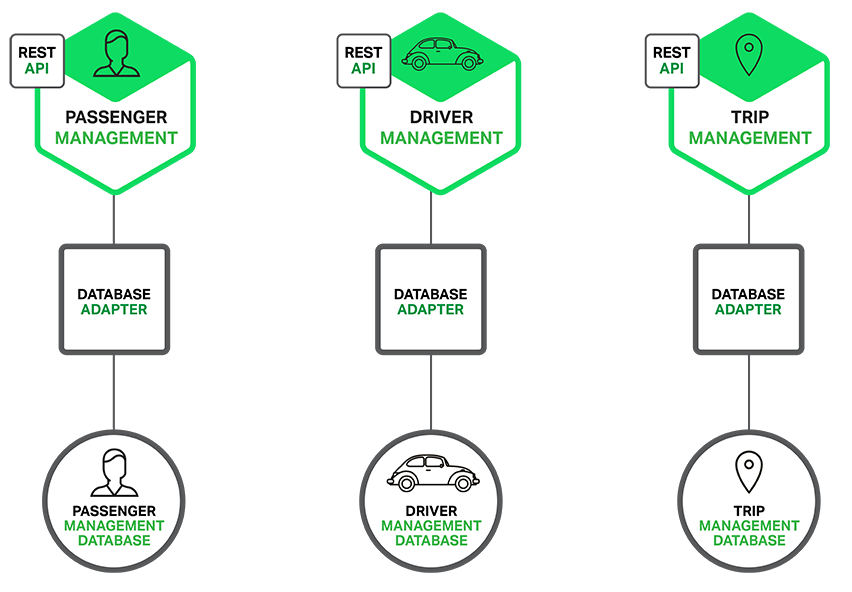
Cada uno de los servicios tiene su propia base de datos. Además, un servicio puede utilizar el tipo de base de datos que mejor se adapte a sus necesidades, lo que se conoce como arquitectura de persistencia políglota. Por ejemplo, Gestión de conductores, que busca conductores cercanos a un posible pasajero, debe utilizar una base de datos que permita realizar consultas geoespaciales de forma eficiente.
A primera vista, el patrón de arquitectura de microservicios es similar a la SOA. En ambos enfoques, la arquitectura consta de un conjunto de servicios. Sin embargo, una forma de entender el patrón de arquitectura de microservicios es considerarlo una SOA sin la comercialización ni el lastre que se suele asociar a las especificaciones de servicios web (WS‑*) y a un bus de servicios empresariales (ESB). Las aplicaciones basadas en microservicios prefieren protocolos más sencillos y ligeros, como REST, en lugar de WS‑*. También evitan en gran medida el uso de ESB y, en su lugar, implementan funcionalidades similares a las de un ESB en los propios microservicios. El patrón de arquitectura de microservicios también rechaza otros elementos de la SOA, como el concepto de esquema canónico.
Las ventajas de los microservicios
El patrón de arquitectura de microservicios ofrece una serie de ventajas importantes. En primer lugar, aborda el problema de la complejidad. Descompone lo que, de otro modo, sería una aplicación monolítica descomunal en un conjunto de servicios. Aunque la funcionalidad total no cambia, la aplicación se divide en partes o servicios manejables. Cada servicio tiene unos límites bien definidos mediante una API basada en RPC o en mensajes. El patrón de arquitectura de microservicios impone un nivel de modularidad que, en la práctica, resulta extremadamente difícil de alcanzar con una base de código monolítica. En consecuencia, los servicios individuales se desarrollan mucho más rápido y son mucho más fáciles de comprender y mantener.
En segundo lugar, esta arquitectura permite que cada servicio sea desarrollado de forma independiente por un equipo centrado en dicho servicio. Los desarrolladores pueden elegir libremente las tecnologías que consideren más adecuadas, siempre que el servicio respete el contrato de la API. Por supuesto, la mayoría de las organizaciones querrán evitar una anarquía total y limitar las opciones tecnológicas. Sin embargo, esta libertad implica que los desarrolladores ya no están obligados a utilizar las tecnologías posiblemente obsoletas que existían al inicio de un nuevo proyecto. Al crear un nuevo servicio, pueden optar por utilizar tecnología actual. Además, dado que los servicios son relativamente pequeños, resulta viable reescribir un servicio antiguo utilizando tecnología actual.
En tercer lugar, el patrón de arquitectura de microservicios permite desplegar cada microservicio de forma independiente. Los desarrolladores nunca tienen que coordinar el despliegue de cambios que solo afectan a su servicio. Este tipo de cambios se puede desplegar en cuanto se haya probado. Por ejemplo, el equipo de interfaz de usuario puede realizar pruebas A/B e iterar rápidamente sobre los cambios en la interfaz. El patrón de arquitectura de microservicios hace posible el despliegue continuo.
Por último, el patrón de arquitectura de microservicios permite escalar cada servicio de forma independiente. Puede implementar únicamente el número de instancias de cada servicio necesario para satisfacer sus requisitos de capacidad y disponibilidad. Además, puede utilizar el hardware que mejor se adapte a los requisitos de recursos de cada servicio. Por ejemplo, puede implementar un servicio de procesamiento de imágenes con un uso intensivo de la CPU en instancias EC2 optimizadas para computación y un servicio de base de datos en memoria en instancias EC2 optimizadas para memoria.
Las desventajas de los microservicios
Como escribió Fred Brooks hace casi 30 años, no existen soluciones milagrosas. Como cualquier otra tecnología, la arquitectura de microservicios tiene sus inconvenientes. Uno de ellos es el propio nombre. El término microservicio pone un énfasis excesivo en el tamaño del servicio. De hecho, algunos desarrolladores abogan por crear servicios extremadamente granulares de entre 10 y 100 líneas de código. Aunque es preferible que los servicios sean pequeños, es importante recordar que son un medio para alcanzar un fin y no el objetivo principal. El objetivo de los microservicios es descomponer la aplicación lo suficiente como para facilitar su desarrollo y despliegue ágiles.
Otro gran inconveniente de los microservicios es la complejidad derivada del hecho de que una aplicación de microservicios es un sistema distribuido. Los desarrolladores deben elegir e implementar un mecanismo de comunicación entre procesos basado en mensajería o RPC. Además, también deben escribir código para gestionar los fallos parciales, ya que el destino de una solicitud podría responder con lentitud o no estar disponible. Aunque nada de esto es especialmente complicado, resulta mucho más complejo que en una aplicación monolítica, donde los módulos se invocan entre sí mediante llamadas a métodos o procedimientos propias del lenguaje.
Otro reto de los microservicios es la arquitectura de bases de datos particionadas. Las transacciones empresariales que actualizan varias entidades de negocio son bastante habituales. Este tipo de transacciones son muy fáciles de implementar en una aplicación monolítica porque hay una única base de datos. Sin embargo, en una aplicación basada en microservicios, es necesario actualizar varias bases de datos pertenecientes a distintos servicios. El uso de transacciones distribuidas no suele ser una opción, y no solo debido al teorema CAP. Sencillamente, muchas de las bases de datos NoSQL y plataformas de mensajería actuales, altamente escalables, no las admiten. Por tanto, hay que recurrir a un enfoque basado en la consistencia eventual, lo que resulta más complejo para los desarrolladores.
Probar una aplicación de microservicios también es mucho más complejo. Por ejemplo, con un framework moderno como Spring Boot, resulta muy sencillo escribir una clase de prueba que inicie una aplicación web monolítica y pruebe su API REST. En cambio, una clase de prueba similar para un servicio tendría que iniciar dicho servicio y todos aquellos de los que dependa (o, al menos, configurar stubs para esos servicios). Una vez más, no es algo extremadamente complicado, pero es importante no subestimar la complejidad que conlleva.
Otro reto importante del patrón de arquitectura de microservicios es implementar cambios que afecten a varios servicios. Por ejemplo, imaginemos que está implementando una historia de usuario que requiere cambios en los servicios A, B y C, donde A depende de B y B depende de C. En una aplicación monolítica, bastaría con modificar los módulos correspondientes, integrar los cambios y desplegarlos todos a la vez. En cambio, con un patrón de arquitectura de microservicios, es necesario planificar y coordinar cuidadosamente el despliegue de los cambios en cada uno de los servicios. Por ejemplo, habría que actualizar primero el servicio C, después el servicio B y, por último, el servicio A. Afortunadamente, la mayoría de los cambios suelen afectar a un único servicio, y los cambios en varios servicios que requieren coordinación son relativamente poco frecuentes.
Desplegar una aplicación basada en microservicios también es mucho más complejo. Una aplicación monolítica simplemente se despliega en un conjunto de servidores idénticos situados detrás de un balanceador de carga tradicional. Cada instancia de la aplicación se configura con las ubicaciones (host y puertos) de servicios de infraestructura, como la base de datos y un bróker de mensajes. En cambio, una aplicación de microservicios suele constar de un gran número de servicios. Por ejemplo, Hailo tiene 160 servicios diferentes y Netflix cuenta con más de 600, según Adrian Cockcroft [Nota del editor: Hailo ha sido adquirida por MyTaxi.]. Cada servicio tendrá varias instancias en ejecución. Esto supone muchas más piezas móviles que hay que configurar, desplegar, escalar y supervisar. Además, también será necesario implementar un mecanismo de descubrimiento de servicios (que se abordará en una publicación posterior) que permita a un servicio descubrir las ubicaciones (hosts y puertos) de cualquier otro servicio con el que necesite comunicarse. Los enfoques operativos tradicionales, basados en incidencias y procesos manuales, no pueden escalar hasta este nivel de complejidad. Por consiguiente, para desplegar correctamente una aplicación de microservicios, los desarrolladores deben tener un mayor control sobre los métodos de despliegue y se requiere un alto grado de automatización.
Un enfoque para la automatización consiste en utilizar una PaaS lista para usar, como Cloud Foundry. Una PaaS ofrece a los desarrolladores una forma sencilla de desplegar y gestionar sus microservicios. Les evita tener que preocuparse por cuestiones como la adquisición y configuración de recursos de TI. Al mismo tiempo, los profesionales de sistemas y redes que configuran la PaaS pueden garantizar el cumplimiento de las prácticas recomendadas y las políticas de la empresa. Otra forma de automatizar el despliegue de microservicios consiste en desarrollar lo que, en esencia, sería una PaaS propia. Un punto de partida habitual es utilizar una solución de agrupación en clústeres, como Kubernetes, junto con una tecnología como Docker. Más adelante en esta serie veremos cómo los enfoques de entrega de aplicaciones basada en software como NGINX Plus, que gestiona fácilmente el almacenamiento en caché, el control de acceso, la medición del uso de las API y la supervisión a nivel de microservicio, pueden ayudar a resolver este problema.
Resumen
Desarrollar aplicaciones complejas es intrínsecamente difícil. Una arquitectura monolítica solo tiene sentido para aplicaciones sencillas y ligeras. Si se utiliza para aplicaciones complejas, acabará generando multitud de problemas. El patrón de arquitectura de microservicios es la mejor opción para aplicaciones complejas y en constante evolución, a pesar de sus inconvenientes y de las dificultades que plantea su implementación.
En próximas entradas del blog, profundizaré en los distintos aspectos del patrón de arquitectura de microservicios y abordaré temas como el descubrimiento de servicios, las opciones de despliegue de servicios y las estrategias para refactorizar una aplicación monolítica y convertirla en servicios.
No te lo pierdas…
Editor – Esta serie de artículos en siete partes ya está completa:
- Introducción a los microservicios (este artículo)
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios
- Cómo elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: «Microservicios: del diseño a la implementación».
El bloguero invitado Chris Richardson es el fundador de la plataforma original CloudFoundry.com, una de las primeras PaaS (plataforma como servicio) de Java para Amazon EC2. Actualmente asesora a organizaciones para mejorar sus procesos de desarrollo e implementación de aplicaciones.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.