Nota del autor – Esta entrada de blog es la sexta de una serie:
- Presentación de la arquitectura de referencia de microservicios de NGINX
- MRA, parte 2: el modelo de proxy
- MRA, parte 3: El modelo de malla de routers
- MRA, parte 4: El modelo de tejido
- MRA, parte 5: Adaptación de la aplicación de doce factores a los microservicios
- MRA, parte 6: Implementación del patrón Circuit Breaker con NGINX Plus (este artículo)
Los seis artículos del blog, junto con otro sobre frontends web para aplicaciones de microservicios<.htmla>, se han recopilado en un ebook gratuito.
Consulta también estos otros recursos de NGINX sobre microservicios:
- Una serie muy útil y popular de Chris Richardson sobre el diseño de aplicaciones de microservicios
- Los artículos de Chris Richardson recopilados en un ebook gratuito, con consejos adicionales para implementar microservicios con NGINX y NGINX Plus
- Otras publicaciones de blog sobre microservicios
- Webinarios sobre microservicios
El diseño de aplicaciones basadas en microservicios ha transformado por completo la forma en que funcionan las aplicaciones. En una arquitectura de microservicios, una «aplicación» es ahora un conjunto de servicios que dependen unos de otros para realizar tareas y ofrecer funcionalidades. En las aplicaciones complejas, el grafo de servicios puede ser bastante profundo y presentar múltiples interdependencias entre los distintos servicios.
Por ejemplo, un servicio de usuarios puede ser esencial para muchos otros servicios que dependen de los datos que proporciona. En este caso, un fallo del servicio de usuarios podría provocar una cascada de fallos en toda la aplicación.
El patrón Circuit Breaker —un término popularizado por Martin Fowler— está ganando aceptación entre los arquitectos de microservicios como patrón de diseño de aplicaciones para evitar fallos en cascada de los servicios. La idea del patrón Circuit Breaker consiste en supervisar los servicios de la aplicación y el tráfico que fluye entre ellos para prevenir fallos y, cuando estos se produzcan, minimizar su impacto en las aplicaciones.
Para los microservicios, el patrón Circuit Breaker resulta especialmente valioso, ya que aporta resiliencia desde la base. Si se implementa correctamente, puede ayudar a evitar fallos en cascada al garantizar la continuidad del servicio incluso cuando algunos servicios no están disponibles. El patrón Circuit Breaker ha sido adoptado de forma especialmente destacada por Netflix como un componente fundamental de su filosofía de diseño de aplicaciones.
No evites los fallos, acéptalos
Un principio fundamental del diseño de aplicaciones modernas es que se producirán fallos. La arquitectura por capas en la que se apoyan las aplicaciones modernas —desde máquinas virtuales alojadas en la nube hasta contenedores, bibliotecas de aplicaciones y redes dinámicas— implica que cualquier aplicación cuenta con innumerables componentes móviles. Debe asumir que, en algún momento, uno o varios componentes de su aplicación fallarán de alguna manera. Anticiparse a los fallos e incorporar mecanismos para mitigar sus efectos contribuye en gran medida a mejorar la resiliencia de su aplicación.
Uno de los objetivos más importantes del patrón de disyuntor es intentar evitar que se produzcan fallos. En algunos tipos de condiciones de error, como quedarse sin memoria, es posible detectar que el fallo es inminente y tomar medidas para evitarlo. Normalmente, esto se consigue haciendo que el servicio indique que no está en buen estado, tras lo cual el disyuntor le da la oportunidad de recuperarse reduciendo el número de solicitudes o redirigiéndolas por completo. Una vez que el servicio se ha recuperado, también es aconsejable que el disyuntor aumente gradualmente las solicitudes dirigidas al servicio para no sobrecargarlo de inmediato y evitar que vuelva a presentar problemas.
En la arquitectura de referencia de microservicios de NGINX, tenemos un servicio llamado resizer. Cuando se carga una foto de gran tamaño en el sistema, el resizer la descomprime, corrige su orientación, la reduce y, a continuación, vuelve a reducirla, guardando la imagen original corregida y las dos imágenes redimensionadas en un almacén de objetos. Debido a la naturaleza de estos procesos, el resizer es la parte de la aplicación que más recursos de procesamiento y memoria consume.
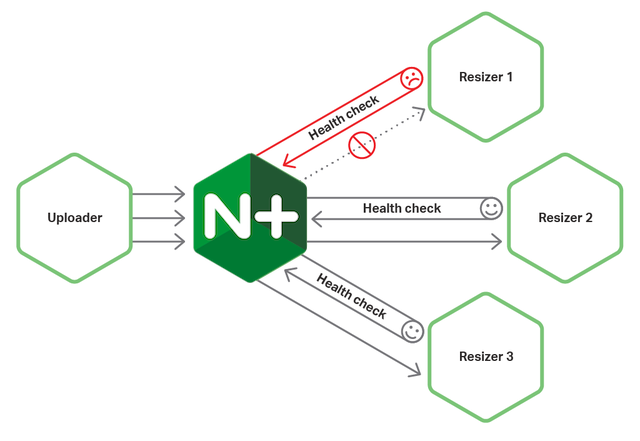
Cuando se redimensionan muchas imágenes simultáneamente, el redimensionador puede quedarse sin memoria y, en algunos casos, dejar de funcionar por completo. Para evitar problemas, colocamos un disyuntor entre las instancias del servicio de redimensionamiento y el servicio uploader que les envía las imágenes. El uploader consulta periódicamente el estado de las instancias del redimensionador. La consulta hace que el redimensionador compruebe, entre otros aspectos, si ha utilizado más del 80 % de la memoria disponible y responda al uploader con su estado.
Si una instancia del redimensionador indica que no está en buen estado, el cargador dirige las solicitudes a otras instancias —como se muestra en la Figura 1—, pero sigue comprobando si dicha instancia se ha recuperado. Cuando la instancia del redimensionador vuelve a indicar que está en buen estado, se reincorpora al grupo con equilibrio de carga y el cargador aumenta gradualmente el tráfico hasta alcanzar la capacidad máxima de la instancia. Este diseño evita que las instancias del redimensionador fallen por completo, que se inicien tareas que no lleguen a completarse y que los usuarios cuyos procesos habrían fallado tengan que esperar demasiado; además, ayuda al sistema a gestionar de la forma más eficaz posible el flujo de solicitudes que recibe.
El patrón de disyuntor mejora la coherencia
Una de las ventajas de implementar el patrón de disyuntor en NGINX es que crea una capa universal, coherente y muy flexible para gestionar los disyuntores en toda la aplicación de microservicios. Gracias a esta universalidad y coherencia, no es necesario gestionar ni adaptar el desarrollo a los matices y las incoherencias de las bibliotecas de disyuntores de cada lenguaje.
Obtendrá numerosas ventajas si mantiene la mayor parte de la funcionalidad del disyuntor fuera del código de cada servicio y la implementa en NGINX Plus:
- El disyuntor de un servicio escrito, por ejemplo, en Java es el mismo que el de un servicio escrito en PHP; además, el propio disyuntor puede escribirse en otro lenguaje distinto, según sea necesario.
- Evita tener que volver a implementar la funcionalidad del disyuntor en los distintos lenguajes y bibliotecas de soporte que utiliza cada uno de sus servicios
- De este modo, se simplifica cada servicio que no necesita incluir el código del disyuntor; se ejecuta más rápido y es más fácil de escribir, depurar, ejecutar y mantener
- El código auxiliar de cada servicio se simplifica; el conjunto de bibliotecas y sistemas utilizados puede limitarse a reflejar la funcionalidad principal del servicio
- El código del disyuntor se simplifica; al existir en un único lugar, puede reducirse a lo esencial, sin necesidad de adaptarse a contextos locales
- El código del disyuntor puede aprovechar funcionalidades de NGINX Plus como el almacenamiento en caché, lo que lo hace mucho más potente
- Puede ajustar con precisión el código del disyuntor a nivel de NGINX Plus y, a continuación, reutilizarlo en otras aplicaciones y en distintas plataformas de implementación, como entornos locales, diferentes plataformas en la nube y entornos híbridos.
Sin embargo, es importante señalar que los disyuntores no se pueden implementar únicamente en NGINX Plus. Un verdadero disyuntor requiere que el servicio proporcione una comprobación de estado activa e introspectiva en un URI designado (normalmente /health). La comprobación de estado debe adaptarse a las necesidades de ese servicio específico.
Al desarrollar la comprobación de estado, debe conocer el perfil de fallos del servicio y los tipos de condiciones que pueden provocar un fallo, como un error de conexión a la base de datos, la falta de memoria o de espacio en disco, o la sobrecarga de la CPU. Estas condiciones se evalúan durante el proceso de comprobación de estado, que proporciona un estado binario: correcto o incorrecto.
El patrón Circuit Breaker aporta flexibilidad
Cuando se implementa el patrón de disyuntor en el nivel de NGINX, tal como se describe aquí, NGINX Plus se encarga de gestionar la situación cuando una instancia de servicio comunica que no está en buen estado. Hay varias opciones.
La primera opción consiste en redirigir las solicitudes a otras instancias en buen estado y seguir consultando la instancia que presenta problemas para comprobar si se recupera. La segunda opción consiste en proporcionar respuestas almacenadas en caché a los clientes que soliciten el servicio, manteniendo así la estabilidad aunque el servicio no esté disponible. Esta solución funciona bien con servicios orientados a la lectura, como un servicio de contenidos.
Otra opción consiste en proporcionar fuentes de datos alternativas. Por ejemplo, uno de nuestros clientes dispone de un servidor de anuncios personalizados que utiliza datos de perfil para mostrar anuncios dirigidos a sus usuarios. Si el servidor de anuncios personalizados deja de estar disponible, la solicitud del usuario se redirige a un servidor de respaldo que proporciona un conjunto genérico de anuncios adecuados para todos. Este enfoque basado en fuentes de datos alternativas puede resultar muy eficaz.
Por último, si conoce muy bien el perfil de fallos de un servicio, puede mitigar los fallos añadiendo una limitación de la tasa de solicitudes al disyuntor. Las solicitudes solo se envían al servicio al ritmo que este puede gestionar. Esto crea un búfer en el disyuntor que le permite absorber los picos de tráfico.
La limitación de la tasa de solicitudes puede resultar especialmente eficaz en un escenario de balanceo de carga centralizado como el modelo de malla de enrutadores, en el que el tráfico de las aplicaciones se dirige a través de un número limitado de balanceadores de carga capaces de conocer con precisión el uso total del tráfico en todo el sitio.
Implementación del patrón de disyuntor en NGINX Plus
Como hemos descrito anteriormente, el patrón de disyuntor puede evitar que se produzca un fallo reduciendo el tráfico hacia un servicio en mal estado o desviando las solicitudes a otro destino. Para ello, se necesita una comprobación de estado activa conectada a un monitor de estado introspectivo en cada servicio. Lamentablemente, una comprobación de estado pasiva no sirve, ya que solo detecta el fallo cuando se produce, momento en el que ya es demasiado tarde para tomar medidas preventivas. Por este motivo, NGINX Open Source no puede implementar el patrón de disyuntor, ya que solo admite comprobaciones de estado pasivas.
NGINX Plus, sin embargo, cuenta con un sólido sistema de comprobaciones de estado activas que ofrece numerosas opciones para detectar problemas de estado y responder ante ellos. El análisis de la implementación de algunos de los tipos de servicio de la Arquitectura de Referencia de Microservicios proporciona buenos ejemplos de las opciones y los casos de uso para implementar el patrón de disyuntor.
Empecemos por el servicio de carga que se conecta al redimensionador. El servicio de carga guarda las imágenes en un almacén de objetos y, a continuación, indica al redimensionador que abra una imagen, la corrija y cambie su tamaño. Esta operación requiere un uso intensivo de recursos de computación y memoria. El servicio de carga debe supervisar el estado del redimensionador y evitar sobrecargarlo, ya que este puede llegar a bloquear por completo el host en el que se ejecuta.
Lo primero que hay que hacer es crear un bloque location específico para la comprobación de estado del redimensionador. Este bloque es una ubicación internal, lo que significa que no se puede acceder a ella mediante una solicitud a la URL estándar del servidor (http://example.com/health-check-resizer). En su lugar, actúa como marcador de posición para la información de la comprobación de estado. La directiva health_check envía una comprobación de estado al URI /health cada tres segundos y utiliza las pruebas definidas en el bloque match denominado conditions para comprobar el estado de la instancia del servicio. Una instancia del servicio se marca como no disponible cuando falla una sola comprobación. Las directivas proxy_* envían la comprobación de estado al grupo ascendente resizer, utilizando TLS 1.2 sobre HTTP 1.1 con los encabezados HTTP indicados establecidos en null.
location /health-check-resizer {    internal;
    health_check uri=/health match=conditions fails=1 interval=3s;


    proxy_pass                        https://resizer;
    proxy_ssl_session_reuse           on;
    proxy_ssl_protocols               TLSv1.2;
    proxy_http_version                1.1;
    proxy_set_header Connection       "";
    proxy_set_header Accept-Encoding  "";
}
El siguiente paso es crear el bloque conditions match para especificar las respuestas que representan estados correctos e incorrectos. La primera comprobación corresponde al código de estado de la respuesta: si se encuentra en el intervalo de 200 a 399, la prueba continúa con la siguiente instrucción de evaluación. La segunda comprobación verifica que el valor de Content-Type sea application/json. Por último, la tercera comprobación coteja una expresión regular con el valor de las métricas deadlocks, Disk y Memory. Si todas presentan valores correctos, se determina que el servicio funciona correctamente.
match conditions {    status 200-399;
    header Content-Type ~ "application/json";
    body ~ '{
        "deadlocks":{"healthy":true},
        "Disk":{"healthy":true},
        "Memory":{"healthy":true}
    }';
}
El sistema de disyuntor/comprobación de estado de NGINX Plus también cuenta con una función de inicio lento. El parámetro slow_start de la directiva server para el servicio de redimensionamiento del bloque upstream indica a NGINX Plus que modere el flujo de tráfico cuando una instancia de redimensionamiento se recupera de un estado no saludable. En lugar de saturar de golpe el servicio con el mismo número de solicitudes que se envían a los servicios en buen estado, el tráfico dirigido al servicio en recuperación aumenta gradualmente hasta alcanzar la tasa normal durante el periodo indicado por el parámetro slow_start; en este caso, 30 segundos. El inicio lento aumenta las probabilidades de que el servicio recupere toda su capacidad y, al mismo tiempo, reduce el impacto si esto no sucede.
upstream resizer {    server        resizer slow_start=30s;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}
La limitación de solicitudes gestiona y modera el flujo de solicitudes al servicio. Si conoce lo bastante bien el perfil de fallos de la aplicación como para saber cuántas solicitudes puede gestionar en un momento dado, implementar la limitación de solicitudes puede resultar muy beneficioso para el proceso. Sin embargo, esta función solo es eficaz si NGINX Plus conoce el número total de conexiones que se dirigen al servicio. Por este motivo, lo más útil es implementar el disyuntor de limitación de solicitudes en una instancia de NGINX Plus que se ejecute en un contenedor junto con el propio servicio, como en el modelo Fabric, o en un equilibrador de carga centralizado encargado de gestionar todo el tráfico de un clúster.
El siguiente fragmento de código de configuración define un límite de frecuencia de solicitudes que se aplicará a las instancias del servicio de redimensionamiento en sus contenedores. La directiva limit_req_zone establece el límite de frecuencia en 100 solicitudes por segundo. La variable $server_addr se utiliza como clave, lo que significa que todas las solicitudes que llegan al contenedor de redimensionamiento se contabilizan para el límite. El nombre de la zona es moderateReqs y el periodo durante el que se mantiene el recuento de solicitudes es de 1 minuto. La directiva limit_req permite que NGINX Plus almacene en búfer ráfagas de hasta 150 solicitudes. Cuando se supera esa cifra, los clientes reciben el código de error 503 según lo especificado por la directiva limit_req_status, lo que indica que el servicio no está disponible.
http {    # Moderated delivery
    limit_req_zone $server_addr zone=moderateReqs:1m rate=100r/s;
    # ...
    server {
        # ...
        limit_req zone=moderateReqs burst=150;
        limit_req_status 503;
        # ...
    }
}
Otra gran ventaja de ejecutar el disyuntor dentro de NGINX Plus es la posibilidad de incorporar almacenamiento en caché y mantener los datos almacenados en caché de forma centralizada para utilizarlos en todo el sistema. Esto resulta especialmente útil para servicios orientados a la lectura, como los servidores de contenido, en los que los datos que se leen del backend no cambian con frecuencia.
proxy_cache_path /app/cache levels=1:2 keys_zone=oauth_cache:10m max_size=10m inactive=15s use_temp_path=off;
upstream user-manager {
    server        user-manager;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}

server {
    listen 443 ssl;
    location /v1/users {
        proxy_pass http://user-manager;
        proxy_cache            oauth_cache;
        proxy_cache_valid      200  30s;
        proxy_cache_use_stale  error timeout invalid_header updating
                               http_500 http_502 http_503 http_504;
    }
}
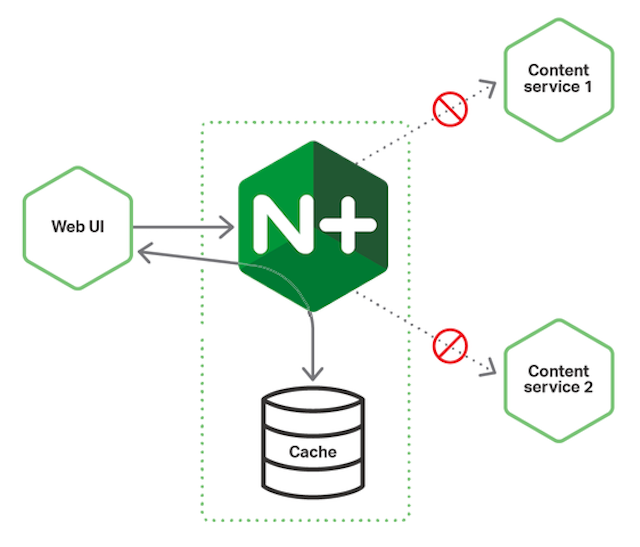
Como se muestra en la Figura 2, el almacenamiento de datos en caché hace que muchas solicitudes de datos de clientes nunca lleguen a las instancias de microservicios, lo que libera capacidad para solicitudes que no se habían recibido anteriormente.
Sin embargo, en un servicio cuyos datos pueden cambiar, como un servicio de gestión de usuarios, la caché debe administrarse con prudencia. De lo contrario, puede darse una situación en la que un usuario modifique su perfil, pero vea datos antiguos en determinados contextos porque están almacenados en caché. Establecer un tiempo de espera razonable y aceptar el principio de alta disponibilidad con consistencia eventual puede resolver este dilema.
Una de las interesantes funciones de la caché de NGINX es que puede seguir sirviendo datos almacenados en caché aunque el servicio no esté disponible en absoluto; en el fragmento anterior, esto ocurre si el servicio responde con uno de los cuatro códigos de error más habituales de la serie 500.
El almacenamiento en caché no es la única opción para responder a los clientes cuando un servidor está caído. Como mencionamos en El patrón de disyuntor aporta flexibilidad, uno de nuestros clientes necesitaba una solución resiliente para el caso de que su servidor de anuncios personalizados dejara de funcionar, y las respuestas almacenadas en caché no eran una buena solución. En su lugar, querían que un servidor de anuncios genéricos proporcionara anuncios genéricos hasta que el servidor personalizado volviera a estar disponible. Esto se consigue fácilmente mediante el parámetro backup de la directiva server. El siguiente fragmento especifica que, cuando todos los servidores definidos para el dominio personal-ad-server no están disponibles, se utilizan en su lugar los servidores definidos para el dominio generic-ad-server.
upstream personal-ad-server {    server        personal-ad-server;
    server        generic-ad-server backup;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}
Y, por último, es posible hacer que NGINX evalúe los códigos de respuesta de un servicio y los gestione de forma individual. En el siguiente fragmento, si un servicio devuelve un error 503, NGINX Plus envía la solicitud a un servicio alternativo. Por ejemplo, si el redimensionador dispone de esta función y la instancia local está sobrecargada o deja de funcionar, las solicitudes se envían a otra instancia del redimensionador.
location / {    error_page 503 = @fallback;
}

location @fallback {
    proxy_pass http://alternative-backend;
}
Conclusión
El patrón de disyuntor es una herramienta muy eficaz para aportar resiliencia y control a su aplicación de microservicios. NGINX Plus ofrece numerosas funciones y opciones para implementar el disyuntor en su entorno. La clave para implementar este patrón consiste en comprender el perfil de fallos del servicio que se desea proteger y, a continuación, elegir las opciones que mejor prevengan los fallos, cuando sea posible, y que mejor mitiguen sus efectos cuando se produzcan.
Para probar NGINX Plus, inicie hoy mismo su prueba gratuita de 30 días o póngase en contacto con nosotros para hablar sobre sus casos de uso.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.