El tiempo de inactividad puede tener graves consecuencias.
Estas palabras son más ciertas para las empresas del sector de la tecnología médica que para las de la mayoría de los demás sectores: en su caso, las «graves consecuencias» pueden incluir literalmente la muerte. Recientemente tuvimos la oportunidad de analizar en profundidad la infraestructura tecnológica de una empresa que pretende transformar el mantenimiento de historiales médicos, pasando del papel y el bolígrafo a datos digitales seguros y accesibles en cualquier momento y lugar del mundo. Estos datos abarcan desde la información de los pacientes hasta las directrices asistenciales, los marcadores biológicos, los análisis médicos, los historiales y cualquier otra información que compartan los equipos sanitarios.
Desde el principio, la empresa ha tratado de responder a una pregunta aparentemente sencilla: «¿Cómo podemos ayudar al personal asistencial a registrar datos fácilmente y en tiempo real?». Sin embargo, a medida que la empresa ha crecido, la necesidad de ampliar la capacidad y garantizar que los datos estén disponibles en todo momento ha hecho que resolver este reto sea cada vez más complejo. A continuación, explicamos cómo la evolución tecnológica de la empresa la ha llevado a adoptar Kubernetes y NGINX Ingress Controller.
Resumen de la pila tecnológica
- SO – Linux
- Orquestación de contenedores – Microsoft Azure Kubernetes Service
- Redes – Kubernetes, Controlador de entrada NGINX basado en NGINX Plus
- Lenguaje/framework de desarrollo de software – .Net
- Monitorización, observabilidad y alertas – Prometheus
- Panel de monitorización – Grafana
- Registro – Grafana Loki
- Base de datos – Azure SQL Service
- Servidor de aplicaciones – Azure App Service, .NET
- Mensajería y streaming: Azure Event Hubs
- Almacenamiento en caché – Redis
- Seguridad – NGINX App Protect
- Ubicación e infraestructura: dos zonas de disponibilidad, 2 clústeres de Kubernetes, entre 15 y 20 nodos y entre 60 y 100 pods
- DevOps – Azure DevOps Services
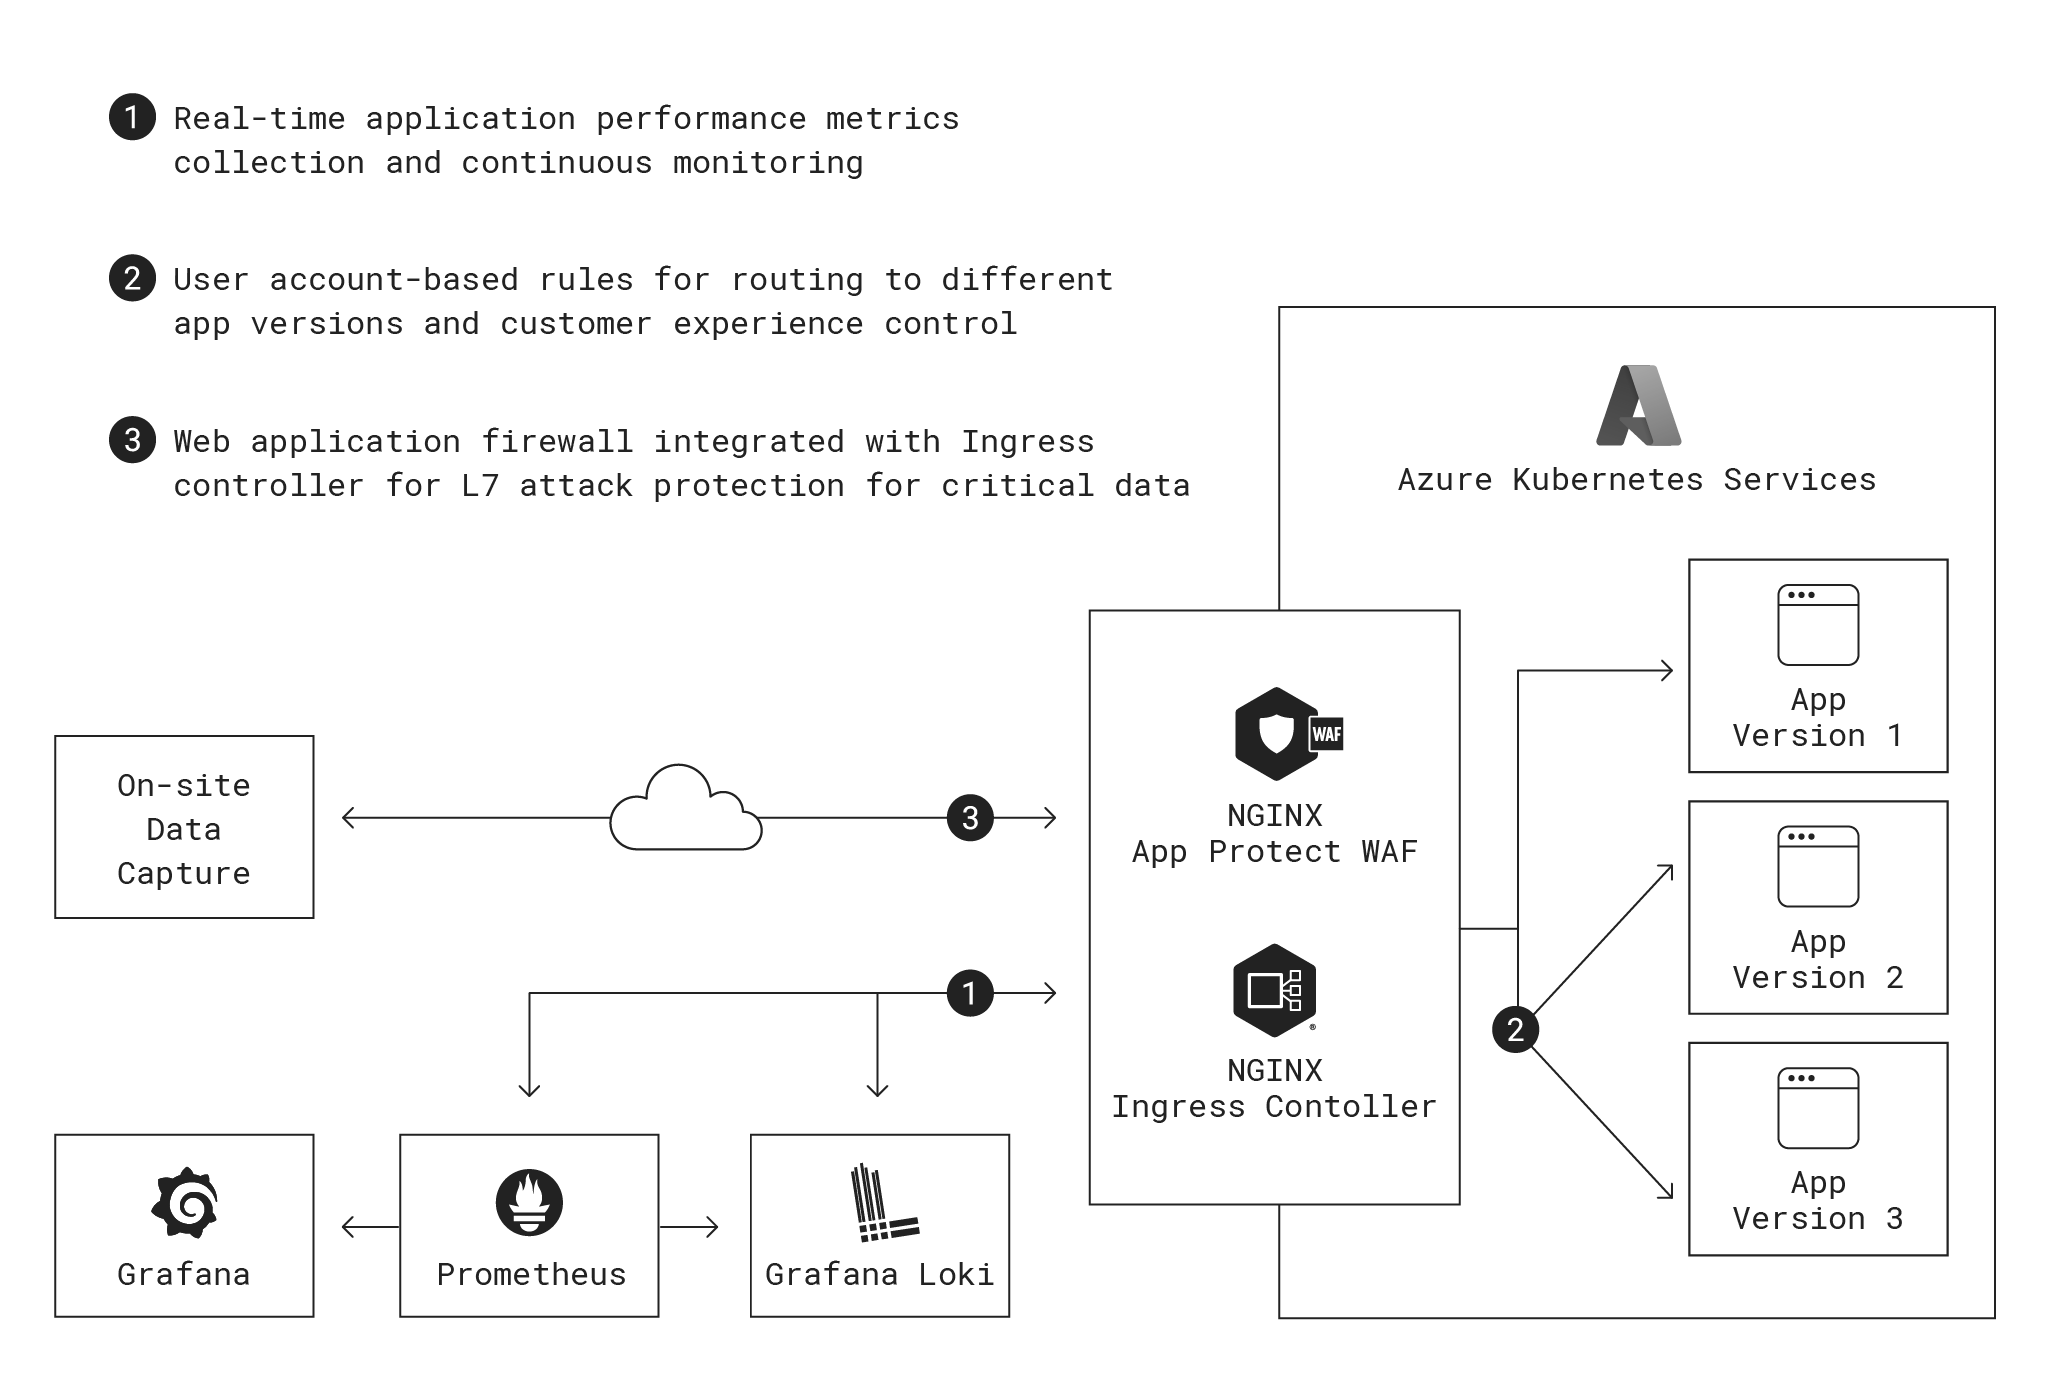
Veamos cómo encaja NGINX en su arquitectura:
El problema del papel
Registrar periódicamente el estado de los pacientes y la información sobre su atención es una tarea fundamental del personal sanitario. Tradicionalmente, esta información se ha anotado en papel o, más recientemente, en un ordenador portátil o una tableta. Esto presenta un par de inconvenientes importantes:
- Los profesionales sanitarios pueden atender a decenas de pacientes al día, por lo que no suele ser práctico tomar notas detalladas mientras prestan asistencia. Como consecuencia, acaban redactando sus notas al final del turno. Para entonces, el cansancio físico y mental puede llevarles a registrar únicamente comentarios genéricos.
- Los profesionales también deben confiar en su memoria para recordar detalles sobre el comportamiento de los pacientes. Las imprecisiones podrían ocultar patrones que, si se documentaran de forma correcta y sistemática a lo largo del tiempo, facilitarían el diagnóstico de problemas de salud más graves.
- Los registros en papel no se pueden compartir fácilmente entre las distintas áreas de un mismo departamento, y mucho menos con otras entidades, como los técnicos de emergencias sanitarias, el personal de urgencias y las compañías de seguros. La situación no mejora mucho si se utilizan ordenadores portátiles o tabletas que no están conectados a un repositorio central de datos o a la nube.
Para abordar estos retos, la empresa creó un sistema simplificado de registro de datos que ofrece accesos directos para consultar la información de los pacientes y registrar acciones habituales, como la administración de medicamentos. Esta facilidad de acceso y uso permite registrar las interacciones con los pacientes en tiempo real, a medida que se producen.
Todos los datos se almacenan en sistemas en la nube gestionados por la empresa, y la aplicación se integra con otros sistemas de historias clínicas electrónicas para ofrecer una visión longitudinal completa del comportamiento de los residentes. Esto ayuda a los cuidadores a garantizar una mayor continuidad asistencial, crea un historial seguro y permite compartir fácilmente la información con otros sistemas de software sanitario.
Los médicos y otros especialistas también utilizan la plataforma al ingresar a los pacientes o al interactuar con ellos de cualquier otro modo. Existe un registro de sus preferencias y necesidades personales que acompaña al paciente a cualquier centro. Esta información puede utilizarse para ayudar a los pacientes a sentirse cómodos en un entorno nuevo, lo que mejora resultados como el tiempo de recuperación.
Existen estrictos requisitos legales sobre el tiempo durante el cual las empresas deben conservar los datos de los pacientes. Los desarrolladores de la empresa han creado el software para ofrecer una disponibilidad extremadamente alta, con acuerdos de nivel de servicio (SLA) de tiempo de actividad muy superiores a los de las aplicaciones genéricas en la nube. No es aceptable hacer esperar a una ambulancia porque no se pueda cargar el expediente de un paciente.
El viaje del garaje a la nube y a Kubernetes
Como muchas empresas emergentes, al principio la empresa ahorró costes ejecutando la primera aplicación de prueba de concepto en un servidor ubicado en la casa de uno de los cofundadores. Cuando quedó claro que la idea tenía potencial, trasladó su infraestructura a la nube en lugar de gestionar hardware en un centro de datos. Dado que trabajaba con tecnologías de Microsoft, eligió Azure. La arquitectura inicial ejecutaba las aplicaciones en máquinas virtuales (VM) tradicionales mediante Azure App Service, un servicio gestionado de entrega de aplicaciones que utiliza el servidor web IIS de Microsoft. Para almacenar y recuperar datos, la empresa optó por utilizar SQL Server de Microsoft, ejecutado en una VM como aplicación gestionada.
Tras varios años operando en la nube, la empresa crecía rápidamente y empezaba a sufrir problemas de escalabilidad. Necesitaba poder escalar sin límites y de forma horizontal, en lugar de vertical, ya que esta última opción es lenta y costosa con máquinas virtuales. Este requisito llevó de forma bastante natural a considerar la contenerización y Kubernetes como una posible solución. Otro punto a favor de la contenerización era que los desarrolladores de la empresa necesitaban publicar con frecuencia actualizaciones de la aplicación y la infraestructura sin arriesgarse a provocar interrupciones del servicio. Dado que se añaden constantemente notas de pacientes desde distintas zonas horarias, no existe ningún periodo natural de inactividad en el que implementar cambios en producción sin el riesgo de que los clientes se vean afectados de inmediato por posibles fallos.
Un punto de partida lógico para la empresa fue la oferta de Kubernetes administrado de Microsoft, Azure Kubernetes Services (AKS). El equipo investigó las prácticas recomendadas de Kubernetes y se dio cuenta de que necesitaba un controlador de Ingress delante de sus clústeres de Kubernetes para gestionar eficazmente el tráfico y las aplicaciones que se ejecutaban en nodos y pods de AKS.
El enrutamiento del tráfico debe ser flexible y preciso
El equipo probó el controlador Ingress predeterminado de AKS, pero descubrió que sus funciones de enrutamiento del tráfico no permitían distribuir las actualizaciones a los clientes de la empresa de la forma necesaria. Cuando se trata de la atención al paciente, no hay margen para la ambigüedad ni para la información contradictoria: por ejemplo, es inaceptable que un profesional sanitario vea una alerta naranja y otro una alerta roja para el mismo evento. Por tanto, todos los usuarios de una organización determinada deben utilizar la misma versión de la aplicación. Esto plantea un gran reto a la hora de realizar actualizaciones. No existe un momento idóneo para migrar a un cliente a una nueva versión, por lo que la empresa necesitaba una forma de aplicar reglas en el servidor y en la red para dirigir a distintos clientes a diferentes versiones de la aplicación.
Para lograrlo, la empresa utiliza la misma plataforma de backend para todos los usuarios de una organización y no ofrece un entorno multiinquilino con segmentación en la capa de infraestructura dentro de la organización. Con Kubernetes, es posible dividir el tráfico mediante rutas de red virtuales y cookies en los navegadores, junto con reglas de tráfico detalladas. Sin embargo, el equipo técnico de la empresa descubrió que el controlador Ingress predeterminado de AKS solo permite dividir el tráfico por porcentajes, y no mediante reglas que se apliquen a nivel de organización cliente o de usuario individual, como se requiere.
En su configuración básica, NGINX Ingress Controller basado en NGINX Open Source presenta la misma limitación, por lo que la empresa decidió pasarse a la versión más avanzada de NGINX Ingress Controller basada en NGINX Plus, un producto de nivel empresarial que permite un control granular del tráfico. Las recomendaciones de Microsoft y de la comunidad de Kubernetes a favor de NGINX Ingress Controller, debido a su alto grado de flexibilidad y control, contribuyeron a afianzar esta elección. La configuración se adapta mejor a las necesidades de gestión de pods de la empresa (frente a la gestión clásica del tráfico), ya que garantiza que los pods se ejecuten en las zonas adecuadas y que el tráfico se dirija a esos servicios. En ocasiones, el tráfico se enruta internamente, pero, en la mayoría de los casos de uso, vuelve a salir a través de NGINX Ingress Controller por motivos de observabilidad.
Territorio inexplorado: monitorización, observabilidad y rendimiento de las aplicaciones
Con NGINX Ingress Controller, el equipo técnico tiene un control total sobre la experiencia de los desarrolladores y los usuarios finales. Una vez que los usuarios inician sesión y establecen una sesión, se les puede dirigir inmediatamente a una nueva versión o devolverlos a una anterior. Los parches se pueden distribuir de forma simultánea y casi instantánea a todos los usuarios de una organización. El software no depende de la propagación de DNS ni de las actualizaciones de red en toda la plataforma en la nube.
NGINX Ingress Controller también cumple el requisito de la empresa de disponer de una supervisión granular y continua. El rendimiento de las aplicaciones es sumamente importante en el ámbito sanitario. La latencia o el tiempo de inactividad pueden dificultar una atención clínica eficaz, especialmente en situaciones de vida o muerte. Tras la migración a Kubernetes, los clientes empezaron a informar de periodos de inactividad que la empresa no había detectado. La empresa no tardó en descubrir el origen del problema: Azure App Service se basa en datos obtenidos mediante muestreo. El muestreo resulta adecuado para calcular promedios e identificar tendencias generales, pero pasa completamente por alto aspectos como las solicitudes rechazadas y los recursos ausentes. Tampoco muestra los picos de uso que suelen producirse cada media hora cuando el personal sanitario inicia sesión y registra los datos de los pacientes. La empresa solo obtenía una visión incompleta de la latencia, los orígenes de los errores, las solicitudes incorrectas y la falta de disponibilidad del servicio.
Los problemas no acabaron ahí. De forma predeterminada, Azure App Service conserva los datos almacenados durante solo un mes, un periodo muy inferior a las decenas de años que exige la legislación de muchos países. Ampliar el almacenamiento de datos para conservarlos durante más tiempo resultaba prohibitivamente caro. Además, la solución de Azure no puede ver el interior de la pila de red de Kubernetes. NGINX Ingress Controller puede supervisar tanto los parámetros de la infraestructura como los de las aplicaciones mientras gestiona el tráfico de las capas 4 y 7.
Para la supervisión del rendimiento y la observabilidad, la empresa eligió una base de datos de series temporales Prometheus conectada a un motor de visualización y un panel de Grafana. La integración con Prometheus y Grafana viene incorporada en los planos de datos y de control de NGINX; el equipo técnico solo tuvo que realizar un pequeño cambio de configuración para dirigir todo el tráfico a través de los servidores de Prometheus y Grafana. La información también se envió a una base de datos de registros Grafana Loki para facilitar el análisis de los registros y proporcionar al equipo de software un mayor control de los datos a lo largo del tiempo.
Esta configuración también está preparada para afrontar en el futuro incidentes que requieran un muestreo de datos de gran volumen y con una frecuencia extremadamente alta para diagnosticar problemas y corregir errores. Abordar este tipo de incidentes podría resultar costoso con los sistemas de monitorización de aplicaciones que ofrecen la mayoría de las grandes empresas de servicios en la nube, pero el coste y la sobrecarga de Prometheus, Grafana y Loki en este caso de uso son mínimos. Los tres son productos de código abierto estables que, por lo general, apenas requieren más que la aplicación de parches tras el ajuste inicial.
Mantener el rumbo: un enfoque centrado en la alta disponibilidad y la seguridad
La empresa siempre se ha centrado en dos aspectos: la seguridad, para proteger uno de los tipos de datos más sensibles que existen, y la alta disponibilidad para garantizar que la aplicación esté disponible siempre que se necesite. Durante la migración a Kubernetes, realizaron algunos cambios para reforzar ambas capacidades.
Para lograr la máxima disponibilidad, el equipo técnico implementa un diseño de infraestructura distribuida activo-activo, multizona y multirregión que ofrece redundancia completa sin ningún punto único de fallo. El equipo mantiene una infraestructura activo-activo N+2 con dos clústeres de Kubernetes en dos regiones geográficas distintas. En cada región, el software se distribuye entre varios centros de datos para reducir el riesgo de inactividad y garantizar la continuidad ante cualquier fallo en cualquier capa de la infraestructura. Las reglas de afinidad y antiafinidad permiten redirigir al instante a los usuarios y el tráfico hacia pods operativos para evitar interrupciones del servicio.
Para garantizar la seguridad, el equipo implementa un cortafuegos de aplicaciones web (WAF) para protegerse frente a solicitudes maliciosas y agentes malintencionados. La protección frente al Top 10 de OWASP es un requisito básico que ofrecen la mayoría de los WAF. Durante el desarrollo de la aplicación, el equipo evaluó varios WAF, incluidos el WAF nativo de Azure y ModSecurity. Finalmente, eligió NGINX App Protect, con su WAF en línea y protección frente a ataques distribuidos de denegación de servicio (DDoS).
Una gran ventaja de NGINX App Protect es que está ubicado junto a NGINX Ingress Controller, lo que elimina un punto de redundancia y reduce la latencia. Otros WAF deben implementarse fuera del entorno de Kubernetes, lo que aumenta la latencia y los costes. Incluso los retrasos ínfimos (por ejemplo, 1 milisegundo adicional por solicitud) se acumulan rápidamente con el tiempo.
Misión secundaria sorpresa: cero tiempo de inactividad para los desarrolladores
Tras completar la transición a AKS de la mayor parte de su infraestructura de aplicaciones y redes, la empresa también ha logrado mejoras significativas en la experiencia de desarrollo (DevEx). Ahora, los desarrolladores casi siempre detectan los problemas antes de que los propios clientes perciban cualquier incidencia. Desde el cambio, el volumen de llamadas al servicio de asistencia por errores se ha reducido aproximadamente un 80 %.
Los equipos de seguridad y rendimiento de aplicaciones de la empresa disponen de un panel detallado de Grafana y de un sistema de alertas unificado, lo que elimina la necesidad de consultar varios sistemas o configurar activadores para los mensajes de advertencia y las llamadas procedentes de distintos procesos. Los equipos de desarrollo y DevOps ahora pueden desplegar actualizaciones de código e infraestructura a diario, o incluso varias veces al día, y utilizar patrones blue-green extremadamente granulares. Antes, desplegaban actualizaciones una o dos veces por semana y tenían que programarlas en franjas de baja actividad, lo que resultaba estresante. Ahora, el código se despliega cuando está listo y los desarrolladores pueden supervisar su impacto directamente observando el comportamiento de la aplicación.
Los resultados son positivos en todos los sentidos: mayor velocidad de desarrollo de software, una mejora de la moral de los desarrolladores y más vidas salvadas.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.