Es bien sabido que NGINX utiliza un enfoque asíncrono y basado en eventos para gestionar las conexiones. Esto significa que, en lugar de crear otro proceso o hilo dedicado para cada solicitud (como hacen los servidores con una arquitectura tradicional), gestiona múltiples conexiones y solicitudes en un único proceso de trabajo. Para lograrlo, NGINX utiliza sockets en modo no bloqueante y métodos eficientes como epoll y kqueue.
Dado que el número de procesos completos es reducido (normalmente solo uno por núcleo de CPU) y constante, se consume mucha menos memoria y no se desperdician ciclos de CPU en cambios de tarea. Las ventajas de este enfoque son bien conocidas gracias al propio ejemplo de NGINX, que gestiona con éxito millones de solicitudes simultáneas y ofrece una excelente escalabilidad.
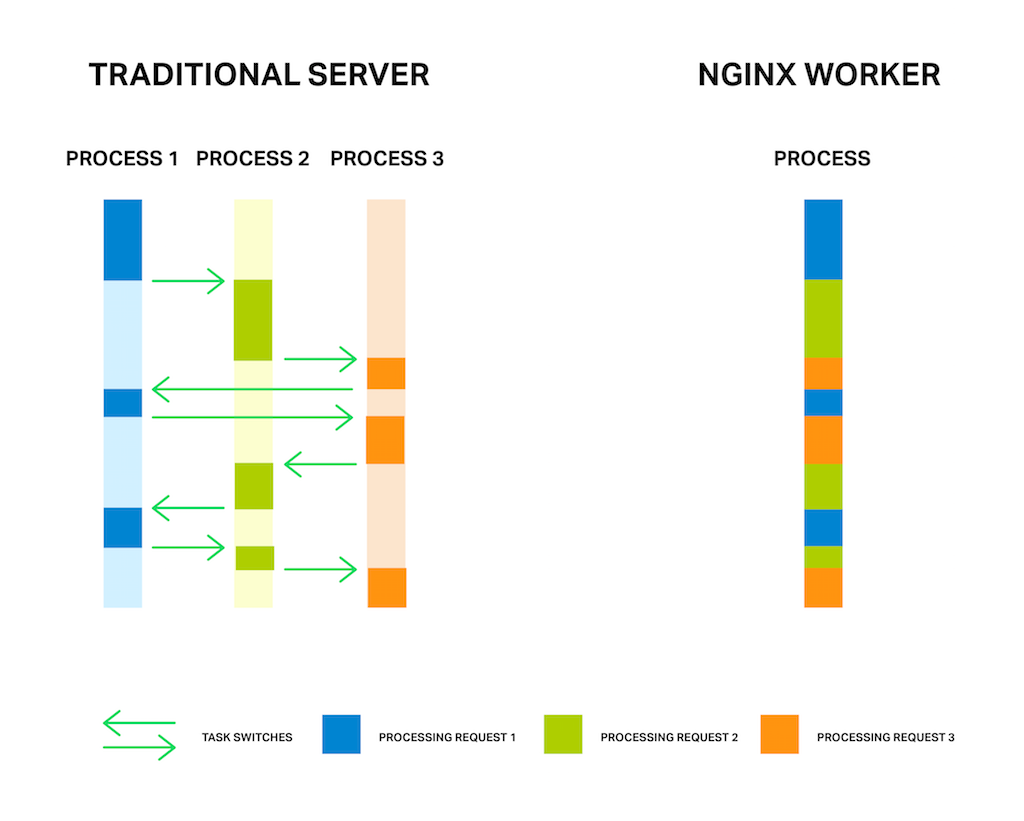
Sin embargo, el enfoque asíncrono basado en eventos sigue teniendo un problema. O, como me gusta considerarlo, un «enemigo». Y el nombre del enemigo es: bloqueo. Por desgracia, muchos módulos de terceros utilizan llamadas bloqueantes, y los usuarios (y, a veces, incluso los desarrolladores de los módulos) no son conscientes de sus inconvenientes. Las operaciones bloqueantes pueden arruinar el rendimiento de NGINX y deben evitarse a toda costa.
Incluso en el código oficial actual de NGINX no es posible evitar las operaciones de bloqueo en todos los casos. Para resolver este problema, el nuevo mecanismo de «grupos de subprocesos» se implementó en la versión 1.7.11 de NGINX y en NGINX Plus Release 7. Más adelante veremos en qué consiste y cómo debe utilizarse. Ahora enfrentémonos cara a cara con nuestro enemigo.
Editor: Para obtener una visión general de NGINX Plus R7, consulte «Presentamos NGINX Plus R7» en nuestro blog.
Para obtener información detallada sobre otras funciones nuevas de NGINX Plus R7, consulte estas entradas relacionadas del blog:
- NGINX Plus ya es totalmente compatible con HTTP/2
- Fragmentación de sockets en NGINX
- El nuevo panel de NGINX Plus en la versión 7<.htmla>
- Equilibrado de carga TCP en NGINX Plus R7<.htmla>
El problema
En primer lugar, para comprender mejor el problema, conviene explicar brevemente cómo funciona NGINX.
En general, NGINX es un gestor de eventos, un controlador que recibe información del núcleo sobre todos los eventos que se producen en las conexiones y, a continuación, indica al sistema operativo qué debe hacer. De hecho, NGINX realiza todo el trabajo complejo orquestando el sistema operativo, mientras que este se encarga de las tareas rutinarias de leer y enviar bytes. Por eso, es muy importante que NGINX responda con rapidez y en el momento oportuno.
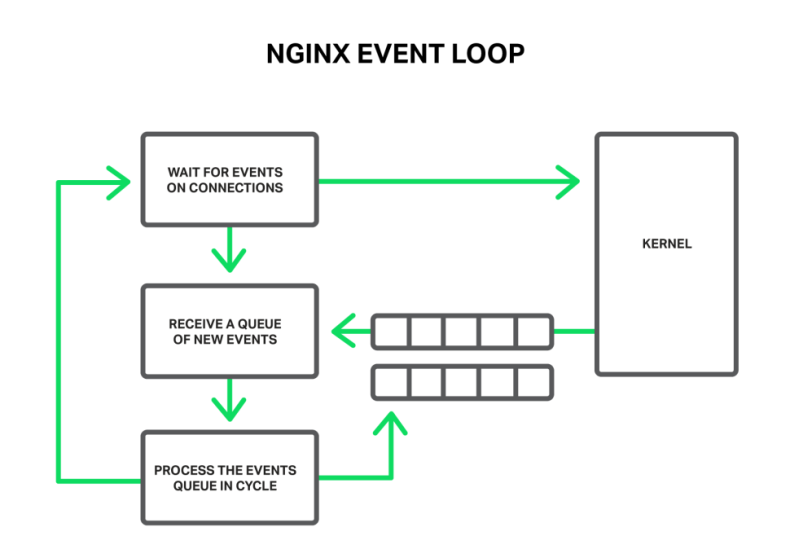
Los eventos pueden ser tiempos de espera agotados, notificaciones de sockets listos para lectura o escritura, o notificaciones de errores que se hayan producido. NGINX recibe un conjunto de eventos y los procesa uno a uno, realizando las acciones necesarias. Así, todo el procesamiento se lleva a cabo en un único hilo mediante un sencillo bucle que recorre una cola. NGINX extrae un evento de la cola y reacciona ante él, por ejemplo, escribiendo en un socket o leyéndolo. En la mayoría de los casos, este proceso es extremadamente rápido (quizá solo requiera unos pocos ciclos de CPU para copiar algunos datos en la memoria), por lo que NGINX procesa todos los eventos de la cola en un instante.
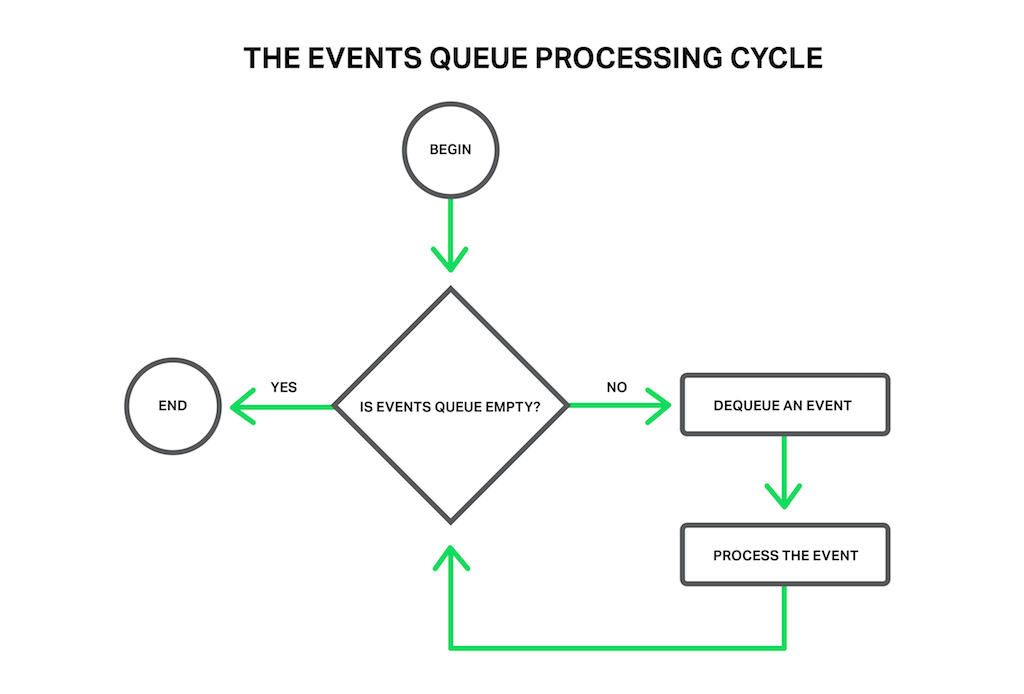
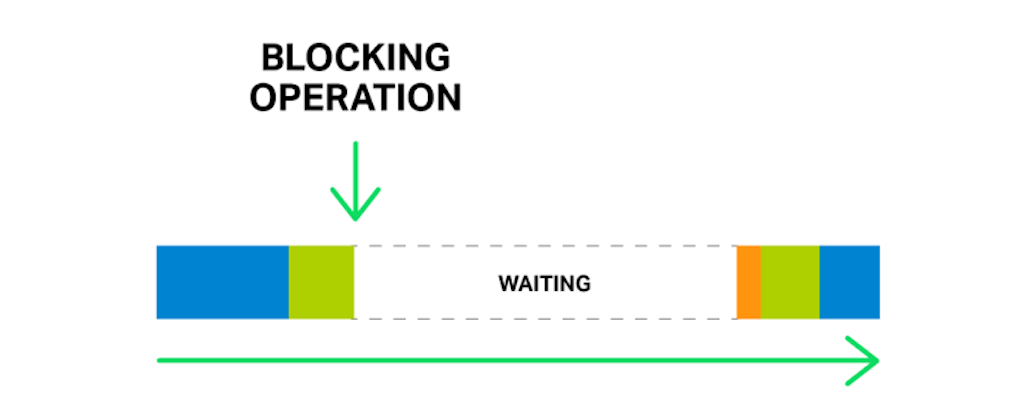
Pero ¿qué ocurrirá si se ejecuta alguna operación larga y pesada? Todo el ciclo de procesamiento de eventos se quedará bloqueado esperando a que finalice.
Así pues, cuando hablamos de «una operación bloqueante», nos referimos a cualquier operación que detenga el ciclo de procesamiento de eventos durante un periodo de tiempo considerable. Las operaciones pueden ser bloqueantes por diversos motivos. Por ejemplo, NGINX podría estar ocupado realizando un procesamiento prolongado e intensivo en el uso de la CPU, o podría tener que esperar para acceder a un recurso (como un disco duro, un mutex o una llamada a una función de biblioteca que obtiene respuestas de una base de datos de forma síncrona, etc.). La cuestión clave es que, mientras procesa este tipo de operaciones, el proceso de trabajo no puede hacer nada más ni gestionar otros eventos, aunque haya más recursos del sistema disponibles y algunos eventos de la cola pudieran utilizarlos.
Imagine a un dependiente en una tienda con una larga cola delante. La primera persona de la cola pide algo que no está en la tienda, sino en el almacén. El dependiente va al almacén a buscar el producto. Ahora toda la cola debe esperar un par de horas hasta que vuelva y todos están descontentos. ¿Se imagina cómo reaccionará la gente? El tiempo de espera de cada persona de la cola aumenta en esas horas, aunque los artículos que quieren comprar podrían estar allí mismo, en la tienda.
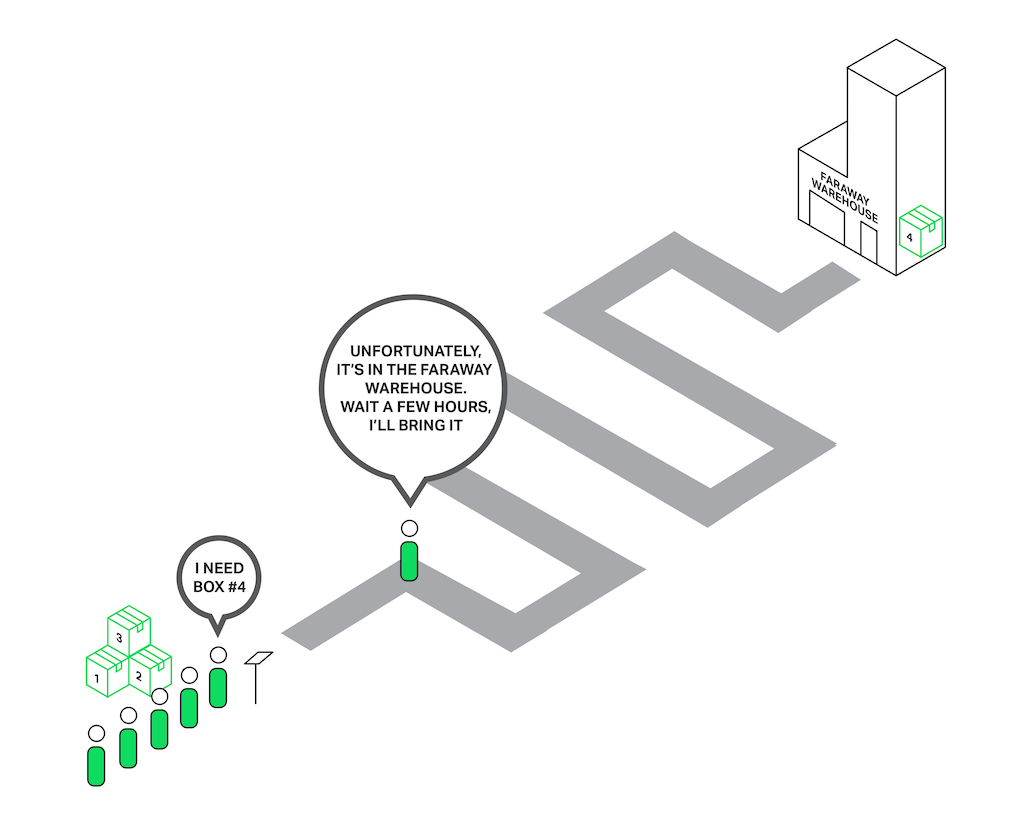
Con NGINX ocurre una situación muy similar cuando solicita leer un archivo que no está almacenado en la caché de memoria y debe leerse desde el disco. Los discos duros son lentos (especialmente los mecánicos) y, aunque las demás solicitudes que esperan en la cola quizá no necesiten acceder al disco, se ven obligadas a esperar de todos modos. Como resultado, aumenta la latencia y no se aprovechan al máximo los recursos del sistema.
Algunos sistemas operativos proporcionan una interfaz asíncrona para leer y enviar archivos, y NGINX puede utilizarla (consulte la directiva aio). FreeBSD es un buen ejemplo. Por desgracia, no podemos decir lo mismo de Linux. Aunque Linux proporciona una especie de interfaz asíncrona para leer archivos, presenta un par de inconvenientes importantes. Uno de ellos son los requisitos de alineación para el acceso a archivos y los búferes, pero NGINX los gestiona correctamente. Sin embargo, el segundo problema es más grave. La interfaz asíncrona requiere que se establezca la marca O_DIRECT en el descriptor de archivo, lo que significa que cualquier acceso al archivo omitirá la caché en memoria y aumentará la carga de los discos duros. Sin duda, esto hace que no sea la opción más adecuada en muchos casos.
Para resolver este problema en concreto, se introdujeron grupos de subprocesos en NGINX 1.7.11 y NGINX Plus versión 7.
Ahora profundicemos en qué son los grupos de hilos y cómo funcionan.
Grupos de hilos
Volvamos a nuestro pobre dependiente, que trae productos de un almacén lejano. Pero se ha vuelto más listo (¿o quizá espabiló después de que lo apaleara una multitud de clientes enfadados?) y ha contratado un servicio de reparto. Ahora, cuando alguien pide algo del almacén lejano, en lugar de ir él mismo, simplemente encarga el pedido a un servicio de reparto, que se ocupa de gestionarlo mientras nuestro dependiente sigue atendiendo a otros clientes. De este modo, solo esperan la entrega aquellos clientes cuyos productos no están en la tienda, mientras que los demás pueden ser atendidos de inmediato.
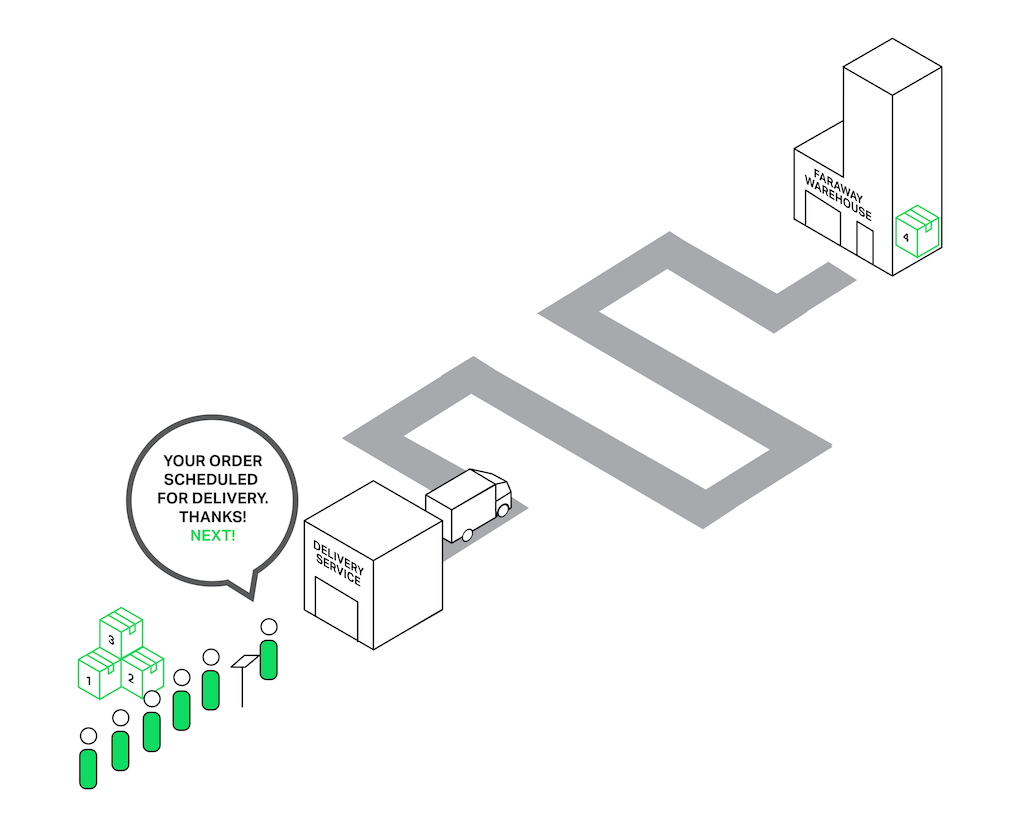
En el contexto de NGINX, el grupo de hilos desempeña las funciones del servicio de entrega. Consta de una cola de tareas y de varios hilos que procesan dicha cola. Cuando un proceso de trabajo necesita realizar una operación que puede llevar mucho tiempo, en lugar de procesarla por sí mismo, coloca una tarea en la cola del grupo, de donde cualquier hilo libre puede tomarla y procesarla.
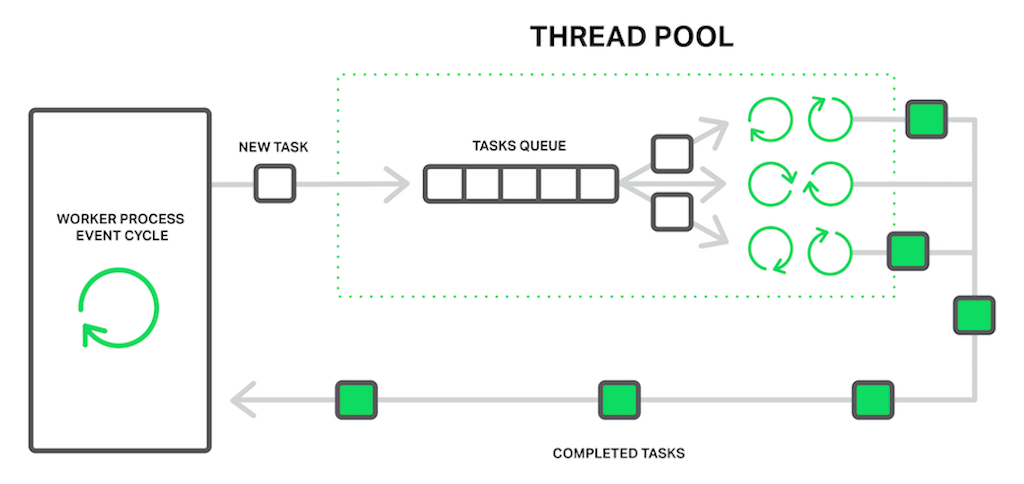
Parece, entonces, que tenemos otra cola. Así es. Pero, en este caso, la cola está limitada por un recurso específico. No podemos leer de una unidad más rápido de lo que esta es capaz de proporcionar datos. Ahora, al menos, la unidad no retrasa el procesamiento de otros eventos y solo quedan a la espera las solicitudes que necesitan acceder a archivos.
La operación de «lectura desde el disco» suele utilizarse como el ejemplo más habitual de una operación bloqueante, pero, en realidad, la implementación de grupos de hilos de NGINX puede utilizarse para cualquier tarea que no sea adecuado procesar en el ciclo de trabajo principal.
Por el momento, la delegación en grupos de subprocesos solo está implementada para tres operaciones esenciales: la llamada al sistema read() en la mayoría de los sistemas operativos, sendfile() en Linux y aio_write() en Linux, que se utiliza al escribir algunos archivos temporales, como los de la caché. Seguiremos probando y evaluando el rendimiento de la implementación, y es posible que en futuras versiones deleguemos otras operaciones en los grupos de subprocesos si ello aporta una ventaja clara.
Nota del editor: La compatibilidad con la aio_write() llamada al sistema se añadió en NGINX 1.9.13 y NGINX Plus R9.
Pruebas de rendimiento
Es hora de pasar de la teoría a la práctica. Para demostrar el efecto del uso de grupos de subprocesos, vamos a realizar una prueba de rendimiento sintética que simula la peor combinación de operaciones bloqueantes y no bloqueantes.
Para ello se necesita un conjunto de datos que, con toda seguridad, no quepa en memoria. En un equipo con 48 GB de RAM, hemos generado 256 GB de datos aleatorios en archivos de 4 MB y, a continuación, hemos configurado NGINX 1.9.0 para servirlos.
La configuración es bastante sencilla:
worker_processes 16;
events {
    accept_mutex off;
}

http {
    include mime.types;
    default_type application/octet-stream;

    access_log off;
    sendfile on;
    sendfile_max_chunk 512k;

    server {
        listen 8000;

        location / {
            root /storage;
        }
    }
}
Como puede ver, se realizaron algunos ajustes para mejorar el rendimiento: logging y accept_mutex se desactivaron, sendfile se activó y se configuró sendfile_max_chunk. Esta última directiva puede reducir el tiempo máximo empleado en llamadas bloqueantes a sendfile(), ya que NGINX no intentará enviar el archivo completo de una sola vez, sino que lo hará en bloques de 512 KB.
La máquina cuenta con dos procesadores Intel Xeon E5645 (12 núcleos y 24 hilos HT en total) y una interfaz de red de 10 Gbps. El subsistema de discos está compuesto por cuatro discos duros Western Digital WD1003FBYX configurados en una matriz RAID10. Todo este hardware funciona con Ubuntu Server 14.04.1 LTS.
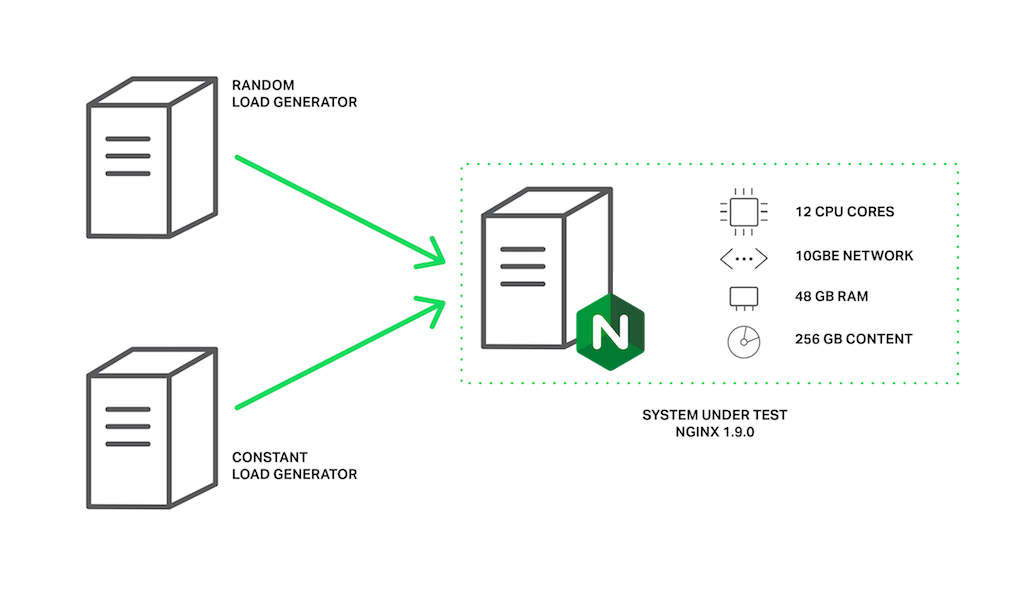
Los clientes están representados por dos máquinas con las mismas especificaciones. En una de ellas, wrk genera carga mediante un script de Lua. El script solicita archivos a nuestro servidor en orden aleatorio utilizando 200 conexiones paralelas, y es probable que cada solicitud provoque un fallo de caché y una lectura bloqueante del disco. Llamaremos a esta carga carga aleatoria.
En la segunda máquina cliente ejecutaremos otra instancia de wrk que solicitará el mismo archivo repetidamente mediante 50 conexiones paralelas. Como se accederá a este archivo con frecuencia, permanecerá en memoria en todo momento. En circunstancias normales, NGINX atendería estas solicitudes muy rápidamente, pero el rendimiento disminuirá si los procesos de trabajo quedan bloqueados por otras solicitudes. Llamaremos a esta carga la carga constante.
El rendimiento se medirá supervisando el caudal de la máquina del servidor mediante ifstat y obteniendo los resultados de wrk del segundo cliente.
Ahora, la primera ejecución sin grupos de subprocesos no arroja resultados demasiado interesantes:
% ifstat -bi eth2eth2
Kbps in  Kbps out
5531.24  1.03e+06
4855.23  812922.7
5994.66  1.07e+06
5476.27  981529.3
6353.62  1.12e+06
5166.17  892770.3
5522.81  978540.8
6208.10  985466.7
6370.79  1.12e+06
6123.33  1.07e+06
Como puede ver, con esta configuración el servidor es capaz de generar aproximadamente 1 Gbps de tráfico en total. En la salida de top, podemos ver que todos los procesos de trabajo pasan la mayor parte del tiempo en operaciones de E/S bloqueantes (se encuentran en estado D):
top - 10:40:47 up 11 days,  1:32,  1 user,  load average: 49.61, 45.77 62.89Tasks: 375 total,  2 running, 373 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.0 us,  0.3 sy,  0.0 ni, 67.7 id, 31.9 wa,  0.0 hi,  0.0 si,  0.0 st
KiB Mem:  49453440 total, 49149308 used,   304132 free,    98780 buffers
KiB Swap: 10474236 total,    20124 used, 10454112 free, 46903412 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4639 vbart    20   0   47180  28152     496 D   0.7  0.1  0:00.17 nginx
 4632 vbart    20   0   47180  28196     536 D   0.3  0.1  0:00.11 nginx
 4633 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.11 nginx
 4635 vbart    20   0   47180  28136     480 D   0.3  0.1  0:00.12 nginx
 4636 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.14 nginx
 4637 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.10 nginx
 4638 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4640 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4641 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4642 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.11 nginx
 4643 vbart    20   0   47180  28276     536 D   0.3  0.1  0:00.29 nginx
 4644 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.11 nginx
 4645 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.17 nginx
 4646 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4647 vbart    20   0   47180  28208     532 D   0.3  0.1  0:00.17 nginx
 4631 vbart    20   0   47180    756     252 S   0.0  0.1  0:00.00 nginx
 4634 vbart    20   0   47180  28208     536 D   0.0  0.1  0:00.11 nginx< 4648 vbart 20 0 25232 1956 1160 R 0.0 0.0 0:00.08 top
25921 vbart    20   0  121956   2232    1056 S   0.0  0.0  0:01.97 sshd
25923 vbart    20   0   40304   4160    2208 S   0.0  0.0  0:00.53 zsh
En este caso, el rendimiento está limitado por el subsistema de disco, mientras que la CPU permanece inactiva la mayor parte del tiempo. Los resultados de wrk también son muy bajos:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg    Stdev     Max  +/- Stdev
    Latency     7.42s  5.31s   24.41s   74.73%
    Req/Sec     0.15    0.36     1.00    84.62%
  488 requests in 1.01m, 2.01GB read
Requests/sec:      8.08
Transfer/sec:     34.07MB
Y recuerde: ¡esto corresponde al archivo que debería servirse desde la memoria! Las latencias excesivamente altas se deben a que todos los procesos de trabajo están ocupados leyendo archivos de las unidades para atender la carga aleatoria generada por 200 conexiones del primer cliente, por lo que no pueden procesar nuestras solicitudes a tiempo.
Es hora de poner en funcionamiento nuestros grupos de hilos. Para ello, solo tenemos que añadir la directiva aio threads al bloque location:
location / {    root /storage;
    aio threads;
}
y pide a NGINX que vuelva a cargar su configuración.
Después, repetimos la prueba:
% ifstat -bi eth2eth2
Kbps in  Kbps out
60915.19  9.51e+06
59978.89  9.51e+06
60122.38  9.51e+06
61179.06  9.51e+06
61798.40  9.51e+06
57072.97  9.50e+06
56072.61  9.51e+06
61279.63  9.51e+06
61243.54  9.51e+06
59632.50  9.50e+06
Ahora nuestro servidor alcanza los 9,5 Gbps, frente a aproximadamente 1 Gbps sin grupos de hilos.
Probablemente podría ofrecer aún más rendimiento, pero ya ha alcanzado la capacidad máxima práctica de la red, por lo que, en esta prueba, NGINX está limitado por la interfaz de red. Los procesos de trabajo pasan la mayor parte del tiempo inactivos, esperando nuevos eventos (se encuentran en el estado S en top):
top - 10:43:17 up 11 days,  1:35,  1 user,  load average: 172.71, 93.84, 77.90Tasks: 376 total,  1 running, 375 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.2 us,  1.2 sy,  0.0 ni, 34.8 id, 61.5 wa,  0.0 hi,  2.3 si,  0.0 st
KiB Mem:  49453440 total, 49096836 used,   356604 free,    97236 buffers
KiB Swap: 10474236 total,    22860 used, 10451376 free, 46836580 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4654 vbart    20   0  309708  28844     596 S   9.0  0.1  0:08.65 nginx
 4660 vbart    20   0  309748  28920     596 S   6.6  0.1  0:14.82 nginx
 4658 vbart    20   0  309452  28424     520 S   4.3  0.1  0:01.40 nginx
 4663 vbart    20   0  309452  28476     572 S   4.3  0.1  0:01.32 nginx
 4667 vbart    20   0  309584  28712     588 S   3.7  0.1  0:05.19 nginx
 4656 vbart    20   0  309452  28476     572 S   3.3  0.1  0:01.84 nginx
 4664 vbart    20   0  309452  28428     524 S   3.3  0.1  0:01.29 nginx
 4652 vbart    20   0  309452  28476     572 S   3.0  0.1  0:01.46 nginx
 4662 vbart    20   0  309552  28700     596 S   2.7  0.1  0:05.92 nginx
 4661 vbart    20   0  309464  28636     596 S   2.3  0.1  0:01.59 nginx
 4653 vbart    20   0  309452  28476     572 S   1.7  0.1  0:01.70 nginx
 4666 vbart    20   0  309452  28428     524 S   1.3  0.1  0:01.63 nginx
 4657 vbart    20   0  309584  28696     592 S   1.0  0.1  0:00.64 nginx
 4655 vbart    20   0  30958   28476     572 S   0.7  0.1  0:02.81 nginx
 4659 vbart    20   0  309452  28468     564 S   0.3  0.1  0:01.20 nginx
 4665 vbart    20   0  309452  28476     572 S   0.3  0.1  0:00.71 nginx 5180 vbart 20 0 25232 1952 1156 R 0.0 0.0 0:00.45 top
 4651 vbart    20   0   20032    752     252 S   0.0  0.0  0:00.00 nginx
25921 vbart    20   0  121956   2176    1000 S   0.0  0.0  0:01.98 sshd
25923 vbart    20   0   40304   3840    2208 S   0.0  0.0  0:00.54 zsh
Todavía hay muchos recursos de CPU disponibles.
Los resultados de wrk:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg      Stdev     Max  +/- Stdev
    Latency   226.32ms  392.76ms   1.72s   93.48%
    Req/Sec    20.02     10.84    59.00    65.91%
  15045 requests in 1.00m, 58.86GB read
Requests/sec:    250.57
Transfer/sec:      0.98GB
¡El tiempo medio para servir un archivo de 4 MB se ha reducido de 7,42 segundos a 226,32 milisegundos (33 veces menos), y el número de solicitudes por segundo se ha multiplicado por 31 (250 frente a 8)!
La explicación es que nuestras solicitudes ya no esperan en la cola de eventos para ser procesadas mientras los procesos de trabajo están bloqueados realizando operaciones de lectura, sino que son atendidas por hilos libres. Mientras el subsistema de disco hace su trabajo lo mejor posible atendiendo nuestra carga aleatoria procedente del primer equipo cliente, NGINX utiliza el resto de los recursos de la CPU y de la capacidad de red para atender desde la memoria las solicitudes del segundo cliente.
Sigue sin ser una solución milagrosa
Después de todos nuestros temores sobre las operaciones bloqueantes y de algunos resultados prometedores, probablemente muchos de vosotros ya estéis pensando en configurar grupos de hilos en vuestros servidores. No os precipitéis.
Lo cierto es que, afortunadamente, la mayoría de las operaciones de lectura y envío de archivos no tienen que lidiar con discos duros lentos. Si dispone de suficiente RAM para almacenar el conjunto de datos, el sistema operativo será lo bastante inteligente como para guardar en caché los archivos de uso frecuente en la denominada «caché de páginas».
La caché de páginas funciona bastante bien y permite que NGINX ofrezca un gran rendimiento en casi todos los casos de uso habituales. La lectura desde la caché de páginas es bastante rápida y nadie puede calificar estas operaciones como «bloqueantes». Por otro lado, delegarlas en un grupo de hilos conlleva cierta sobrecarga.
Por tanto, si dispone de una cantidad razonable de RAM y su conjunto de datos de trabajo no es muy grande, NGINX ya funciona de forma óptima sin necesidad de utilizar grupos de subprocesos.
Delegar las operaciones de lectura al grupo de subprocesos es una técnica aplicable a tareas muy específicas. Resulta especialmente útil cuando el volumen de contenido solicitado con frecuencia no cabe en la caché de memoria virtual del sistema operativo. Este podría ser el caso, por ejemplo, de un servidor de streaming multimedia basado en NGINX y sometido a una carga elevada. Esta es la situación que hemos simulado en nuestra prueba de rendimiento.
Sería estupendo poder mejorar la delegación de las operaciones de lectura en grupos de subprocesos. Solo necesitamos una forma eficiente de saber si los datos del archivo necesarios están en memoria y, únicamente si no lo están, delegar la operación de lectura en un subproceso independiente.
Volviendo a nuestra analogía de las ventas, actualmente el vendedor no puede saber si el artículo solicitado está en la tienda y debe optar entre pasar siempre todos los pedidos al servicio de reparto o gestionarlos siempre él mismo.
El problema es que los sistemas operativos carecen de esta función. Los primeros intentos de añadirla a Linux mediante la llamada al sistema fincore() se remontan a 2010, pero no llegaron a buen puerto. Más adelante hubo varios intentos de implementarla mediante una nueva llamada al sistema preadv2() con la opción RWF_NONBLOCK (para obtener más información, consulte Operaciones de lectura de archivos con búfer no bloqueantes y Operaciones de lectura con búfer asíncronas en LWN.net). El destino de todos estos parches sigue sin estar claro. Lo lamentable es que el principal motivo por el que estos parches aún no se han aceptado en el kernel parece ser un continuo debate sobre cuestiones triviales.
Por otro lado, los usuarios de FreeBSD no tienen de qué preocuparse. FreeBSD ya dispone de una interfaz asíncrona suficientemente buena para leer archivos, que debería utilizarse en lugar de grupos de hilos.
Configuración de grupos de hilos
Así que, si tienes claro que el uso de grupos de subprocesos puede aportar alguna ventaja en tu caso, es hora de profundizar en la configuración.
La configuración es bastante sencilla y flexible. Lo primero que debe tener es NGINX versión 1.7.11 o posterior, compilado con el argumento --with-threads del comando configure. Los usuarios de NGINX Plus necesitan la versión 7 o posterior. En el caso más sencillo, la configuración es muy simple. Solo tiene que incluir la directiva aio threads en el contexto adecuado:
# in the 'http', 'server', or 'location' contextaio threads;Esta es la configuración mínima posible de los grupos de subprocesos. De hecho, es una versión abreviada de la siguiente configuración:
# in the 'main' contextthread_pool default threads=32 max_queue=65536;

# in the 'http', 'server', or 'location' context
aio threads=default;
Define un grupo de subprocesos llamado default con 32 subprocesos de trabajo y una longitud máxima de 65536 tareas para la cola de tareas. Si la cola de tareas está sobrecargada, NGINX rechaza la solicitud y registra este error:
thread pool "NAME" queue overflow: N tasks waitingEl error significa que es posible que los hilos no puedan procesar el trabajo con la misma rapidez con la que se añade a la cola. Puede intentar aumentar el tamaño máximo de la cola, pero, si eso no ayuda, significa que su sistema no es capaz de atender tantas solicitudes.
Como ya habrás observado, con la directiva thread_pool puedes configurar el número de hilos, la longitud máxima de la cola y el nombre de un grupo de hilos específico. Esto último implica que puedes configurar varios grupos de hilos independientes y utilizarlos en distintos lugares del archivo de configuración para diferentes fines:
# in the 'main' context
thread_pool one threads=128 max_queue=0;
thread_pool two threads=32;

http {
    server {
        location /one {
            aio threads=one;
        }

        location /two {
            aio threads=two;
        }

    }
    # ...
}
Si no se especifica el parámetro max_queue, se utiliza de forma predeterminada el valor 65536. Como se muestra, es posible establecer max_queue en cero. En este caso, el grupo de subprocesos solo podrá gestionar tantas tareas como subprocesos haya configurados; ninguna tarea quedará a la espera en la cola.
Ahora imaginemos que tiene un servidor con tres discos duros y quiere que funcione como un «proxy de caché» que almacene en caché todas las respuestas de sus servidores backend. La cantidad prevista de datos almacenados en caché supera con creces la memoria RAM disponible. En realidad, se trata de un nodo de caché para su CDN personal. Por supuesto, en este caso lo más importante es obtener el máximo rendimiento de los discos.
Una de las opciones es configurar una matriz RAID. Este enfoque tiene sus ventajas e inconvenientes. Ahora, con NGINX, puede optar por otra alternativa:
# We assume that each of the hard drives is mounted on one of these directories:# /mnt/disk1, /mnt/disk2, or /mnt/disk3

# in the 'main' context
thread_pool pool_1 threads=16;
thread_pool pool_2 threads=16;
thread_pool pool_3 threads=16;

http {
    proxy_cache_path /mnt/disk1 levels=1:2 keys_zone=cache_1:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk2 levels=1:2 keys_zone=cache_2:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk3 levels=1:2 keys_zone=cache_3:256m max_size=1024G
                     use_temp_path=off;

    split_clients $request_uri $disk {
        33.3%     1;
        33.3%     2;
        *         3;
    }

    server {
        # ...
        location / {
            proxy_pass http://backend;
            proxy_cache_key $request_uri;
            proxy_cache cache_$disk;
            aio threads=pool_$disk;
            sendfile on;
        }
    }
}
En esta configuración, las directivas thread_pool definen un grupo de subprocesos dedicado e independiente para cada disco, y las directivas proxy_cache_path definen una caché dedicada e independiente en cada disco.
El módulo split_clients se utiliza para equilibrar la carga entre las cachés (y, por tanto, entre los discos), lo que resulta perfecto para esta tarea.
El parámetro use_temp_path=off de la directiva proxy_cache_path indica a NGINX que guarde los archivos temporales en los mismos directorios donde se encuentran los datos de caché correspondientes. Esto es necesario para evitar copiar los datos de respuesta entre los discos duros al actualizar nuestras cachés.
Todo esto en conjunto nos permite obtener el máximo rendimiento del subsistema de discos actual, ya que NGINX interactúa con las unidades en paralelo y de forma independiente mediante grupos de hilos separados. Cada unidad cuenta con 16 hilos independientes y una cola de tareas específica para leer y enviar archivos.
Seguro que a sus clientes les gusta este enfoque a medida. Tenga por seguro que a sus discos duros también.
Este ejemplo demuestra claramente la flexibilidad con la que se puede ajustar NGINX específicamente para su hardware. Es como si le diera instrucciones a NGINX sobre la mejor forma de interactuar con la máquina y su conjunto de datos. Además, al ajustar con precisión NGINX en el espacio de usuario, puede asegurarse de que el software, el sistema operativo y el hardware funcionen conjuntamente de la forma más óptima para aprovechar todos los recursos del sistema con la mayor eficacia posible.
Conclusión
En resumen, los grupos de hilos son una excelente funcionalidad que lleva el rendimiento de NGINX a nuevas cotas al eliminar uno de sus enemigos más conocidos y persistentes —el bloqueo—, especialmente cuando hablamos de volúmenes de contenido realmente grandes.
Y aún hay más por venir. Como se ha mencionado anteriormente, esta interfaz completamente nueva permite potencialmente delegar cualquier operación larga y bloqueante sin pérdida de rendimiento. NGINX abre nuevos horizontes al posibilitar una gran cantidad de nuevos módulos y funcionalidades. Muchas bibliotecas populares todavía no ofrecen una interfaz asíncrona y no bloqueante, lo que antes las hacía incompatibles con NGINX. Podemos dedicar mucho tiempo y recursos a desarrollar nuestro propio prototipo no bloqueante de alguna biblioteca, pero ¿siempre merecerá la pena el esfuerzo? Ahora, gracias a los grupos de hilos, es posible utilizar dichas bibliotecas con relativa facilidad y crear estos módulos sin que el rendimiento se vea afectado.
Mantente al tanto.
Pruebe usted mismo los grupos de hilos en NGINX Plus: comience hoy mismo su prueba gratuita de 30 días o póngase en contacto con nosotros para hablar sobre sus casos de uso.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.