En abril, escribí sobre por qué el antiguo modelo de seguridad del software ya no funciona. Aquella publicación trataba sobre el problema y los principios. Esta trata sobre el trabajo que estamos realizando en F5 para proteger nuestro código.
Hace unos nueve meses, empezamos a utilizar modelos de IA de vanguardia para analizar sistemáticamente nuestro propio código fuente en busca de vulnerabilidades. Lo que comenzó como una exploración inicial de lo que estos modelos podían hacer con una base de código real y a escala de producción se ha convertido desde entonces en una de las inversiones más importantes de nuestra organización de producto. Hemos creado una infraestructura específica, movilizado recursos de ingeniería de toda la empresa y convertido esta iniciativa en una prioridad absoluta en todos los niveles de la organización.
Más del 80 % de las empresas de la lista Global Fortune 500 confían en F5. Damos soporte a más de la mitad de los entornos de controladores de entrega de aplicaciones (ADC) del mundo. Los 15 principales bancos mundiales, los 30 principales bancos comerciales de EE. UU., las 10 principales compañías de seguros del mundo, las 10 principales empresas de telecomunicaciones del mundo y los 15 departamentos ejecutivos de EE. UU. utilizan F5 en sus infraestructuras.
Nos exigimos un estándar más alto porque las organizaciones nos sitúan en sus rutas más críticas: entre sus usuarios y aplicaciones, y entre sus agentes y API.
Al principio, los modelos no eran muy buenos. Ahora sí.
Cuando emprendimos este camino en el otoño de 2025, los modelos de vanguardia que teníamos a nuestra disposición eran prometedores, pero limitados. Podían identificar problemas superficiales, pero su capacidad para razonar sobre bases de código complejas, comprender el contexto entre distintos módulos y distinguir las vulnerabilidades reales de los falsos positivos era irregular.
La tasa de falsos positivos era alta. Muy alta.
Tuvimos que aprender muchas cosas desde cero:
- Cómo crear un arnés eficaz
- Cómo estructurar prompts que proporcionen suficiente contexto para razonar sobre código real
- Cómo crear canales de verificación capaces de distinguir la información relevante del ruido a gran escala
- Cómo tomar el resultado de un modelo y utilizarlo como entrada para otro a fin de confirmar o descartar los hallazgos
No había un manual genérico que pudiéramos aplicar a F5, así que tuvimos que crear uno.
El ritmo de mejora de estos modelos ha sido asombroso. Los modelos de vanguardia de Anthropic y OpenAI, incluidos Claude Mythos y GPT Cyber, ahora pueden descubrir vulnerabilidades reales, demostrar cómo se pueden explotar y ayudar a los ingenieros a corregirlas. En algunos casos, estos modelos funcionan excepcionalmente bien con archivos binarios y código compilado, no solo con código fuente. Esto no era así el otoño pasado.
No somos los únicos que estamos observando esta mejora. Hemos estado colaborando estrechamente con algunas de las organizaciones más grandes del mundo, incluidas las que participan en Project Glasswing. Son instituciones que utilizan F5 en sus rutas más críticas y que están afrontando el mismo cambio que nosotros.
Han quedado claras algunas cosas:
- Los modelos preliminares y de investigación son extraordinariamente capaces. Los últimos modelos de Anthropic y OpenAI pueden razonar sobre código compilado, identificar cadenas de vulnerabilidades complejas y generar sofisticadas pruebas de concepto.
- El ritmo de mejora de los modelos no es lineal, sino que se está acelerando. Cada nueva generación de modelos supone un salto significativo en cuanto a capacidades. Las organizaciones que no están probando los modelos más recientes con su código se están quedando atrás.
- El cuello de botella inicial fueron los falsos positivos, no los modelos en sí. Al principio, la relación señal-ruido era desalentadora. Tuvimos que invertir mucho en crear sistemas de verificación, automatizar la clasificación y establecer ciclos de retroalimentación que entrenan al sistema para distinguir los problemas reales del ruido. Como resultado, nuestra tasa de falsos positivos ha disminuido y podemos proporcionar a los ingenieros problemas de seguridad y defectos reales que deben solucionar.
- Proteger y gestionar la información sobre vulnerabilidades generada por los modelos de IA de vanguardia es una prioridad de seguridad. Cuando un modelo detecta una vulnerabilidad crítica, como la ejecución remota de código, la gestión de esa información se convierte por sí misma en una operación de seguridad. Hemos aprendido mucho sobre cómo gestionarla de forma responsable.
Todo esto refuerza una idea sobre la que no dejo de insistir: los mismos modelos que utilizamos para detectar vulnerabilidades son los que, tarde o temprano, nuestros adversarios utilizarán contra nosotros. La única estrategia responsable desde el punto de vista de la teoría de juegos consiste en utilizar continuamente modelos de IA de vanguardia para analizar y mejorar nuestro código antes de que lo haga un atacante.
Creación de herramientas, entornos de pruebas y procesos
Desarrollamos herramientas internas que representan un enfoque radicalmente distinto para el análisis de defectos y la gestión de vulnerabilidades.
Nuestra base de código abarca decenas de millones de líneas en C, C++, Python, Tcl, Java, Go y C de bajo nivel escrito para FPGA. Los problemas que buscamos se encuentran en código que lleva años ejecutándose en producción, distribuido entre módulos que interactúan de distintas formas. Crear una infraestructura capaz de analizar todo ese ámbito, abarcando distintos lenguajes y capas de abstracción, supuso un importante reto técnico.
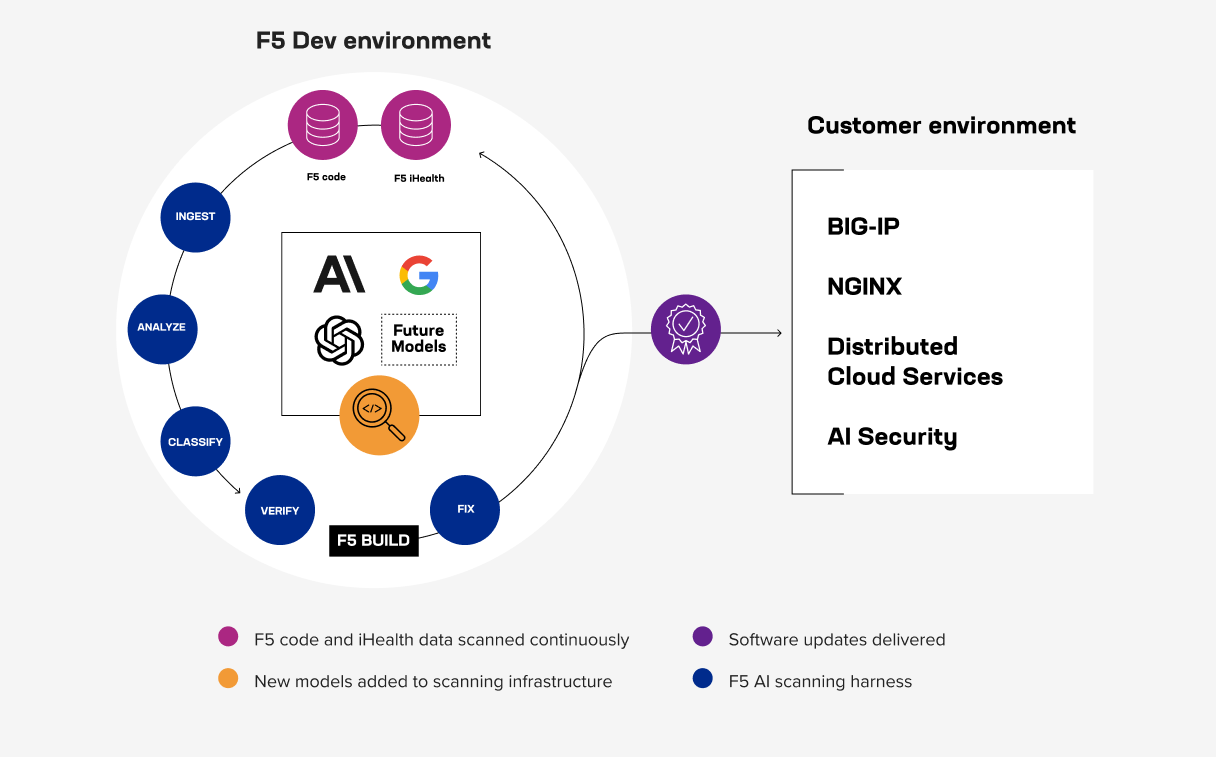
Una de las herramientas que hemos desarrollado incorpora nuevos modelos de cualquier proveedor a medida que están disponibles y los ejecuta continuamente sobre nuestro código base. Colaboramos activamente con laboratorios de IA de vanguardia y tenemos acceso a algunos de los modelos más avanzados, incluidos modelos preliminares y de investigación. Esta herramienta aprovecha estos modelos junto con la teoría de grafos, el análisis estático de composición y otras técnicas. También incorporamos inteligencia sobre amenazas, incluidos conjuntos de datos públicos sobre vulnerabilidades y debilidades.
Esta no es la única herramienta de la que disponemos. Nuestros equipos han creado herramientas adicionales que buscan clases específicas de defectos y aprovechan el trabajo de otras organizaciones. Además, muchos de los laboratorios de vanguardia cuentan con sistemas de pruebas muy avanzados, diseñados para sacar el máximo partido a los modelos subyacentes.
Independientemente de la herramienta, la infraestructura de análisis sigue un proceso riguroso de varias etapas, como el siguiente:
- Ingesta. Introducimos el código fuente de los principales módulos y lenguajes para que los modelos puedan razonar a partir de detalles reales de implementación, no de resúmenes ni abstracciones.
- Analizar. Ejecutamos análisis estáticos basados en IA para detectar errores, patrones de riesgo y flujos sospechosos: lógica de autenticación defectuosa, criptografía insegura, problemas de seguridad de la memoria y mucho más.
- Clasificar. Extraemos hallazgos estructurados, incluidas las correspondencias con CWE, las evaluaciones de gravedad, las referencias a archivos y líneas, y el contexto de explotabilidad.
- Verificar. Un segundo modelo confirma, rebaja o descarta los hallazgos antes de que entren en el flujo de trabajo de ingeniería. Es aquí donde se aborda el problema de los falsos positivos. Al principio, este paso prácticamente no existía y el ruido era abrumador. Hoy es una de las partes más importantes del sistema.
- Corregir. Los hallazgos validados se derivan a un proceso de corrección priorizado. Las correcciones se desarrollan, se prueban y se implementan.
Cada ciclo amplía una base de conocimientos que hace que el siguiente sea más rápido y preciso. Con el tiempo, el propio código se vuelve más resistente. Los modelos encuentran menos porque hay menos que encontrar. Ese es el efecto acumulativo en el que estamos invirtiendo.
Lo que estamos descubriendo
Estamos encontrando problemas que existen en prácticamente cualquier base de código madura: carencias en el refuerzo de la configuración, ajustes predeterminados que deberían ser más restrictivos, problemas de seguridad de la memoria (desbordamientos de búfer y de enteros), condiciones de carrera y deficiencias en la validación de entradas.
Estos son exactamente los tipos de problemas que queremos detectar y solucionar. En un mundo en el que los modelos de IA pueden razonar sobre cómo encadenar vulnerabilidades, eliminarlas sistemáticamente hace que todo el código sea mucho más resistente a posibles ataques. Estas vulnerabilidades son los componentes básicos de las cadenas de explotación y, al eliminarlas, se dificulta atacar el software.
Una nueva capacidad: analizar, clasificar, corregir, probar, publicar y repetir
Uno de los resultados más importantes de este trabajo es la capacidad operativa que nuestro equipo de ingeniería ha desarrollado durante los últimos meses. El análisis es solo una parte de una capacidad integral que hemos creado y que antes no existía.
Estamos pasando de un ciclo de lanzamientos trimestral a lanzamientos reforzados más frecuentes para todo el software. Se trata de un cambio operativo de gran envergadura. Por ejemplo, cabe destacar el rigor con el que trabaja nuestro equipo de ingeniería de BIG-IP: están realizando pruebas con todas las combinaciones activas de F5OS y TMOS presentes en nuestra base de clientes. Cada combinación requiere un entorno de pruebas específico. Cada versión se somete a un estricto control de ramas, pruebas de regresión y pruebas de longevidad. Estamos documentando los tiempos de actualización y reinicio, y asociando a la versión cada corrección, ya sea de un desbordamiento de búfer, del refuerzo de la validación de entradas o de una vulnerabilidad CVE.
Llevamos años aplicando prácticas rigurosas de análisis y pruebas. Lo que ha cambiado es el ciclo impulsado por la IA: analizar, clasificar, corregir, probar, publicar y repetir.
Qué viene después
Cabe esperar más versiones a medida que el análisis basado en IA detecte más vulnerabilidades. Esto es señal de una mayor seguridad, no de un software menos robusto. Revelaremos lo que encontremos después de publicar versiones reforzadas.
A medida que aumente la frecuencia de los parches en todo el sector, nuestros clientes tendrán que incorporar más actualizaciones de todos los proveedores y con mayor frecuencia. Nos comprometemos a facilitarles esta tarea, no a complicarla. Hemos acelerado el trabajo en la gestión de flotas, las actualizaciones automatizadas y la simplificación de los procesos de actualización porque son esenciales.
Además, la seguridad en tiempo de ejecución debe evolucionar al mismo ritmo. Las capacidades de detección y respuesta basadas en IA constituirán una línea de defensa fundamental para identificar y detener amenazas sin depender de firmas conocidas ni esperar a que haya un parche disponible. Estamos desarrollando estas capacidades porque el panorama de amenazas así lo exige. Muy pronto compartiremos más información al respecto.
Hace nueve meses, empezamos a explorar si los modelos de IA de vanguardia podían cambiar radicalmente la forma en que detectamos y corregimos vulnerabilidades en nuestro propio código. Y pueden hacerlo. Los modelos son mejores de lo que esperábamos. Nuestra capacidad operativa es mayor de lo que preveíamos y la urgencia no ha hecho más que aumentar.
Las organizaciones que nos confían sus infraestructuras más críticas no merecen menos.
Para obtener más información, consulta mi entrada anterior del blog, «El plazo para aplicar parches ha terminado. Así está preparada F5 para lo que viene».
Sobre el autor

Kunal Anand dirige la organización de productos de F5 como director de Producto. Es responsable de la visión, la estrategia y la ejecución de los productos, y garantiza el desarrollo de soluciones innovadoras que resuelven retos críticos y ofrecen experiencias excepcionales a los clientes. En su anterior cargo como director de Tecnología e IA, Kunal definió la estrategia y la visión tecnológica y de inteligencia artificial de la empresa. Antes de incorporarse a F5, Kunal desempeñó simultáneamente los cargos de director de Tecnología y director de Seguridad de la Información en Imperva. Su trayectoria en Imperva comenzó en 2018 con la adquisición de Prevoty, una startup de seguridad de aplicaciones que cofundó en 2013. Antes de incorporarse a Prevoty, fue director de Tecnología en BBC Worldwide. Kunal cuenta con una amplia trayectoria en innovación y conocimientos técnicos, y ha ocupado puestos de liderazgo al frente de equipos de seguridad, datos, tecnología e ingeniería en Gravity, MySpace y el Laboratorio de Propulsión a Chorro de la NASA. Kunal cuenta con más de 15 años de experiencia en inteligencia artificial y aprendizaje automático, que abarca desde el entrenamiento de modelos y el uso de algoritmos basados en IA para mejorar productos hasta el diseño y la implementación de arquitecturas de IA. Kunal es graduado en Ciencias de la Computación por Babson College.
Más artículos de Kunal AnandArtículos relacionados del blog

IA agéntica en ciberseguridad: promesas y riesgos
Descubre por qué el uso de la IA agéntica en ciberseguridad es esencial para combatir las amenazas impulsadas por IA y por qué los agentes también generan nuevos riesgos empresariales.

Cómo los clientes de F5 del sector financiero abordan la soberanía digital sin frenar la innovación
¿Cómo se materializa la soberanía digital en el mundo real? Dos proyectos recientes de F5 con clientes muestran cómo distintas empresas están afrontando estos retos.

Soberanía operativa: cómo desarrollar resiliencia en un mundo impredecible
Para muchas organizaciones, la cuestión ya no consiste únicamente en controlar los datos, sino en mantener la capacidad de operar, adaptarse y recuperarse a medida que evolucionan las leyes y las circunstancias.

No se puede proteger una conversación con un cortafuegos: cómo el red teaming de IA se volvió esencial
Dado que las implementaciones de IA avanzan a la velocidad de las máquinas, los métodos tradicionales de prueba de software ya no resultan adecuados.

Protege tu canalización de datos de IA sin ralentizarla
Proteger el flujo de datos de la IA no es opcional. Eso está claro. Lo que resulta mucho menos evidente —y mucho más difícil— es cómo protegerlo adecuadamente.

Las extranets no están muertas; solo necesitan una actualización
Modernice su extranet: descubra cómo F5 y Equinix ofrecen una conectividad para partners repetible, segura y escalable, sin la complejidad de las redes tradicionales.