Escalar contenedores implica mucho más que limitarse a colocar un proxy delante de un servicio y olvidarse. El escalado no consiste únicamente en la distribución y, en el vertiginoso mundo de los contenedores, se requieren cinco capacidades diferenciadas para garantizarlo: reintentos, disyuntores, descubrimiento, distribución, y supervisión.
En este artículo sobre el arte de escalar contenedores, profundizaremos en la monitorización.
Monitorización
Monitorización. En una época en la que todo parece escuchar y/o vigilarlo todo, desde la velocidad a la que conducimos hasta lo que hay en nuestro frigorífico, la palabra deja un mal sabor de boca a mucha gente. Podemos —y a menudo lo hacemos— utilizar en su lugar la palabra «visibilidad», pero ese artificio semántico no cambia lo que estamos haciendo: observar atentamente.
Todo lo relacionado con el escalado depende de la monitorización, es decir, de conocer el estado de los recursos entre los que se distribuyen las solicitudes. Enviar una solicitud a una «zona muerta» porque el recurso ha fallado o se ha desactivado recientemente es como entrar en una calle sin salida. Es una pérdida de tiempo.
La monitorización puede adoptar muchas formas. Está la monitorización de «¿puedo contactar contigo?» mediante un ping en la capa de red. Está la monitorización de «¿estás en casa?» mediante una conexión TCP. Y está la de «¿abres la puerta?» mediante una solicitud HTTP. Por último, está la monitorización de «¿ya te has tomado el café?», que determina si el servicio responde correctamente o no.
Además de comprobar el estado y el funcionamiento de un servicio, también es necesario supervisar su rendimiento. La rapidez con la que responde el servicio es fundamental si se distribuyen las solicitudes en función de los tiempos de respuesta. Los cambios repentinos en el rendimiento pueden indicar problemas, por lo que se trata de datos históricos relevantes que también deben supervisarse.
Existe la monitorización activa (¡déjame enviarte una solicitud real!), la monitorización sintética (déjame enviarte una solicitud simulada) y la monitorización pasiva (me limitaré a observar qué ocurre con una solicitud real). Cada una tiene sus ventajas e inconvenientes, y todas son métodos de monitorización válidos. La clave es que el proxy pueda determinar el estado: ¿está operativo?, ¿está caído?, ¿se ha marchado del edificio con Elvis?
La accesibilidad, la disponibilidad y el rendimiento son aspectos de la supervisión y resultan necesarios para garantizar la escalabilidad. Esto significa que no se trata solo de supervisar, sino de asegurarse de que los proxies de equilibrio de carga dispongan de información actualizada sobre el estado de cada recurso al que puedan dirigir una solicitud.
Si tenemos en cuenta la naturaleza de los contenedores y la tendencia a combinarlos con una arquitectura basada en microservicios, resulta evidente que la monitorización puede convertirse rápidamente en una pesadilla. Esto se debe a que el modelo de balanceo de carga más habitual en los entornos de contenedores se basa en proxies directos (y sidecar). Ambos requieren que cada nodo conozca el estado y el correcto funcionamiento de todos los recursos a los que podría tener que enviar una solicitud. Esto implica monitorizar prácticamente todos los recursos.
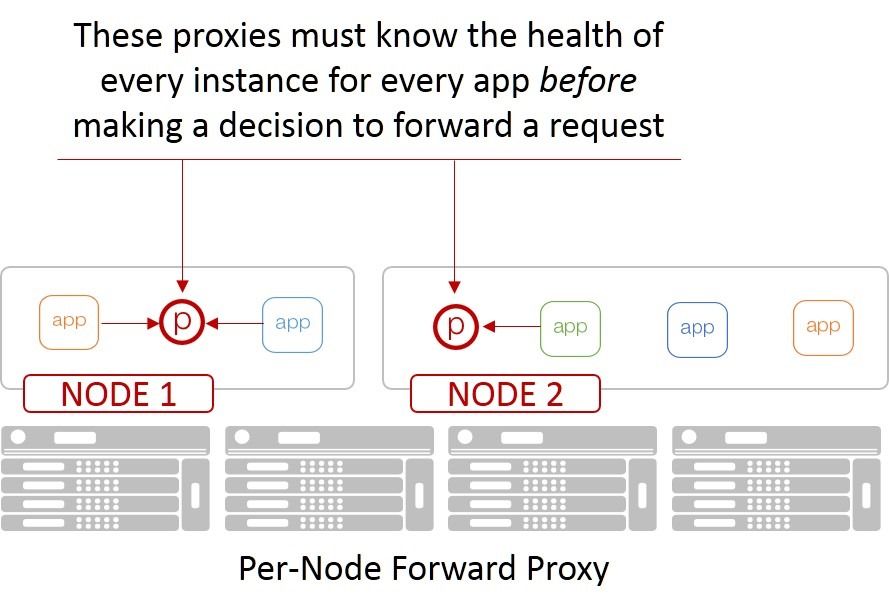
Como puede imaginar, no resulta muy eficiente que un recurso determinado consuma sus propios recursos limitados para informar de su estado a quince o veinte proxies directos. La monitorización en un modelo de este tipo tiene un efecto considerablemente negativo tanto en el rendimiento como en la capacidad, lo que dificulta aún más el escalado.
La monitorización nunca había tenido un impacto tan significativo en la escalabilidad como el que estamos observando con los contenedores.
Y, sin embargo, es fundamental —como se ha señalado anteriormente—, porque no queremos perder el tiempo con recursos que no llevan a ninguna parte si podemos evitarlo.
Los retos que plantea la necesaria supervisión son una de las razones por las que la malla de servicios sigue ganando aceptación (y terreno) como futuro modelo de escalabilidad en entornos de contenedores.
Porque la monitorización no es opcional, pero tampoco debería suponer una carga.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.