Los proveedores de servicios siempre han medido minuciosamente el rendimiento de la red. El caudal y la latencia siguen siendo importantes, pero no indican a los operadores cuánta infraestructura se necesita para ofrecer ese rendimiento.
El consumo de CPU y memoria afecta a los requisitos de los servidores, la densidad de las cargas de trabajo, el consumo energético, la refrigeración y la capacidad restante para otros servicios. Estos factores cobran cada vez más importancia a medida que más funciones de red se trasladan a entornos de Kubernetes.
F5 encargó a The Tolly Group que evaluara de forma independiente la eficiencia y el rendimiento de la infraestructura de F5 BIG-IP Cloud-Native Edition en comparación con una implementación probada de una función de red virtual, o VNF. Ambas se evaluaron en un entorno Red Hat OpenShift utilizando dos cargas de trabajo representativas de proveedores de servicios: procesamiento de consultas DNS y capa 4 junto con NAT de nivel de operador, o L4+CGNAT.
Tolly midió el rendimiento y la latencia, así como el consumo de CPU y memoria. El objetivo era determinar cuánto trabajo útil podía realizar cada implementación y qué recursos de infraestructura se necesitaban para ello.
Mida la infraestructura que sustenta el rendimiento
Los resultados de las pruebas demuestran por qué conviene analizar el consumo de recursos junto con las métricas de rendimiento tradicionales.
En un entorno de Kubernetes, la CPU y la memoria no utilizadas pueden quedar disponibles para que la plataforma programe otras cargas de trabajo, en función de las políticas de recursos del clúster. Por tanto, un menor consumo de recursos puede ofrecer más flexibilidad a los operadores a la hora de utilizar la infraestructura ya desplegada.
Las dos cargas de trabajo de Tolly generaron perfiles de rendimiento diferentes, pero ambas mostraron reducciones sustanciales en los requisitos de CPU de BIG-IP Cloud-Native Edition en la configuración probada.
DNS: mayor rendimiento con menos CPU
DNS es un servicio de gran volumen en el que se deben procesar rápidamente grandes cantidades de transacciones relativamente pequeñas. La prueba de DNS de Tolly utilizó la funcionalidad DNS Express de BIG-IP y midió el rendimiento sostenido de las consultas, el consumo de CPU, la eficiencia de la memoria y la latencia media.
BIG-IP Cloud-Native Edition mantuvo 64.985 consultas DNS por segundo, frente a las 34.463 consultas por segundo de la VNF probada. Esto supone casi 1,9 veces el rendimiento de consultas DNS.
Los requisitos de CPU también fueron considerablemente diferentes. BIG-IP Cloud-Native Edition consumió 341 mCores, mientras que la VNF consumió 4.003 mCores, prácticamente todos los recursos de CPU de los cuatro núcleos asignados a la prueba. Por tanto, CNE utilizó un 91,5 % menos de CPU en la configuración probada.
La latencia media de DNS fue de 1,47 milisegundos para CNE, frente a los 2,82 milisegundos de la VNF, lo que supone una reducción del 48 %.
Tolly también normalizó el rendimiento de DNS en función del consumo de memoria. BIG-IP Cloud-Native Edition procesó 515.759 consultas por segundo por gigabyte de memoria, frente a las 4.194 de la VNF, lo que se tradujo en 123 veces más consultas DNS por gigabyte de memoria en la prueba.
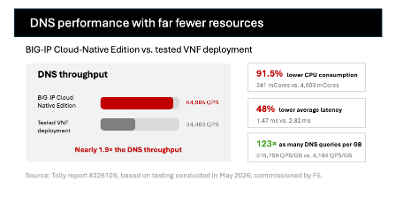
Para los operadores que gestionan servicios DNS de gran volumen, la consideración práctica es cuánta infraestructura se necesita para soportar una carga de trabajo determinada. Unos requisitos menores de CPU y memoria pueden dejar más capacidad disponible en el entorno de Kubernetes para servicios adicionales o para el crecimiento futuro.
L4+CGNAT: rendimiento similar, menos recursos
La prueba de L4+CGNAT arrojó un resultado diferente.
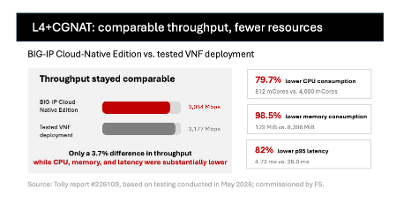
Ambas implementaciones ofrecieron un rendimiento de aproximadamente 3 Gbps. BIG-IP Cloud-Native Edition mantuvo 3064 Mbps, mientras que la VNF probada mantuvo 3177 Mbps, por lo que el resultado de la VNF fue aproximadamente un 3,7 % superior.
La diferencia en el consumo de infraestructura fue considerablemente mayor.
BIG-IP Cloud-Native Edition utilizó 812 mCores, frente a los 4.000 mCores de la VNF. Esto supone un consumo de CPU un 79,7 % menor.
El consumo de memoria fue de 129 MiB para BIG-IP Cloud-Native Edition y de 8.396 MiB para la VNF, lo que supone una reducción del 98,5 % en la configuración probada.
Tolly también midió una latencia p95 de 4,73 milisegundos para BIG-IP Cloud-Native Edition, frente a los 26 milisegundos de la VNF, lo que supone una reducción del 82 %.
En el entorno de prueba, el rendimiento se mantuvo dentro de un margen del 3,7 %, mientras que BIG-IP Cloud-Native Edition utilizó considerablemente menos CPU y memoria y ofreció una latencia p95 más baja.
Por qué es importante la eficiencia de los recursos
Los entornos de los proveedores de servicios suelen tener que admitir grandes volúmenes de tráfico en infraestructuras donde la CPU, la memoria, la energía y la capacidad física son limitadas.
La eficiencia de los recursos puede influir en el número de cargas de trabajo que admite un clúster, en la capacidad que queda disponible para nuevos servicios y en la cantidad de infraestructura necesaria a medida que aumenta la demanda.
Es ahí donde los resultados de Tolly resultan más útiles. DNS y L4+CGNAT fueron dos cargas de trabajo representativas seleccionadas para someterlas a pruebas independientes. No representan todas las funciones disponibles en BIG-IP Cloud-Native Edition, pero ofrecen ejemplos concretos de cómo un modelo de implementación nativo de Kubernetes puede cambiar el perfil de recursos de los servicios de red. Por tanto, las conclusiones deben entenderse como resultados correspondientes a las cargas de trabajo y configuraciones probadas, y no como afirmaciones sobre el rendimiento de otros servicios de BIG-IP Cloud-Native Edition.
Los resultados también ofrecen a los operadores otra métrica que tener en cuenta al evaluar la arquitectura de las funciones de red. El rendimiento sigue siendo esencial, pero la CPU, la memoria y la latencia ayudan a determinar el coste en términos de infraestructura necesario para alcanzar dicho rendimiento.
Para los proveedores de servicios que estén planificando servicios de red basados en Kubernetes, esa información puede ayudar a orientar las decisiones sobre la planificación de la capacidad, la distribución de las cargas de trabajo y el uso de la infraestructura.
Para obtener más información, lea el informe completo de Tolly Group para consultar una evaluación independiente de la eficiencia de F5 BIG-IP Cloud-Native Edition en infraestructuras de proveedores de servicios. Consulte también nuestro blog, Modernización nativa de la nube para la era de la IA y el 5G/6G.
Sobre el autor
Artículos relacionados del blog

El imperativo empresarial de la IA en un mundo de nube híbrida y multinube
Cómo la IA redefine los patrones de tráfico, el riesgo de las API y el cumplimiento normativo, y por qué el paquete Distributed Cloud Services Enterprise ofrece la profundidad necesaria en entornos híbridos multicloud.

STIG de F5 NGINX: un plan de seguridad para el sector público y los entornos regulados
Descubra cómo las STIG de F5 NGINX proporcionan un modelo de seguridad para el Departamento de Defensa de EE. UU. y los entornos regulados, ayudándole a cumplir la normativa mientras crea una infraestructura sólida de confianza cero con mayor visibilidad y resiliencia.

Cómo el marco AEGIS de Forrester valida un enfoque centrado en la inferencia
El auge de la IA agéntica está transformando el panorama de la seguridad empresarial. Estos agentes de IA autodirigidos funcionan de forma autónoma, toman decisiones en tiempo real y pueden interactuar entre distintos sistemas de maneras para las que las arquitecturas tradicionales de ciberseguridad no fueron diseñadas. Aunque esto abre nuevas posibilidades, también introduce riesgos sistémicos: fallos en cascada, secuestro de objetivos y superficies de ataque hasta ahora invisibles. El reciente […] de Forrester
La nueva superficie de riesgo de la IA: invisible, autónoma y ya está dentro
James White, vicepresidente de Ingeniería de F5 A mediados de 2025, es un buen momento para hacer balance de la adopción de la IA en las empresas y del estado de la seguridad de la IA. El uso de la IA generativa ya es habitual en las empresas En general, las empresas cuentan al menos con unos conocimientos básicos sobre la IA generativa. Entienden qué es y dónde puede […]
Protegiendo el futuro: cómo CalypsoAI se alinea con el Top 10 de OWASP para los LLM
Cuando OWASP publicó su Top 10 de 2025 para grandes modelos de lenguaje (LLM), proporcionó al sector un referente de seguridad muy necesario. Pero los referentes no sirven de nada si no se actúa. CalypsoAI aborda el 80 % del Top 10 de OWASP, dando prioridad a los riesgos reales más urgentes. La plataforma combina protección en tiempo real durante la ejecución y pruebas adversariales exhaustivas, ofreciendo una cobertura inigualable frente a las […]
Implementación de LLM en la empresa: mediante una API local
Por sí solos, sin medidas de protección ni protocolos adicionales de seguridad para la IA, el despliegue de modelos de IA generativa —en particular, modelos de lenguaje de gran tamaño (LLM)— en toda la empresa supone una oportunidad de alto riesgo y grandes beneficios para cualquier organización. Sin embargo, determinar exactamente cómo debe dar su organización este gran paso hacia el ámbito de la IA generativa requiere una planificación minuciosa. Quizá […]