L’IA générative (GenAI) fait parler d’elle de toutes parts. Mais quels usages s’imposent réellement ? Comment contribue-t-elle à rendre le monde meilleur ? Quelle valeur apporte-t-elle aux entreprises ? Ces questions sont tout aussi pertinentes au regard des défis auxquels sont confrontées les organisations qui cherchent à déterminer si, et quand, intégrer la GenAI à leurs opérations (AIOps). Fort de mes expérimentations menées au cours de l’année écoulée avec l’IA générative et de ma connaissance approfondie des tendances du secteur, acquise dans le cadre de mes recherches quotidiennes chez F5, je propose cinq enseignements pour aider les organisations qui souhaitent comprendre l’impact de la GenAI sur les pratiques de gestion des données opérationnelles. Elles seront ainsi mieux à même d’aligner le calendrier d’adoption des technologies GenAI sur leurs budgets, leurs pratiques et leur culture actuels.
1. Les modèles d’IA générative raffolent des données semi-structurées et non structurées
Les données opérationnelles sont un mélange hétéroclite de données semi-structurées (objets) et de jeux de données non structurées. Les grands modèles de langage (LLM) font preuve d’une grande souplesse et d’une grande efficacité face à cette diversité de formats de données. Les LLM constituent donc une technologie idéale pour analyser les jeux de données opérationnelles. Les organisations peuvent mener en interne diverses expérimentations et évaluations afin de vérifier l’efficacité, la facilité d’utilisation et le coût de différentes solutions basées sur l’IA générative. Le recours à l’inférence des LLM pour détecter des schémas intéressants dans les données, avec moins de faux positifs, permet d’aligner la vitesse et la capacité de traitement des machines sur les objectifs des équipes qui exploitent les flux de données opérationnelles.
2. Les organisations n’ont pas besoin de créer leurs propres modèles
Les organisations qui s’attachent à déterminer quelles techniques sont utilisées par quels modèles pour les tâches spécifiques qui les concernent n’ont pas besoin de créer leurs propres modèles. Par exemple, la reconnaissance d’entités nommées (NER) est une branche du traitement automatique du langage naturel (NLP) qui s’avère efficace pour identifier des éléments clés dans des données semi-structurées. Un exemple de NER pourrait être une liste comprenant une catégorie telle que les jours de la semaine, ou une description telle que les nombres entiers supérieurs à 1 et inférieurs à 5. Cette approche permet d’obtenir une plus grande précision lors de l’inférence que les techniques de mise en correspondance de motifs fondées sur des règles et ne faisant pas appel à l’IA générative. À mesure que la recherche et l’utilisation de techniques telles que la NER progressent, les équipes opérationnelles peuvent se concentrer sur l’exploitation des techniques qui ont fait leurs preuves plutôt que sur la création de modèles.
Exemple de NER :
Entité nommée : jours de la semaine
Liste : dimanche, lundi, mardi, mercredi, jeudi, vendredi, samedi
Figure 1. La reconnaissance d’entités nommées offre une meilleure précision lors de l’inférence que la mise en correspondance de motifs fondée sur des règles.
3. La gravité des données est une réalité
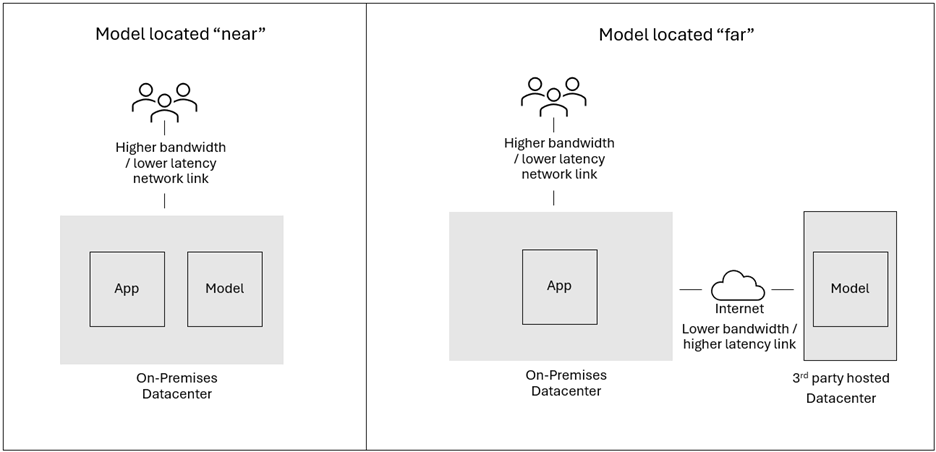
La gravité des données est une force sous-jacente qui influe sur la décision de rapprocher les ressources de calcul du lieu où les données sont créées ou, au contraire, de rapprocher les données du lieu où les ressources de calcul sont déjà déployées. Plus le volume de données est important, plus la force gravitationnelle est élevée, ce qui conduit à accroître la capacité de calcul à proximité de ces données. Pour l’entraînement (création et ajustement des modèles), les données sont agrégées et rapprochées des ressources de calcul. Pour l’inférence (utilisation des modèles), le modèle est rapproché du lieu où la requête est émise.
Si l’on accède à un modèle en en rapatriant une copie en interne, plutôt qu’en appelant l’API d’une instance hébergée par un tiers, il est judicieux de rapprocher le modèle de la requête et/ou de tout jeu de données privées supplémentaire vectorisé dans le cadre de celle-ci. En revanche, si le modèle est hébergé par un tiers qui expose son API sur Internet, ni le modèle ni les opérations d’inférence ne sont déplacés. Dans ce cas, l’inférence et les vecteurs de données privées peuvent être transférés vers un emplacement « proche sur le réseau » au moyen d’une interconnexion dans un centre de données en colocation ou, si possible, en faisant coïncider les sites d’hébergement avec ceux du fournisseur du modèle.
La compréhension des forces qui rapprochent les données et les ressources de calcul, ainsi que de celles qui les éloignent, permet de faire des choix éclairés afin de trouver le juste équilibre entre coût et performances.
4. N’ignorez pas les silos de données, traitez-les
Avec le traitement par l’IA générative, il est plus important que jamais de décloisonner les données afin de simplifier et d’accélérer l’analyse des données opérationnelles. Toutefois, dans un avenir prévisible, les silos de données semblent voués à perdurer, voire à se multiplier.
La question porte davantage sur la manière de gérer les silos de données et sur les choix technologiques à effectuer. Pour accéder à des données stockées à plusieurs endroits, il est possible soit de les copier et de les déplacer, soit de mettre en œuvre une couche de données logique qui utilise des requêtes fédérées sans déplacer les données. Quel que soit le choix retenu, le recensement des sources de données en continu existantes et l’évaluation des cas d’usage opérationnels au regard des contraintes de délai et de fraîcheur des données vous aideront à sélectionner les composants nécessaires de votre pile technologique de données, tels que les moteurs de traitement en continu, les moteurs de requêtes, les formats de données et les catalogues. Le libre choix technologique permet aux équipes chargées des données d’opter pour les technologies les plus efficaces et les plus simples d’utilisation, tout en trouvant le juste équilibre entre performances et coûts. Dans l’idéal, les pratiques d’une organisation en matière de données gagnent en maturité au fil du temps, tout en lui laissant toujours la possibilité de choisir ce qui lui convient le mieux à chaque étape de cette évolution.
5. L’automatisation est votre alliée — n’en ayez pas peur
Lorsque les solutions intègrent l’automatisation, elles gagnent en capacité de mise à l’échelle en transformant les connaissances tacites des experts en confidentialité des données et en SecOps en une pratique reproductible, fondée sur l’AIOps et exécutable par des machines. Ce n’est qu’alors que les équipes chargées des données, de la sécurité et de la confidentialité peuvent se consacrer à l’apport d’intelligence. Cette intelligence renforce l’efficacité des politiques en définissant plus précisément qui peut utiliser certaines données, pendant combien de temps et à quelles fins, tout en assurant le suivi de leur emplacement, des copies qui en sont faites et des personnes avec lesquelles elles sont partagées. Les équipes disposent ainsi de davantage de temps pour la planification stratégique, l’évaluation de nouvelles technologies et les échanges avec les métiers afin d’affiner les politiques d’accès aux données et d’approuver les dérogations.
La rapidité, le passage à l’échelle et l’automatisation caractérisent une pratique AIOps mature, permettant d’obtenir de meilleurs résultats, de prendre des décisions plus rapidement et d’optimiser le capital humain. L’IA générative ouvre des portes que la technologie n’avait jusqu’à présent pas réussi à ouvrir. Les cinq enseignements ci-dessus constituent autant de repères que les équipes chargées des opérations informatiques, de la sécurité et de la confidentialité peuvent prendre en compte lorsqu’elles intègrent l’IA générative à leur pratique AIOps. Les modèles d’IA, la proximité des ressources de calcul avec les données opérationnelles, les données elles-mêmes et l’automatisation sont des composantes essentielles de la nouvelle plateforme AIOps. Dans ce riche environnement d’apprentissage, les organisations peuvent développer la culture et les pratiques des opérations technologiques pour la génération actuelle et les suivantes.
Pour en savoir plus sur l’impact de l’IA générative sur les données, consultez le dernier rapport Digital Enterprise Maturity Index de F5.
À propos de l’auteur

Articles de blog associés

Pourquoi devriez-vous vous intéresser à WebAssembly ?
WebAssembly (Wasm) est un jeu d’instructions binaires portable, rapide et sécurisé, qui permet d’exécuter des applications hautes performances sur n’importe quelle plateforme.

Trois choses à savoir sur les applications d’IA
Les applications d’IA sont des applications modernes, mais elles présentent certaines particularités. Découvrez les points essentiels à connaître sur les applications basées sur l’IA.
État des lieux de la stratégie applicative 2022 : il est temps de moderniser les opérations
Il est devenu évident que, pour maintenir la dynamique de leur transformation numérique, les organisations doivent recentrer leurs efforts sur les fonctions métier. Si les expériences destinées aux clients restent prioritaires, il est également indispensable de permettre la numérisation de fonctions telles que les services juridiques, les ressources humaines et la finance. Les DSI prennent donc les commandes, tandis que la transformation numérique passe de la modernisation des applications à celle des opérations.
Clouds multiples ou multicloud : faciliter la transition
La gestion et la sécurisation des charges de travail deviennent complexes à mesure que les entreprises adoptent une stratégie de cloud connecté. Découvrez comment F5 répond au besoin d’une nouvelle approche de la mise en réseau multicloud.
L’expérience client dépend de la visibilité
Une enquête menée par Dimensional Research auprès de plus de 3 000 utilisateurs d’applications mobiles a confirmé ce que beaucoup d’entre nous pensent des attentes actuelles des clients.
Transformation numérique et explosion du portefeuille d’applications
La transformation numérique stimule la croissance des portefeuilles d’applications et modifie la manière dont celles-ci sont développées, déployées, intégrées et, en définitive, utilisées.