
Cet article est le premier d’une série consacrée aux différents aspects de la création et de l’exploitation de notre service SaaS :
- Plan de contrôle pour une PaaS Kubernetes distribuée
- Maillage de services global pour les applications distribuées
- Sécurité de la plateforme pour les infrastructures, les applications et les données distribuées
- Sécurité des applications et des réseaux des clusters distribués
- Observabilité sur l’ensemble d’une plateforme distribuée à l’échelle mondiale
- Opérations et SRE d’une plateforme distribuée à l’échelle mondiale
- Framework de services en Go pour les microservices distribués
Comme nous l’avons expliqué dans notre précédent article de blog, nos clients développent des ensembles complexes et variés de solutions métier — telles que la fabrication intelligente, l’analyse vidéo à des fins de sécurité publique, le trading algorithmique ou encore les réseaux 5G des opérateurs télécoms — et nous devons donc offrir à ces applications et à leurs utilisateurs finaux une expérience toujours disponible, connectée et fiable.
Comme ces applications peuvent s’exécuter sur plusieurs clusters répartis entre différents fournisseurs de cloud ou sur les sites edge des clients, notre équipe plateforme a dû créer un plan de contrôle distribué et un service PaaS afin de déployer, sécuriser et exploiter plusieurs clusters Kubernetes mutualisés. Ce plan de contrôle distribué a apporté de nombreux avantages en matière d’exploitation, de mise à l’échelle et de performances, que nous aborderons dans notre présentation (lien vers la vidéo) — notamment la gestion de milliers de clusters K8s edge avec GitOps — ainsi que dans un article de blog distinct qui sera publié dans les semaines à venir.
En bref (résumé)
- Nous n’avons trouvé sur le marché aucune solution simple d’utilisation permettant de déployer, de sécuriser et d’exploiter plusieurs clusters d’applications répartis entre différents fournisseurs de cloud, clouds privés ou sites en périphérie.
- Nous n’avons pas trouvé de distribution Kubernetes robuste ni de PaaS (par exemple OpenShift, Cloud Foundry, etc.) offrant un ensemble complet de services de sécurité et d’exploitation nécessaires aux clusters distribués — notamment l’identité basée sur une PKI, le RBAC et la gestion des accès utilisateurs, la gestion des secrets et des clés entre différents fournisseurs de cloud, un maillage de services multicluster, l’observabilité et les journaux d’audit, ou encore la sécurité des applications et du réseau.
- Anthos (Google), Azure Arc (Microsoft) et Rancher sont des plateformes de gestion multicluster regroupant plusieurs services différents. Selon notre analyse, ces solutions n’auraient pas répondu à nos exigences en matière d’exploitation, de mise à l’échelle, de sécurité et de mutualisation pour les services applicatifs et d’infrastructure répartis sur plusieurs clusters.
- Nous avons dû créer notre propre plan de contrôle distribué pour notre PaaS managé reposant sur Kubernetes. Nous sommes partis d’une version standard de Kubernetes, à laquelle nous avons ensuite apporté des modifications importantes afin de fournir les services de plateforme dont nos équipes DevOps et SRE avaient besoin. Nous avons également dû créer un plan de contrôle permettant de gérer un grand nombre de clusters distribués et d’assurer la mutualisation sur des infrastructures hétérogènes (en périphérie, sur notre réseau et auprès de plusieurs fournisseurs de cloud).
Kubernetes pour la gestion des applications : pourquoi et comment
Nous avons choisi Kubernetes (K8s) comme cœur de notre plateforme de gestion des applications distribuées, car il offre un riche éventail de fonctionnalités sans être excessivement contraignant, ce qui nous donne la souplesse nécessaire pour innover dans les domaines qui, selon nous, comptent pour nos clients. Nous nous sommes appuyés sur cette base pour commencer à développer notre service. De plus, avec la popularité croissante de K8s, il est désormais plus facile de trouver des développeurs et des opérateurs qui le maîtrisent.
Cela dit, déployer et gérer un grand nombre de clusters Kubernetes adaptés à la production dans un environnement hybride (plusieurs clouds, points de présence réseau et sites en périphérie) n’est pas chose aisée, car il n’existe aucune solution Kubernetes prête à l’emploi permettant de :
- Harmoniser des ressources d’infrastructure hétérogènes grâce à la mise en cluster, à la mise à l’échelle et au provisionnement sans intervention automatisés ; cela s’est avéré particulièrement complexe en périphérie et dans nos PoP réseau
- Fournir une connectivité performante et fiable entre des sites disparates, en particulier lors du passage d’un fournisseur de cloud à un autre et depuis des sites en périphérie
- Résoudre les problématiques de sécurité liées aux données en transit, aux données au repos, aux secrets, aux clés et au réseau… le tout reposant sur une identité PKI uniforme qui fonctionne à la périphérie, sur le réseau et dans le cloud
- Offrir une véritable architecture mutualisée — avec isolation des locataires et garanties de sécurité — permettant d’exécuter sur les mêmes clusters des charges de travail de production et de développement répondant aux besoins internes et à ceux des clients
- Fournir des capacités d’observabilité et d’exploitation sur l’ensemble des clusters distribués, en cohérence avec les politiques et les objectifs centralisés, sans avoir à mettre en place une collecte complexe de journaux et de métriques
Après avoir réalisé plusieurs preuves de concept auprès de différents fournisseurs de cloud et avec des plateformes open source telles que GKE, AKS, EKS et RKE, ainsi qu’OpenShift et Cloud Foundry, nous avons constaté qu’aucune d’entre elles ne pouvait répondre à l’ensemble des cinq exigences ci-dessus. Nous avons donc décidé de créer notre propre PaaS, en partant d’une version « standard » de Kubernetes à laquelle nous avons ajouté plusieurs fonctionnalités pour la gestion des identités, la mise en réseau, la sécurité, la mutualisation, la journalisation, les métriques, etc. Bien que nous utilisions Kubernetes pour répondre à nos besoins internes, nous avons dû prendre des décisions difficiles, notamment celle de ne pas exposer directement ces clusters Kubernetes à nos utilisateurs internes et/ou à nos clients pour qu’ils y exécutent leurs charges de travail (nous y reviendrons plus tard, la mutualisation étant pour nous un objectif essentiel).
Outre les nombreuses nouvelles fonctionnalités que nous devions ajouter, nous devions également exécuter nos charges de travail et services aux côtés de ceux de nos clients dans de nombreux emplacements, à la périphérie, sur notre réseau et dans des clouds publics et privés. Nous avons donc dû développer des capacités supplémentaires afin de gérer plusieurs clusters dans différents environnements… tous interconnectés au moyen de notre réseau mondial et de nos passerelles d’applications distribuées, afin d’assurer une connectivité Zero Trust au niveau applicatif entre ces clusters.
La partie difficile : la mutualisation et la gestion multicluster pour Kubernetes
Créer et exploiter des applications s’exécutant dans un seul cluster Kubernetes est une tâche complexe, même lorsque le cluster est géré par un fournisseur de cloud. C’est pourquoi les équipes DevOps et SRE cherchent généralement à réduire leur charge opérationnelle et à éviter la complexité liée à la gestion de nombreux clusters. Il est assez courant de voir des équipes créer un grand cluster Kubernetes unique et y regrouper tous les types de ressources. Cette approche peut sembler avantageuse, car elle permet de simplifier les opérations et d’exploiter le cluster de manière à optimiser l’efficacité des ressources de calcul et les coûts. Toutefois, ce n’est pas la meilleure solution, et ce pour plusieurs raisons. Tout d’abord, les besoins des charges de travail de production sont très différents de ceux des environnements de développement, de test et de préproduction : des charges de travail de développement instables peuvent potentiellement perturber des charges de travail de production plus stables.
Outre les besoins propres aux différentes charges de travail, les limites de K8s en matière de sécurité et d’isolation constituent un autre facteur justifiant le recours à plusieurs clusters. Une approche courante pour assurer la sécurité et l’isolation des ressources dans K8s consiste à créer des clusters indépendants pour chaque locataire selon un modèle mutualisé. Si cette solution peut être envisageable dans le cloud, il n’est pas possible d’exécuter plusieurs clusters en périphérie. Les sites périphériques disposent de ressources de calcul et de stockage limitées, ainsi que d’une bande passante réseau restreinte pour envoyer au cloud central les journaux et les métriques de chaque cluster supplémentaire.
Pour résoudre le problème lié à la multiplicité des clusters Kubernetes, nous avons évalué Rancher pour la gestion centralisée de nos clusters Kubernetes (lorsque nous avons commencé, Anthos et Azure Arc n’existaient pas encore), ainsi que KubeFed. Les deux approches disponibles à l’époque étaient les suivantes (et la situation reste inchangée aujourd’hui) :
- La gestion multicluster (par exemple avec Rancher) depuis une console centralisée nous aurait permis de déployer plusieurs clusters à n’importe quel emplacement et d’effectuer des opérations de gestion du cycle de vie, telles que des mises à niveau, des restaurations, etc. Certains de ces systèmes permettaient également de gérer individuellement un cluster grâce à l’automatisation de la configuration et du déploiement des applications
- Une autre approche consiste à déployer un plan de contrôle de fédération de clusters Kubernetes (KubeFed), qui permet de faire apparaître plusieurs clusters physiques comme un seul cluster. Ce projet n’en était qu’à ses débuts lorsque nous l’avons étudié et, aujourd’hui encore, il n’en est qu’au stade alpha.
À la suite de l’annonce récente de GCP Anthos et d’Azure Arc, nous avons réévalué notre décision initiale de créer un plan de contrôle distribué. Nous en avons conclu que même ces deux nouvelles offres n’auraient pas permis de résoudre deux problèmes critiques liés aux clusters distribués. Les deux fonctionnalités essentielles dont notre plateforme avait besoin étaient les suivantes :
- Gérer plusieurs clusters comme une flotte afin de pouvoir effectuer des opérations sur l’ensemble des clusters ou sur un groupe logique de clusters — notamment des opérations de configuration, de déploiement, de collecte de métriques, etc. Cette approche est essentielle pour réduire la charge opérationnelle de nos équipes SRE, faciliter le débogage pour nos équipes DevOps et améliorer l’évolutivité de notre système
- Possibilité de partitionner un cluster Kubernetes physique en vue d’une utilisation mutualisée, sans avoir à créer de clusters physiques supplémentaires — un point particulièrement crucial dans les environnements aux ressources limitées, où nous ne souhaitons pas ajouter de nouveaux clusters physiques uniquement pour assurer la mutualisation
Pour résoudre ces deux problèmes, nous avons dû mettre au point une nouvelle technique — le plan de contrôle distribué — afin de réduire la charge opérationnelle liée aux « multiples » clusters et de fournir un équivalent de « plusieurs clusters » pour la mutualisation dans les environnements aux ressources limitées.
Plan de contrôle distribué : comment nous avons mis en œuvre Kubernetes multicluster
Notre équipe chargée de la plateforme a décidé de créer un plan de contrôle distribué pour Kubernetes, qui met des API Kubernetes à la disposition de notre équipe. Toutefois, ces API proviennent de clusters « virtuels » qui n’existent que dans notre plan de contrôle — un serveur d’API K8s virtuel (vK8s) pour un cluster K8s virtuel (comme illustré à la Figure 1). Ce plan de contrôle traduit les intentions de l’utilisateur sur plusieurs clusters Kubernetes physiques exécutés en périphérie, dans nos points de présence réseau et dans des environnements de cloud public. Ces clusters physiques sont uniquement accessibles à notre plan de contrôle distribué, et non aux locataires ou utilisateurs individuels.
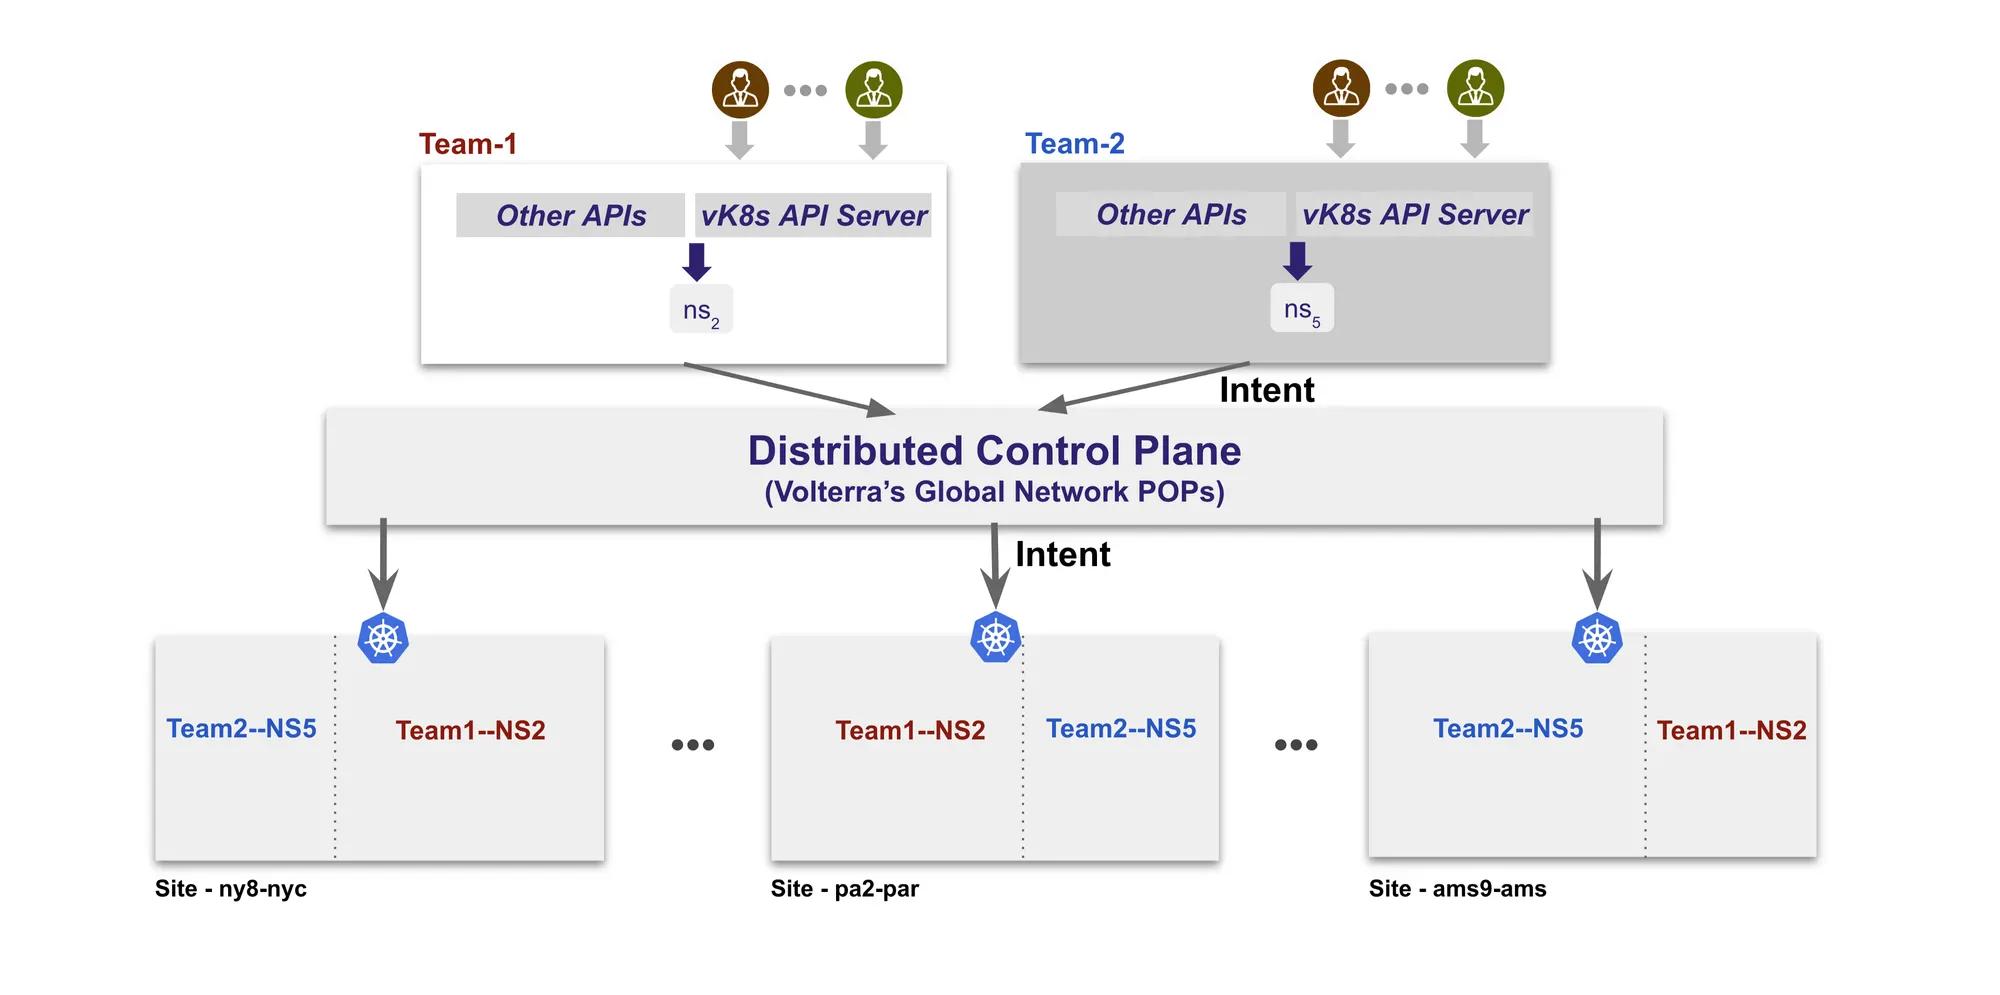
Ce plan de contrôle fournit à chaque locataire un ou plusieurs clusters d’applications « virtuels » sur lesquels il peut déployer ses applications. Selon la configuration, le plan de contrôle les réplique et les gère sur plusieurs clusters Kubernetes physiques. Outre les opérations de configuration et de déploiement, les opérations de surveillance suivent également ce cluster « virtuel », sans qu’il soit nécessaire de développer des outils pour collecter et analyser les données provenant de plusieurs clusters physiques.
Prenons l’exemple d’une application d’interface utilisateur appelée productpage, que l’utilisateur souhaite exécuter de manière distribuée sur trois sites — pa2-par, ny8-nyc et ams9-ams — avec deux réplicas sur chacun d’eux. Lorsque l’utilisateur crée un objet vK8s et l’associe à un cluster virtuel, un serveur d’API vK8s utilisable avec la commande kubectl standard est immédiatement provisionné.
À l’étape suivante, l’utilisateur télécharge le kubeconfig de ce cluster virtuel et crée un fichier YAML standard pour décrire un déploiement K8s de productpage.
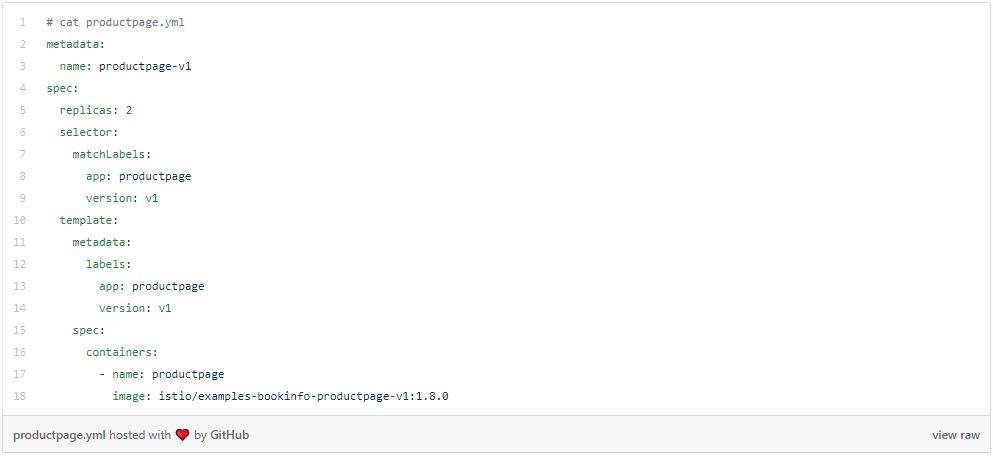
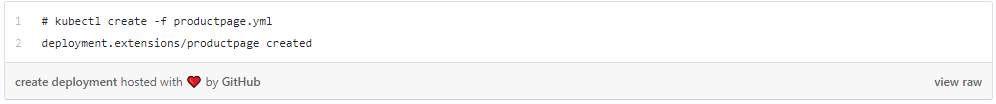
Après avoir créé la spécification de déploiement, l’utilisateur peut procéder à la création d’un déploiement sur ce cluster virtuel :
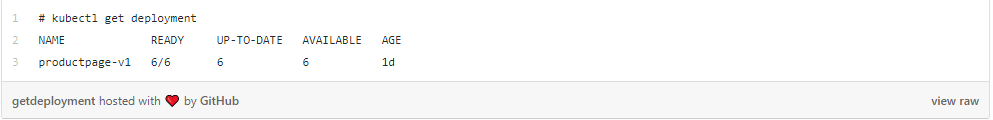
À présent, si l’utilisateur vérifie son déploiement, il constate que 6 réplicas ont été démarrés, à raison de 2 dans chaque emplacement (pa2-par, ny8-nyc et ams9-ams).
La sortie suivante montre deux pods en cours d’exécution dans chaque emplacement, avec leur association à un nœud physique spécifique.
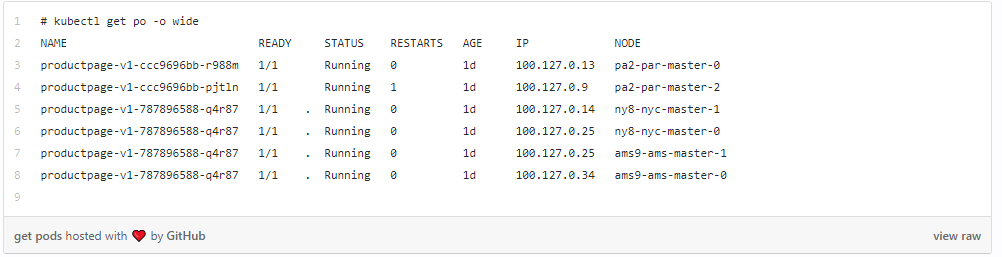
Cet exemple simple montre à quel point il est facile de répliquer n’importe quelle application sur plusieurs clusters en quelques minutes, sans aucune contrainte d’installation ni de gestion. En plus de traduire l’intention en configuration, le plan de contrôle distribué fournit également une observabilité à l’échelle du cluster virtuel, plutôt qu’au niveau de chaque cluster individuel.
Contrôle distribué et gestion centralisée pour les environnements mutualisés
Comme vous pouvez le voir dans la figure 2, notre plan de gestion centralisé est déployé sur deux fournisseurs de cloud public (une région chez chacun) : l’un sur AWS et l’autre sur Azure (à des fins de redondance). Ce plan de gestion permet à notre équipe SRE de créer des locataires avec une isolation stricte ; par exemple, une équipe de développement travaillant sur notre service VoltMesh peut constituer un locataire, tandis qu’une équipe chargée des solutions clients et travaillant sur des démonstrations de faisabilité pour des clients peut disposer de son propre locataire et de son propre ensemble d’utilisateurs.
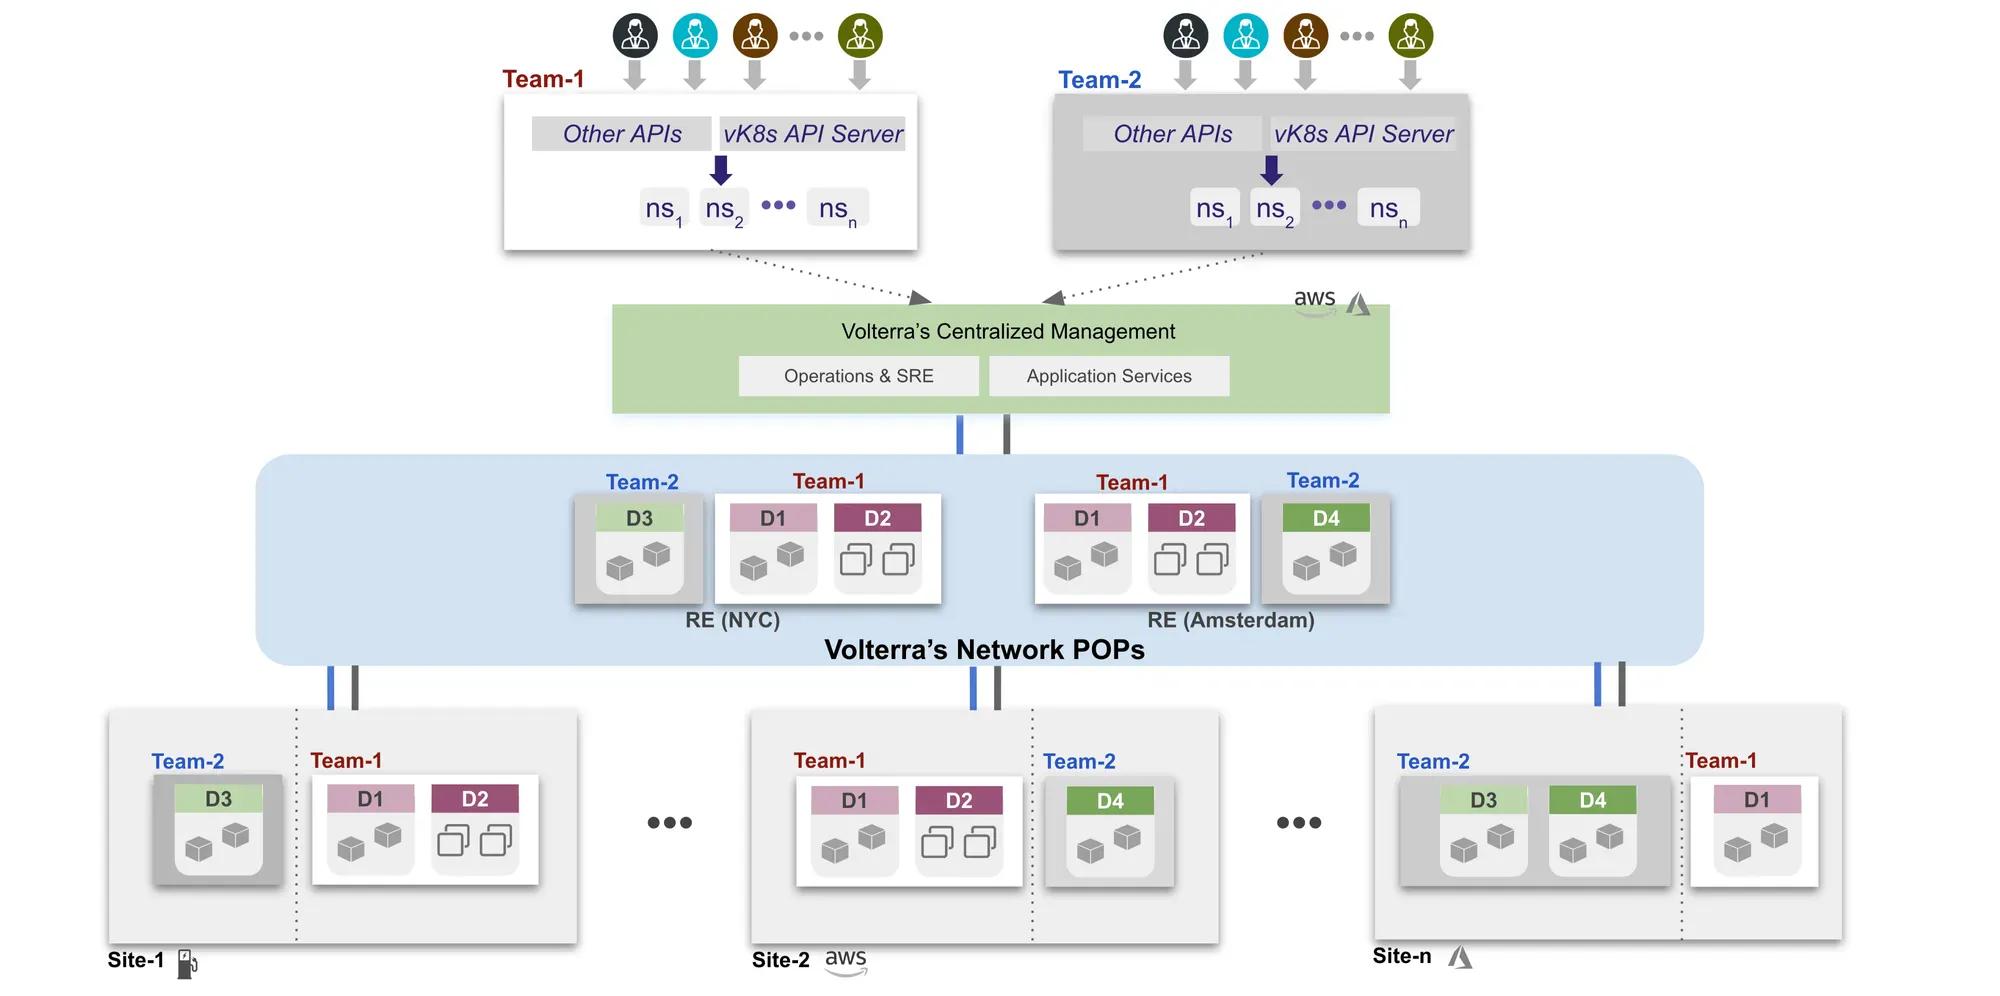
Chacun de ces locataires peut créer plusieurs espaces de noms et affecter un groupe d’utilisateurs afin qu’ils collaborent au sein de ces espaces. Ces espaces de noms ne sont pas des espaces de noms Kubernetes : ils constituent une frontière d’isolation sur notre plateforme, avec des règles RBAC et des politiques IAM pour les utilisateurs.
Lorsqu’un utilisateur au sein d’un espace de noms souhaite créer un cluster d’applications, il crée un objet vK8s, qui crée à son tour un serveur d’API vK8s dans notre plan de gestion. À l’aide de cet objet vK8s, l’utilisateur peut créer des déploiements, des StatefulSets, des PVC, etc. Le plan de contrôle veille alors à ce que ces opérations soient effectuées sur un ou plusieurs clusters physiques, en fonction des sites associés à l’objet vK8s.
Étant donné que chaque locataire et chaque utilisateur emploie les opérations K8s standard sans aucune modification, le système est compatible avec de nombreux outils couramment utilisés par les opérateurs, tels que Spinnaker, Helm ou Jenkins.
Avantages obtenus grâce à un plan de contrôle distribué
Le principal avantage d’un plan de contrôle distribué est qu’il a permis de réduire la charge opérationnelle de nos équipes SRE et DevOps. Elles peuvent désormais effectuer des opérations (configuration, déploiement, surveillance, gestion des politiques, etc.) sur un cluster virtuel, et le plan de contrôle les répercute automatiquement sur plusieurs clusters physiques. Outre la simplification de l’exploitation de plusieurs clusters, le plan de contrôle a également résolu les problèmes de sécurité et d’isolation liés à l’architecture mutualisée.
Ce plan de contrôle distribué a également amélioré la productivité des développeurs qui souhaitent ajouter de nouvelles fonctionnalités à notre plateforme : ils n’ont plus besoin de créer de nouvelles automatisations chaque fois qu’ils ajoutent des fonctionnalités ayant une incidence sur la configuration ou les opérations de plusieurs clusters. Ils utilisent le modèle de configuration basé sur les intentions, et le plan de contrôle sait ce qu’il doit faire. De plus, ils peuvent continuer à interagir avec cet objet distribué multicluster — Kubernetes virtuel — à l’aide de kubectl, sans avoir à utiliser une énième interface en ligne de commande.
Après plus d’un an d’utilisation dans nos environnements de développement et de test, de préproduction et de production, nous avons constaté que ce plan de contrôle distribué à l’échelle mondiale (exécuté dans les points de présence de notre réseau) offre également des avantages considérables en matière de capacité de montée en charge, de performances et de fiabilité — ce que nous n’avions pas pleinement envisagé à nos débuts. Nous présenterons cette découverte lors de notre prochaine intervention à la KubeCon, ainsi que dans un article de blog distinct au cours des prochaines semaines.
À suivre…
Cette série d’articles de blog abordera les différents aspects de la conception et de l’exploitation de notre service SaaS distribué à l’échelle mondiale, avec de nombreux clusters applicatifs dans le cloud public, nos PoP de réseau privé et nos sites en périphérie. Prochain sujet : Un maillage de services mondial pour les applications distribuées…
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.