
L’équipe Solutions de Volterra conçoit et gère de nombreux cas d’usage potentiels de la plateforme Volterra afin d’en démontrer la valeur. Ces cas d’usage sont souvent transformés en guides pratiques permettant aux clients de faire leurs premiers pas avec Volterra.
L’équipe Solutions souhaitait disposer d’une méthode plus rapide et automatisée pour déployer nos cas d’usage en interne, à la demande et avec le moins d’intervention humaine possible. Nos déploiements couvraient un environnement multicloud hybride reposant à la fois sur des plateformes IaaS (AWS, Azure et GCP) et sur des environnements de centres de données privés (VMware vSphere et Vagrant KVM). Nous voulions simplifier la gestion de ces environnements en proposant un outil unique capable de créer des déploiements dans n’importe quel environnement, sans que chaque utilisateur ait à créer des comptes d’accès supplémentaires ni à gérer des identifiants supplémentaires pour chaque plateforme de virtualisation ou fournisseur IaaS. Cet outil devait également pouvoir évoluer afin de prendre en charge plusieurs utilisateurs et déploiements simultanés.
En résumé, le principal problème que nous souhaitions résoudre consistait à créer un outil automatisé de déploiement de cas d’usage de solutions, capable de monter en charge et de gérer des déploiements simultanés dans des environnements multicloud hybrides, avec le moins d’intervention possible de la part des utilisateurs.
Le projet Altered-Carbon (AC)
À cette fin, nous avons créé un projet appelé Altered-Carbon, souvent abrégé en AC. Le projet AC est un pipeline GitLab dynamique capable de créer plus de 20 cas d’usage différents pour les solutions Volterra. Grâce à l’automatisation du pipeline, nous avons créé des « déploiements en un clic » exécutables à l’aide d’une seule commande, permettant aux utilisateurs de déployer facilement plusieurs clusters correspondant à différents cas d’usage, à la demande ou au moyen de tâches cron quotidiennes planifiées.
À titre de référence, dans AC, nous appelons chaque déploiement une STACK et chaque cas d’usage unique une SLEEVE.
Développement de projets
Nous avons commencé le développement du projet AC en automatisant le cas d’usage hello-cloud dans le premier SLEEVE. Le cas d’usage hello-cloud crée un site Volterra dans AWS et Azure, puis regroupe ces sites au sein d’un cluster Volterra VK8s (Kubernetes virtuel) et déploie, via VK8s, une application composée de 10 pods sur les deux sites. Nous avons commencé par créer des modèles Terraform supplémentaires et des scripts shell utilisant l’API Volterra afin de mettre en place un workflow GitLab entièrement automatisé et pilotable par des pipelines CI/CD. Nous nous sommes ensuite attachés à rendre cette méthode de déploiement réutilisable et évolutive.
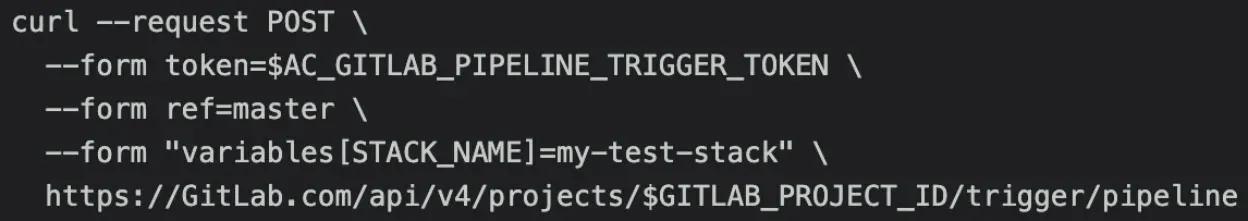
L’ajout de conventions de nommage uniques a été le problème suivant auquel nous nous sommes attaqués lors de la conception. Afin de permettre plusieurs déploiements du cas d’usage dans un même environnement de locataire Volterra, nous devions nous assurer que les ressources créées dans chaque STACK portaient des noms uniques et ne tentaient pas de créer des ressources dont les noms existaient déjà dans d’autres STACKs du même environnement de locataire Volterra. Pour éviter d’éventuels conflits de nommage, nous avons commencé à intégrer aux déclencheurs de pipeline le concept de variables d’environnement uniques fournies par l’utilisateur, qui allait devenir un élément central du projet. La variable d’environnement STACK_NAME a été introduite et utilisée par terraform afin d’inclure une chaîne définie par l’utilisateur dans le nom de toutes les ressources associées à une STACK donnée. Au lieu d’être déclenchées lors d’un commit, les tâches des pipelines AC ont été configurées pour s’exécuter uniquement à la suite d’un appel à l’API effectué par un utilisateur GitLab à l’aide d’un jeton de déclenchement CI de projet GitLab, ce qui permet de contrôler le pipeline par une intervention humaine ou des appels d’API externes. Grâce à des appels d’API semblables à celui de l’exemple suivant, les utilisateurs pouvaient atteindre notre objectif consistant à créer plusieurs déploiements sans conflits de ressources, à l’aide d’une seule commande.
Nous nous sommes ensuite efforcés de créer, à partir de ce modèle, des options de déploiement supplémentaires. Les déploiements du site hello-cloud sur AWS et Azure constituaient également des cas d’usage distincts que nous souhaitions déployer indépendamment avec AC. C’est alors que nous avons rencontré notre premier problème majeur avec GitLab. Dans les pipelines CI/CD de GitLab, toutes les tâches du pipeline d’un projet sont liées. Cela nous a semblé contre-intuitif, car de nombreuses tâches nécessaires au déploiement de hello-cloud ne l’étaient pas pour les déploiements du site sur AWS ou Azure. Nous voulions en fait qu’un seul pipeline CI de projet GitLab contienne plusieurs pipelines indépendants, pouvant être déclenchés à la demande avec des ensembles distincts de tâches CI lorsque cela était nécessaire.
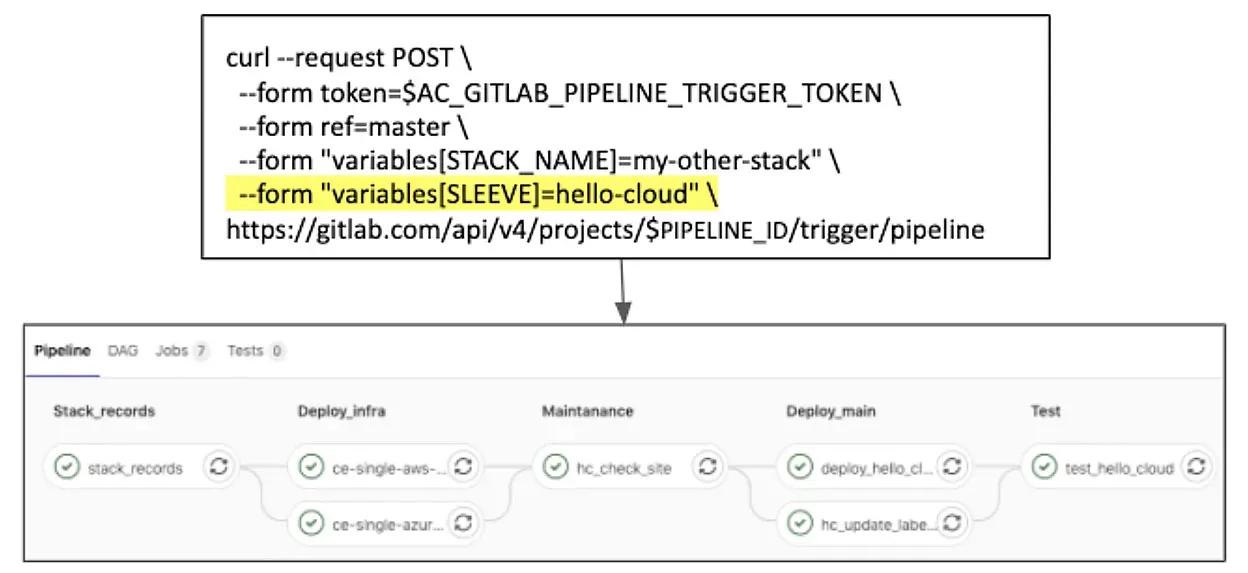
Pour résoudre ce problème, nous avons introduit la variable d’environnement SLEEVE dans la structure du pipeline, qui intégrait les options GitLab CI/CD only/except . Cela permettait de limiter les tâches CI déclenchées dans n’importe quel pipeline en fonction de la valeur de SLEEVE fournie lors du déclenchement du pipeline. Nous disposions alors de nos trois premières options SLEEVE : simple-aws, simple-azure et hello-cloud. Chaque SLEEVE définissait le cas d’usage qu’un utilisateur souhaitait déployer (et contrôlait ainsi les tâches CI du pipeline déclenché), ainsi qu’un STACK_NAME permettant de nommer les ressources créées par ce pipeline. La structure de commande suivante, qui intègre ces deux variables d’environnement, constituait la commande AC la plus élémentaire et reste encore utilisée aujourd’hui :
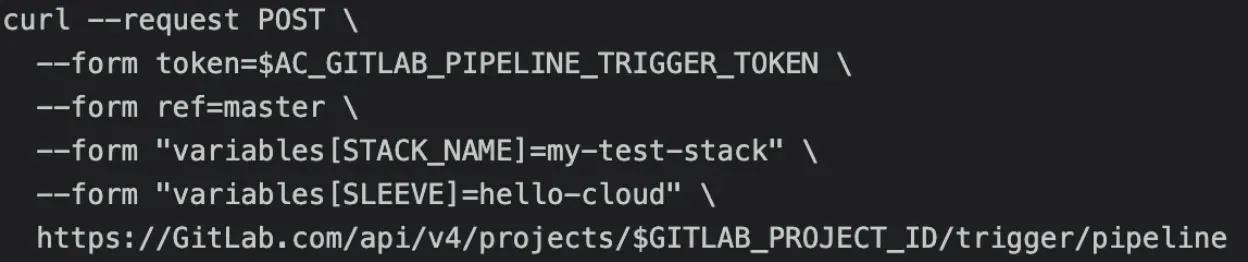
L’image suivante illustre comment la modification de la variable d’environnement SLEEVE modifie les tâches déclenchées à chaque exécution du pipeline AC.
Pipeline SLEEVE « simple-aws » :
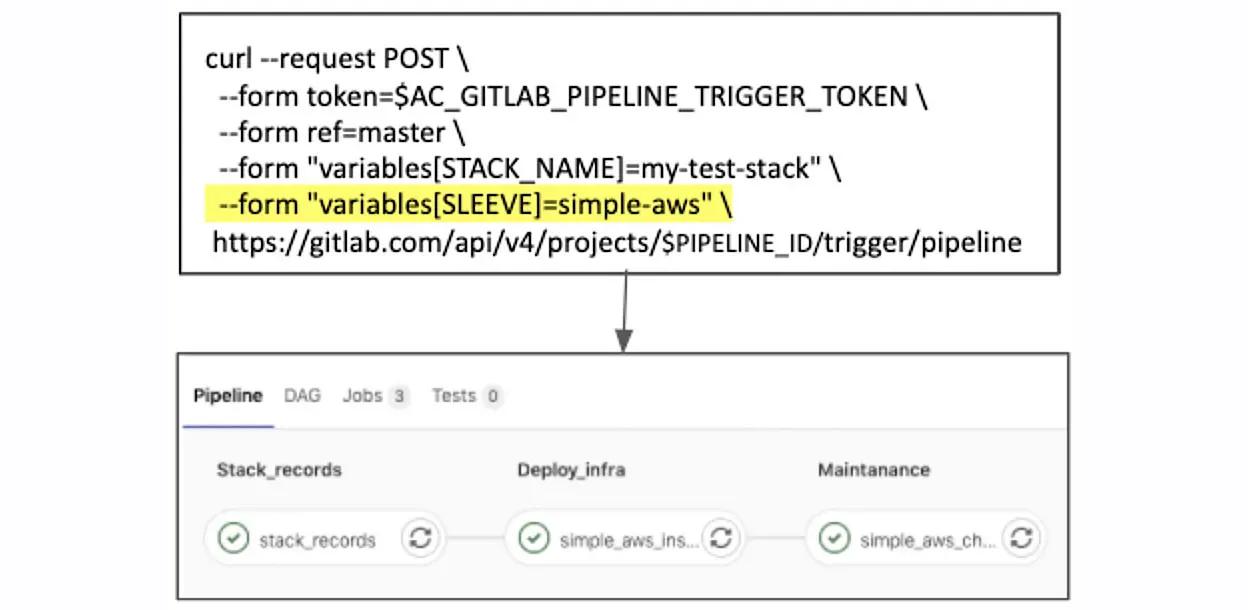
Pipeline SLEEVE « hello-cloud » :
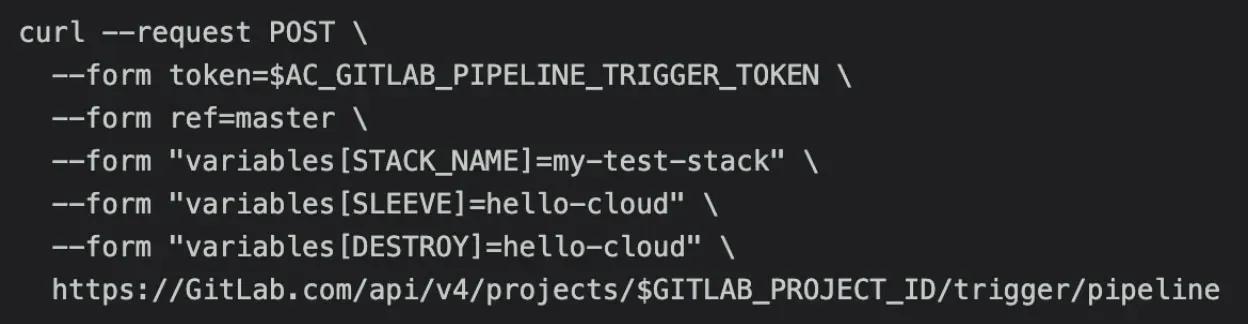
Nous avons également ajouté des tâches supplémentaires qui se déclenchent lorsque la variable d’environnement DESTROY est fournie lors du déclenchement d’un pipeline. Cela permet d’effectuer l’opération inverse afin de supprimer les ressources créées par AC. Voici un exemple permettant de supprimer les ressources d’une STACK existante :
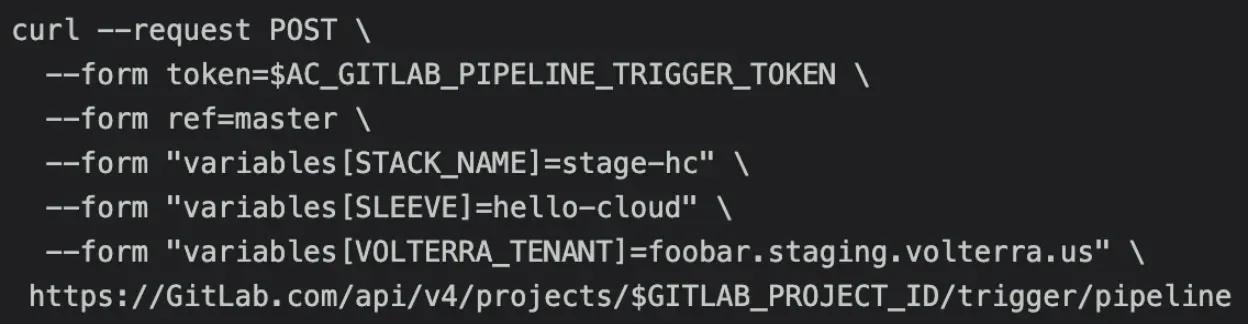
D’autres variables d’environnement étaient stockées dans GitLab avec des valeurs par défaut qui pouvaient être remplacées en ajoutant des valeurs à la commande de déclenchement. Par exemple, l’URL de l’API de nos environnements de locataires Volterra était stockée dans la variable d’environnement VOLTERRATENANT. Si un utilisateur ajoutait la variable d’environnement VOLTERRATENANT à sa commande d’API, cela remplaçait la valeur par défaut et redirigeait le déploiement vers l’emplacement souhaité. Cette possibilité s’est révélée essentielle pour nos tests internes, car l’équipe chargée des solutions gère des dizaines d’environnements de locataires Volterra et doit pouvoir passer de l’un à l’autre en fonction de la tâche à accomplir :
Ces variables d’environnement facultatives pouvaient être utilisées pour mieux contrôler les déploiements lorsque cela était nécessaire, tout en offrant une option de déploiement par défaut plus simple aux utilisateurs qui ne souhaitaient pas gérer cette charge supplémentaire. Elles nous permettaient également de basculer facilement entre les déploiements dans les environnements de préproduction et de production, ce qui allait s’avérer essentiel pour notre principal utilisateur d’AC.
Cas d’usage des solutions : tests de régression nocturnes
Comme indiqué précédemment, chaque SLEEVE dans AC représentait un cas d’usage de Volterra qui constituait souvent le premier contact des clients avec le produit. Il était essentiel de veiller à ce que ces cas d’usage soient fonctionnels et exempts de bogues afin de donner une excellente première impression du produit. Avant la création d’AC, tester les cas d’usage pour vérifier qu’ils étaient fonctionnels et à jour avec les dernières versions du logiciel et de l’API de Volterra prenait beaucoup de temps. Les étapes manuelles requises pour chaque cas d’usage limitaient les possibilités de tests de régression, qui n’étaient pas effectués assez souvent et étaient sujets aux erreurs humaines.
Cependant, grâce à l’automatisation d’AC, des tâches planifiées quotidiennement pouvaient déclencher le déploiement de n’importe quel cas d’usage spécifique à l’aide d’un SLEEVE, puis supprimer les ressources créées une fois le déploiement terminé ou après son échec. Ce processus était utilisé dans les environnements de préproduction et de production afin de vérifier si des modifications récentes apportées à l’un ou l’autre avaient affecté le déploiement du cas d’usage ou provoqué des bogues dans le logiciel Volterra. Nous pouvions ensuite corriger les erreurs relevées dans nos guides de cas d’usage ou détecter rapidement les bogues du logiciel Volterra et soumettre des tickets de résolution.
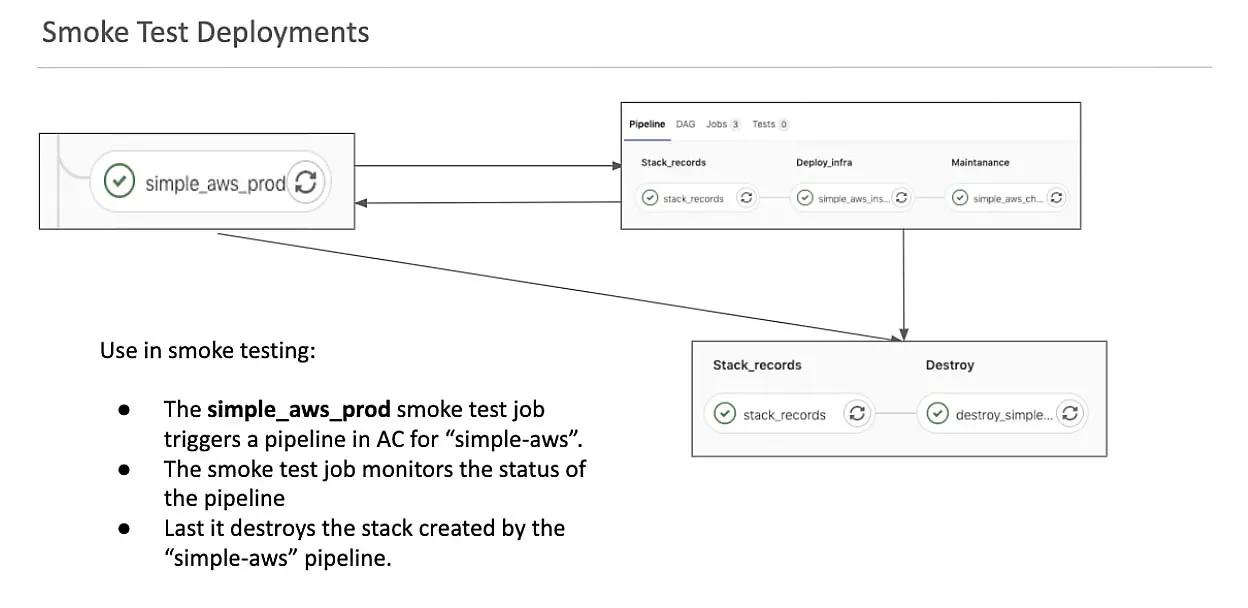
Nous avons créé un dépôt et un pipeline distincts, avec des tâches planifiées utilisant les commandes de déclenchement de l’API GitLab afin de générer simultanément plusieurs piles à l’aide de différents SLEEVE. Chaque tâche de test de bon fonctionnement commençait par déclencher la création d’une pile au moyen d’un pipeline AC indépendant. Elle récupérait ensuite l’identifiant du pipeline dans la sortie standard de l’appel de déclenchement, puis utilisait l’API GitLab pour surveiller l’état du pipeline déclenché. Une fois le pipeline terminé, qu’il ait réussi ou échoué, elle exécutait le pipeline de destruction sur la même STACK afin de supprimer les ressources créées après le test.
L’image suivante détaille ce processus et présente les tâches qu’il déclenche dans AC pour les commandes de création et de destruction :
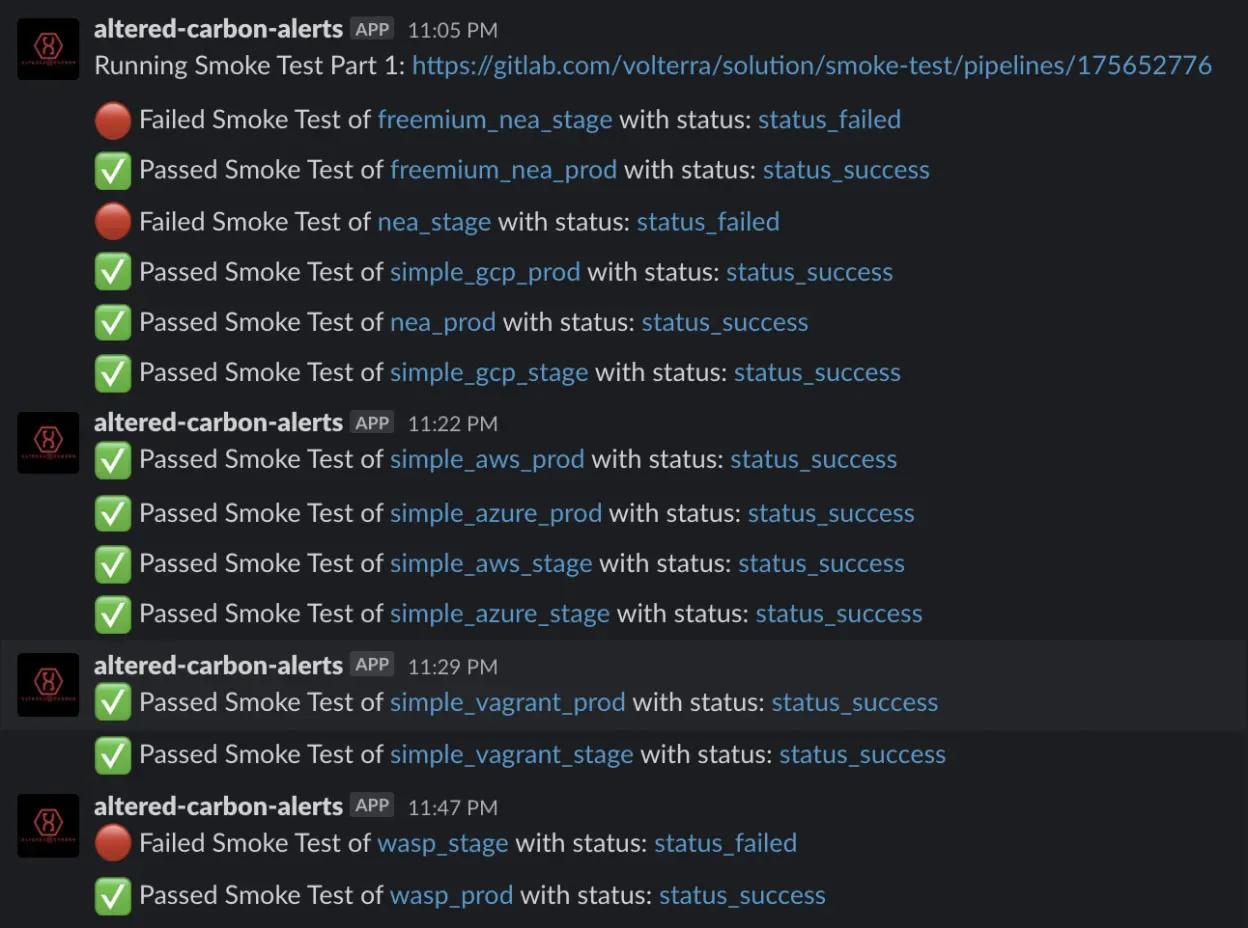
Lorsqu’un pipeline de tests de fumée échouait, nous pouvions fournir les variables d’environnement à utiliser dans un déclencheur AC afin de reproduire le problème. Ces informations pouvaient être ajoutées à nos tickets d’incident technique, ce qui permettait à nos développeurs de recréer facilement les déploiements ayant échoué. Puis, à mesure que de nouveaux SLEEVES étaient finalisés, nous avons ajouté de plus en plus de tâches aux pipelines d’intégration continue afin d’élargir la couverture des tests. Pour améliorer encore la visibilité de ces tests, nous avons intégré Slack et configuré les tâches de tests de fumée pour qu’elles envoient un message indiquant la réussite ou l’échec de chaque exécution du pipeline, accompagné de liens et d’informations détaillées vers les pages web d’intégration continue correspondantes dans les projets Altered-Carbon et Smoke-Test.
Conservation des enregistrements de pile et navigation vers l’URL web du pipeline
La complexité du projet s’est accrue à mesure qu’AC évoluait, intégrait de nouveaux utilisateurs de l’équipe Solutions et créait toujours plus de stacks. Cela a commencé à poser des problèmes majeurs lors de la navigation dans l’interface Web des pipelines GitLab. Nous utilisions les pipelines GitLab d’une manière très peu conventionnelle, ce qui rendait leur interface Web difficile à utiliser pour retrouver les exécutions individuelles associées aux STACKs que nous créions.
Les pipelines GitLab qui gèrent les déploiements au moyen de workflows GitOps semblent particulièrement adaptés à un ensemble statique et prédéfini de clusters. Dans ce cas, chaque exécution d’un pipeline GitLab affecterait systématiquement les mêmes clusters et les mêmes ressources. L’historique de déploiement de ces clusters correspondrait alors à l’historique des pipelines affiché dans l’interface web de GitLab. Cependant, AC est dynamique et gère un ensemble de ressources en constante évolution : chaque exécution de pipeline peut utiliser un ensemble de tâches totalement différent et gérer différents STACKs de ressources auprès de différents fournisseurs de virtualisation. Cette différenciation introduite par les conventions SLEEVE et STACK rend très difficile l’identification du pipeline correspondant à chaque stack. Par exemple, examinons l’interface web des pipelines CI/CD GitLab pour AC :
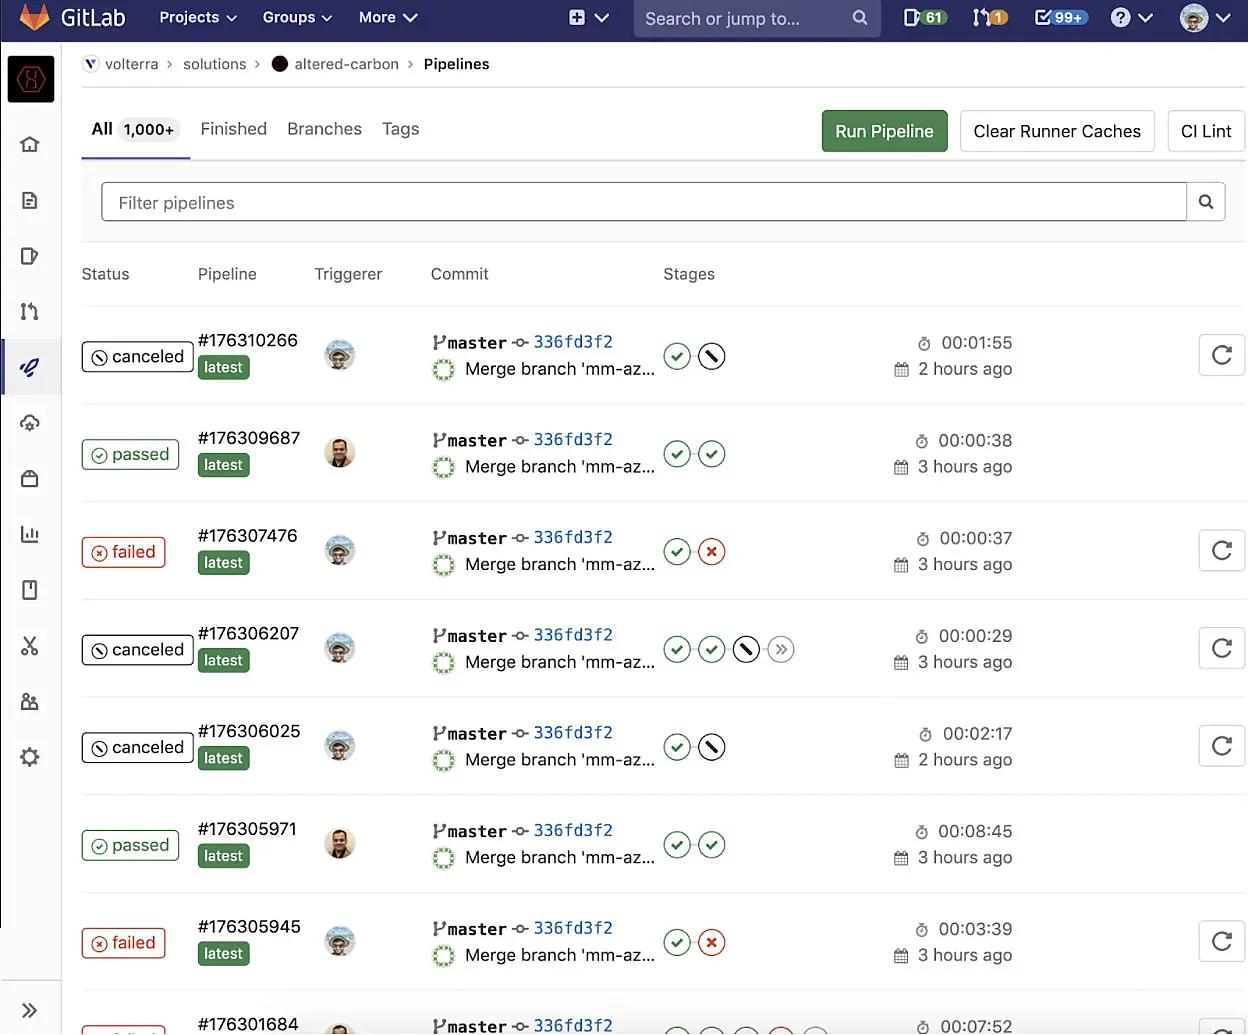
Depuis cette vue, il est impossible de déterminer quel STACK ou SLEEVE est modifié par un pipeline donné sans examiner chaque pipeline individuellement. Lorsque des centaines de pipelines sont exécutés chaque jour, il peut être fastidieux de retrouver l’exécution précise qui a créé ou détruit un STACK particulier, ou d’obtenir des informations spécifiques sur ce STACK. Pour résoudre ce problème dès les premières étapes du développement d’AC, nous avons ajouté un système simple de tenue de registres. Une tâche appelée stack-records s’exécutait avant chaque pipeline. Elle recueillait les informations relatives au stack lors de sa création et générait un fichier JSON, ensuite chargé dans le compartiment de stockage S3 utilisé pour conserver les sauvegardes de notre tfstate. Voici un exemple de registre de stack :
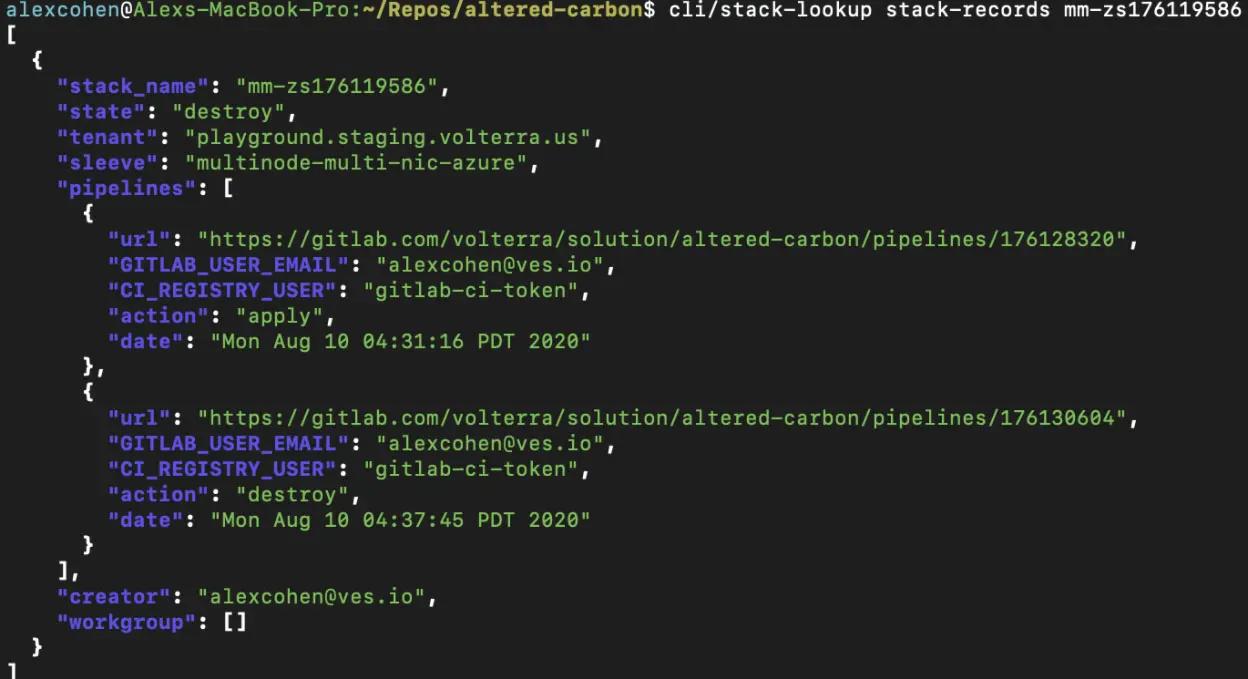
Les fichiers stack-record.json contiennent des informations détaillées sur chaque stack, notamment :
- Quel environnement de locataire Volterra a été utilisé.
- Quel SLEEVE a été utilisé.
- Indique si la STACK était en cours d’exécution dans l’état « apply » ou si ses ressources avaient été supprimées avec l’état « destroy ».
- Quel utilisateur GitLab a créé la pile.
- Un groupe de travail répertoriant les autres utilisateurs autorisés à modifier une STACK.
- Et surtout, un tableau de pipelines contenant l’URL web de chaque exécution de pipeline lancée sur la STACK, l’identité de la personne ayant déclenché le pipeline, si celui-ci a appliqué ou détruit une STACK, ainsi que la date et l’heure de son déclenchement.
Cela permettait de conserver un historique de toutes les URL de pipelines associées à chaque stack. Un simple script CLI capable d’accéder à ces fichiers via des appels à l’API S3 a également été créé afin de simplifier davantage le processus. Les utilisateurs d’AC pouvaient se servir de ces documents pour suivre l’historique des stacks et consulter leurs enregistrements afin de savoir quand elles avaient été modifiées.
Les enregistrements de piles nous ont également permis de mettre en place certains niveaux de contrôle des utilisateurs et de détection des erreurs sur les pipelines que nous déployons. Par exemple, une modification apportée au logiciel Volterra après la création d’AC nous a contraints à limiter à 17 caractères les noms des clusters de sites (une valeur dérivée de la valeur STACKNAME) utilisés lors de la création de sites Volterra. Nous avons donc ajouté une vérification à la tâche de gestion des enregistrements de piles afin que les pipelines échouent avant l’exécution de toute étape de déploiement si la valeur STACKNAME dépassait la limite de caractères. D’autres contrôles personnalisés ont été ajoutés, notamment des niveaux d’autorisation dans AC qui déterminent quels utilisateurs peuvent modifier certaines piles gérées par AC.
- Autorisations de niveau administrateur : les deux principaux développeurs d’AC peuvent créer ou détruire n’importe quelle stack à des fins de débogage. -Le niveau propriétaire ou créateur est attribué à l’utilisateur GitLab qui crée initialement une STACK. Son adresse e-mail GitLab est enregistrée dans les enregistrements de stack en tant que créateur, et il peut créer ou détruire une stack.
- Ensuite, nous avons les autorisations au niveau du groupe de travail : l’adresse e-mail de l’utilisateur GitLab peut être ajoutée au tableau des groupes de travail dans l’enregistrement de la pile, ce qui permet à des utilisateurs autres que le créateur d’appliquer ou de détruire une PILE.
- Un utilisateur ne disposant d’aucun de ces niveaux d’autorisation ne pourra pas modifier une STACK. Si un tel utilisateur tente de modifier une STACK pour laquelle il ne dispose d’aucune autorisation, le job stack-records échouera avant le déploiement de toute ressource.
Utilisation interne et couverture actuelle des tests
Aujourd’hui, AC est devenu un outil essentiel pour l’équipe Solutions, qui l’utilise pour réaliser la majeure partie de nos tests de régression et de nos tâches d’automatisation. Il sert principalement aux tests de fumée de régression, aux tests de montée en charge, aux tests de facturation des produits, ainsi qu’aux déploiements simplifiés utilisés lors des démonstrations de produits.
Les déploiements automatisés sont principalement utilisés dans le cadre de nos tests de régression nocturnes. Chaque nuit, nous testons chacun de nos SLEEVES dans des environnements de production et de préproduction en déclenchant un déploiement, puis en supprimant les ressources créées. Lorsque des changements surviennent, nous pouvons les détecter rapidement et soumettre des rapports de bogues afin de mettre à jour nos guides. Notre couverture de test actuelle comprend :
- Passerelle Kubernetes sécurisée.
- Sécurité des applications web.
- Applications en périphérie de réseau qui déploient notre application « hipster-co » standard composée de 10 pods, ainsi qu’une application plus légère composée d’un seul pod.
- Hello-Cloud.
- Sites Volterra CE à nœud unique et interface réseau unique sur AWS, GCP, Azure, VSphere et KVM/Vagrant.
- Sites Volterra CE à nœud unique avec deux interfaces réseau sur AWS, GCP, Azure, VSphere et KVM/Vagrant.
- Déploiements à grande échelle de sites Volterra CE à nœud unique et interface réseau unique (avec GCP, VSphere et KVM), en créant plusieurs sites CE à nœud unique et carte réseau unique afin de tester les capacités de mise à l’échelle de Volterra.
- Sites Volterra CE à nœud unique avec plusieurs interfaces réseau sur AWS, GCP, Azure, VSphere et KVM/Vagrant.
- Sites Volterra CE à plusieurs nœuds avec une seule interface réseau sur AWS, GCP, Azure, VSphere et KVM/Vagrant.
- Sites Volterra CE à plusieurs nœuds et plusieurs interfaces réseau sur AWS, GCP, Azure, VSphere et KVM/Vagrant.
Nous disposons également de suites spécialisées de tests de montée en charge qui automatisent le déploiement simultané de jusqu’à 400 sites afin de tester les capacités de mise à l’échelle du logiciel Volterra. Elles ont été testées avec GCP, vSphere et KVM.
Le déploiement automatisé et rapide de cas d’usage permet aux membres de l’équipe Solutions de se concentrer sur d’autres tâches, améliorant ainsi l’efficacité interne. L’équipe Solutions utilise souvent AC pour déployer des dizaines de sites KVM, GCP et vSphere afin d’enregistrer des démonstrations vidéo. Cela nous fait gagner du temps lors de la création de sites Volterra destinés à la mise en place d’infrastructures plus complexes, en nous appuyant sur l’automatisation existante. Cette solution est également utilisée pour exécuter des tâches cron quotidiennes qui testent les fonctionnalités de facturation de la plateforme Volterra en automatisant le déploiement de cas d’usage liés à AWS, à la sécurité des applications web, à la passerelle Kubernetes sécurisée et aux applications en périphérie de réseau, sur un tenant Volterra spécialisé qui enregistre les informations de facturation.
Projets futurs et feuille de route
Notre utilisation d’AC donne déjà d’excellents résultats, et de nombreuses fonctionnalités et améliorations doivent encore être ajoutées au projet dans un avenir proche.
L’évolution majeure du projet réside dans l’ajout continu de nouvelles options SLEEVE afin de couvrir davantage de scénarios de déploiement. Pour chaque nouvelle SLEEVE ajoutée, nous intégrons une nouvelle tâche à nos tests de fumée de régression nocturnes, ce qui permet d’étendre la couverture des projets de déploiement de solutions. La plupart des SLEEVE précédentes étaient axées sur des scénarios à nœud unique et à interface réseau unique, mais nous avons récemment étendu notre couverture SLEEVE aux clusters de sites Volterra multinœuds ainsi qu’aux scénarios comportant plusieurs interfaces réseau sur les plateformes AWS, Azure, GCP, VMWare et KVM/Vagrant.
Nous cherchons également à améliorer notre système d’enregistrement des stacks. Nous allons accroître le niveau de détail de nos enregistrements AC et ajouter des fonctionnalités de recherche améliorées en intégrant des bases de données RDS pour stocker nos enregistrements. L’objectif est de permettre des recherches plus rapides dans notre environnement AC et d’offrir des critères de recherche plus précis, par exemple pour retrouver des stacks en fonction de leur état, de leur créateur, etc. Notre feuille de route prévoit également d’utiliser ces enregistrements pour concevoir une interface utilisateur personnalisée permettant de visualiser plus efficacement les déploiements créés avec AC.
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.