Les interruptions de service coûtent cher. Qu’elles soient dues à une attaque ou à une défaillance logicielle ou matérielle importe finalement peu. Le coût de chaque minute d’indisponibilité augmente en raison de la dépendance croissante de l’économie numérique moderne aux API et aux applications web.
Pour certains, ces coûts sont vertigineux. On estime que les 40 minutes d’indisponibilité d’Amazon en 2013lui ont coûté 2,64 millions de dollars. Cela représente 1 100 $ par seconde pour ceux qui ne souhaitent pas faire le calcul. Si cela vous semble effrayant, pensez à Google, dont les 5 minutes d’indisponibilité la même année lui ont coûté 109 000 $ par minute (soit 1 816,67 $ par seconde), pour un total faramineux de 545 000 $. Pour 5 minutes. Techniquement, si c’est la seule indisponibilité qu’ils ont subie, cela correspond aux fameux « cinq neuf » que les équipes informatiques sont chargées d’atteindre.
À quelle fréquence les pannes se produisent-elles ? Trop souvent, apparemment. Si vous ne l’avez jamais vue, jetez un œil à la carte en temps réel des pannes de Pingdom. Elle repose sur les données recueillies auprès de plus de 700 000 utilisateurs dans le monde. Cette carte à la fascination quelque peu morbide affiche les pannes survenues au cours de la dernière heure à travers le monde. Les éclairs lumineux qui représentent les pannes sont une touche bien pensée : ils illustrent parfaitement leur impact sur les utilisateurs.
Autrement dit, un impact indésirable.
L’économie numérique aggrave ce problème. Plus tôt cette année, une panne de S3 chez Amazon a mis hors service toute une série d’applications et de sites web de clients. Mais avant d’en rejeter la faute sur les fournisseurs de cloud public, un rapide coup d’œil au site builtwith.com vous fera vite changer d’avis. Le pourcentage de sites qui utilisent des CDN et des API est peut-être alarmant si l’on considère la dépendance que cela crée vis-à-vis de la disponibilité de quelqu’un d’autre . Il est difficile de trouver un site qui ne s’appuie pas sur au moins une API ou un service externe, ce qui accroît le risque d’indisponibilité, car si ce service externe est en panne, votre site l’est aussi.
En définitive, le secteur informatique a retenu la règle des « cinq neuf », car il est impossible d’atteindre une disponibilité de 100 %. Aujourd’hui, alors que les coûts par seconde montent en flèche sous l’effet de la transition de l’économie vers le numérique, l’essentiel est de réduire au minimum les temps d’arrêt. Autrement dit, se fixer des objectifs exigeant un faible temps moyen de résolution (MTTR) est tout aussi crucial — voire davantage — que de chercher à éliminer les temps d’arrêt.
L’un des principaux indicateurs des « organisations très performantes » dans le Rapport 2016 sur l’état du DevOps de Puppet Labs est le MTTR, défini comme le temps nécessaire pour rétablir le service lorsqu’un incident survient (par exemple, une interruption imprévue ou une dégradation du service). Les organisations les plus performantes (selon l’évaluation du rapport) mettent moins d’une heure, tandis que les organisations moyennement et peu performantes mettent « moins d’une journée ». « En d’autres termes », souligne le rapport, « le MTTR des organisations très performantes était 24 fois plus rapide que celui des organisations peu performantes ».
Vous remarquerez que la question n’était pas de savoir « si » un incident de service allait se produire, mais « quand » il se produirait. On part du principe qu’un incident surviendra ; l’essentiel est donc de réduire au minimum le délai de résolution. Une étude réalisée en 2016 par IHS indiquait que « les personnes interrogées subissent en moyenne 5 interruptions de service par mois, soit 27 heures d’indisponibilité mensuelle », ce qui coûte 1 $ à une entreprise de taille moyenne et jusqu’à 60 millions de dollars aux grandes entreprises.
Si l’on part du principe que la loi de Murphy l’emporte toujours sur celles de Moore et de Conway, la solution consiste à réduire au maximum le MTTR afin de limiter la durée (et les coûts) des inévitables interruptions de service.
Cela signifie que la visibilité est essentielle, et donc la supervision. Beaucoup, beaucoup de supervision. Mais pas seulement celle du site web, de l’application web ou de l’API : nous devons superviser l’ensemble de la pile technologique. Du réseau aux services applicatifs, jusqu’à l’application elle-même. Tout le monde ne le fait pas et, lorsque c’est le cas, cela semble être fait de manière irrégulière.
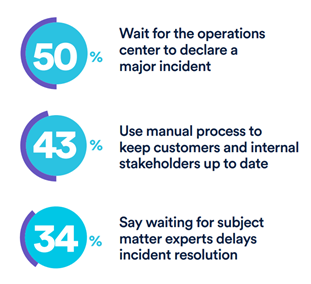
Prenons l’enquête de 2017 xMatters|Atlassian sur la maturité DevOpsdans laquelle 50 % des personnes interrogées ont déclaré « attendre que les équipes d’exploitation déclarent un incident majeur » avant de réagir. Fait inquiétant, un tiers des entreprises « apprennent l’existence d’interruptions de service par leurs clients ».
Dans une économie numérique, chaque seconde compte. Non seulement parce qu’elle coûte de l’argent, mais aussi parce qu’elle a un impact négatif sur les revenus futurs. La baisse de la valeur de la marque et de la confiance des clients entraîne une diminution des achats et du nombre d’utilisateurs, puis, à terme, une stagnation de la croissance. Ce n’est pas la voie que les organisations devraient suivre.
La surveillance est la première étape pour détecter les problèmes à l’origine des interruptions de service. Mais la surveillance seule ne permet pas de réduire le MTTR. La communication, si. Alerter au plus vite les parties prenantes concernées et leur fournir les informations nécessaires pour diagnostiquer le problème permet d’accélérer sa résolution. Cela signifie que le partage – l’un des quatre piliers fondamentaux du DevOps – est essentiel pour améliorer le MTTR. Même si votre entreprise n’a pas encore adopté les autres aspects du DevOps, vous devriez envisager de faire du partage une initiative hautement prioritaire. Que ce soit via ChatOps ou par e-mail, au moyen d’une application mobile ou d’une page wiki mise à jour dynamiquement, il est impératif que les informations recueillies grâce à la surveillance soient largement partagées au sein de l’organisation.
Un dysfonctionnement au niveau d’un commutateur ou d’un serveur peut sembler anodin, mais s’il n’est pas corrigé, il risque de finir par mettre hors service la moitié des services dont dépend une application critique. Dans l’étude 2017 sur l’état du réseau menée par Viavi, 65 % des administrateurs réseau et système citent « déterminer si le problème provient du réseau, du système ou des applications » comme leur principale difficulté lorsqu’ils cherchent à résoudre des problèmes applicatifs. Une meilleure visibilité et une supervision de l’ensemble de la pile permettent notamment de relever ce défi, en veillant à ce que les personnes chargées d’identifier la cause première disposent d’un maximum d’informations sur l’état et le bon fonctionnement de tous les composants du chemin de données.
La visibilité est essentielle à l’avenir de l’informatique. Sans elle, nous ne pouvons pas atteindre le niveau d’automatisation nécessaire pour remédier aux interruptions avant qu’elles ne surviennent. Sans visibilité, nous ne pouvons pas réduire significativement le MTTR. Sans elle, nous ne pouvons tout simplement pas assurer une croissance durable de l’entreprise.
La visibilité, tout comme la sécurité, doit occuper une place de premier plan dans l’ensemble des stratégies qui font progresser l’informatique. Car les pannes sont inévitables, et c’est la visibilité qui permet aux organisations de rétablir rapidement et efficacement leurs services, tout en limitant autant que possible les répercussions sur leur image de marque et leurs résultats financiers.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.