Les garde-fous intégrés aux modèles ne suffisent pas à garantir la sécurité des systèmes d’IA. C’est ce que notre équipe de recherche constate chaque mois lorsqu’elle teste des modèles de pointe (résultats publiés dans notre classement de la sécurité des IA). Bien que les garde-fous intégrés aux modèles soient utiles pour définir des limites comportementales, les attaquants ne relâchent pas leurs efforts. Face au déferlement constant d’injections de prompts, de tentatives de jailbreak et de nouveaux exploits, les organisations restent exposées aux fuites de données, aux manquements aux exigences de conformité et aux manipulations adverses que ces garde-fous n’ont pas été conçus pour empêcher. Pour sécuriser véritablement les applications et les agents d’IA, les organisations ont besoin de garde-fous à l’exécution qui assurent une protection en temps réel en détectant et en bloquant les menaces dès qu’elles surviennent.
Pourquoi les entreprises ne peuvent pas se fier uniquement aux Guardrails des modèles
Les garde-fous des modèles d’IA sont des outils préventifs, généralement intégrés à l’entraînement, à l’apprentissage par renforcement ou aux règles définies dans les prompts. Ils orientent le comportement attendu des systèmes d’IA, en encadrant ce que les modèles doivent ou ne doivent pas faire. Mais une fois qu’un modèle est déployé en production, son utilisation dans des conditions réelles en révèle les limites, notamment à travers des éléments tels que :
- Des attaquants qui conçoivent de nouveaux prompts et de nouvelles techniques d’exploitation pour contourner les restrictions imposées par les garde-fous
- Fuite d’informations sensibles, telles que des données à caractère personnel ou du code source, même lorsque les résultats semblent sûrs
- Adaptation lente, les garde-fous des modèles nécessitant souvent un nouvel entraînement ou une reconfiguration avant de pouvoir faire face à de nouvelles menaces
En d’autres termes, les garde-fous des modèles servent de guide, mais ne garantissent pas la sécurité.
Les Guardrails d’exécution détectent ce que les Guardrails de modèle ne voient pas
F5 AI Guardrails comble les lacunes laissées par les mécanismes de protection intégrés aux modèles. Fonctionnant lors de l’exécution, les mécanismes de protection à l’exécution analysent en temps réel les requêtes et les réponses, et bloquent ou signalent les interactions à risque avant qu’un problème ne survienne. Par exemple, les mécanismes de protection contre l’injection de requêtes et le contournement des restrictions peuvent détecter les requêtes manipulatrices visant à passer outre les politiques. De même, les mécanismes de prévention des pertes de données empêchent les données sensibles de quitter l’organisation.
Les garde-fous d’exécution peuvent fonctionner en mode blocage (pour empêcher les violations) ou en mode audit (pour consigner les événements à des fins de contrôle). Contrairement aux garde-fous intégrés aux modèles, ces garde-fous d’exécution sont continuellement mis à jour, afin que les défenses restent à la hauteur des attaques en constante évolution.
Pour faire simple, les garde-fous du modèle sont comme les clôtures qui délimitent les zones où les personnes peuvent circuler autour d’un bâtiment. Les garde-fous d’exécution sont les postes de contrôle de sécurité à l’entrée : ils inspectent tout ce qui franchit le seuil. Les premiers fixent les limites ; les seconds veillent à ce que rien de dangereux ne passe entre les mailles du filet.
Principales différences
Bien que les garde-fous à l’exécution et les garde-fous intégrés aux modèles contribuent tous deux à la sécurité de l’IA, leur fonctionnement diffère fondamentalement. Ce tableau présente leurs principales différences en un coup d’œil.
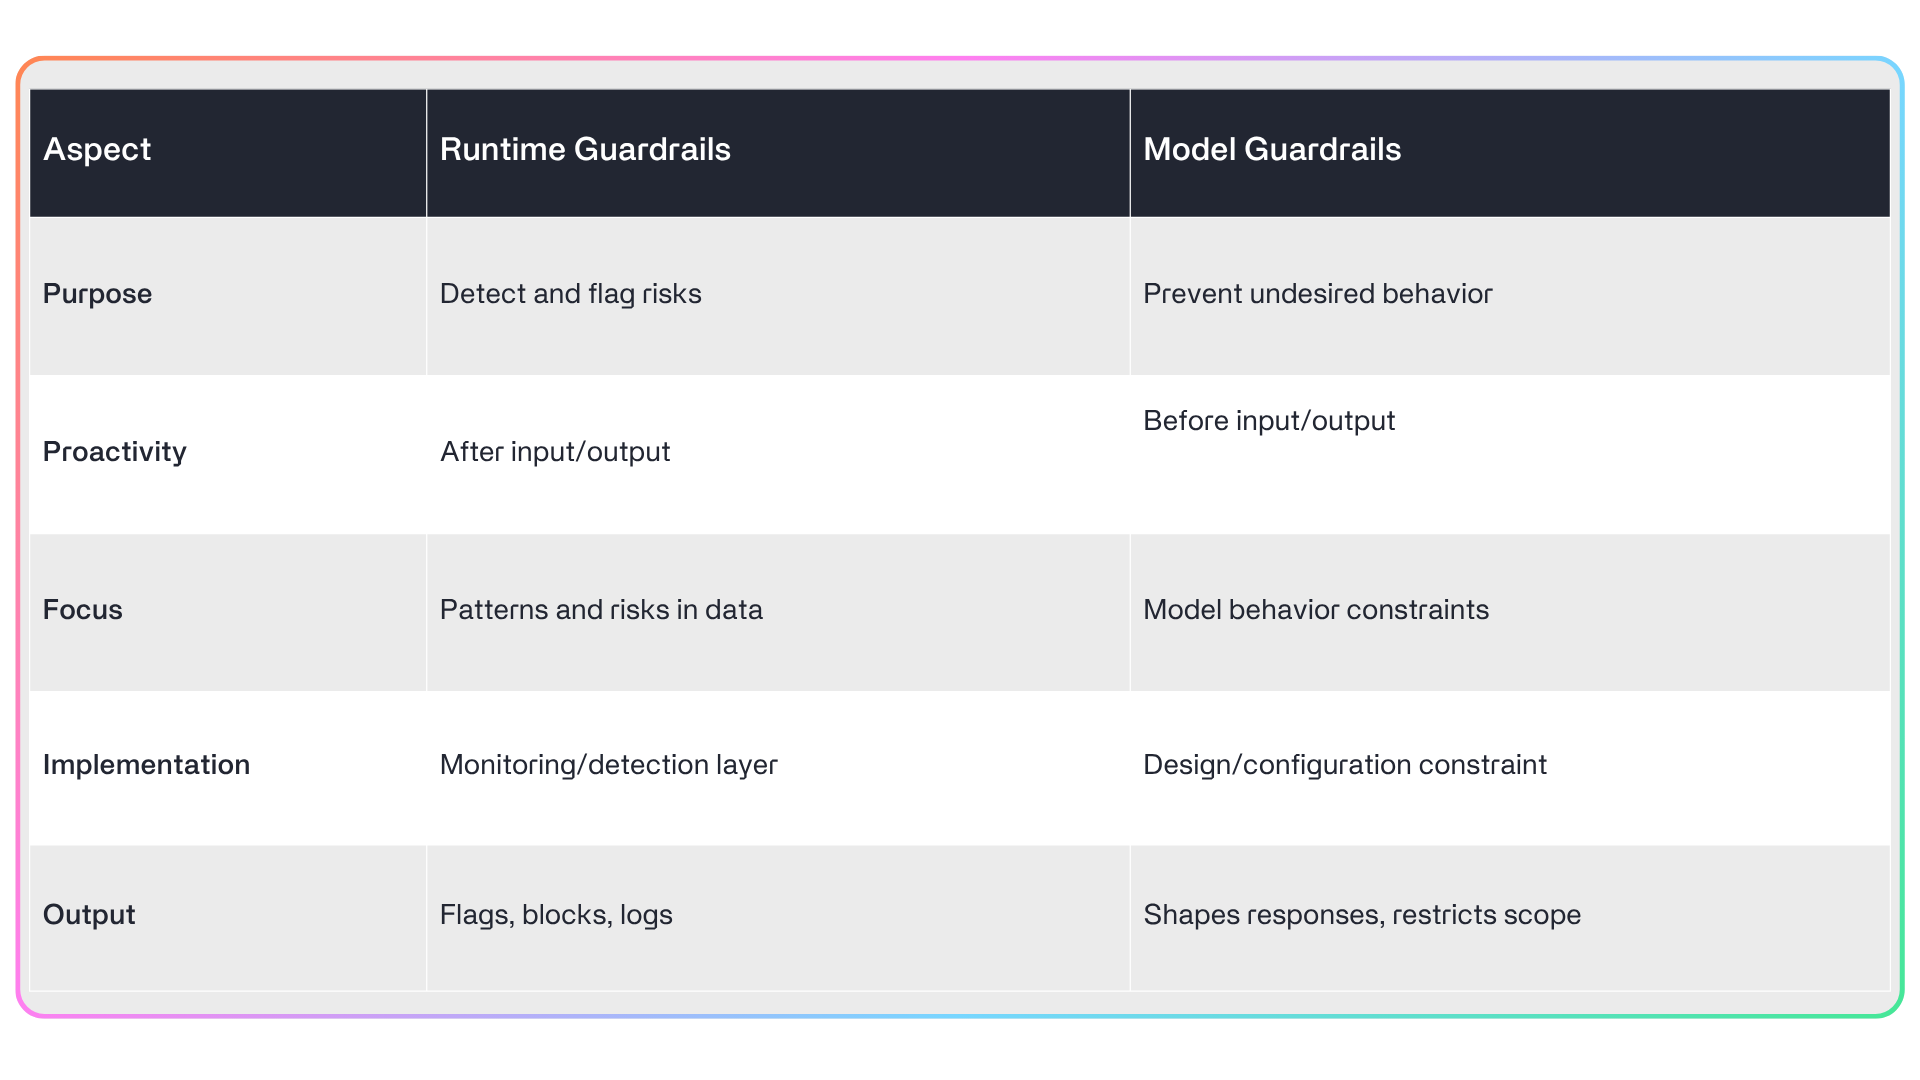
Ce contraste met une chose en évidence : les garde-fous du modèle permettent d’orienter l’IA, mais ce sont les garde-fous d’exécution qui garantissent véritablement sa sécurité en production.
Pourquoi les entreprises ont besoin de Guardrails d’exécution pour sécuriser l’IA
Si les garde-fous d’exécution offrent les couches de protection les plus robustes lors de l’inférence, leur véritable valeur se révèle lorsqu’ils sont associés aux garde-fous du modèle, les deux fonctionnant de concert pour créer une stratégie de défense en profondeur.
Les garde-fous du modèle définissent les limites de référence de son comportement. Les garde-fous à l’exécution étendent cette protection en détectant les nouvelles menaces et les tentatives de contournement que les garde-fous du modèle ne peuvent pas anticiper Par exemple, un garde-fou du modèle peut lui interdire de donner des conseils médicaux, tandis qu’un garde-fou à l’exécution détecte et bloque les tentatives visant à contourner cette règle au moyen de formulations indirectes ou de prompts manipulateurs.
Cette approche multicouche offre le niveau de sécurité le plus élevé pour l’IA, permettant aux entreprises d’innover en toute confiance tout en restant résilientes face à des risques en constante évolution.
À propos de l’auteur

Articles de blog associés

F5 rejoint le projet PQC du NIST pour contribuer à l’élaboration de normes résistantes aux attaques quantiques
En rejoignant le consortium du projet « Migration to PQC » du NIST, F5 contribue à élaborer des recommandations pratiques pour un monde résistant aux menaces quantiques.

La dernière version de F5 Distributed Cloud Bot Defense offre des fonctionnalités et des améliorations de nouvelle génération
Les mises à jour de la console de F5 Distributed Cloud Bot Defense améliorent la gestion des menaces automatisées et l’intégration dans des cadres de sécurité plus larges.

La nouvelle surface de risque liée à l’IA : invisible, autonome et déjà à l’intérieur
James White, vice-président de l’ingénierie chez F5 À mi-parcours de l’année 2025, le moment est bien choisi pour dresser un état des lieux de l’adoption de l’IA en entreprise et de la sécurité de l’IA. L’utilisation de l’IA générative est désormais la norme dans les entreprises De manière générale, les entreprises possèdent au moins une compréhension élémentaire de l’IA générative. Elles savent ce qu’elle est et où elle peut […]
Évaluation des LLM : renforcer la confiance grâce à la notation de sécurité
À mesure que l’adoption de l’IA s’accélère dans les entreprises, l’évaluation des LLM ne porte plus uniquement sur leurs performances, mais aussi sur la confiance qu’ils inspirent. Les équipes de sécurité doivent évaluer non seulement les performances d’un modèle, mais aussi la sûreté de son comportement. Pourtant, la plupart des cadres d’évaluation se concentrent sur des critères de précision, laissant les facteurs de sécurité et de risque dans le flou ou sans mesure.
Évaluer le niveau de préparation de votre organisation à la sécurité de l’IA
Dans un paysage de l’intelligence artificielle (IA) en constante évolution, il est non seulement important, mais impératif de savoir si votre organisation est prête à instaurer et à soutenir une culture de la sécurité de l’IA. À mesure que les technologies d’IA progressent, elles font émerger une multitude de nouveaux défis de sécurité qui, pour être gérés efficacement, exigent une approche réfléchie, globale et proactive […]
Déployer des LLM en entreprise : via une API dans un cloud privé
Pris isolément, sans mesures de protection spécialisées ni protocoles de sécurité en place, le déploiement de modèles d’IA générative (GenAI), en particulier de grands modèles de langage (LLM), à l’échelle de l’entreprise représente pour toute organisation une opportunité à haut risque, mais potentiellement très rentable. La manière précise dont votre organisation doit franchir ce grand pas dans l’univers de la GenAI nécessite une planification mûrement réfléchie. Peut-être serait-il […]