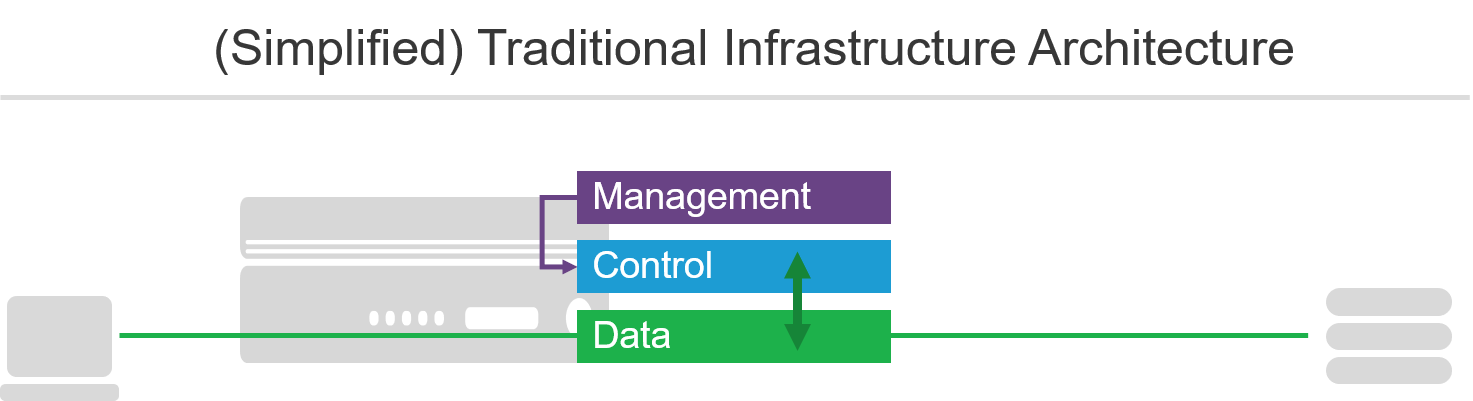
Dans une infrastructure réseau traditionnelle, on distingue généralement trois plans architecturaux : le plan de données, le plan de contrôle et le plan de gestion.
Les définitions exactes de ces plans peuvent varier selon le type et la mise en œuvre spécifique de l’infrastructure, mais ces archétypes s’appliquent globalement à la plupart des infrastructures réseau.
- Plan de données
- Parfois appelé « chemin de données » dans la terminologie moderne, le plan de données est le chemin par lequel transitent les paquets (données). Le plan de données est chargé d’accepter un paquet et de l’acheminer vers la bonne destination.
- Plan de contrôle
- En règle générale, le plan de contrôle détermine la destination des données. Les protocoles de routage sont de bons exemples de fonctions du plan de contrôle, tout comme les mécanismes de prise de décision de niveau supérieur, qui peuvent aujourd’hui être plus dynamiques. La mise en œuvre précise varie : le plan de données peut transmettre les données au plan de contrôle afin qu’il prenne une décision, ou le plan de contrôle peut observer les données de manière transparente et agir en fonction de déclencheurs spécifiques. Les plans de contrôle sont aussi souvent chargés de surveiller l’état des équipements et de recueillir des statistiques.
- Plan de gestion
- Le plan de gestion est le plus visible des trois plans, car c’est par son intermédiaire que nous interagissons avec le plan de contrôle. Les plans de gestion traditionnels utilisent des CLI (interfaces de ligne de commande), tandis que les plans de gestion modernes privilégient les API (interfaces de programmation d’applications). Quelle que soit la méthode utilisée, le plan de gestion permet aux opérateurs de définir des politiques appliquées par le plan de contrôle. Cela inclut des options de configuration telles que les algorithmes d’équilibrage de charge et les politiques d’autorisation ou de refus fondées sur des caractéristiques comme l’adresse IP et le type d’appareil.
Mais un autre type d’orchestration est à l’œuvre en coulisses, en grande partie à l’insu des opérateurs. Il n’a rien à voir avec la gestion, si ce n’est qu’il reprend à son compte certaines responsabilités jusque-là assumées par des opérateurs humains.
La différence ici tient au fait que les actions sont déclenchées automatiquement par des changements apportés à l’environnement en cours d’exécution, plutôt que lors d’un déploiement. Mais il est essentiel de savoir ce qui a changé, ce qui signifie que ces informations doivent être obtenues quelque part.
Dans un modèle d’exploitation traditionnel, ces informations proviennent généralement de tickets ou de demandes de changement. Dans le cas des modèles d’exploitation modernes et, plus particulièrement, des conteneurs, elles proviennent des registres de services par l’intermédiaire d’un mécanisme de découverte.
Registres de services et découverte
La nature des environnements de conteneurs repose notamment sur l’hypothèse que les adresses IP n’ont, en pratique, aucune importance pour l’environnement applicatif. Elles en ont toutefois pour l’infrastructure, car les données doivent toujours être acheminées et transférées d’un appareil à l’autre afin de parcourir le chemin entre le client et l’application. Dans les environnements modernes, ces adresses IP n’existent souvent que pendant de courtes périodes (la durée de vie d’un conteneur ou d’un service).
Examinons ces conclusions de DataDog (c’est nous qui soulignons) :
L’adoption rapide des orchestrateurs (voir le fait n° 4) semble réduire encore davantage la durée de vie des conteneurs, car leur démarrage et leur arrêt automatisés entraînent un taux de renouvellement plus élevé. Dans les organisations qui utilisent un orchestrateur, la durée de vie habituelle d’un conteneur est d’environ 12 heures. Dans les organisations sans orchestration, un conteneur vit en moyenne six jours.
Source : <https://www.datadoghq.com/docker-adoption>
Imaginez qu’en tant qu’opérateur, vous deviez mettre à jour les tables de routage ou les groupes d’équilibrage de charge tous les six jours, voire toutes les douze heures. Vous ne feriez pratiquement rien d’autre. Le risque d’erreur de configuration serait considérable et augmenterait probablement à mesure que vous seriez contraint de gérer manuellement les changements au sein d’un cluster de conteneurs.
Un registre de services, tel que Consul, devient un composant essentiel de votre déploiement de conteneurs. Les registres de services assurent le suivi des instances et des services, ainsi que de leurs adresses IP associées. À cet égard, ils peuvent être comparés à un « DNS pour les conteneurs et les services ».
Ainsi, le registre de services suit les caractéristiques actuelles des conteneurs du cluster. La découverte consiste à se connecter au registre de services (via une API ou en s’abonnant à une file d’attente de messages) afin d’associer les instances aux adresses IP.
Cela signifie que toute infrastructure devant acheminer du trafic vers un service ou une instance spécifique au sein d’un cluster de conteneurs doit être en mesure de récupérer une adresse IP. En effet, même si les conteneurs masquent le réseau à l’application, ils en dépendent toujours pour transférer les données d’un endroit à un autre.
Le quatrième plan : l’orchestration
Cela introduit dans l’infrastructure une nouvelle couche architecturale qui interagit avec les environnements d’orchestration de conteneurs. Cette couche — la couche d’orchestration — s’intègre à l’environnement de conteneurs et exploite des fonctionnalités telles que la découverte de services afin d’automatiser la détection des services et des instances. Ainsi, un répartiteur de charge peut découvrir automatiquement les membres d’un pool et le mettre à jour en continu en fonction des changements dans l’environnement. Cela évite aux équipes d’exploitation d’avoir à mettre à jour manuellement les pools de répartition de charge, une tâche de plus en plus fastidieuse lorsque la durée de vie moyenne des conteneurs est inférieure à une semaine.
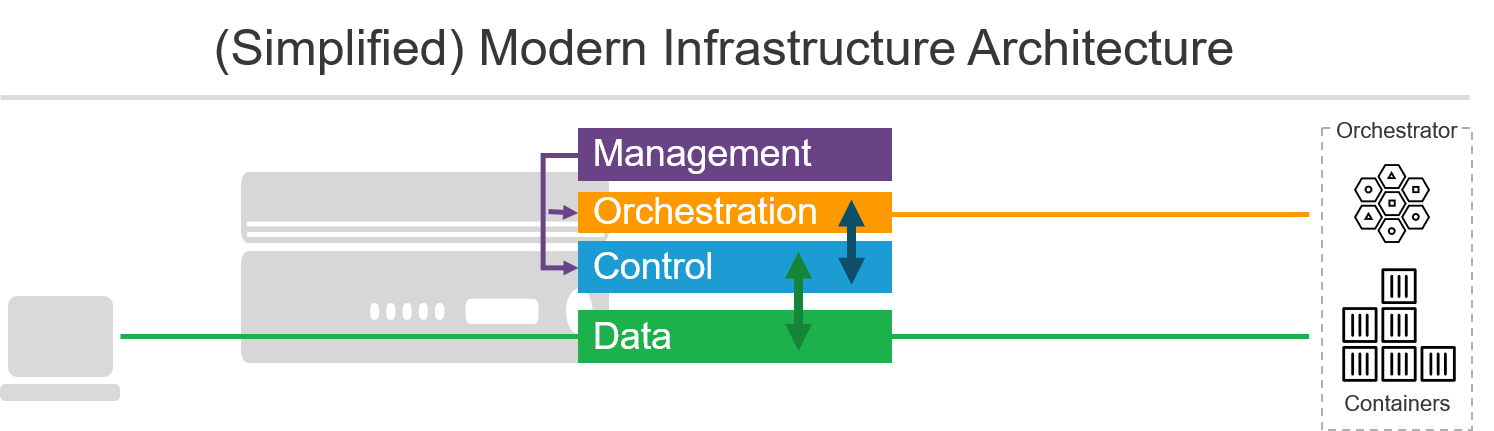
Ce plan n’est pas destiné aux interactions avec les opérateurs. La configuration, la surveillance et l’exploitation s’effectuent toujours par l’intermédiaire d’un plan de gestion. L’emplacement d’un registre de services serait configuré via le plan de gestion, mais utilisé par le plan d’orchestration pour se connecter au plan de contrôle et lui communiquer les modifications.
Nous pouvons définir le « plan d’orchestration » comme suit.
- Le plan d’orchestration est l’un des plans les moins visibles de l’architecture d’infrastructure. Les interactions avec celui-ci s’effectuent par l’intermédiaire du plan de gestion, dont le rôle principal est d’orienter le plan d’orchestration vers le registre de services approprié. Il lui incombe de mettre à jour les composants dynamiques du plan de contrôle afin de garantir le bon acheminement et la disponibilité des ressources conteneurisées.
La question reste de savoir si ce plan doit être intégré à l’appareil aux côtés des plans de contrôle et de données, ou s’il ne constitue qu’une surcouche du plan de gestion (ce qui modifierait légèrement notre schéma, sans toutefois avoir d’incidence sur les interactions entre les plans et les composants). De nombreux appareils traditionnels prennent déjà en charge ce plan émergent grâce à des extensions qui s’intègrent aux environnements de conteneurs et apportent des modifications par l’intermédiaire du plan de gestion. Il s’agit d’un bon exemple de remaniement des architectures traditionnelles visant à étendre leurs fonctionnalités aux environnements modernes. Mais, en définitive, ce n’est peut-être pas la solution idéale.
Pourquoi est-ce important ?
À première vue, l’introduction d’un quatrième plan pour l’infrastructure peut sembler sans importance. Après tout, son rôle est de décharger les opérateurs d’une partie des tâches fastidieuses qui leur incombent. Cela ne peut pas être une mauvaise chose.
Ce n’est pas une mauvaise chose, mais il est important de comprendre que ce passage d’une configuration statique à une configuration dynamique a des conséquences sur certaines des fonctions les plus importantes du plan de contrôle. La découverte de services devient si critique que sa disponibilité et sa sécurité doivent être une priorité absolue. Elle devient, de fait, le point de défaillance unique sur lequel repose toute l’infrastructure de votre application.
Les registres de services reposent sur les mêmes principes que la plupart des applications modernes : ils sont conçus pour résister aux défaillances. Il peut arriver que l’adresse IP que vous venez de découvrir disparaisse avant même que vous puissiez acheminer le trafic vers l’instance correspondante. La plupart des infrastructures sont alors capables de relancer la transmission, mais ce processus prend du temps. Dans l’économie numérique, chaque microseconde compte. Les paramètres traditionnels, tels que les délais d’expiration et les intervalles de découverte, ont donc une incidence sur les architectures modernes qui reposent sur la découverte de services. La supervision devient elle aussi bien plus critique, car la capacité à déterminer aussi rapidement que possible l’état de santé et la disponibilité d’un service peut faire toute la différence entre un utilisateur satisfait et un utilisateur qui se désengage. Ces deux aspects constituent des enjeux métier dont chacun, au sein d’une organisation moderne, doit avoir conscience et qu’il convient d’intégrer à ses propres indicateurs et objectifs.
La mise en œuvre du plan d’orchestration dans votre infrastructure, ainsi que le choix du registre de services, deviennent des facteurs importants dans votre processus de décision quant à la technologie à utiliser. Étudiez soigneusement vos options, car elles ont une incidence à la fois sur la disponibilité et sur les performances des applications fournies au moyen d’architectures basées sur des conteneurs.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.