L’automatisation des réseaux est-elle vraiment une question de tout ou rien ?
L’automatisation des réseaux – qui consiste à appliquer les pratiques DevOps au pipeline de production – est déjà utilisée par une part importante des organisations. Si très peu l’ont pleinement adoptée, la majorité (77 % selon notre dernier rapport « État des lieux de la livraison des applications ») la testent ou l’utilisent partiellement en production.
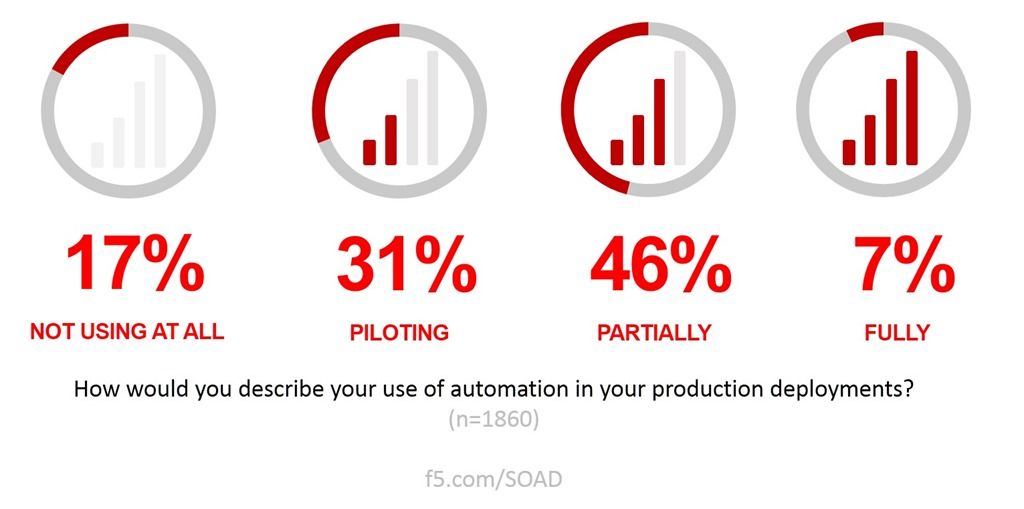
L’un des concepts étroitement liés au DevOps – et donc souvent associé au NetOps – est celui du produit minimum viable (MVP).
Cela fait partie de la méthodologie Agile et permet d’accélérer les cycles de développement afin de commercialiser plus rapidement les solutions. C’est précisément ce dont nous avons cruellement besoin dans « le réseau ». Vous vous souvenez peut-être de l’enquête Appian mentionnée dans un précédent article de blog qui nous a confrontés à un constat sans appel : 72 % des personnes interrogées ne pensaient pas que l’informatique était capable de monter en charge pour répondre aux besoins de l’entreprise.
Aïe. Malgré un recours assez généralisé à l’automatisation dans l’informatique, les développeurs et les parties prenantes métier doutent encore de notre capacité à mener les choses à bien.
Adopter les outils, les technologies et les méthodologies du DevOps pour accélérer les choses (en faisant évoluer les capacités plus intelligemment) n’a donc rien de si insensé. Mais avant de déterminer comment appliquer le MVP au réseau, il faut comprendre de quoi il s’agit. Pour celles et ceux qui ne connaissent pas le DevOps, l’Agile ou le MVP, voici une définition simple proposée par l’Agile Alliance :
Un produit minimum viable (MVP) est un concept issu du Lean Startup qui souligne l’importance de l’apprentissage dans le développement de nouveaux produits. Eric Ries a défini un MVP comme la version d’un nouveau produit qui permet à une équipe de recueillir un maximum d’enseignements validés sur les clients avec un minimum d’efforts. Cet apprentissage validé consiste à déterminer si vos clients achèteront réellement votre produit.
L’un des principes fondamentaux du concept de MVP consiste à créer un produit réel (qui peut se limiter à une page de destination ou à un service en apparence automatisé, mais dont le fonctionnement est en réalité entièrement manuel) afin de le proposer aux clients et d’observer leur comportement réel vis-à-vis du produit ou du service. Observer ce que les gens font réellement avec un produit est bien plus fiable que de leur demander ce qu’ils feraient.
Une équipe utilise efficacement le MVP comme élément central d’une stratégie d’expérimentation. Elle émet l’hypothèse que ses clients ont un besoin et que le produit sur lequel elle travaille répond à ce besoin. L’équipe propose alors quelque chose à ces clients afin de déterminer s’ils utiliseront effectivement le produit pour répondre à leurs besoins. En fonction des informations recueillies au cours de cette expérience, l’équipe poursuit, modifie ou abandonne le développement du produit.
C’est à ce stade de cet exposé que je tiens à souligner que bon nombre des concepts associés au DevOps (ainsi qu’aux technologies et méthodologies connexes) ne sont pas toujours aisément transposables à une initiative NetOps. L’expérimentation n’est pas un terme que les ingénieurs, les architectes ou les dirigeants informatiques emploient lorsqu’ils envisagent d’apporter des modifications au réseau.
Le rayon d’impact, voyez-vous. Il est vaste et difficile à maîtriser. La plupart des organisations ont, à juste titre, une faible tolérance au risque opérationnel. Les interruptions de service coûtent réellement de l’argent — et parfois des emplois. Le réseau n’est vraiment pas un terrain propice à l’expérimentation.
Mais cela ne signifie pas qu’il n’existe pas de déploiement minimal viable (MVD) pour le NetOps.
Définir un MVD pour le NetOps
Aujourd’hui, le pipeline de production comprend à la fois des ressources partagées telles que les commutateurs, les routeurs, le DNS et le routage multicloud (GSLB), ainsi que des services applicatifs propres à chaque application, comme les répartiteurs de charge, les pare-feu applicatifs web (WAF) et le contrôle d’accès aux applications.
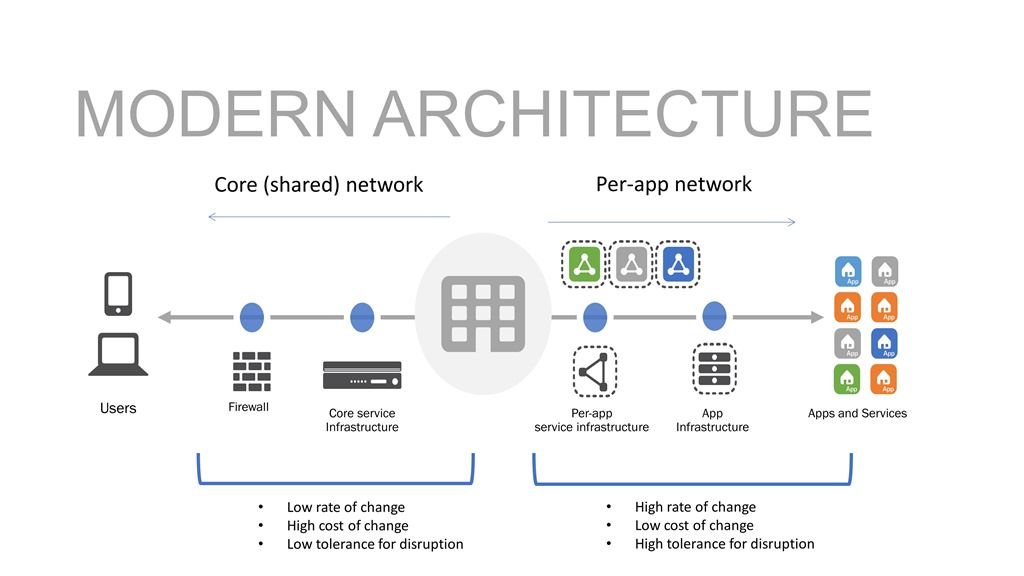
Fait intéressant, si l’on examine le rythme d’évolution des ressources partagées, on constate qu’il est relativement faible. Autrement dit, ces ressources évoluent peu. C’est une bonne chose, car elles tolèrent également mal les perturbations. En revanche, les ressources propres à chaque application évoluent plus rapidement et tolèrent mieux les perturbations.
C’est d’ailleurs l’un des avantages d’une architecture par application : l’isolation du chemin de données protège les autres applications des perturbations en cas de problème.
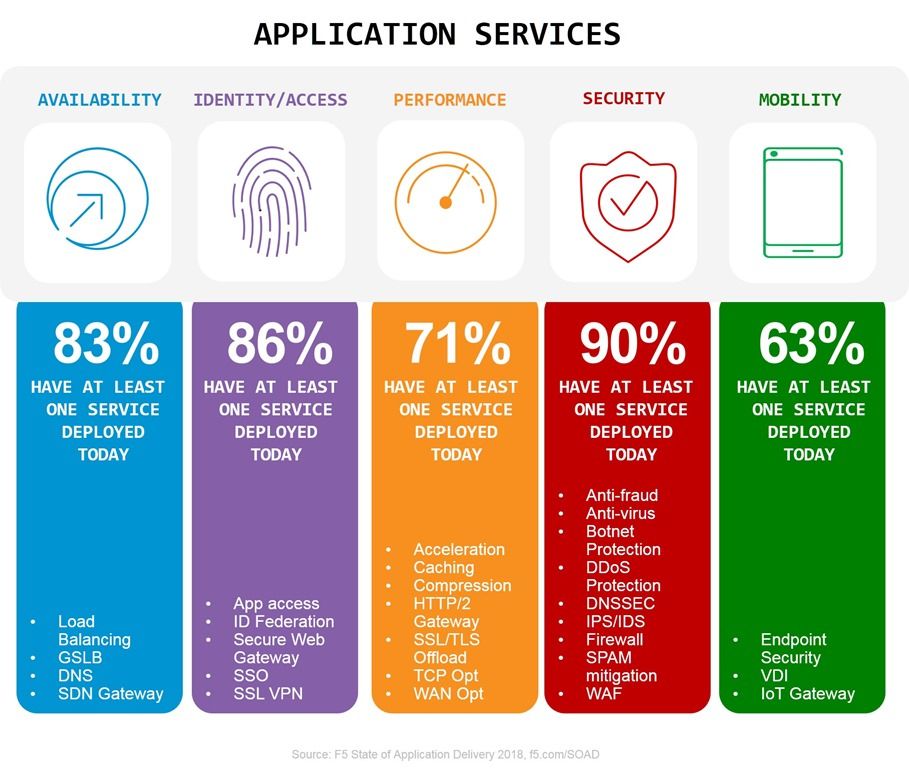
Le long de ce chemin de données se trouvent en moyenne seize services applicatifs différents qui, selon nos recherches, sont utilisés par les organisations pour fournir et sécuriser leurs applications. Certains d’entre eux, comme un pare-feu réseau et le DNS, sont des ressources partagées. D’autres ne le sont pas, ou du moins n’ont pas besoin de l’être. Ils sont peut-être aujourd’hui déployés sur une plateforme partagée, mais pourraient être intégrés à leur propre chemin de données si une bonne raison le justifiait.
C’est bien sûr ce que je vais vous proposer.
La bonne raison, c’est que vous pouvez développer efficacement un MVD pour une application si vous adoptez une architecture propre à chaque application pour les services applicatifs qui sont, dès le départ, étroitement couplés à l’application.
Comme nous l’indique notre définition d’un MVP, le « produit » (dans notre cas, le déploiement d’une application) n’a pas besoin d’être entièrement automatisé. Si nous partons du principe que les ressources les plus risquées et les moins tolérantes doivent continuer à être configurées (et vérifiées) manuellement, nous progressons malgré tout. Les pare-feu et les services essentiels tels que le DNS évoluent très peu ; nous pouvons donc supposer que les méthodes manuelles n’auront pas d’incidence notable sur le calendrier de déploiement. C’est d’autant plus vrai si nous automatisons la majeure partie des services applicatifs propres à chaque application, car nous libérons ainsi du temps pour permettre aux opérateurs et aux ingénieurs d’effectuer les modifications manuelles si nécessaire.
En supposant que le rapport entre les services de base (partagés) et les services applicatifs propres à chaque application soit d’environ un pour trois*, cela signifie qu’une organisation moyenne dispose d’au moins quatre ressources partagées à gérer manuellement et de douze ressources propres à chaque application à automatiser.
En examinant la longue liste des services applicatifs (nous suivons actuellement trente services distincts) nous constatons que certains sont indispensables pour fournir ou sécuriser une application (protection contre les attaques DDoS, WAF, équilibrage de charge pour la mise à l’échelle, accès aux applications), tandis que d’autres sont plutôt, disons, des améliorations. Il s’agit notamment de services applicatifs tels que les options d’accélération visant à améliorer les performances ou l’authentification unique (SSO) destinée à accroître la productivité.
Ainsi, si nous envisagions la mise en œuvre d’un MVD, nous pourrions adopter une approche Agile et nous concentrer sur les services applicatifs indispensables dès le premier jour pour assurer la mise à disposition et la sécurité. Cela ne signifie pas que nous négligeons les améliorations, mais simplement que nous allons d’abord nous concentrer sur les services critiques et automatiser ceux-ci en priorité. Nous pouvons toujours gérer manuellement les services qui améliorent la productivité ou les performances, mais, dans le cadre d’un MVD, nous voulons nous focaliser sur les services ayant une incidence sur les bénéfices.
Une approche MVD pour un réseau agile
Aborder l’automatisation dans l’objectif de définir et de livrer un MVD signifie que nous avançons plus rapidement (nous sommes plus agiles) et nous donne la possibilité de la faire évoluer afin de l’améliorer et de l’étendre à chaque sprint (mesuré en semaines, et non en trimestres), jusqu’à obtenir un produit robuste et pérenne (un déploiement automatisé).
L’adoption d’une stratégie d’automatisation fondée sur un MVD exige de s’engager non seulement en faveur d’une architecture, mais aussi d’une approche et d’un état d’esprit centrés sur les applications. En effet, ce type d’approche nécessite de comprendre l’application et ses besoins, tant sur le plan opérationnel que du point de vue métier. Le MVD d’une application peut différer de celui d’une autre. C’est l’une des raisons pour lesquelles l’architecture propre à chaque application joue un rôle si essentiel dans la transition d’un réseau fixe et manuel vers un pipeline agile (automatisé).
Il s’avère donc qu’il existe un déploiement minimal viable pour les NetOps. Cela signifie que vous pouvez adopter une approche Agile de l’automatisation du réseau, qui sera infiniment plus rapide (et plus sûre) si, dans le cadre de vos initiatives de réseau agile, vous passez à une architecture par application.
Automatisez (presque) tout ce qui concerne le réseau.
*Il s’agit clairement d’une estimation au doigt mouillé, fondée sur cette liste, mon expérience et mon avis (bien tranché). Votre expérience et votre définition peuvent varier.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.