Le poste d’ingénieur en fiabilité des sites (Site Reliability Engineer, SRE) est relativement récent. Généralement rattaché aux équipes d’ingénierie ou d’exploitation, il vise, comme son nom l’indique, à garantir la fiabilité des sites. Cela concerne généralement la disponibilité des applications, mais aussi leurs performances. C’est logique, puisque la plupart des utilisateurs finaux considèrent aujourd’hui qu’une application qui ne répond pas est indisponible.
En parcourant le rapport SRE 2018 de Catchpoint, j’ai été frappé par les graphiques comparant les indicateurs de niveau de service et les métriques SRE. En général, lorsque la « disponibilité » figure parmi les principaux indicateurs de niveau de service, le « temps de disponibilité » ou le « temps d’indisponibilité » apparaît également comme métrique. Ce n’est pas le cas pour les SRE interrogés dans cette enquête.
Lorsqu’on leur a demandé quels indicateurs de niveau de service étaient les plus importants pour leurs services, une écrasante majorité de 84 % a placé la « disponibilité pour l’utilisateur final » en tête. La latence arrivait en deuxième position avec 61 %, suivie de près par le taux d’erreur avec 60 %. Les performances — décrites dans le rapport comme le temps de réponse pour l’utilisateur final — ont recueilli le score impressionnant de 58 %.
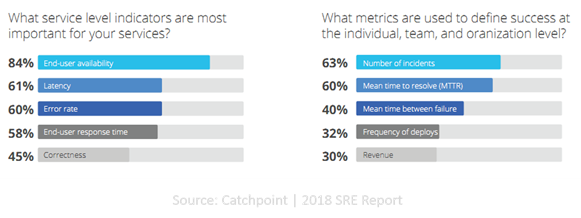
Examinons maintenant les indicateurs utilisés pour définir la réussite. Dans le monde de l’infrastructure et des opérations, nous sommes davantage habitués à des indicateurs tels que la « disponibilité » et à des expressions accrocheuses comme « cinq neuf ».
Les SRE ont plutôt tendance à mesurer la réussite en fonction du taux d’incidents et du MTTR. Sachant que ce même rapport indiquait que 41 % des SRE occupaient un poste d’« ingénieur DevOps » avant de devenir SRE, cela n’a rien de surprenant. Le DevOps lui-même s’intéresse davantage au MTTR qu’au calcul de la disponibilité, car il part du principe qu’il y aura des interruptions de service. L’essentiel est d’en réduire la durée en les résolvant rapidement, plutôt que de perdre du temps à essayer de les éviter à tout prix.
Toutefois, les lecteurs avisés remarqueront qu’en réduisant au minimum le MTTR, on réduit également au minimum les temps d’arrêt. Plus la résolution est rapide, plus les temps d’arrêt sont courts.
La différence subtile entre les deux tient au fait que les êtres humains ont tendance à optimiser ce sur quoi ils sont évalués. Si vous êtes évalué sur le nombre de lignes de code, vous allez en écrire beaucoup, qu’elles soient nécessaires ou non. Si vous êtes évalué sur les incidents de sécurité, vous allez tout verrouiller et crier NON à tout changement susceptible de favoriser une faille. Si vous évaluez les équipes sur la disponibilité, l’exploitation se concentrera sur le maintien des systèmes en fonctionnement et accessibles, mais pas sur la conception et l’instrumentation de systèmes et d’applications permettant de réduire le MTTR.
Il s’agit de l’un de ces aspects « culturels » du DevOps — un changement dans notre façon d’aborder les opérations — qui doit être transposé au NetOps. Si nous continuons à privilégier la disponibilité, nous passons à côté de l’occasion de mettre en place des mécanismes d’alerte et d’observabilité (comme la supervision et une journalisation robuste) qui réduisent le temps moyen de résolution et nous permettent d’atteindre notre objectif de réduction des temps d’arrêt.
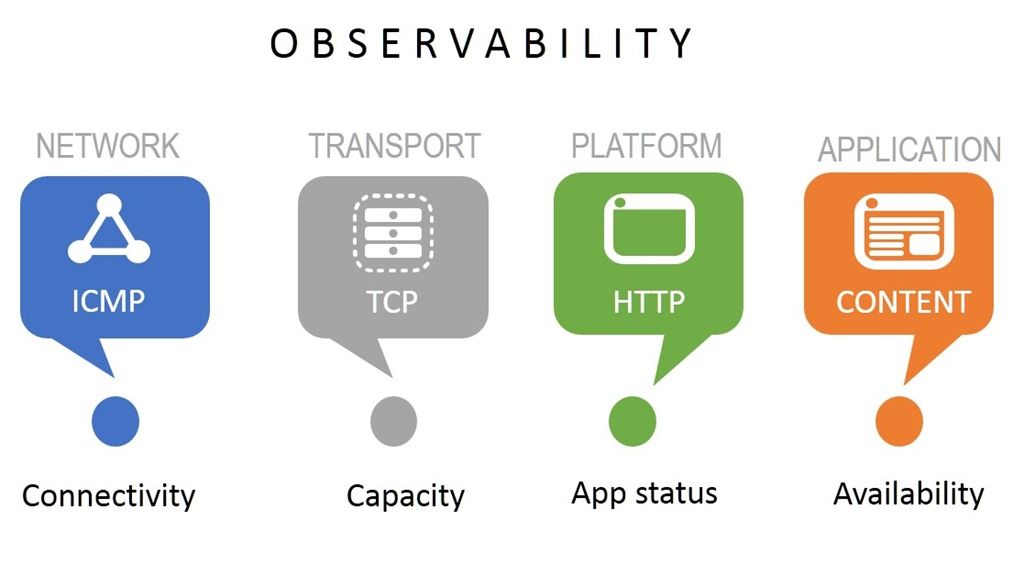
Éplucher les journaux – même centralisés – n’est pas un moyen efficace d’identifier la cause profonde d’un problème et de le résoudre. La surveillance en temps réel et la génération d’alertes sur les variables clés qui influent sur la disponibilité, telles que la capacité, la connectivité et les performances sur l’ensemble du chemin de données (réseau, infrastructure, application), réduiront invariablement le temps nécessaire à la résolution des problèmes si vous êtes informé de la dégradation ou de la défaillance soudaine de systèmes ou de services.
Les équipes NetOps doivent adopter cette approche en matière de fiabilité du pipeline de production, car elle permet globalement de mieux gérer les défaillances inévitables et elle s’inscrit dans la même logique que celle de leurs homologues DevOps. Après tout, ce n’est pas sans raison que nous n’avons visé que les cinq neuf, n’est-ce pas ? Parce que nous avons admis que les défaillances sont inévitables quels que soient nos efforts, et que la perfection est impossible.
Passer de la disponibilité/indisponibilité au MTTR comme indicateur de réussite favorise la collaboration entre les équipes et l’utilisation d’outils d’observabilité sur l’ensemble de la chaîne de production. Ce n’est pas un hasard si les outils de surveillance et d’alerte figuraient en tête de la liste des « outils indispensables » pour les SRE dans l’enquête. L’observabilité (dans le but de signaler les erreurs et incidents), associée à la collaboration, constitue une meilleure approche pour permettre à tous — NetOps, DevOps et développeurs d’applications — d’atteindre leur objectif : garantir des applications à la fois rapides et disponibles.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.