Depuis des années, la segmentation du réseau constitue la pierre angulaire de l’isolation des menaces, de la différenciation de la qualité de service, de la réponse aux incidents et de leur analyse, des audits de conformité, ainsi que de nombreuses autres fonctions essentielles d’interopérabilité. Pourtant, alors que nous vantons les principes du modèle Zero Trust et nous empressons de déployer l’IA, n’avons-nous pas négligé cet élément fondamental de l’infrastructure réseau, qui sert de socle à la cybersécurité moderne et à l’exploitation des services ?
Plus tôt dans notre série consacrée aux usines d’IA, nous avons défini une usine d’IA comme un investissement massif dans le stockage, les réseaux et les ressources de calcul, destiné à répondre aux besoins d’entraînement et d’inférence à grande échelle et à hautes performances. Pour rentabiliser cet investissement, les usines d’IA planifient de manière dynamique l’utilisation de précieux processeurs graphiques (GPU) et de ressources de calcul afin d’effectuer ces opérations d’entraînement et d’inférence. La planification des GPU nécessite de concevoir plusieurs « locataires » de services d’IA par cluster d’IA. Cela soulève un problème que de nombreuses équipes d’exploitation ne voient venir que lorsqu’il est souvent trop tard.
Aligner les ressources des clusters d’usines d’IA sur la segmentation du réseau
Au sein d’un cluster d’IA, nous pouvons segmenter logiquement les ressources selon un contexte de locataire, ce qui permet de définir des quotas par locataire, des limites de consommation des ressources, des règles de sécurité pour les systèmes hôtes et un contrôle des accès à l’administration fondé sur les rôles (RBAC). Toutefois, les contextes de locataire ne sont pas exposés par les services réseau de base qui assurent l’entrée et la sortie du trafic entre le cluster d’IA et le reste du réseau de l’usine d’IA. Sans ce contexte, la segmentation du réseau, pierre angulaire de la cybersécurité dans le centre de données, fonctionne à l’aveugle. Les méthodes habituelles permettant d’exposer les contextes de locataire nécessaires privent l’usine d’IA d’une part importante de ses précieuses ressources de calcul ou ralentissent les chemins réseau au point de ne plus respecter les exigences en matière de latence des services, de bande passante ou de simultanéité. Nous sommes ainsi confrontés à un faux dilemme entre l’utilisation efficace des précieuses ressources de l’usine d’IA et l’intégration adéquate des locataires au réseau.
Dans les infrastructures de cloud public, les architectures réseau multi-locataires orchestrées constituent le socle de tous les services d’une région cloud et sont mises en œuvre au moyen de clouds privés virtuels (VPC). Cette segmentation virtualisée du réseau est essentielle à la sécurité et à la mesure de l’utilisation des ressources. Les fournisseurs de cloud public assurent cette fonction grâce à des équipes de développeurs de logiciels réseau et à du matériel réseau spécialisé, notamment des SmartNIC et des unités de traitement de données (DPU). Les clusters d’usines d’IA dans les clouds publics sont conçus pour tirer parti de l’orchestration du réseau VPC de l’infrastructure sous-jacente. Le coût de maintenance des VPC est assez élevé, mais ceux-ci sont au cœur du modèle économique du cloud public.
La question se pose : comment une organisation peut-elle rentabiliser au maximum son investissement dans une usine d’IA et planifier dynamiquement l’utilisation des GPU et des ressources de calcul sans investir autant qu’un fournisseur de cloud public ?
La première étape du secteur dans cette démarche a consisté à recourir à la virtualisation des serveurs pour créer des machines virtuelles (VM). Les VM utilisent l’accès direct au matériel pour se connecter à des réseaux de centre de données segmentés. Il suffit de placer toutes les machines virtuelles sur les mêmes VLAN pour poursuivre les opérations normalement, si l’on ne s’intéresse qu’à un seul locataire au sein d’un même cluster d’IA.
Les machines virtuelles peuvent également répondre au besoin de segmentation des GPU, car les fournisseurs de GPU proposent des mécanismes permettant de subdiviser les périphériques GPU en ensembles de cœurs et de mémoire, puis de les attribuer à des machines virtuelles spécifiques. Toutefois, la segmentation des périphériques GPU n’est pas dynamique et nécessite le redémarrage de la machine virtuelle. En outre, cette architecture limite la possibilité de créer un pool de ressources GPU dont l’utilisation peut être mesurée pour plusieurs locataires. Ces inconvénients constituent des limites importantes de cette solution.
Aligner la segmentation du réseau sur les clusters d’usines d’IA mutualisés
Qu’advient-il de nos clusters d’usines d’IA lorsqu’ils ne peuvent plus être dédiés à un seul locataire ? Le problème se déplace vers le centre de données. Dans les clusters d’usines d’IA, par défaut, tout le trafic réseau sortant vers le centre de données fait l’objet d’une traduction d’adresse réseau source (SNAT) vers l’adresse IP du nœud du cluster sur lequel s’exécute la charge de travail conteneurisée à l’origine de la requête réseau, ce qui masque de fait la véritable source. Le trafic provient alors du segment réseau sur lequel ce nœud a été déployé. Dans un cluster mutualisé, cela signifie que nous perdons le contexte propre à chaque locataire et que nous obtenons un flux mêlé de trafic sortant provenant de plusieurs locataires, impossible à démêler, sécuriser, dépanner ou auditer.
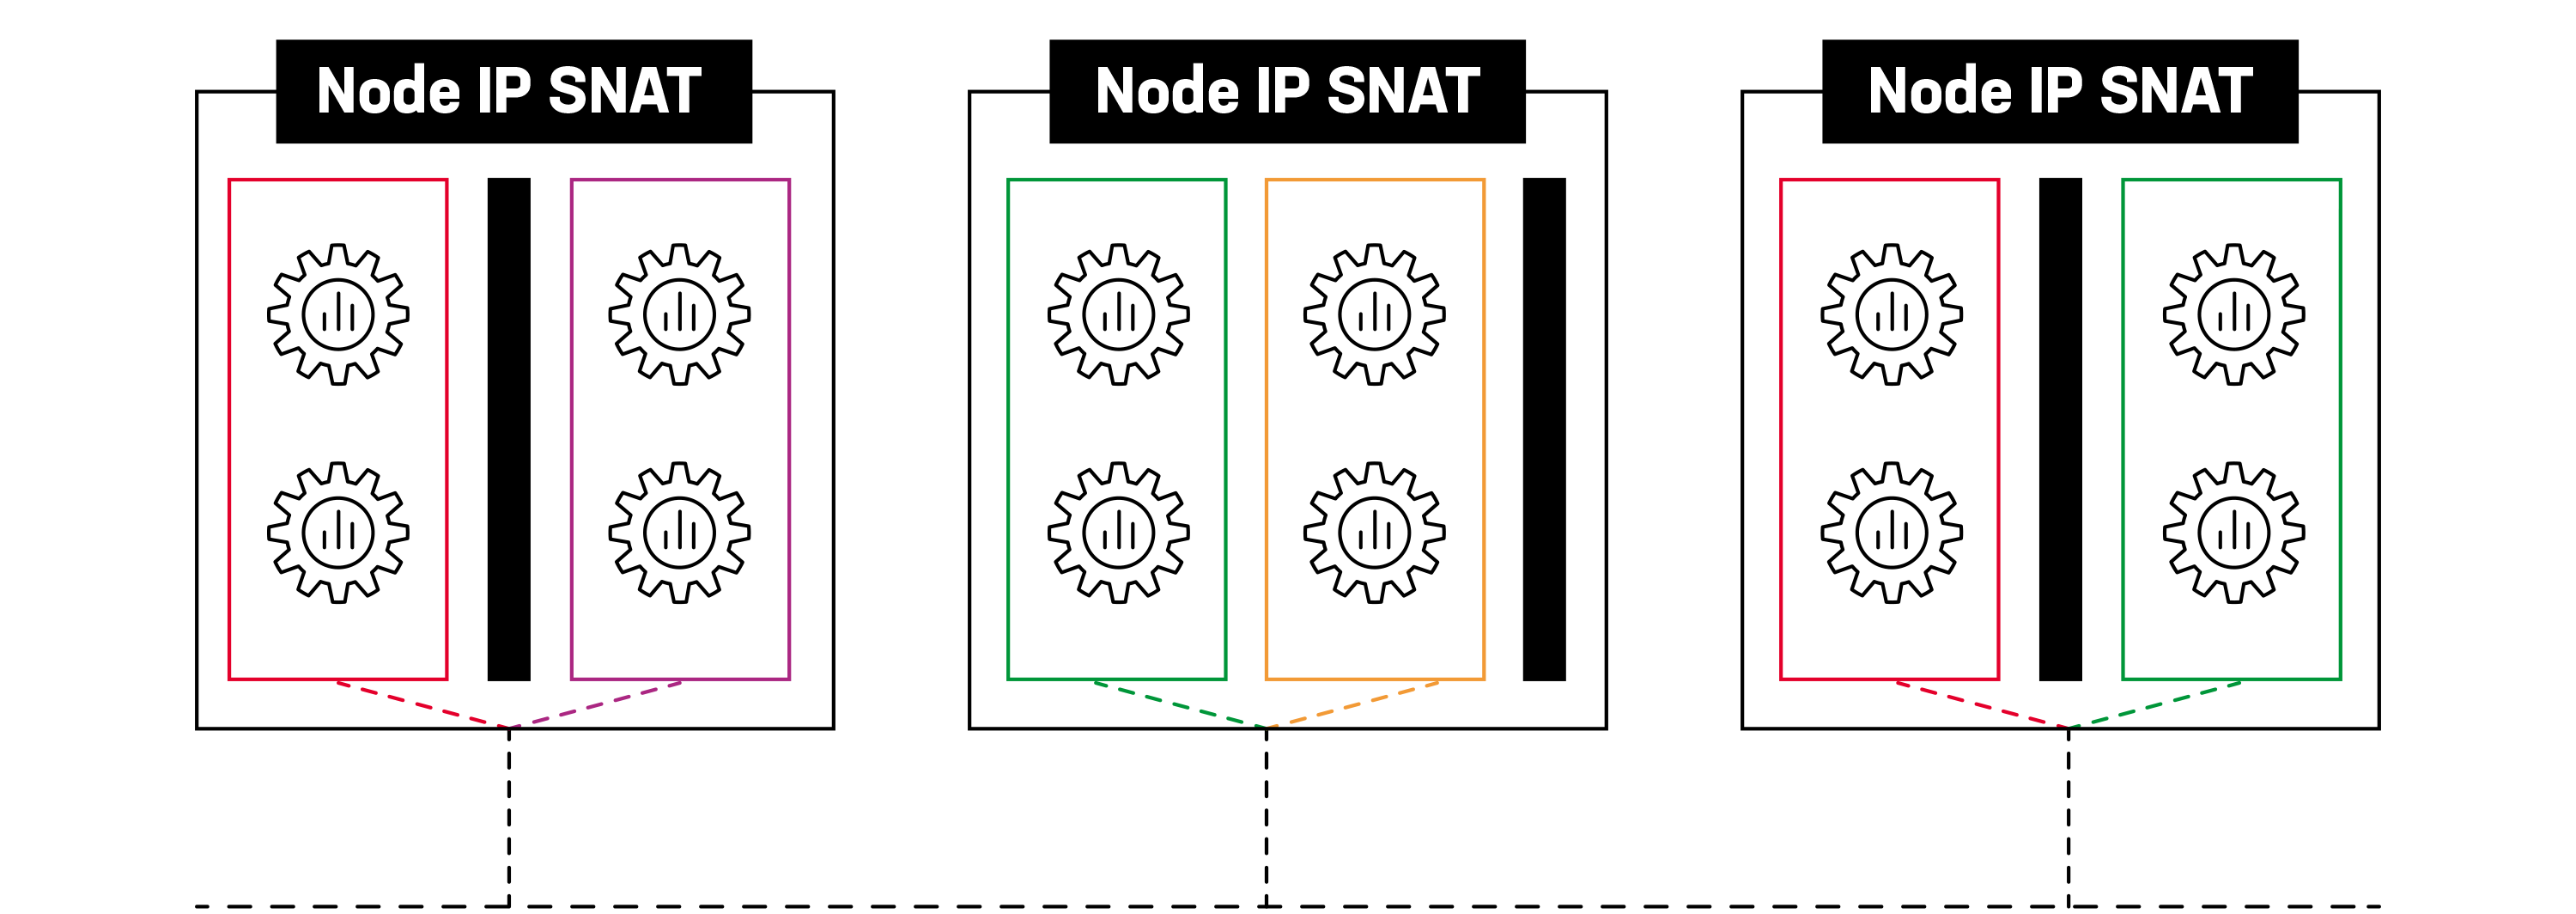
Par défaut, le contexte du locataire du cluster est perdu lors de la sortie.
Ce problème s’accentue lorsque le trafic entrant est également pris en compte. Bien que ce trafic puisse être plus facile à gérer puisqu’il provient d’un centre de données déjà segmenté, comment établir une corrélation entre le trafic entrant d’un locataire donné et son trafic sortant ? La réponse repose sur la génération augmentée par récupération (RAG) et sur les services agentiques, qui communiquent de manière intensive afin d’acquérir des données externes et d’utiliser des services externes. Cela nécessite une collaboration entre plusieurs équipes, les ingénieurs de plateforme et les équipes NetOps devant identifier un problème affectant un client ou tenter de réussir des audits de sécurité.
Les entreprises peuvent se demander : « Pourquoi ne pouvons-nous pas simplement utiliser une technologie de superposition de réseau défini par logiciel (SDN) et déployer des réseaux VPC comme le font les hyperscalers ? » C’est tout à fait possible, mais cela revient à transférer les coûts vers la maintenance de réseaux VPC SDN sur l’infrastructure existante du centre de données. Si une segmentation de couche 2 (par exemple, VxLAN) est souhaitée, la difficulté réside alors dans l’orchestration des tunnels avec les commutateurs en haut de baie et dans le provisionnement de ces commutateurs afin qu’ils correspondent à la segmentation du réseau. C’est pourquoi les hyperscalers ont opté pour les SmartNIC et adopté une orchestration d’hôte à hôte, laissant les réseaux des centres de données rapides, mais dépourvus d’intelligence.
La plupart des organisations ne disposent pas des compétences en programmation réseau nécessaires ni ne souhaitent prendre en charge une orchestration aussi complexe au niveau des hôtes, ou ne peuvent tout simplement pas renoncer à la visibilité sur le réseau fédérateur indispensable à la qualité de service. Les solutions de routage de couche 3 (par exemple, IP) proposées pour résoudre ces problèmes ont conduit les équipes réseau à faire de chaque nœud de cluster d’IA un pair de routage dynamique (BGP) du centre de données, avec plusieurs réflecteurs de routes tentant d’assurer une isolation élémentaire des sous-réseaux IP entre locataires. Cette approche expose elle aussi les opérateurs à des problèmes de routage et à des audits de sécurité très complexes, et a entraîné des pannes à l’échelle de régions entières.
Segmentation réseau orchestrée et adaptée aux clusters pour les usines d’IA
Les usines d’IA doivent prévoir une solution réseau riche en fonctionnalités, programmable, sécurisée et à faible latence, capable d’évoluer aussi bien en bande passante qu’en nombre de connexions simultanées. Les contextes des locataires de couche 2 (par exemple, VLAN, VxLAN) et de couche 3 (par exemple, sous-réseaux, interfaces IPsec) doivent être exposés depuis l’intérieur d’un cluster jusqu’au réseau de l’usine d’IA. Les métriques d’observabilité, les journaux et les outils de débogage doivent être accessibles aux équipes NetOps.
Traditionnellement, bon nombre de ces solutions de gestion des environnements applicatifs et de visibilité sont fournies par F5 BIG-IP. F5 BIG-IP Container Ingress Services (CIS) détecte dynamiquement les services Kubernetes et les expose aux centres de données sous forme de serveurs virtuels, un objet de configuration que les administrateurs BIG-IP connaissent bien puisqu’ils l’utilisent pour présenter des serveurs physiques et des machines virtuelles. Bien que BIG-IP réponde à une grande partie des exigences recherchées, il ne gère pas le trafic sortant du cluster d’IA vers le réseau de l’usine d’IA, ce qui est nécessaire pour maintenir la segmentation.
Pour résoudre ce problème, nous avons conçu F5 BIG-IP Next for Kubernetes, une solution destinée aux clusters de calcul mutualisés, reposant sur notre plateforme de nouvelle génération BIG-IP Next.
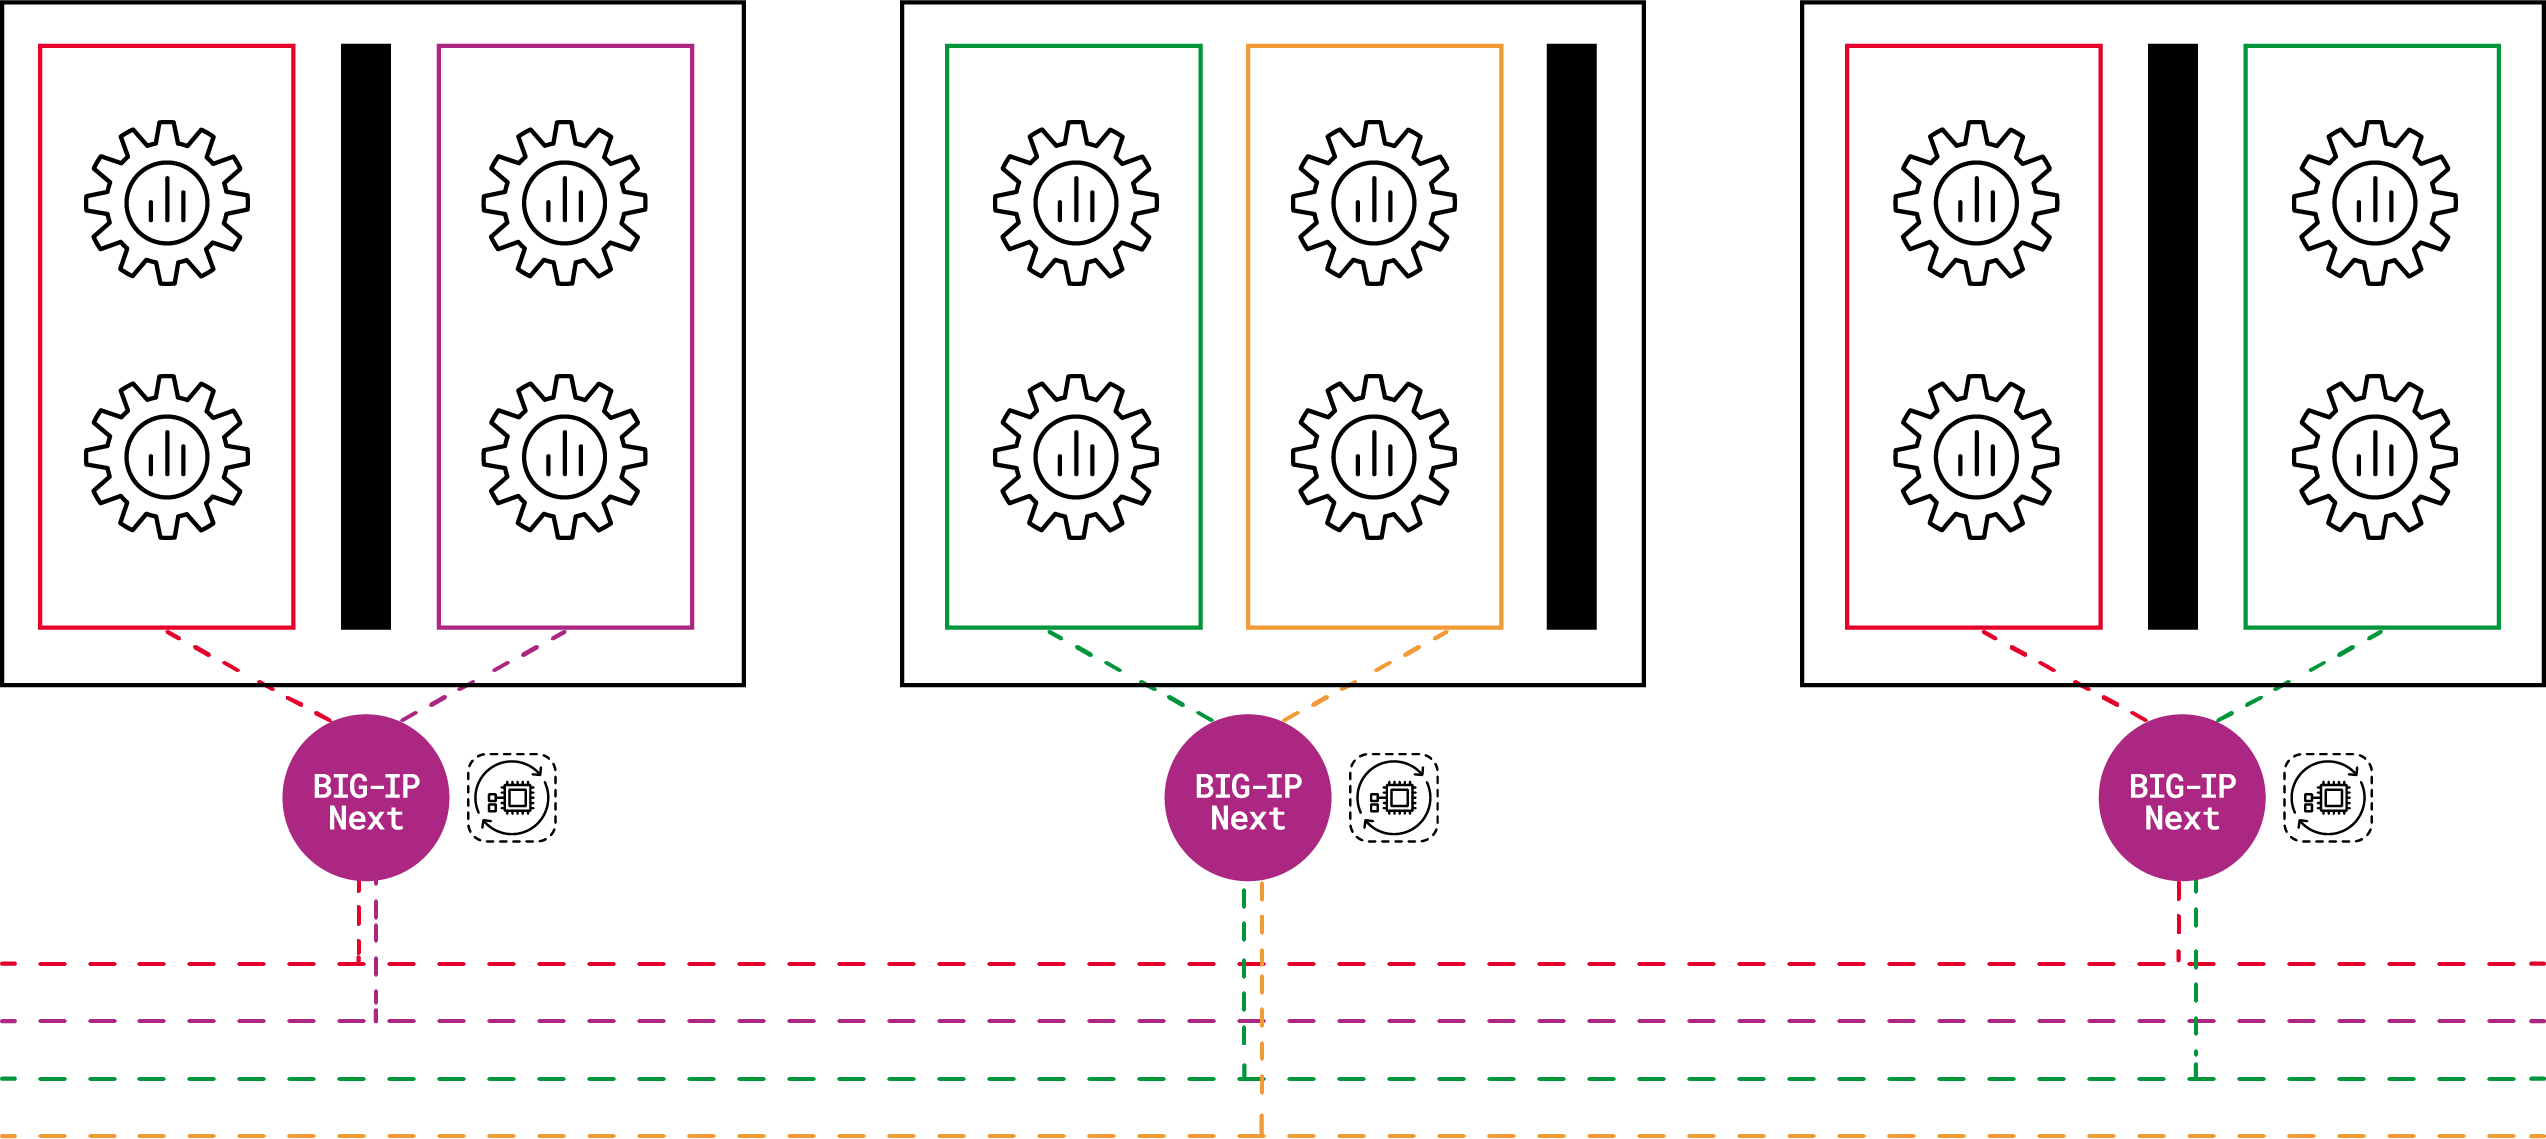
BIG-IP Next for Kubernetes permet aux équipes NetOps d’associer les locataires du cluster à des segments réseau.
BIG-IP Next for Kubernetes est entièrement géré via le plan de contrôle Kubernetes et prend en charge l’authentification de gestion Kubernetes ainsi que le contrôle d’accès basé sur les rôles (RBAC) pour toutes les ressources déclarées. Il reconnaît également les environnements mutualisés Kubernetes au moyen des espaces de noms afin d’assurer la segmentation réseau requise pour le trafic entrant comme sortant. Cette fonctionnalité est essentielle pour les architectures privilégiant l’orchestration, telles que les usines d’IA.
BIG-IP Next for Kubernetes permet aux équipes NetOps de déclarer simplement les correspondances entre les espaces de noms Kubernetes et les segments réseau. L’appairage dynamique des routes entre le réseau de l’usine d’IA et les instances BIG-IP Next s’appuie sur une syntaxe de configuration des routes bien connue. Les équipes NetOps disposent d’une capacité unique à diagnostiquer en toute sécurité les flux réseau en temps réel pour le trafic entrant et sortant du cluster. Les équipes SecOps bénéficient, pour chaque locataire du cluster, de listes de contrôle d’accès (ACL) de pare-feu pour le trafic entrant et sortant, ainsi que de fonctionnalités de protection contre les attaques par déni de service distribué (DDoS) et de prévention des intrusions (IPS).
Pour les équipes d’ingénierie de plateforme, BIG-IP Next for Kubernetes libère des ressources de calcul en déchargeant les fonctions réseau telles que le traitement du trafic de données entrant et sortant, ainsi que la traduction d’adresses réseau source (Source NAT) et le filtrage par pare-feu. Cela permet de réduire les coûts d’exploitation, tout en maintenant la disponibilité et l’efficacité des services.
BIG-IP Next for Kubernetes prend également en charge l’API Kubernetes Gateway, la première API d’entrée communautaire conçue pour des rôles organisationnels spécifiques dans les domaines NetOps, de l’ingénierie de plateforme, du DevOps et du MLOps. Grâce à l’API Gateway, BIG-IP Next for Kubernetes étend les services d’entrée classiques basés sur les ports de couche 4 ou sur les routes HTTP(S) de couche 7 à un ensemble destiné au DevOps/MLOps, à savoir TCPRoute, UDPRoute, HTTPRoute, TLSRoute et GRPCRoute, tous pilotés par la même automatisation CI/CD dans les principaux frameworks d’IA.
Du point de vue de la gestion, BIG-IP Next for Kubernetes permet aux équipes NetOps, SecOps, d’ingénierie de plateforme, DevOps et MLOps de collaborer efficacement grâce aux déclarations de l’API Kubernetes. Il offre tout ce que vous attendez de BIG-IP, mais dans l’environnement Kubernetes, tout en prenant en charge la segmentation du réseau.
L’essor du DPU
Les unités de traitement des données (DPU) connaissent un essor exponentiel au sein des usines d’IA. Comme indiqué dans un précédent article de blog de notre série consacrée aux usines d’IA, une DPU est un processeur programmable conçu pour prendre en charge le déplacement et le traitement de volumes considérables de données grâce à une accélération matérielle au débit maximal du réseau. Grâce aux innovations produits de F5 et à notre collaboration avec NVIDIA, nous avons lancé BIG-IP Next for Kubernetes afin de décharger les flux de données du trafic entrant et sortant, tout en prenant en charge la segmentation du réseau ainsi que les fonctions de sécurité, grâce à son déploiement sur les DPU NVIDIA BlueField-3 à l’aide des API DOCA de NVIDIA. Cette solution optimise l’investissement dans une usine d’IA en garantissant que les clusters d’IA sont correctement « alimentés en données ».
Usines d’IA optimisées par F5
Lorsqu’on investit dans des usines d’IA, il est impératif de s’assurer que l’infrastructure est optimisée, efficace et évolutive. F5 BIG-IP Next for Kubernetes, déployé sur des DPU NVIDIA BlueField-3, fournit la segmentation réseau nécessaire à l’allocation dynamique des GPU et des ressources de calcul, tout en offrant une évolutivité hautes performances afin de maximiser le retour sur investissement dans l’IA. Pour en savoir plus, contactez F5 afin d’échanger avec votre responsable de compte F5 et votre ingénieur ou architecte solutions.
Vous souhaitez en savoir plus sur les usines d’IA ? Découvrez d’autres articles de notre série consacrée aux usines d’IA :
- Qu’est-ce qu’une usine d’IA ? ›
- Génération augmentée par récupération (RAG) pour les usines d’IA ›
- Optimiser la gestion du trafic pour l’ingestion de données dans les usines d’IA ›
- Connecter de manière optimale les sources de données en périphérie aux usines d’IA ›
- L’évolutivité et la flexibilité multicloud au service des usines d’IA ›
- La puissance et l’importance du DPU NVIDIA BlueField pour les usines d’IA ›
- Protection des API pour les usines d’IA : la première étape vers la sécurité de l’IA ›
- Les usines d’IA produisent les applications les plus modernes qui soient : les applications d’IA ›
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.