Cet article de blog fait partie d’une série consacrée aux usines d’IA. Une fois votre lecture terminée, découvrez les autres articles de la série.
- Génération augmentée par récupération (RAG) pour les usines d’IA ›
- Optimisez la gestion du trafic pour l’ingestion de données dans les usines d’IA ›
- Connecter de manière optimale les sources de données en périphérie aux usines d’IA ›
- L’évolutivité et la flexibilité multicloud au service des usines d’IA ›
- La puissance et l’importance du DPU NVIDIA BlueField pour les usines d’IA ›
- Protection des API pour les usines d’IA : la première étape vers la sécurité de l’IA ›
- L’importance de la segmentation réseau pour les usines d’IA ›
- Les usines d’IA produisent les applications les plus modernes qui soient : les applications d’IA ›
Lorsque ChatGPT est sorti en novembre 2022, les questions que nous posions et les requêtes que nous saisissions étaient simples : « Raconte-moi une histoire sur X » et « Écris un récit mettant en scène une personne A et une personne B sur le sujet Z. » À travers ces questions et nos premières interactions avec GPT-3.5 à l’époque, nous cherchions à déterminer l’incidence que cette nouvelle technologie en plein essor aurait sur notre quotidien. Aujourd’hui, fin 2024, l’IA enrichit nos vies : elle nous aide notamment à déboguer et à écrire du code, à compiler et à synthétiser des données, ainsi qu’à nous déplacer à bord de véhicules autonomes. Ce sont là les produits d’une usine d’IA moderne, et nous n’en sommes qu’au début.
Cet article, le premier d’une série consacrée aux usines d’IA, présente les composants d’une usine d’IA et explique comment les différents éléments fonctionnent ensemble pour générer à grande échelle des solutions basées sur l’IA.
Définir les usines d’IA
Dans le contexte de l’évolution de l’IA, le concept d’usine d’IA s’est imposé comme une analogie illustrant la manière dont les modèles et services d’IA sont créés, perfectionnés et déployés. À l’image d’une usine traditionnelle qui transforme des matières premières en produits finis, une usine d’IA représente un investissement massif dans le stockage, les réseaux et la puissance de calcul afin de répondre à des besoins d’entraînement et d’inférence à grande échelle et hautes performances.
“Une usine d’IA représente un investissement massif dans le stockage, les réseaux et le calcul afin de répondre aux besoins d’entraînement et d’inférence à grande échelle et à hautes performances.”
Au sein de ces usines, des réseaux de serveurs, de processeurs graphiques (GPU), d’unités de traitement de données (DPU) et de matériels spécialisés fonctionnent de concert pour traiter d’immenses volumes de données et exécuter des algorithmes complexes qui entraînent les modèles d’IA afin d’atteindre des niveaux élevés de précision et d’efficacité. Ces infrastructures sont méticuleusement conçues pour fournir la puissance de calcul considérable nécessaire à l’entraînement de modèles à grande échelle et à leur déploiement pour l’inférence en temps réel. Elles intègrent des solutions de stockage avancées permettant de gérer et de récupérer d’immenses jeux de données, tout en garantissant une circulation fluide des données.
L’équilibrage de charge et l’optimisation du réseau maximisent les performances et l’utilisation des ressources, évitant ainsi les goulets d’étranglement et garantissant l’évolutivité. Cette orchestration des composants matériels et logiciels permet aux usines d’IA de produire des modèles d’IA de pointe et de les perfectionner en continu, en les adaptant aux nouvelles données et à l’évolution des besoins. En définitive, une usine d’IA incarne l’industrialisation du développement de l’IA en fournissant l’infrastructure robuste nécessaire à la prochaine génération d’applications intelligentes.
Pourquoi les usines d’IA sont-elles importantes ?
Comme l’a déclaré Jensen Huang, PDG de NVIDIA, lors de l’événement Dreamforce 2024 de Salesforce : « Jamais dans l’histoire la technologie informatique n’a progressé plus vite que ne le prédit la loi de Moore », avant d’ajouter : « Nous progressons bien plus vite que la loi de Moore, au point qu’on pourrait aisément parler d’une loi de Moore au carré. »
Le déploiement de l’IA à grande échelle devient de plus en plus indispensable, car les investissements dans l’IA constituent des facteurs clés de différenciation sur le marché et d’efficacité opérationnelle. Pour y parvenir, les organisations doivent continuellement développer et affiner leurs modèles, tout en intégrant des référentiels de connaissances et des données en temps réel. Le concept d’usine d’IA souligne que l’IA doit faire l’objet d’un investissement continu plutôt que d’un effort ponctuel. Il fournit aux organisations un cadre leur permettant d’industrialiser leurs initiatives en matière d’IA et de mieux les adapter à l’évolution des besoins de l’entreprise et du marché.
Composants d’une usine d’IA
S’appuyant sur son expertise dans l’accompagnement des clients pour le déploiement à grande échelle de parcs d’applications modernes, performants et sécurisés, F5 a développé un cadre d’architecture de référence pour l’IA. Les applications d’IA étant les plus modernes qui soient, fortement interconnectées via des API et largement distribuées, ce cadre répond aux enjeux critiques de performances, de sécurité et d’exploitation indispensables à la mise à disposition d’applications d’IA de pointe.
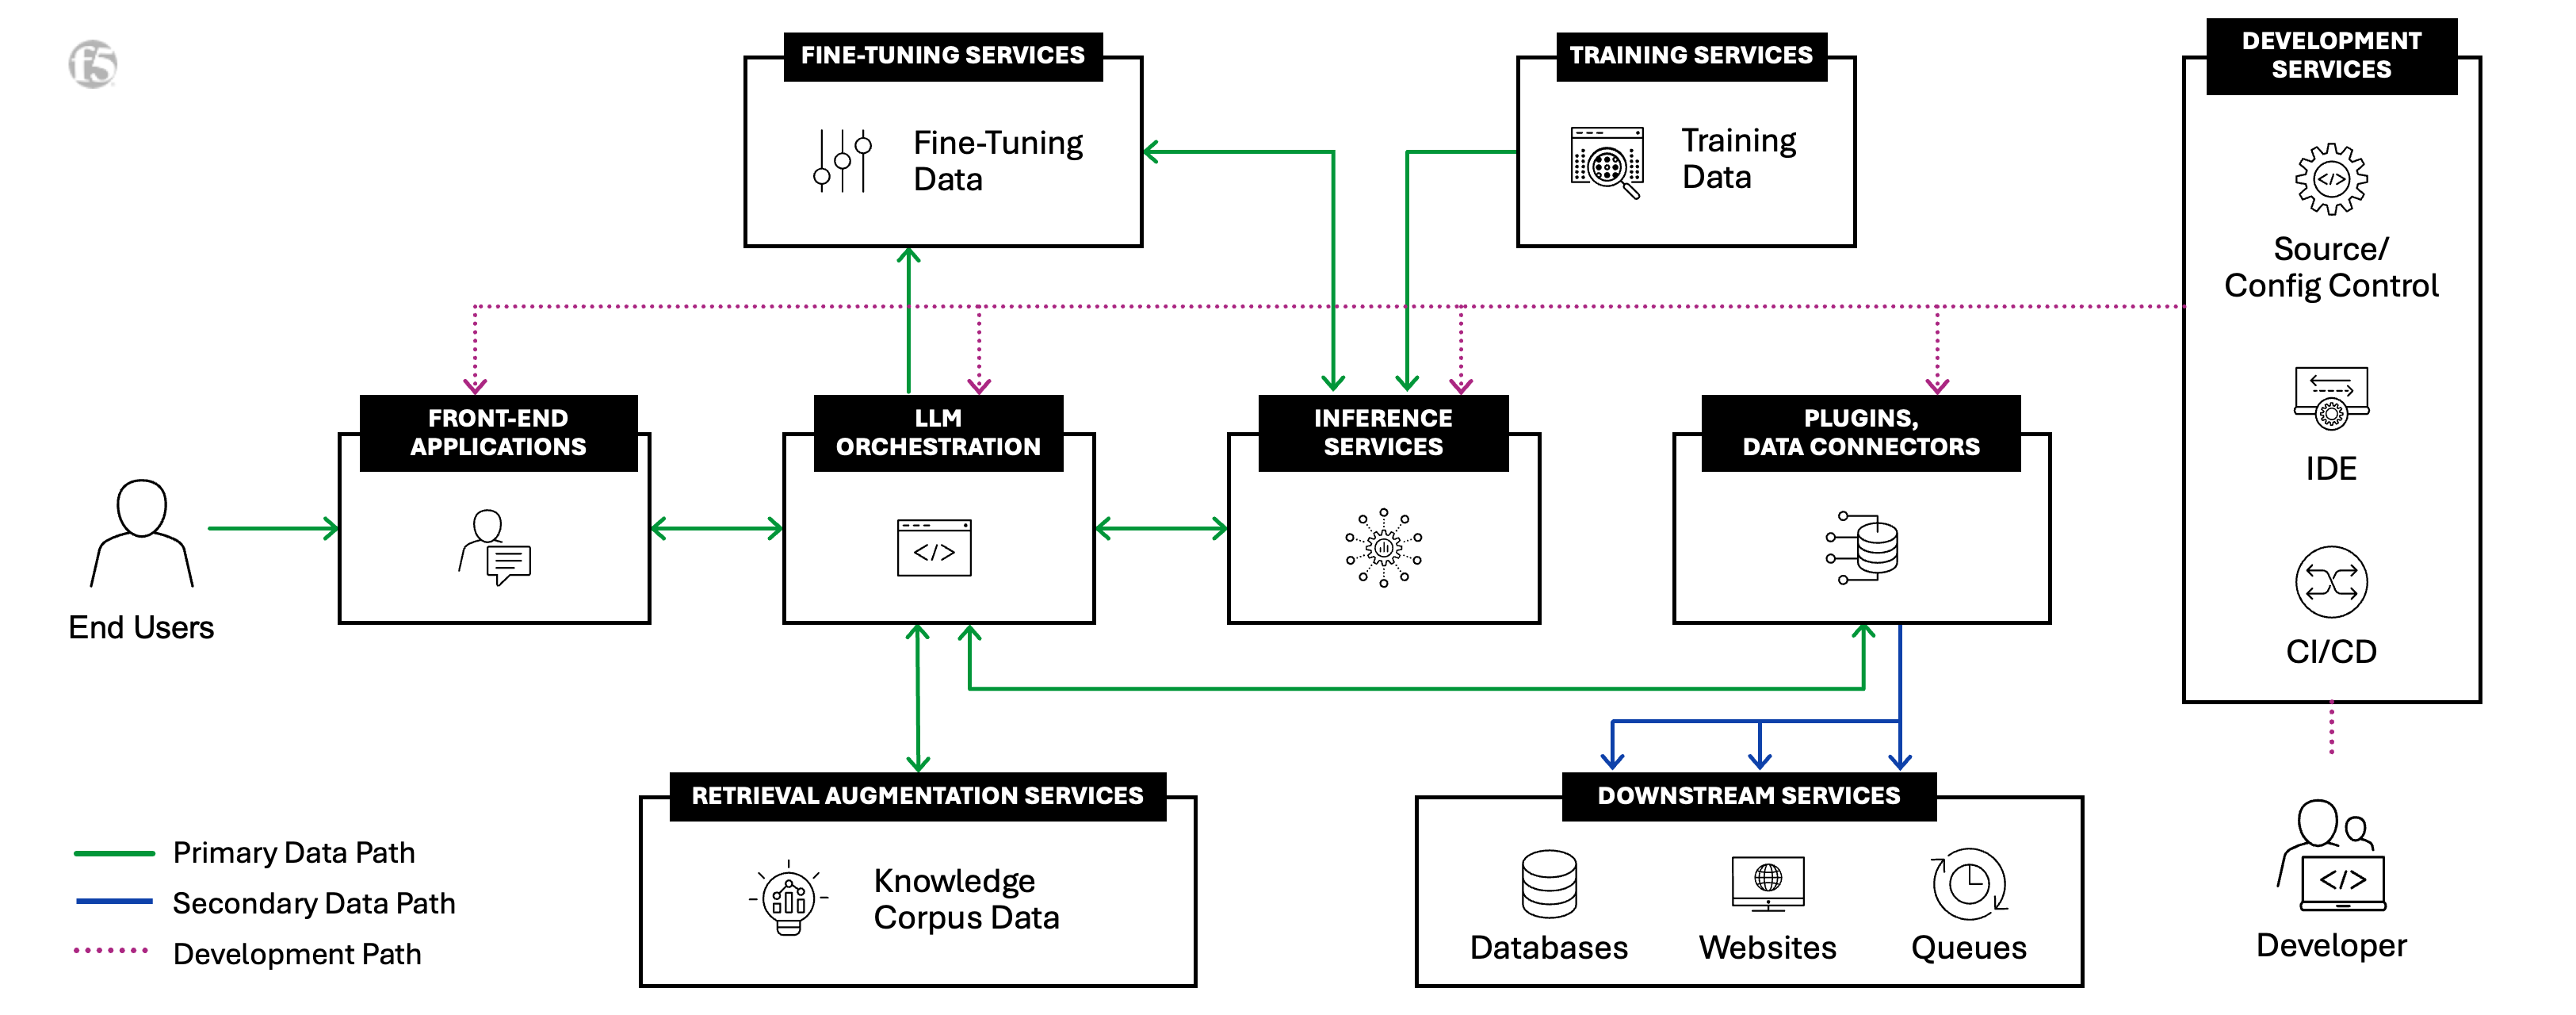
Sept composants fondamentaux de l’IA
Dans notre architecture de référence, nous avons défini sept composants fondamentaux d’IA nécessaires à la mise en place d’une usine d’IA complète :
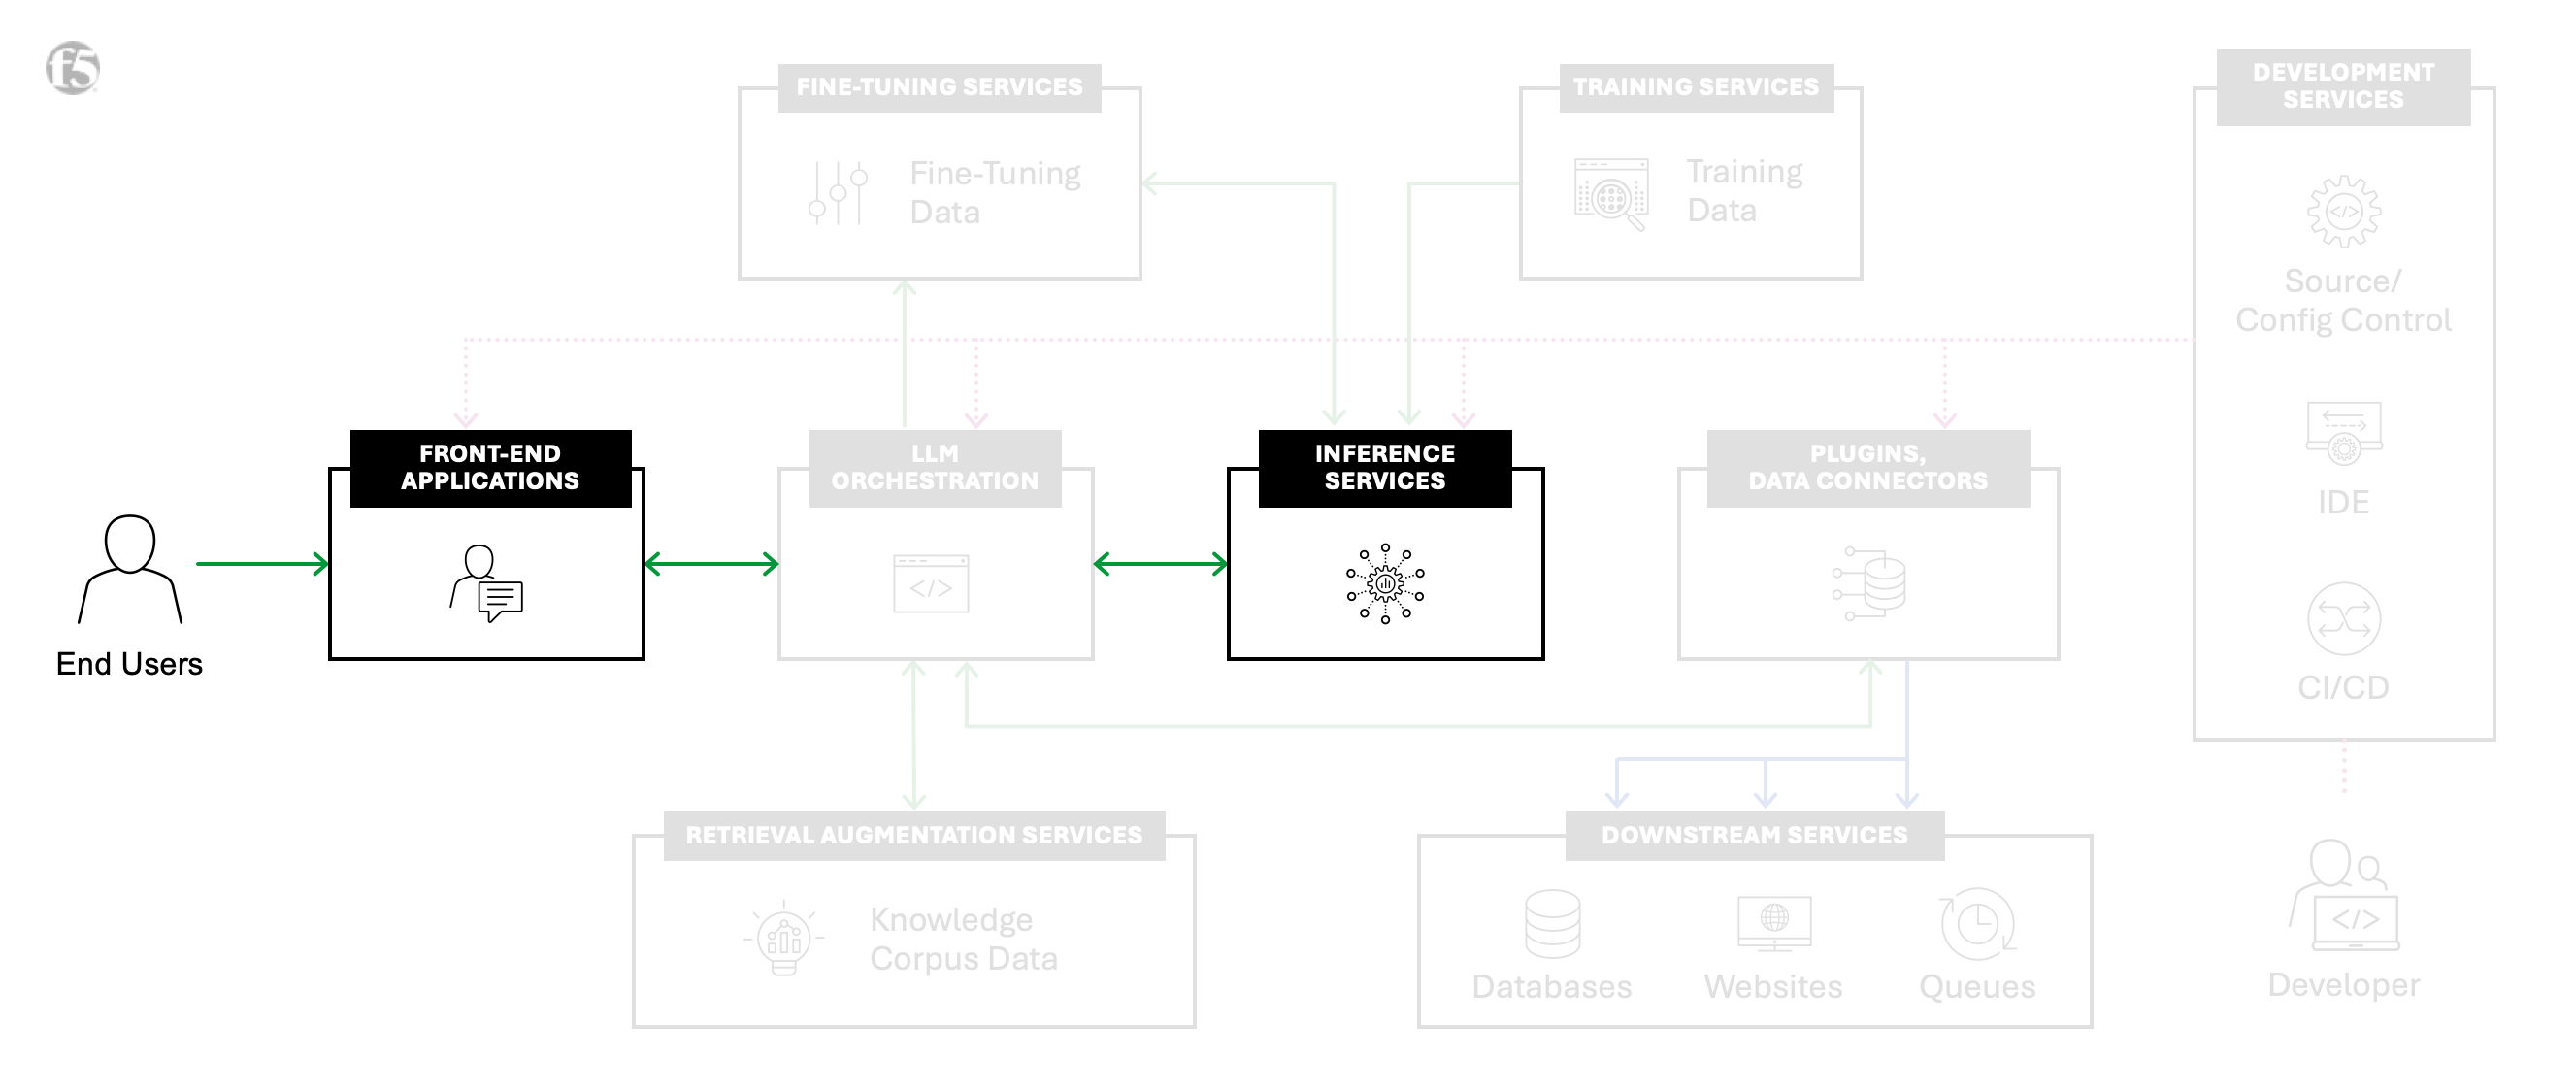
1. Inférence
Décrit l’interaction entre une application front-end et l’API d’un service d’inférence, en mettant l’accent sur l’envoi d’une requête à un modèle d’IA et la réception d’une réponse. Cela pose les bases d’interactions plus complexes.
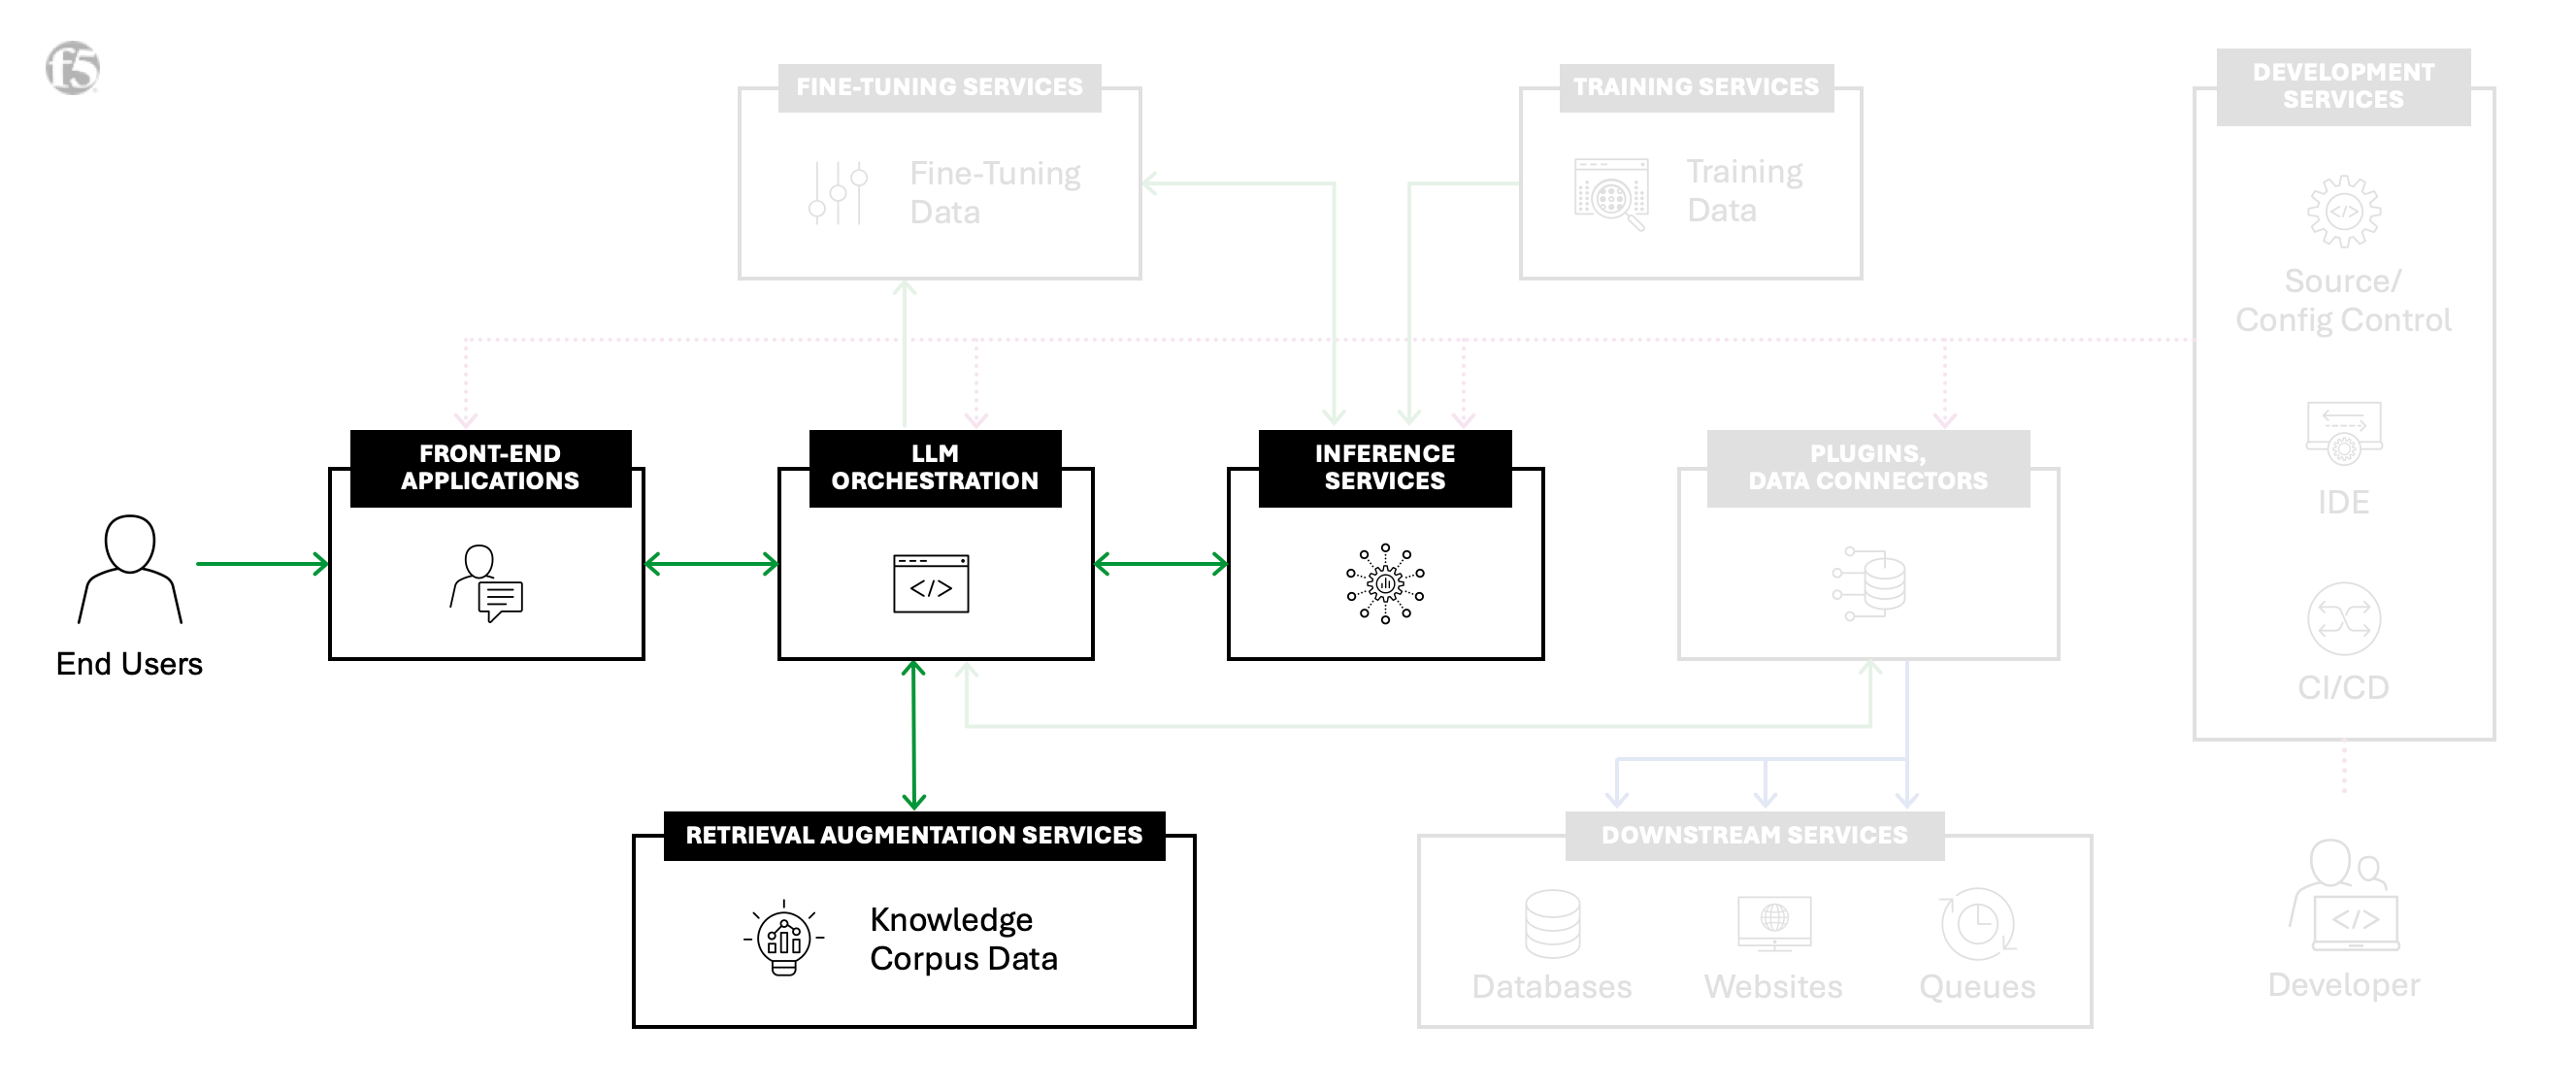
2. Génération augmentée par récupération
Améliore l’inférence de base en ajoutant des services d’orchestration de grands modèles de langage (LLM) et de génération augmentée par récupération. Cette approche consiste à extraire du contexte supplémentaire à partir de bases de données vectorielles et de référentiels de contenu, puis à l’utiliser pour générer une réponse enrichie par ce contexte.
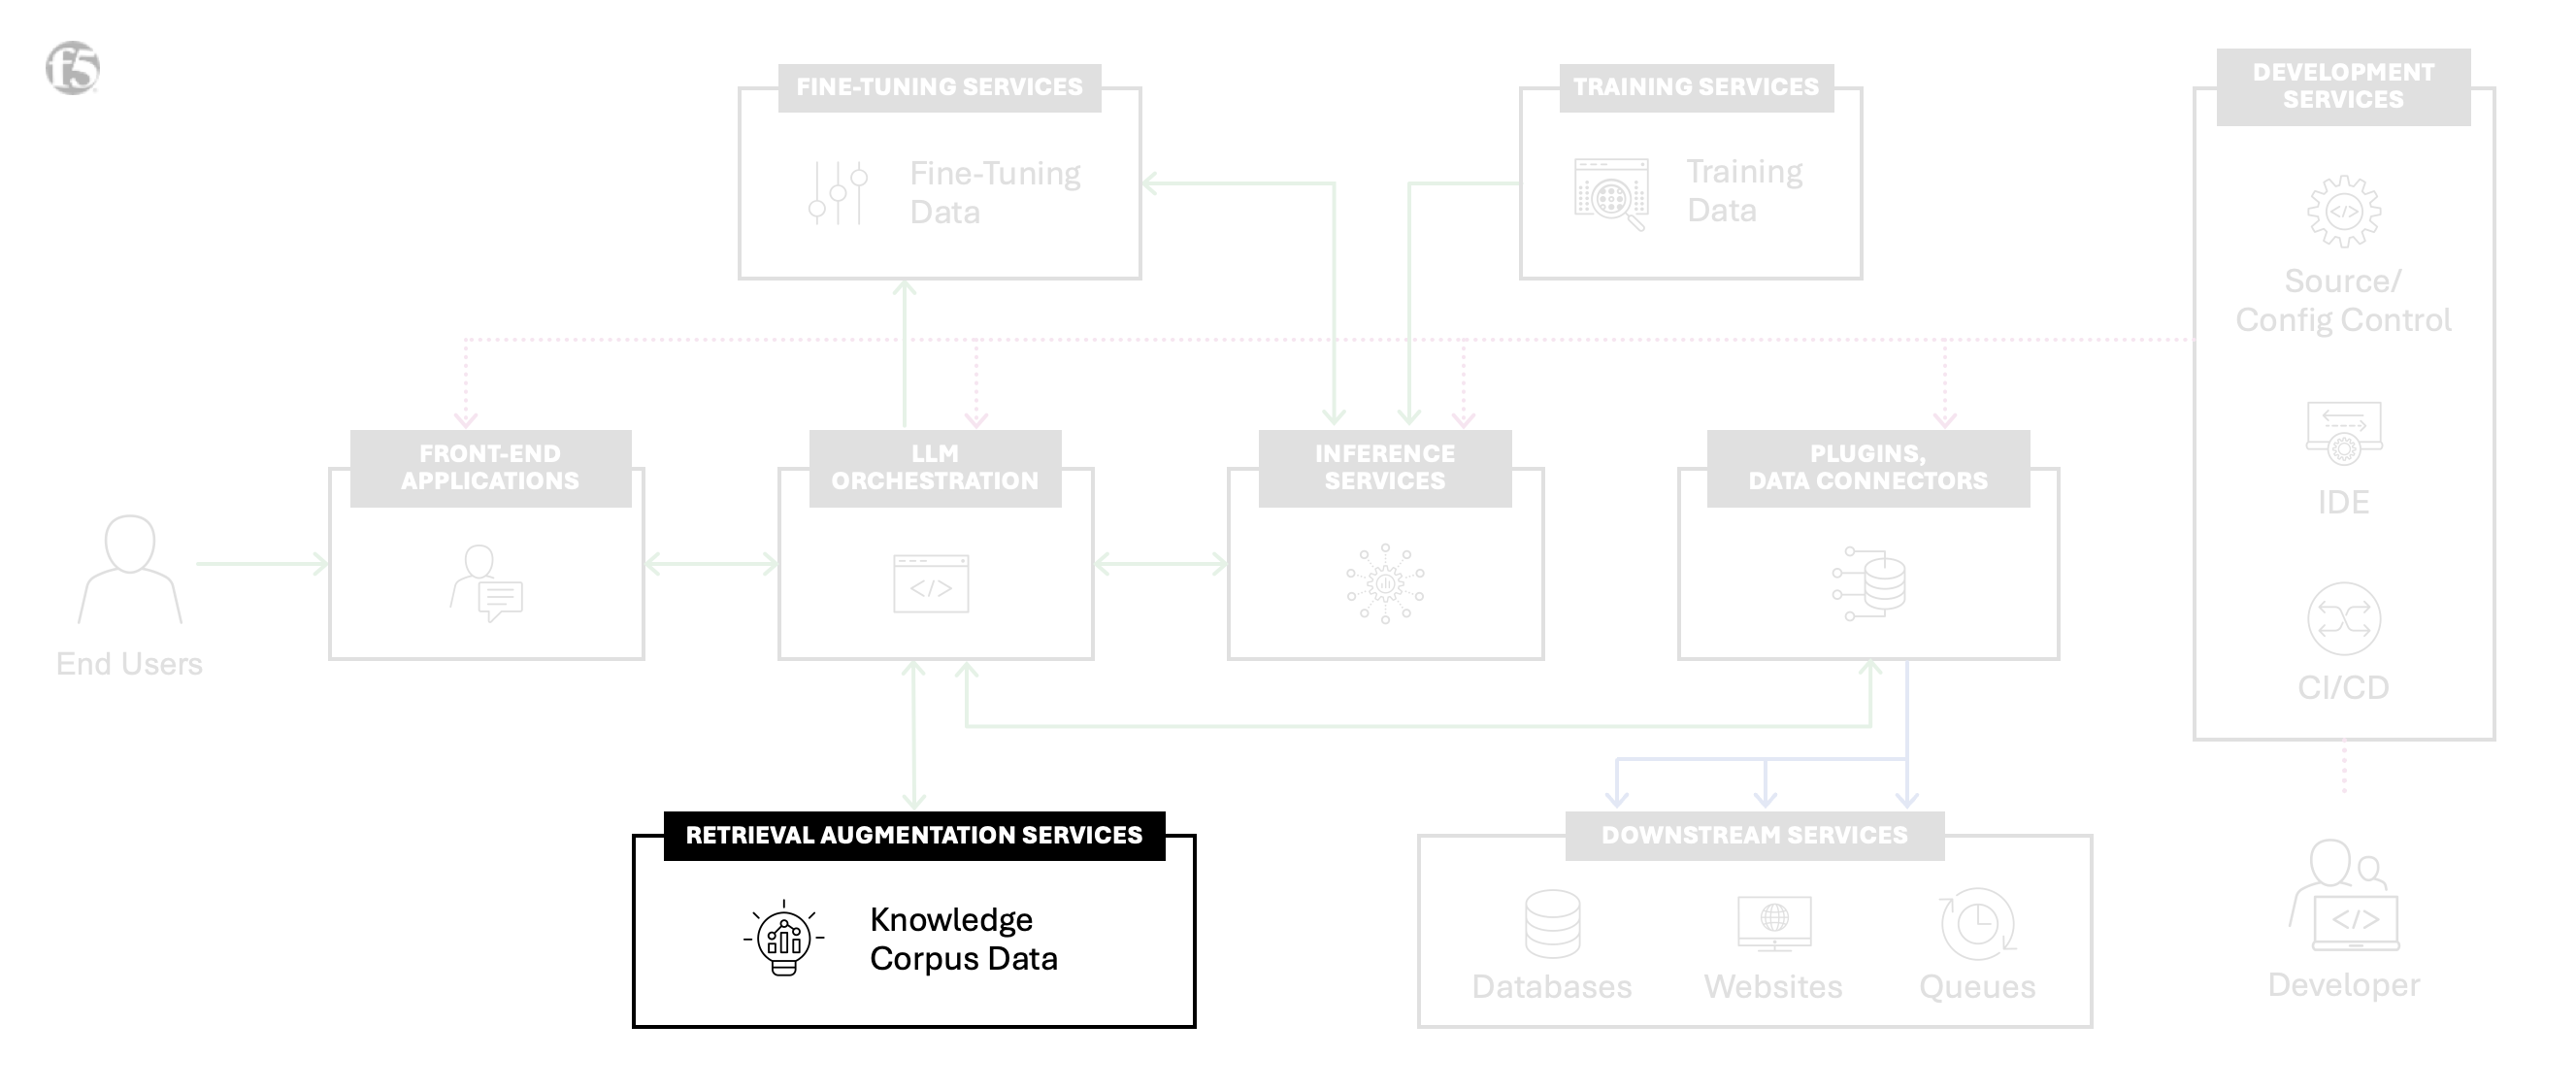
3. Gestion du corpus RAG
Se concentre sur les processus d’ingestion de données nécessaires à l’inférence avec génération augmentée par récupération (RAG). Cela comprend la normalisation des données, la création d’embeddings et l’alimentation des bases de données vectorielles afin de préparer le contenu pour les appels RAG.
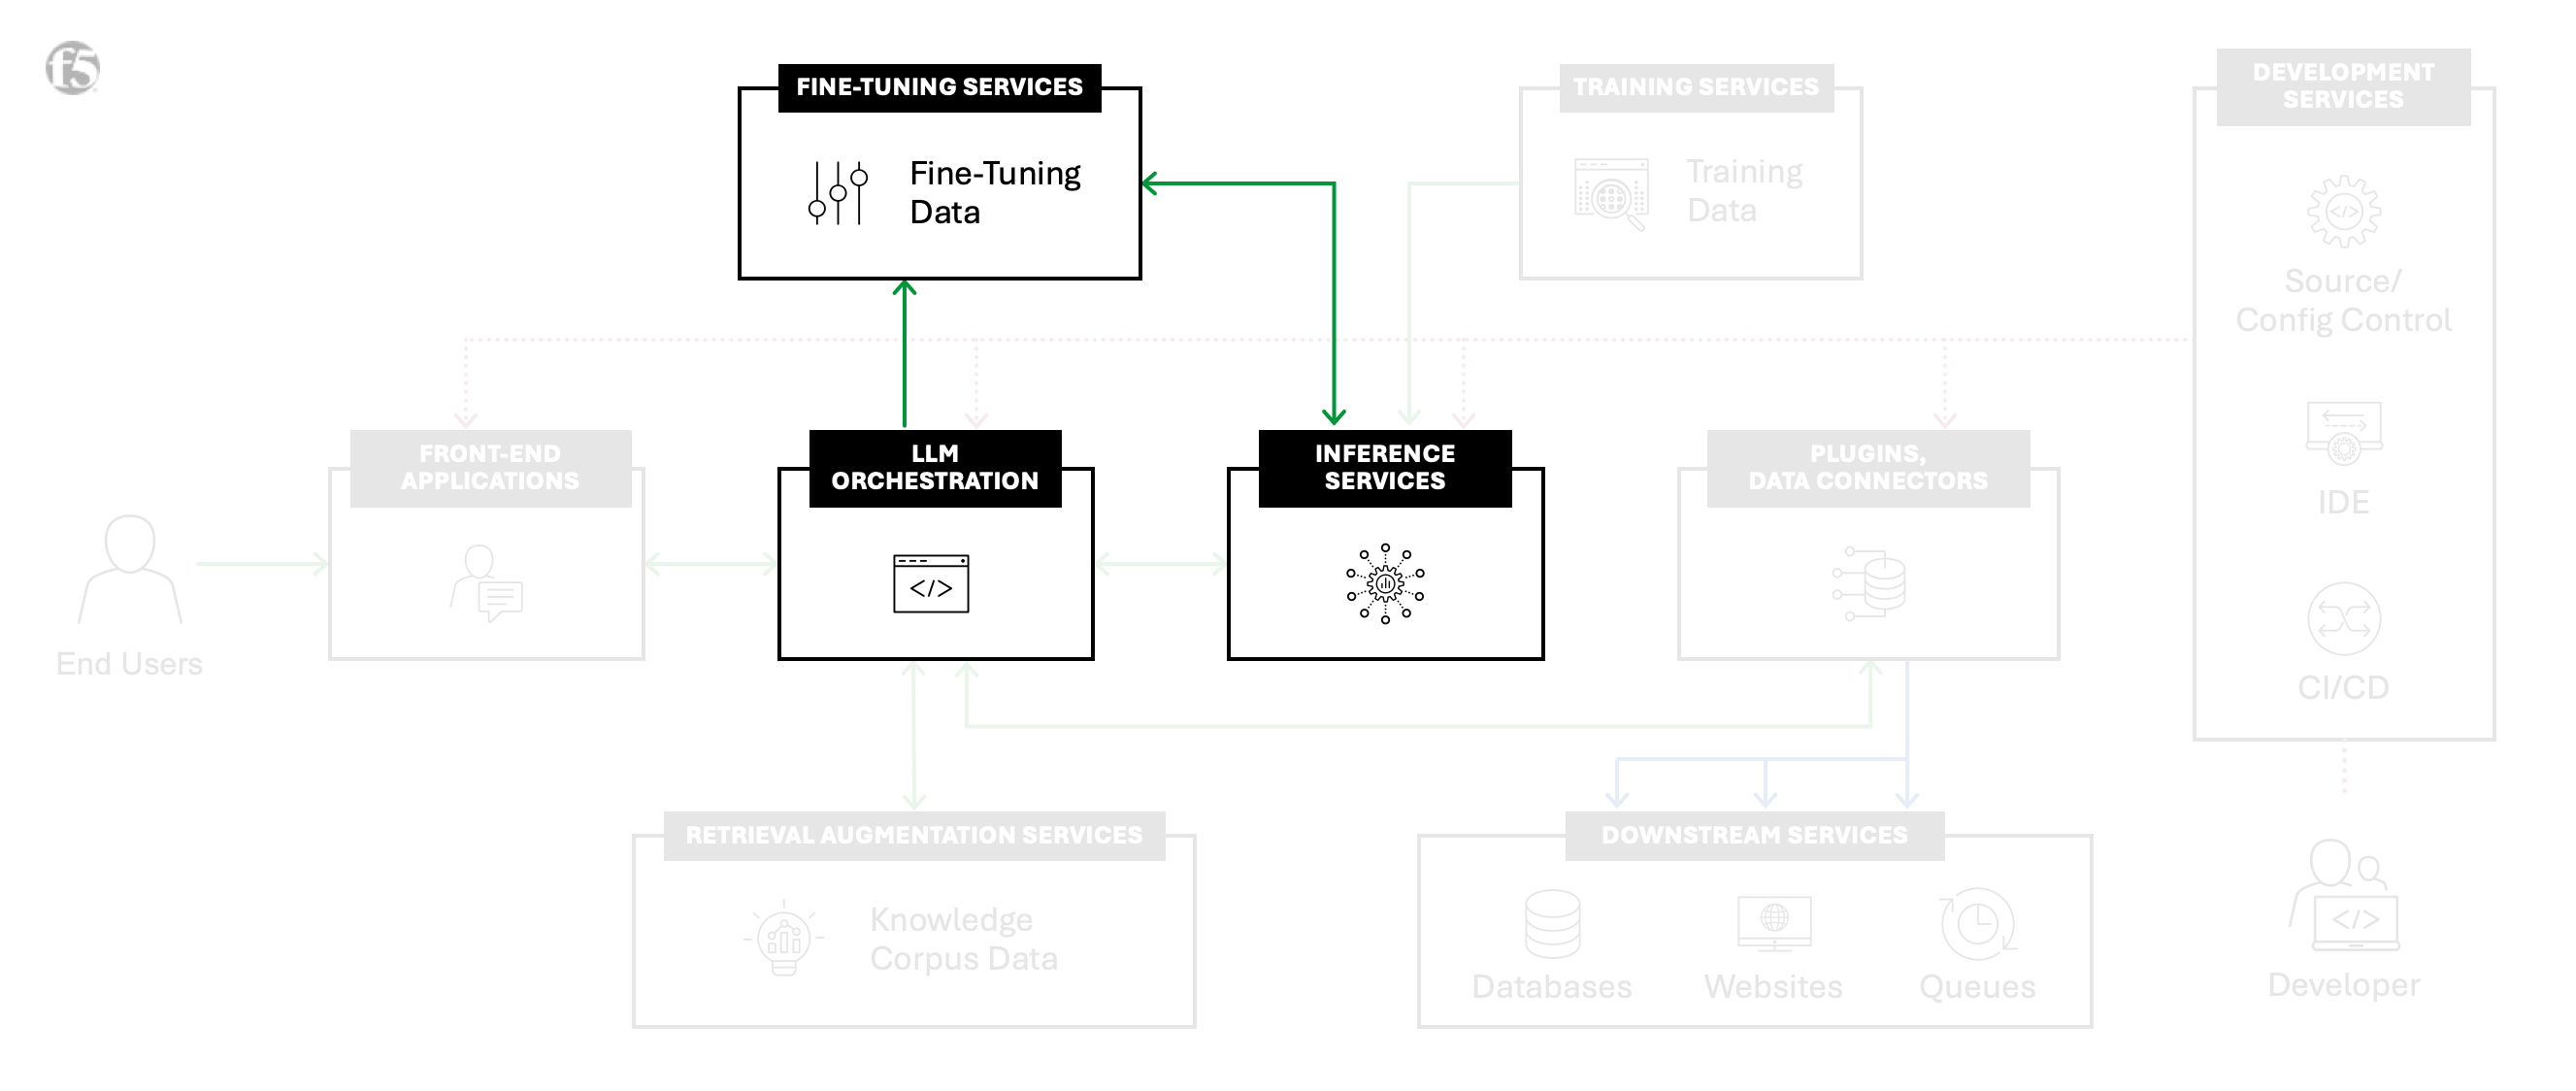
4. Ajustement fin
Vise à améliorer les performances d’un modèle existant grâce à l’interaction avec celui-ci. Cette approche ajuste le modèle sans le reconstruire entièrement et met l’accent sur la collecte de données issues de l’inférence et de l’inférence avec RAG pour les workflows de réglage fin.
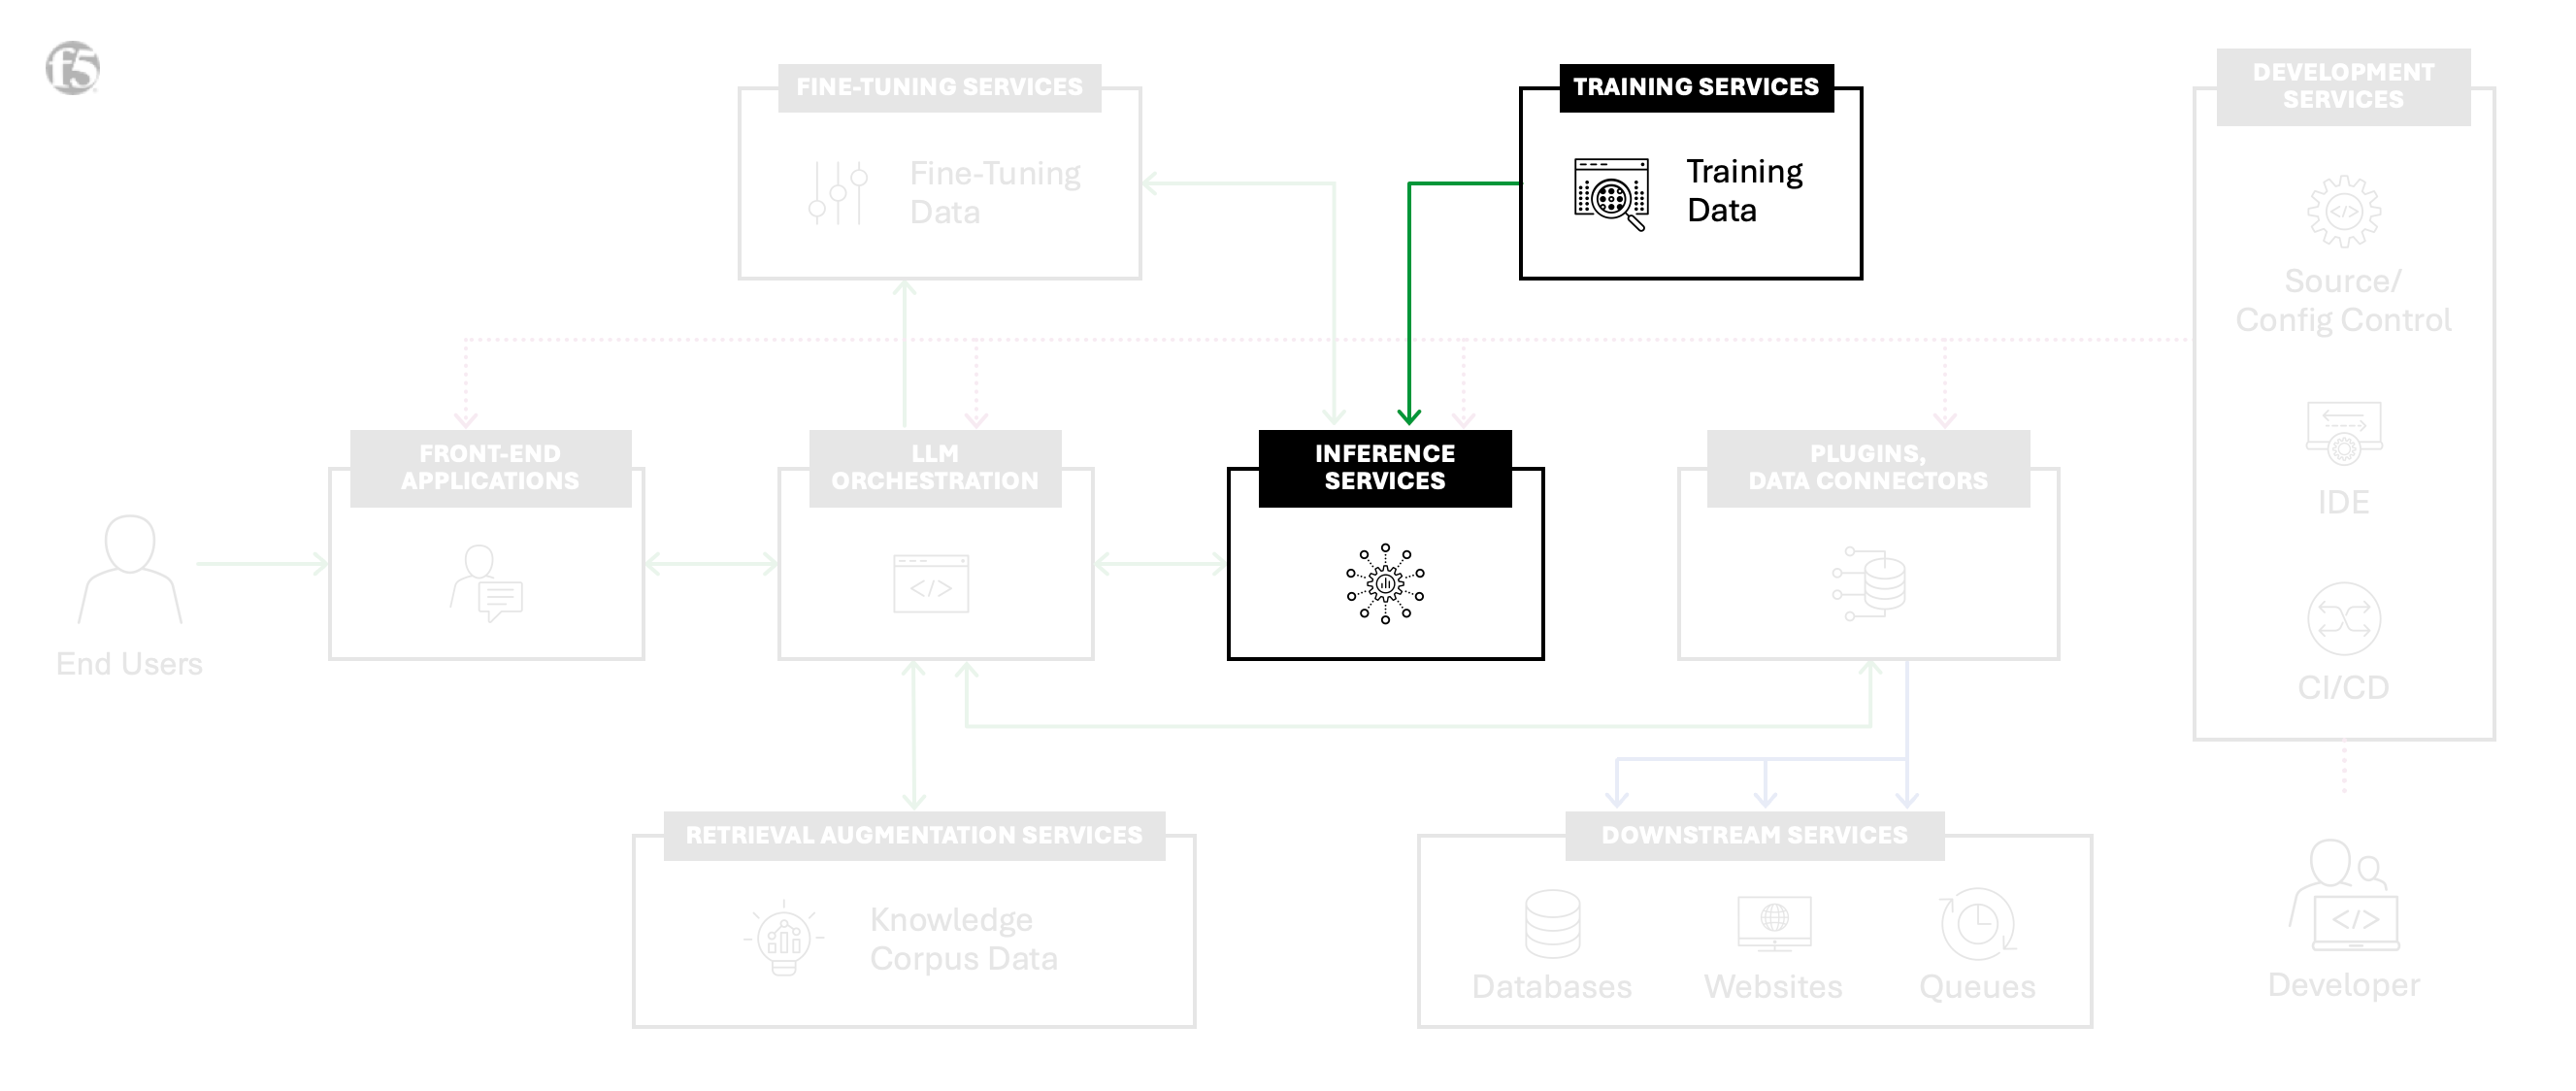
5. Entraînement
Consiste à construire un nouveau modèle de A à Z, bien qu’il puisse s’appuyer sur des points de contrôle antérieurs (réentraînement). Ce processus englobe la collecte et le prétraitement des données, le choix du modèle et de la méthode d’entraînement, l’entraînement ainsi que la validation et les tests. Cette démarche itérative vise à créer des modèles robustes adaptés à des tâches spécifiques.
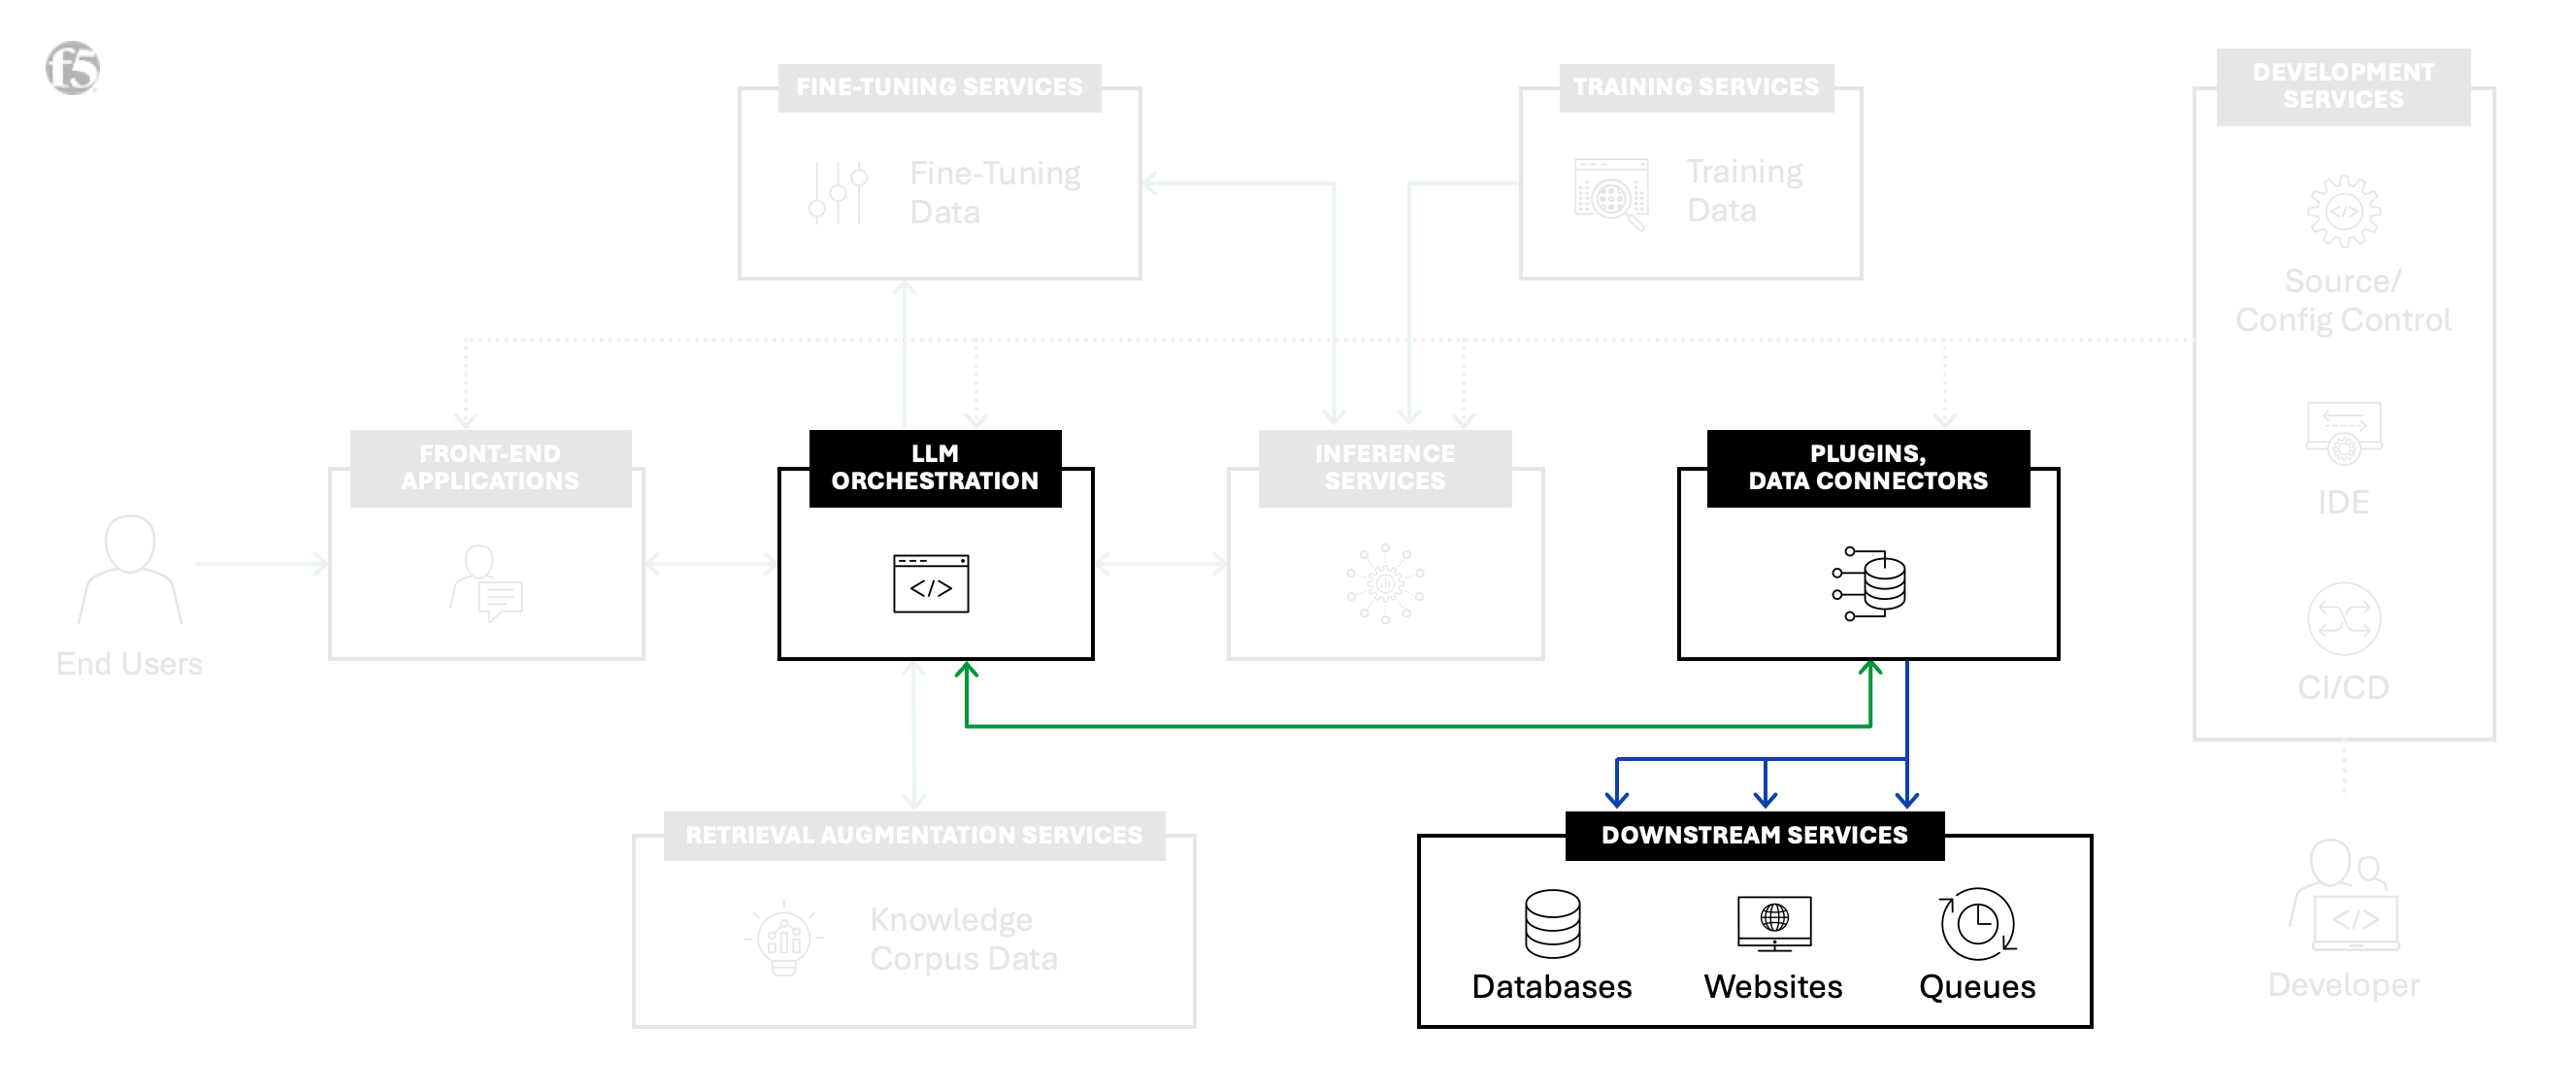
6. Intégration de services externes
Connecte la couche d’orchestration du LLM à des sources externes telles que des bases de données et des sites web. Elle intègre des données externes aux requêtes d’inférence, mais n’inclut pas les tâches de prétraitement des documents telles que le découpage en segments et la vectorisation.
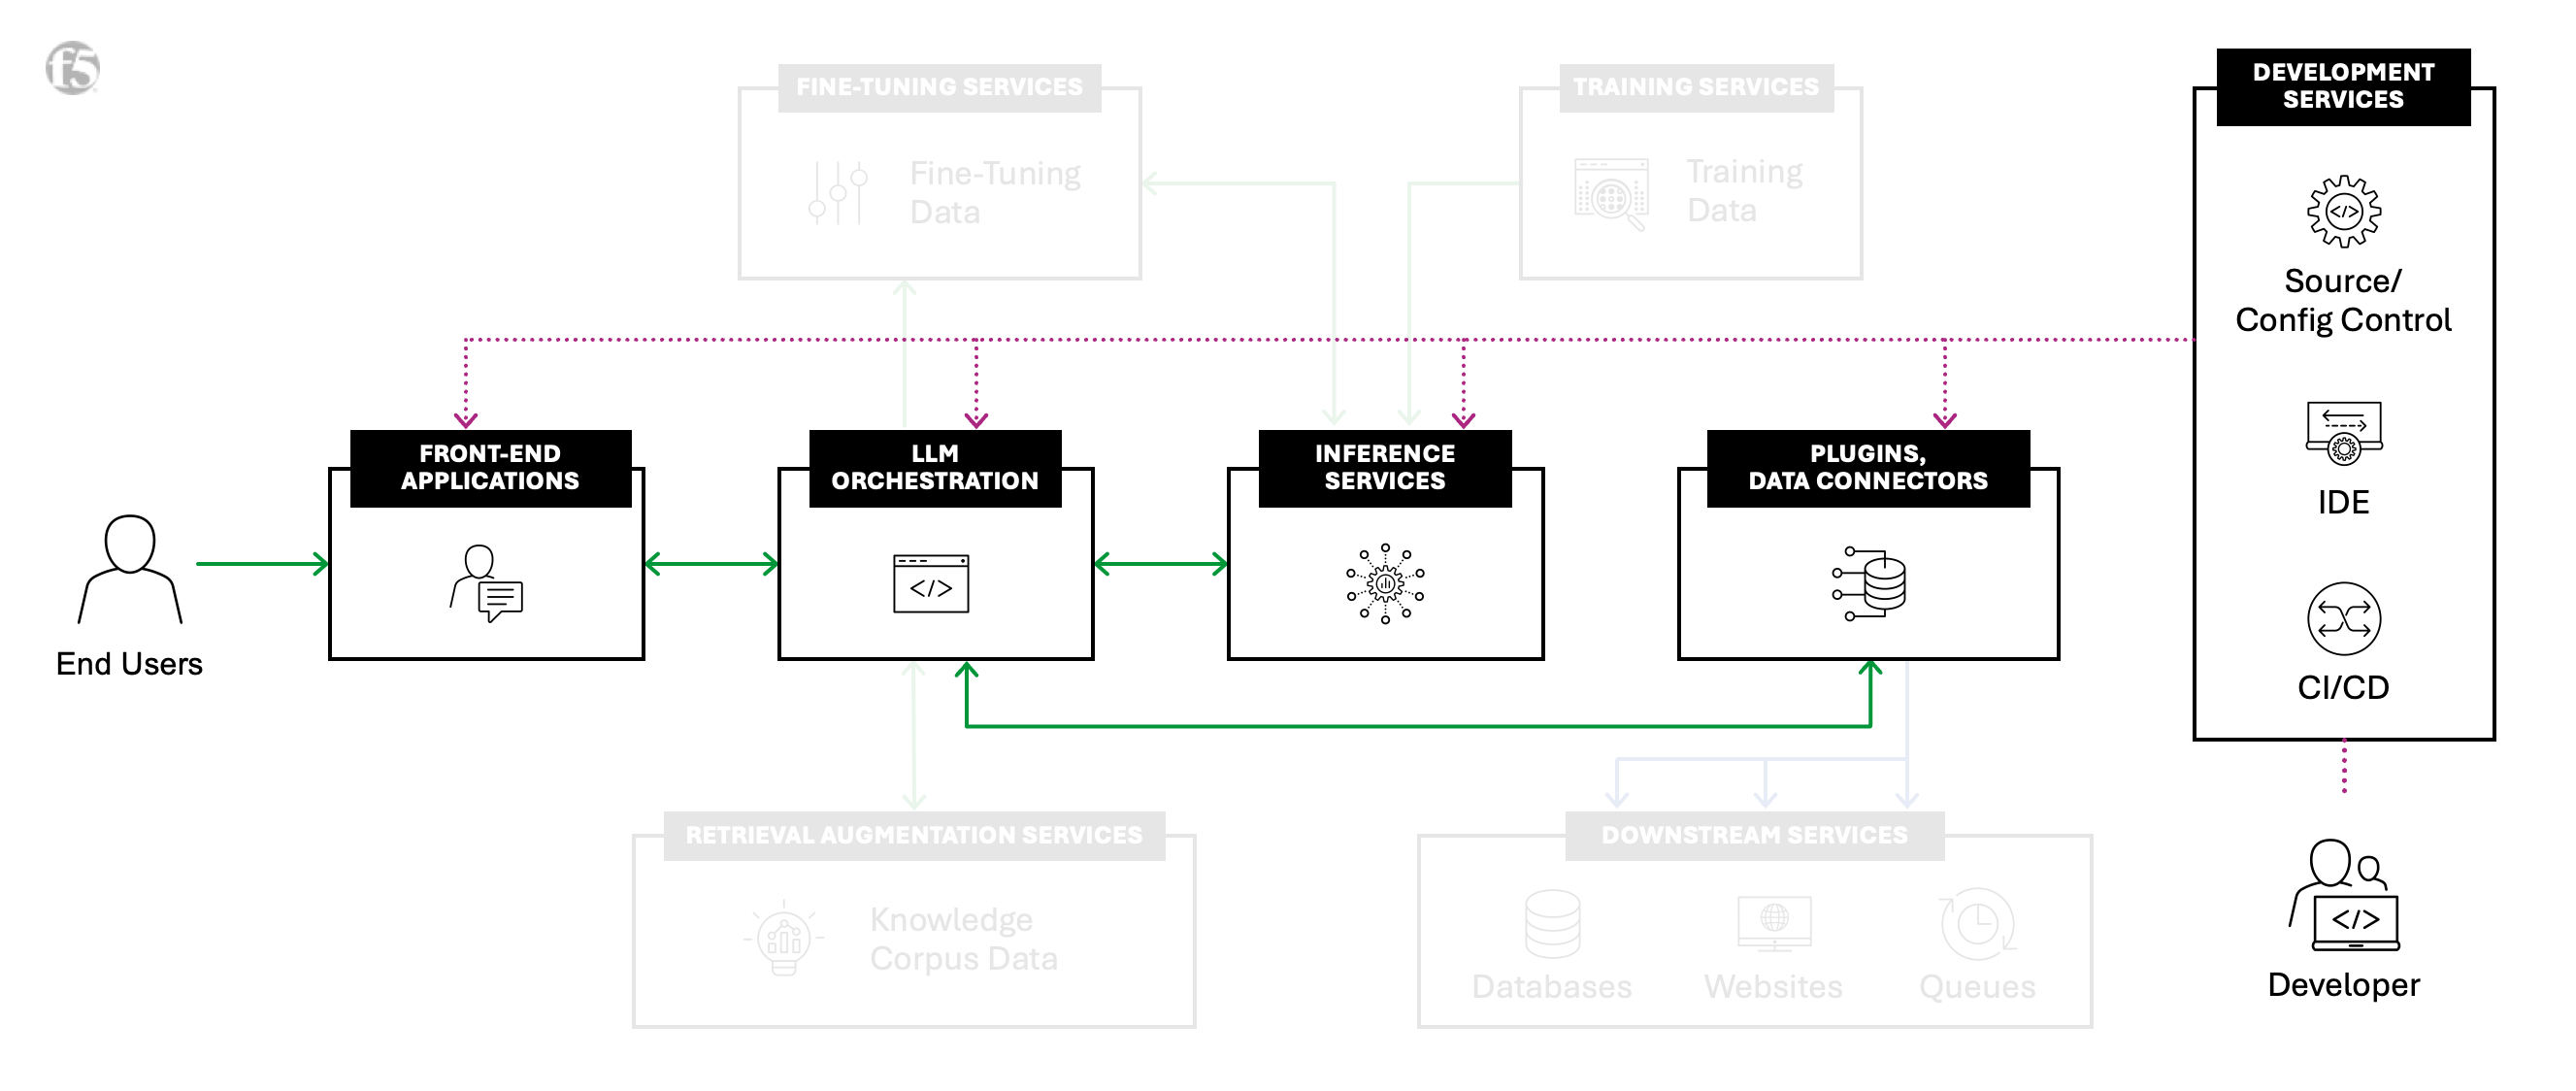
7. Développement
Englobe les workflows de développement, de maintenance, de configuration, de test et de déploiement des composants d’applications d’IA. Cela inclut les applications front-end, l’orchestration des LLM, la gestion du code source et les pipelines CI/CD.
Ensemble, ces composants constituent l’épine dorsale d’une usine d’IA. Chacun joue un rôle crucial dans la création, le déploiement et l’amélioration des résultats produits par l’IA. En outre, les initiatives d’usine d’IA tendent à privilégier la maîtrise de leurs stratégies de mise en œuvre (plutôt que leur location ou leur externalisation) pour la plupart des composants, ce qui conduit à choisir le modèle auto-hébergé parmi les modèles de déploiement répertoriés ci-dessous.
Quatre modèles de déploiement
Pour chacune de ces briques, les clients doivent choisir un modèle de déploiement et une stratégie de mise en œuvre adaptés (achat, location ou externalisation), afin de définir l’architecture de référence optimale pour atteindre les objectifs commerciaux de leurs initiatives d’IA. Voici les quatre principaux modèles :
- AI-SaaS consiste à utiliser une implémentation SaaS (Software as a Service) d’un service d’inférence, dans laquelle le fournisseur de services gère l’infrastructure, les mises à jour des modèles et la mise à l’échelle. Les utilisateurs interagissent avec le service par l’intermédiaire d’API sans avoir à se soucier de la maintenance sous-jacente. Ce modèle de déploiement est idéal pour les entreprises qui recherchent une solution facile à utiliser et rapide à intégrer, sans frais généraux importants. Il permet également une mise à l’échelle rapide et l’accès aux dernières fonctionnalités et améliorations.
- Hébergé dans le cloud : ce mode de déploiement consiste à gérer le service d’inférence en faisant appel à un fournisseur de services cloud (CSP), sous forme d’infrastructure en tant que service (IaaS) ou de plateforme en tant que service (PaaS). Dans ce modèle, l’utilisateur est responsable de la gestion du service, notamment de sa configuration, de sa mise à l’échelle et de sa maintenance, tout en bénéficiant de l’infrastructure robuste et des outils du CSP. Ce modèle offre flexibilité et contrôle, ce qui le rend adapté aux organisations ayant des exigences spécifiques et disposant d’une expertise technique. Il permet également une intégration fluide avec d’autres services et outils cloud natifs.
- Auto-hébergé : ce mode de déploiement nécessite de gérer le service d’inférence au sein d’un centre de données privé autogéré ou d’un centre de colocation. Ce modèle offre le plus haut niveau de contrôle et de personnalisation, permettant aux organisations d’adapter l’infrastructure et le service à leurs besoins spécifiques. Cependant, il exige également des ressources importantes pour la maintenance, les mises à jour et la mise à l’échelle. Il est souvent choisi par les organisations ayant des exigences strictes en matière de sécurité, de conformité ou de performances auxquelles les solutions cloud ne peuvent pas répondre.
- Hébergé en périphérie : ce mode de déploiement consiste à exécuter des services d’intelligence artificielle (IA) ou d’apprentissage automatique (ML) en périphérie, par exemple dans une borne de vente, un appareil IoT ou d’autres environnements locaux. Ce modèle réduit la latence en traitant les données au plus près de leur source, ce qui le rend idéal pour les applications en temps réel et les situations où la connexion Internet est limitée ou intermittente. Il nécessite une gestion rigoureuse du matériel et des logiciels sur site, mais offre des avantages considérables pour les cas d’usage exigeant une prise de décision immédiate et locale. Le déploiement hébergé en périphérie est particulièrement utile dans des secteurs tels que le commerce de détail, l’industrie manufacturière et la santé.
F5 fournit et sécurise les applications d’IA partout
Les fonctionnalités de F5 sur lesquelles vous comptez au quotidien pour la mise à disposition et la sécurité des applications sont également essentielles à une usine d’IA bien conçue. F5 BIG-IP Local Traffic Manager, associé au matériel dédié F5 rSeries et VELOS, permet l’ingestion de données à hautes performances pour l’entraînement de l’IA. F5 Distributed Cloud Network Connect assure une mise en réseau multicloud sécurisée reliant des données situées dans différents environnements et crée ainsi un canal sécurisé entre les données propriétaires et les modèles d’IA pour la RAG.
L’engagement de F5 en faveur de l’IA ne s’arrête pas là : découvrez comment F5 sécurise et fournit des applications d’IA partout dans le monde.
Vous souhaitez en savoir plus sur les usines d’IA ? Découvrez les autres articles de notre série consacrée aux usines d’IA :
- Génération augmentée par récupération (RAG) pour les usines d’IA ›
- Optimiser la gestion du trafic pour l’ingestion de données dans les usines d’IA ›
- Connecter de manière optimale les sources de données en périphérie aux usines d’IA ›
- L’évolutivité et la flexibilité multicloud au service des usines d’IA ›
- La puissance et l’importance du DPU NVIDIA BlueField pour les usines d’IA ›
- Protection des API pour les usines d’IA : la première étape vers la sécurité de l’IA ›
- L’importance de la segmentation réseau pour les usines d’IA ›
- Les usines d’IA produisent les applications les plus modernes qui soient : les applications d’IA ›
À propos de l’auteur
Hunter Smit est directeur principal du marketing produit pour les solutions et la stratégie chez F5. Il dirige le marketing des solutions pour l’ensemble du portefeuille de F5, notamment dans les domaines de l’infrastructure d’IA et de la sécurité des applications, et pilote l’entrée de F5 sur le marché émergent de la fourniture de données pour l’IA. Hunter est membre du conseil consultatif de l’École de commerce de l’université Whitworth et a enseigné le marketing produit en tant que chargé de cours vacataire. Il est titulaire d’un MBA et d’un Bachelor of Business Administration en management de l’université Whitworth.
Autres articles de Hunter SmitArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.