Dans le paysage technologique actuel en constante évolution, le déploiement et la mise en œuvre opérationnelle de l’IA sont devenus des facteurs de différenciation essentiels pour les entreprises. Alors que celles-ci exploitent la puissance de l’IA pour améliorer la prise de décision et l’efficacité, ou pour développer des produits différenciants grâce à l’IA, les usines d’IA se sont imposées comme un modèle fondamental. Au cœur de ces usines se trouve la génération augmentée par récupération (RAG), l’un des sept composants fondamentaux de l’IA, qui permet de produire des résultats tenant compte du contexte, plus précis et disponibles au moment opportun.
Précédemment, dans notre série consacrée aux usines d’IA, nous avons défini une usine d’IA comme un investissement massif dans le stockage, les réseaux et le calcul, destiné à répondre aux besoins d’entraînement et d’inférence à haut volume et à hautes performances. Dans cet article, nous aborderons deux des composants fondamentaux de l’IA que nous avons définis : la RAG et la gestion du corpus RAG.
Comprendre l’usine d’IA
À l’instar d’une usine de production traditionnelle, une usine d’IA est conçue pour générer des résultats et des modèles d’IA grâce à une infrastructure méticuleusement orchestrée composée de serveurs, de GPU, de DPU et de systèmes de stockage. Prenant en charge l’entraînement et l’inférence, les usines d’IA sont essentielles au développement d’applications d’IA à grande échelle. Toutefois, l’intégration de la génération augmentée par récupération (RAG) afin d’améliorer la pertinence contextuelle de leurs résultats permet de libérer tout le potentiel d’une usine d’IA.
Qu’est-ce que la génération augmentée par récupération, ou RAG ?
Avant d’entrer dans le vif du sujet, définissons la génération augmentée par récupération : la RAG est une technique d’IA qui intègre des données propriétaires afin de compléter les modèles d’IA et de produire des résultats tenant compte du contexte. Alors que les déploiements d’applications sont de plus en plus distribués et hébergés dans des environnements hybrides et multicloud , les données d’une entreprise se trouvent partout. Pour les organisations qui souhaitent exploiter l’avantage stratégique que représentent leurs données pour l’IA, une question se pose : comment connecter les données pertinentes afin d’enrichir les entrées des modèles d’IA, tels que les grands modèles de langage (LLM) ? Les organisations se tournent vers la RAG pour résoudre ce problème et créer des voies sécurisées entre le modèle d’IA et les silos de données distribués. Cela permet d’accéder aux informations les plus récentes et ainsi d’obtenir des résultats actualisés, tenant compte du contexte et plus précis. Sans cela, même les modèles d’IA affinés n’ont pas accès aux informations les plus récentes, qui évoluent souvent dès la fin de l’entraînement.
“La génération augmentée par récupération (RAG) est une technique d’IA qui intègre des données propriétaires afin de compléter les modèles d’IA et de produire des résultats adaptés au contexte.”
Quels exemples peut-on citer ? On peut notamment penser aux véhicules autonomes reposant sur la vision artificielle, ainsi qu’aux grands modèles de langage lorsqu’ils hallucinent ou émettent des hypothèses parce qu’une requête manque de contexte pertinent.
Pour les véhicules autonomes, l’inférence doit intégrer des données en temps réel sur la position du véhicule et sur l’environnement en constante évolution qui l’entoure, afin de circuler en toute sécurité dans des rues fréquentées par des piétons, des cyclistes et d’autres véhicules. Dans le cas des LLM, si l’on prend l’exemple d’un chatbot d’assistance client, l’accès à des informations sur les produits, telles que les journaux des modifications, les bases de connaissances, l’état des systèmes et les données de télémétrie, associé à des informations propres à chaque client, comme les tickets d’assistance, l’historique des achats et les profils clients, permet de transformer les réponses génériques des LLM en résultats utiles.
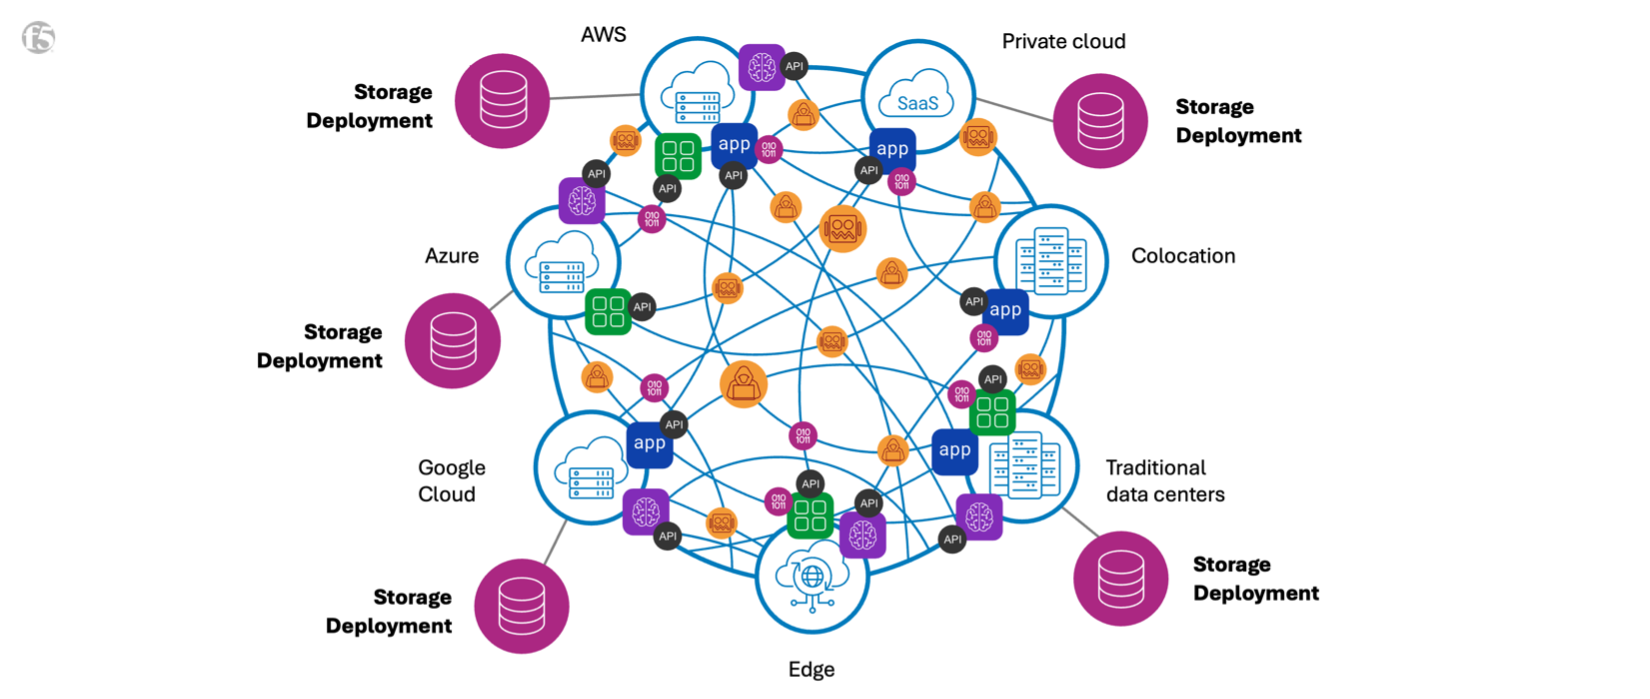
Les environnements hybrides et multicloud deviennent de plus en plus complexes, tandis que les déploiements de stockage sont de plus en plus cloisonnés dans des emplacements disparates. Chez F5, nous appelons ce phénomène la « boule de feu ».
RAG pour les usines d’IA
Dans le contexte des usines d’IA, la RAG améliore les capacités d’inférence de base des modèles d’IA fondamentaux en récupérant du contexte supplémentaire dans des bases de données vectorielles et des référentiels de contenu, qui est ensuite utilisé pour générer des réponses enrichies par le contexte. Au sein d’une usine d’IA, la couche d’orchestration de la RAG gère les interactions complexes entre le modèle d’IA et les services d’augmentation, assurant ainsi l’intégration fluide de données supplémentaires dans les workflows d’IA.
Par exemple, dans le scénario de service client mentionné ci-dessus, la RAG peut accéder aux données de diverses bases et sources pertinentes, puis les intégrer. Les résultats générés par l’IA sont ainsi particulièrement pertinents. En intégrant la RAG au cadre de l’usine d’IA, les entreprises peuvent améliorer la qualité et la rapidité de leurs réponses d’inférence, favorisant ainsi une prise de décision plus efficace et une meilleure efficacité opérationnelle.
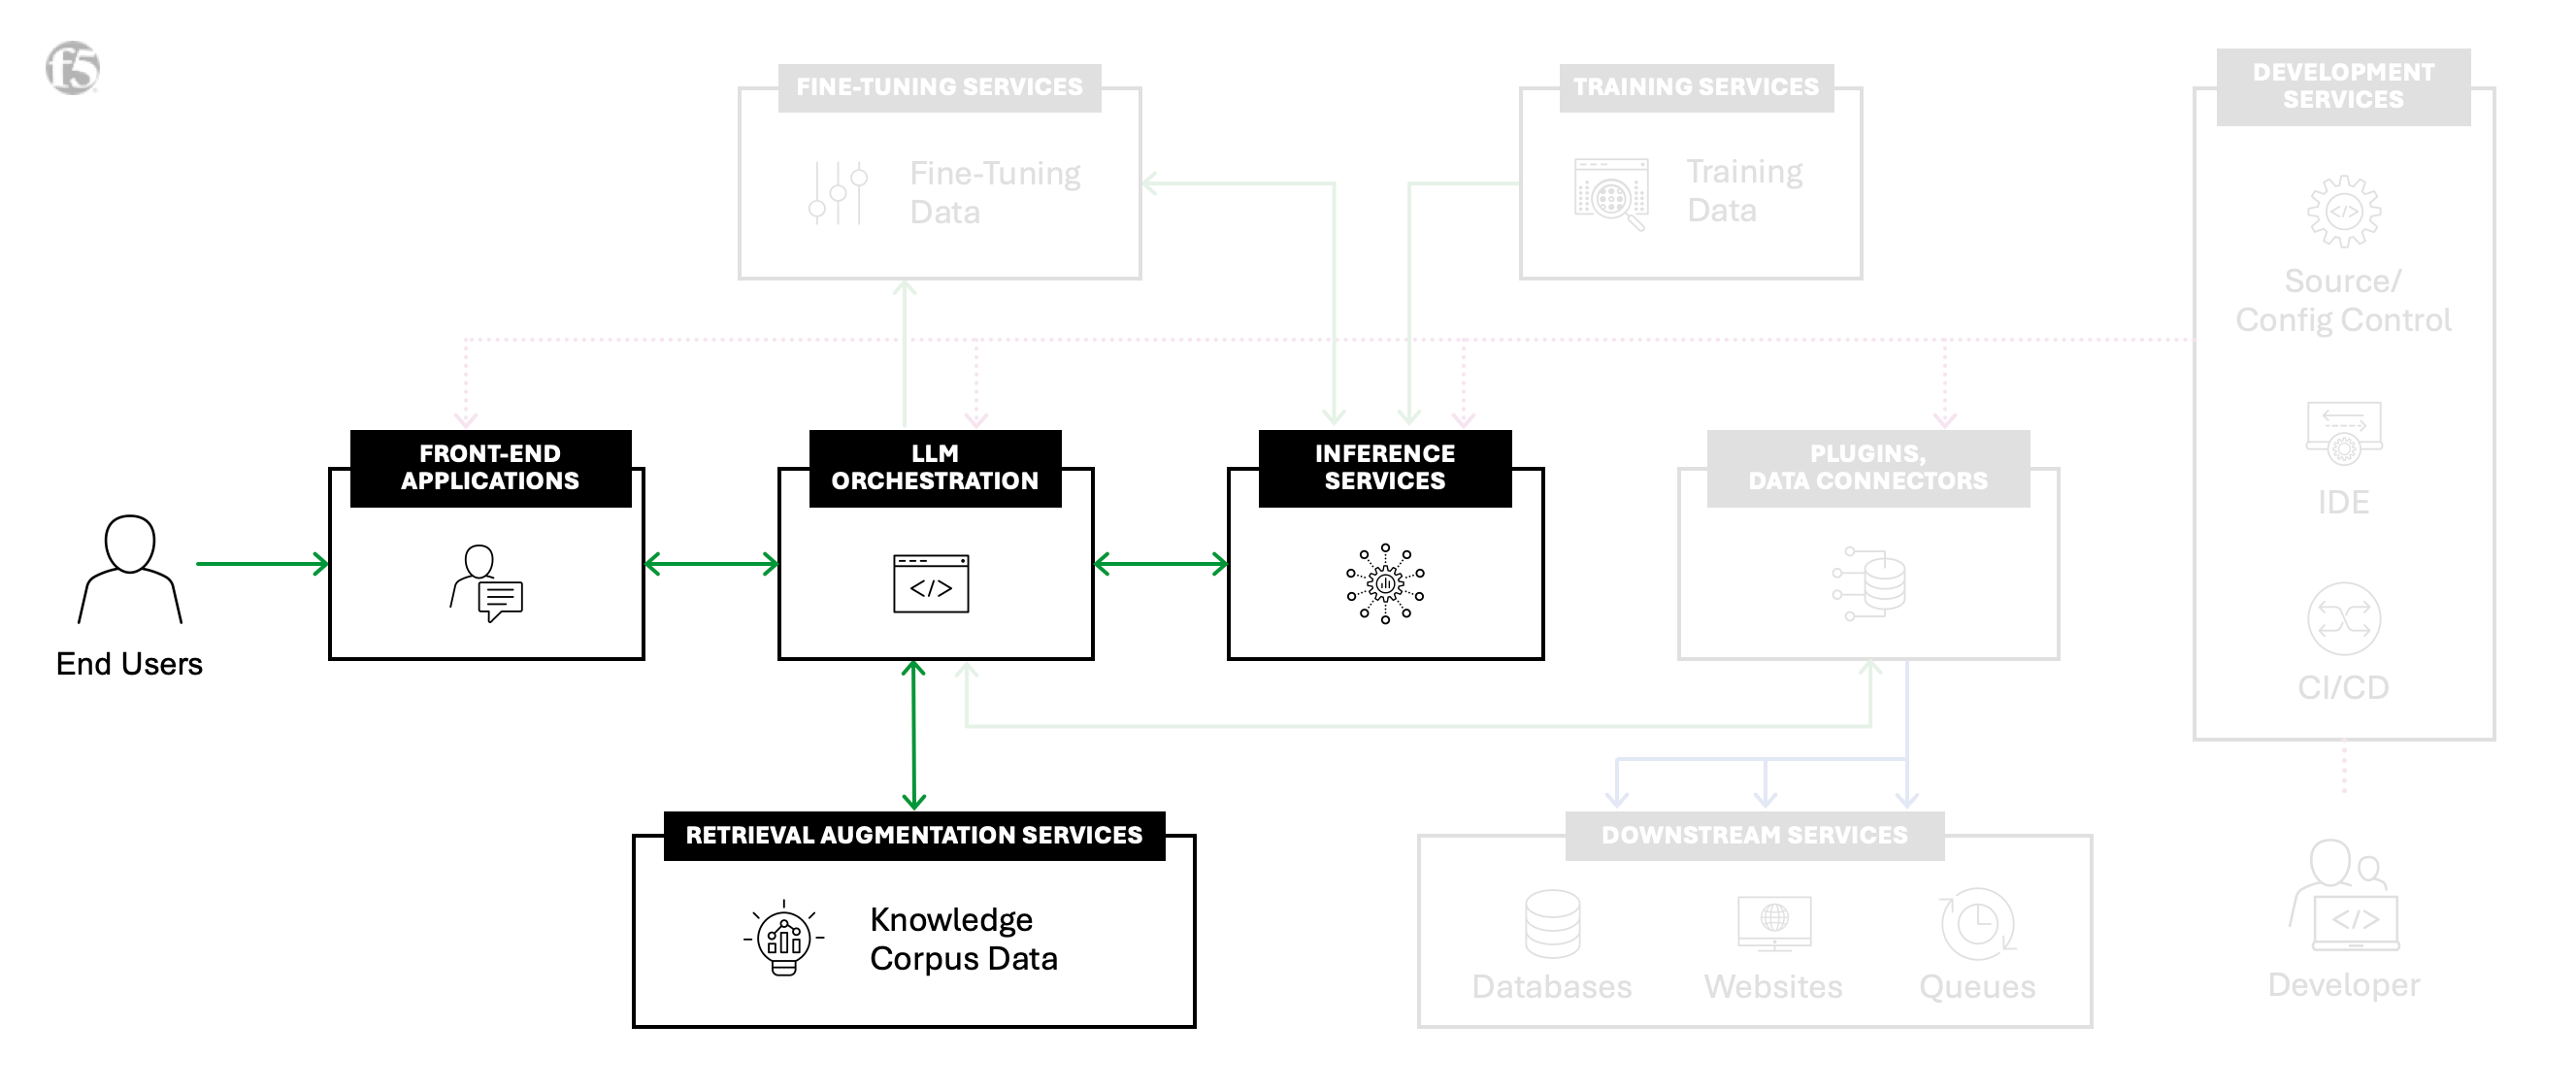
L’architecture de référence de F5 pour l’IA met en avant la RAG, l’un des sept composants d’IA nécessaires à la réussite des infrastructures d’IA à grande échelle.
Gestion des corpus RAG pour les usines d’IA
La gestion des corpus RAG se concentre sur l’ingestion et le prétraitement des données indispensables à l’inférence avec RAG. Elle comprend une série d’étapes, notamment la normalisation des données, la tokenisation, la vectorisation et l’alimentation des bases de données vectorielles, afin de préparer au mieux le contenu pour les requêtes RAG.
Au sein d’une usine d’IA, ce processus commence par la normalisation de différents formats de données afin de créer un jeu de données cohérent et structuré. Des plongements vectoriels sont ensuite générés pour convertir ces données dans un format interrogeable par les modèles d’IA. Les données préparées sont intégrées dans des bases de données vectorielles, des graphes de connaissances et des référentiels de contenu, ce qui les rend facilement accessibles pour une récupération en temps réel lors de l’inférence. En garantissant que les données sont propres, structurées et récupérables, la gestion du corpus RAG améliore l’efficacité globale et la précision des résultats produits par l’IA. Ce processus est essentiel pour les entreprises qui souhaitent maintenir des réponses d’IA de haute qualité et enrichies par des éléments contextuels.
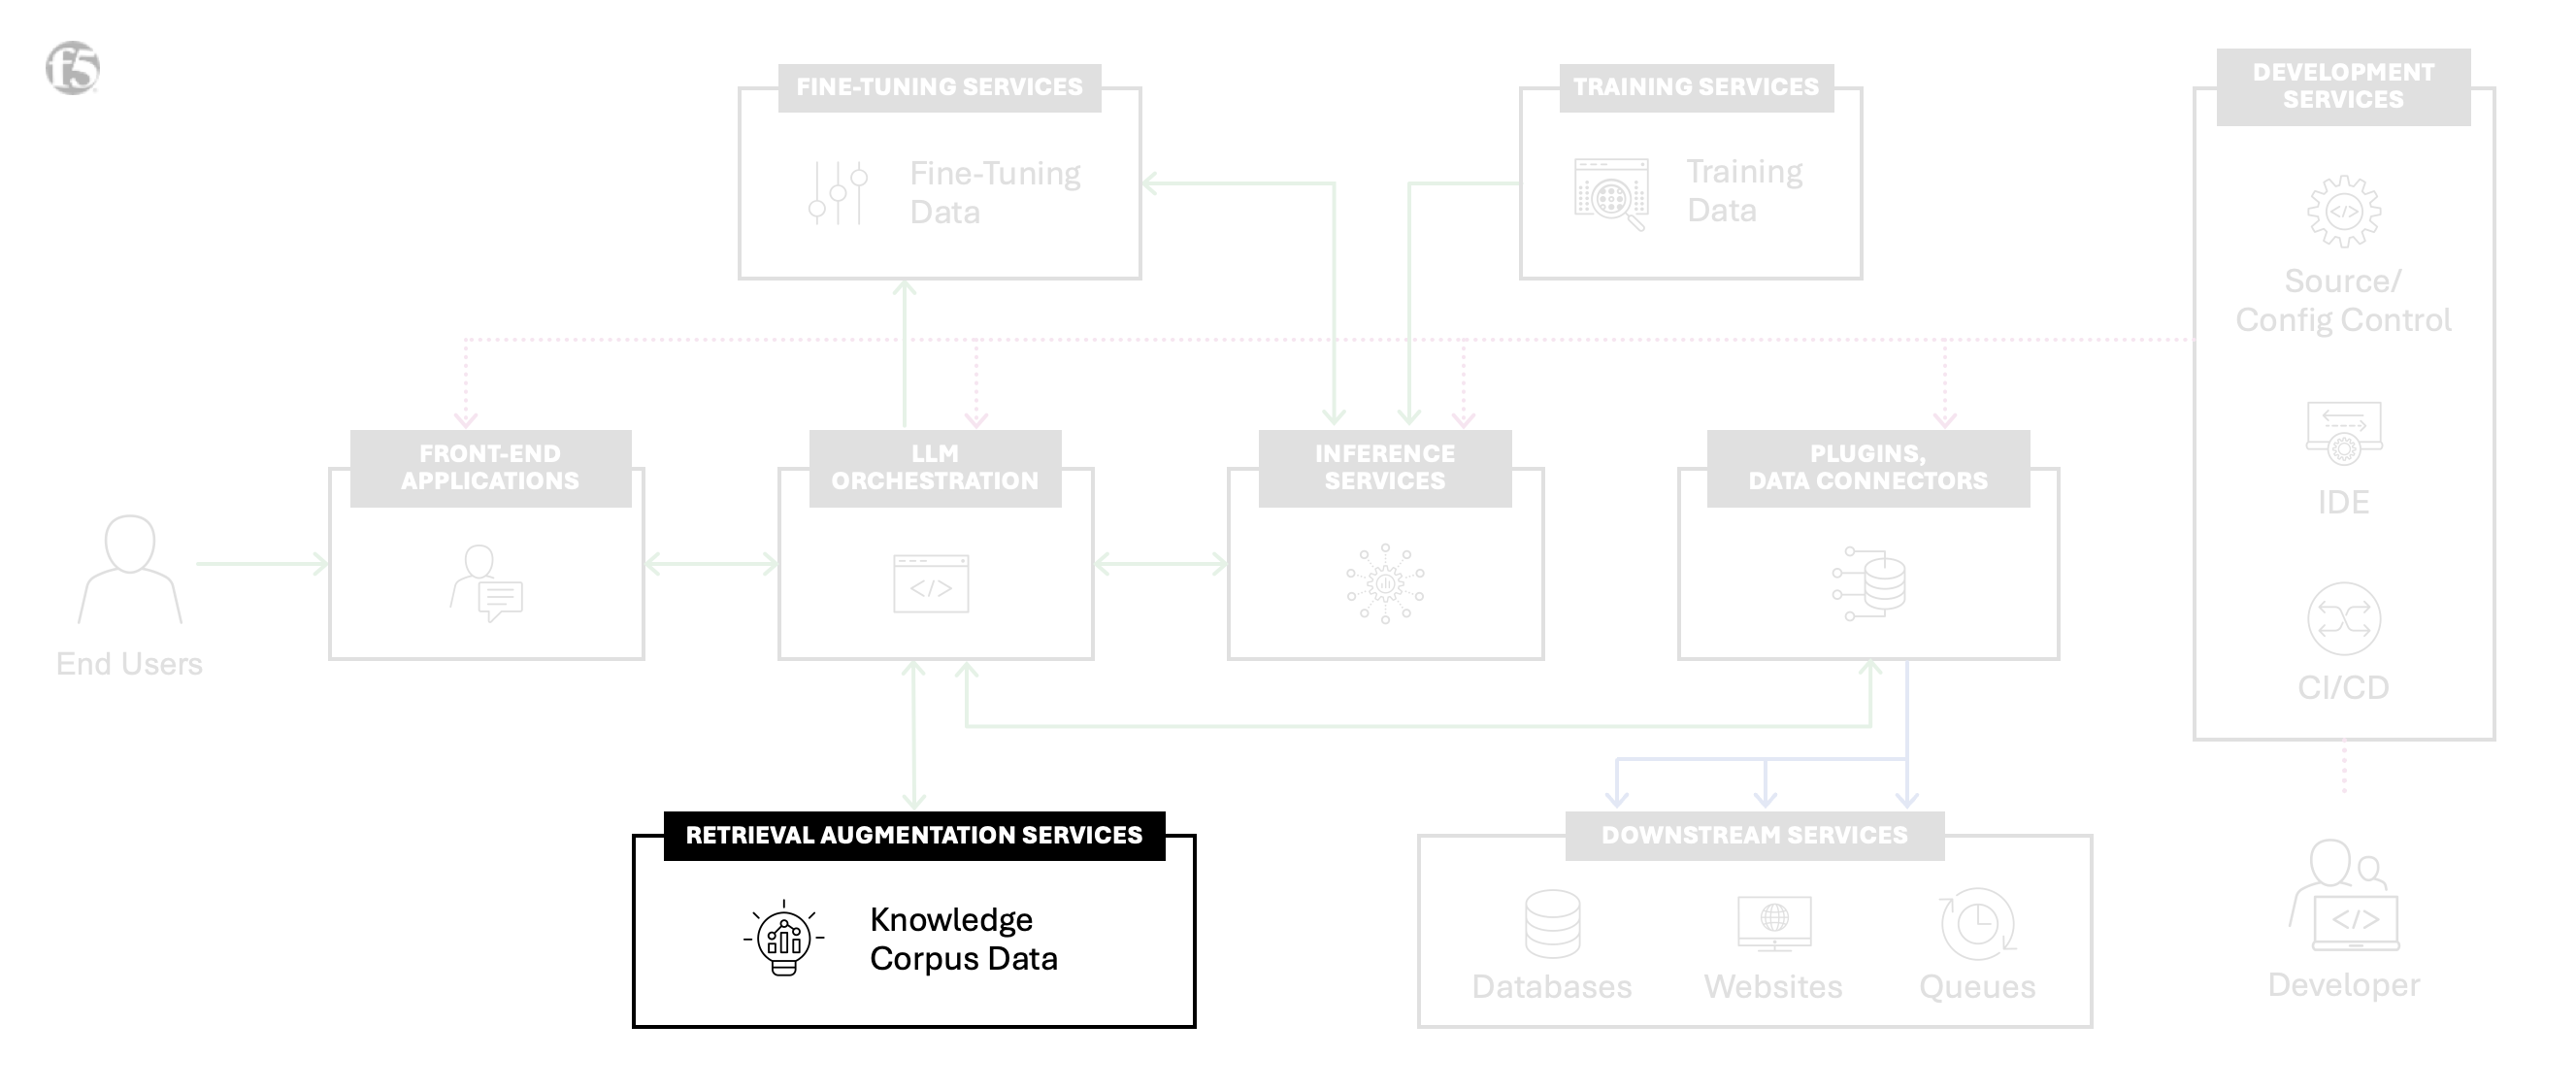
La gestion du corpus RAG est l’un des sept composants fondamentaux de l’IA définis par F5 pour assurer la réussite d’une architecture d’IA.
Le RAG s’applique-t-il uniquement aux usines d’IA ?
Bien que la RAG soit un élément fondamental des usines d’IA, elle est nécessaire pour les déploiements de modèles d’IA de toutes tailles. Étant donné que les modèles d’IA fondamentaux (par exemple, GPT et Llama) sont entraînés à partir d’informations publiques, le déploiement d’un tel modèle ne procure pas aux organisations un avantage concurrentiel suffisant par rapport à celles qui déploient le même modèle. L’intégration de données propriétaires et non publiques via la RAG est essentielle pour toute organisation, quelle que soit l’ampleur de son déploiement d’IA, afin d’enrichir les requêtes avec ses propres données. Prenons l’exemple d’un chatbot de service client : pour fournir une solution utile, une application d’assistance basée sur un LLM doit avoir accès à des informations propres aux produits et aux clients. Même lorsque les modèles sont entraînés ou affinés, l’accès à des données en constante évolution est indispensable pour obtenir des résultats plus précis.
Créer des autoroutes de données sécurisées pour permettre la mise en œuvre du RAG
Alors que les organisations continuent d’investir dans l’IA pour stimuler l’innovation et l’efficacité opérationnelle, l’importance de la RAG au sein des usines d’IA ne saurait être sous-estimée. En améliorant la prise en compte du contexte, la précision et l’actualité des informations, la RAG permet aux modèles d’IA de fournir des résultats à la fois plus pertinents et plus fiables. Pour les entreprises qui souhaitent créer des intégrations sécurisées entre leurs silos de données et leurs usines d’IA, F5 Distributed Cloud Network Connect offre des autoroutes modernes qui connectent de manière sécurisée les emplacements hébergeant les données propriétaires de l’entreprise, fournissent un accès restreint, simplifient la mise en réseau et assurent le stockage et la mobilité des données entre les zones et les régions.
L’engagement de F5 en faveur de l’IA ne s’arrête pas là : découvrez comment F5 sécurise et déploie les applications d’IA partout dans le monde.
Vous souhaitez en savoir plus sur les usines d’IA ? Découvrez d’autres articles de notre série consacrée aux usines d’IA :
- Qu’est-ce qu’une usine d’IA ? ›
- Optimisez la gestion du trafic pour l’ingestion de données dans les usines d’IA ›
- Connecter de manière optimale les sources de données en périphérie aux usines d’IA ›
- L’évolutivité et la flexibilité multicloud au service des usines d’IA ›
- La puissance et l’importance du DPU NVIDIA BlueField pour les usines d’IA ›
- Protection des API pour les usines d’IA : la première étape vers la sécurité de l’IA ›
- L’importance de la segmentation réseau pour les usines d’IA ›
- Les usines d’IA produisent les applications les plus modernes qui soient : les applications d’IA ›
À propos de l’auteur

Hunter Smit est directeur principal du marketing produit pour les solutions et la stratégie chez F5. Il dirige le marketing des solutions pour l’ensemble du portefeuille de F5, notamment dans les domaines de l’infrastructure d’IA et de la sécurité des applications, et pilote l’entrée de F5 sur le marché émergent de la fourniture de données pour l’IA. Hunter est membre du conseil consultatif de l’École de commerce de l’université Whitworth et a enseigné le marketing produit en tant que chargé de cours vacataire. Il est titulaire d’un MBA et d’un Bachelor of Business Administration en management de l’université Whitworth.
Autres articles de Hunter SmitArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.