La rédaction – Cet article fait partie d’une série en 10 volets :
- Réduisez la complexité grâce à Kubernetes prêt pour la production
- Comment améliorer la résilience dans Kubernetes grâce à une gestion avancée du trafic (cet article)
- Comment améliorer la visibilité dans Kubernetes
- Six façons de sécuriser Kubernetes à l’aide d’outils de gestion du trafic
- Guide pour choisir un contrôleur Ingress, 1re partie : identifiez vos besoins
- Guide pour choisir un contrôleur Ingress, 2e partie : risques et pérennisation
- Guide pour choisir un contrôleur Ingress, 3e partie : open source, par défaut ou commercial
- Guide pour choisir un contrôleur Ingress, 4e partie : les options de contrôleur Ingress NGINX
- Comment choisir un maillage de services
- Tests de performance des contrôleurs Ingress NGINX dans un environnement cloud Kubernetes dynamique
Vous pouvez également télécharger l’ensemble des articles sous la forme d’un e-book gratuit : « Faire passer Kubernetes de l’environnement de test à la production ».
Il existe un moyen très simple de savoir qu’une entreprise ne parvient pas à exploiter efficacement les technologies modernes de développement d’applications : ses clients s’empressent de se plaindre sur les réseaux sociaux. Ils se plaignent lorsqu’ils ne peuvent pas regarder en streaming la dernière nouveauté à dévorer. Ou accéder à leurs services bancaires en ligne. Ou effectuer un achat parce que leur panier expire.
Même si les clients ne se plaignent pas publiquement, cela ne signifie pas que leur mauvaise expérience est sans conséquence. L’un de nos clients, une grande compagnie d’assurance, nous a confié qu’il perdait des clients lorsque sa page d’accueil ne se chargeait pas en moins de 3 secondes.
Toutes ces plaintes d’utilisateurs concernant de mauvaises performances ou des interruptions de service désignent un même coupable : la résilience… ou plutôt son absence. Tout l’intérêt des technologies de microservices – notamment les conteneurs et Kubernetes – réside dans leur capacité à améliorer considérablement l’expérience client en renforçant la résilience de vos applications. Comment ? Tout est une question d’architecture.
J’aime expliquer la différence fondamentale entre les architectures monolithiques et celles basées sur des microservices en prenant l’analogie d’une guirlande lumineuse. Lorsqu’une ampoule grille sur un ancien modèle de guirlande, toute la guirlande s’éteint. Si vous ne pouvez pas remplacer l’ampoule, la seule chose que cette guirlande pourra décorer, c’est l’intérieur de votre poubelle. Ces anciennes guirlandes sont comparables aux applications monolithiques, dont les composants sont eux aussi étroitement couplés et qui cessent de fonctionner dès que l’un d’eux tombe en panne.
Mais l’industrie de l’éclairage, à l’instar de celle du logiciel, a identifié ce problème. Lorsqu’une ampoule grille sur une guirlande moderne, les autres continuent de briller, tout comme une application de microservices bien conçue continue de fonctionner même lorsqu’une instance de service tombe en panne.
Gestion du trafic Kubernetes
Les conteneurs sont très prisés dans les architectures de microservices, car ils sont parfaitement adaptés à la création d’applications à partir de composants plus petits et indépendants : ils sont légers, portables et faciles à faire évoluer. Kubernetes est la norme de facto en matière d’orchestration de conteneurs, mais la mise en production de Kubernetes présente de nombreux défis. Une stratégie aboutie de gestion du trafic permet à la fois de mieux contrôler vos applications Kubernetes et d’améliorer leur résilience. Elle vous permet de contrôler les services plutôt que les paquets, et d’adapter les règles de gestion du trafic de manière dynamique ou à l’aide de l’API Kubernetes. Si la gestion du trafic est importante dans toute architecture, deux outils sont indispensables pour les applications hautes performances : le contrôle du trafic et la répartition du trafic.
Contrôle du trafic
Le contrôle du trafic (parfois appelé « routage du trafic » ou « gestion du trafic ») consiste à contrôler la destination du trafic et la manière dont il y parvient. Il est indispensable lors de l’utilisation de Kubernetes en production, car il permet de protéger votre infrastructure et vos applications contre les attaques et les pics de trafic. Deux techniques à intégrer au cycle de développement de vos applications sont la limitation du débit et le coupe-circuit.
- Cas d’utilisation : Je souhaite protéger les services contre un trop grand nombre de requêtes
Solution : Limitation du débitQu’il soit malveillant (par exemple, tentatives de deviner un mot de passe par force brute et attaques DDoS) ou légitime (comme lorsque des clients affluent pour profiter d’une promotion), un volume élevé de requêtes HTTP peut saturer vos services et provoquer le plantage de vos applications. La limitation du débit restreint le nombre de requêtes qu’un utilisateur peut effectuer au cours d’une période donnée. Il peut s’agir d’une simple requêteGETvisant à récupérer la page d’accueil d’un site web ou d’une requêtePOSTenvoyée depuis un formulaire de connexion. En cas d’attaque DDoS, par exemple, vous pouvez utiliser la limitation du débit pour ramener le taux de requêtes entrantes à une valeur habituelle pour de vrais utilisateurs. - Cas d’utilisation : Je veux éviter les défaillances en cascade
Solution : DisjoncteurLorsqu’un service est indisponible ou présente une latence élevée, les requêtes entrantes peuvent mettre beaucoup de temps à expirer et les clients à recevoir une réponse d’erreur. Ces longs délais d’expiration peuvent entraîner une défaillance en cascade, dans laquelle l’indisponibilité d’un service provoque l’expiration des requêtes adressées à d’autres services, puis la défaillance de l’application tout entière. Les disjoncteurs empêchent les défaillances en cascade en surveillant les défaillances des services. Lorsque le nombre de requêtes ayant échoué auprès d’un service dépasse un seuil prédéfini, le disjoncteur se déclenche et commence à renvoyer une réponse d’erreur aux clients dès l’arrivée des requêtes, détournant ainsi le trafic du service. Le disjoncteur continue d’intercepter et de rejeter les requêtes pendant une durée définie, avant de laisser passer un nombre limité de requêtes à titre de test. Si ces requêtes aboutissent, le disjoncteur cesse de limiter le trafic. Dans le cas contraire, le délai est réinitialisé et le disjoncteur rejette à nouveau les requêtes pendant la durée définie.
Répartition du trafic
La répartition du trafic (parfois appelée « test de trafic ») est une sous-catégorie du contrôle du trafic qui consiste à contrôler la proportion du trafic entrant dirigée vers différentes versions d’une application backend exécutées simultanément dans un environnement (généralement la version de production actuelle et une version mise à jour). Il s’agit d’une étape essentielle du cycle de développement d’une application, car elle permet aux équipes de tester les fonctionnalités et la stabilité des nouvelles fonctions et versions sans nuire aux clients. Parmi les scénarios de déploiement utiles figurent le routage de débogage, les déploiements Canary, les tests A/B et les déploiements blue-green. (L’utilisation de ces quatre termes varie considérablement dans le secteur. Nous les employons ici selon notre compréhension de leurs définitions.)
- Cas d’utilisation : Je suis prêt à tester une nouvelle version en production
Solution : Routage de débogageImaginons que vous disposiez d’une application bancaire et que vous souhaitiez y ajouter une fonctionnalité de score de crédit. Avant de la tester auprès des clients, vous voudrez probablement vérifier son comportement en production. Le routage de débogage vous permet de la déployer publiquement tout en la « masquant » aux utilisateurs réels, en autorisant uniquement certains utilisateurs à y accéder selon des attributs de couche 7, tels qu’un cookie de session, un identifiant de session ou un identifiant de groupe. Par exemple, vous pouvez réserver l’accès aux utilisateurs disposant d’un cookie de session administrateur : leurs requêtes sont alors acheminées vers la nouvelle version intégrant la fonctionnalité de score de crédit, tandis que tous les autres utilisateurs continuent d’utiliser la version stable.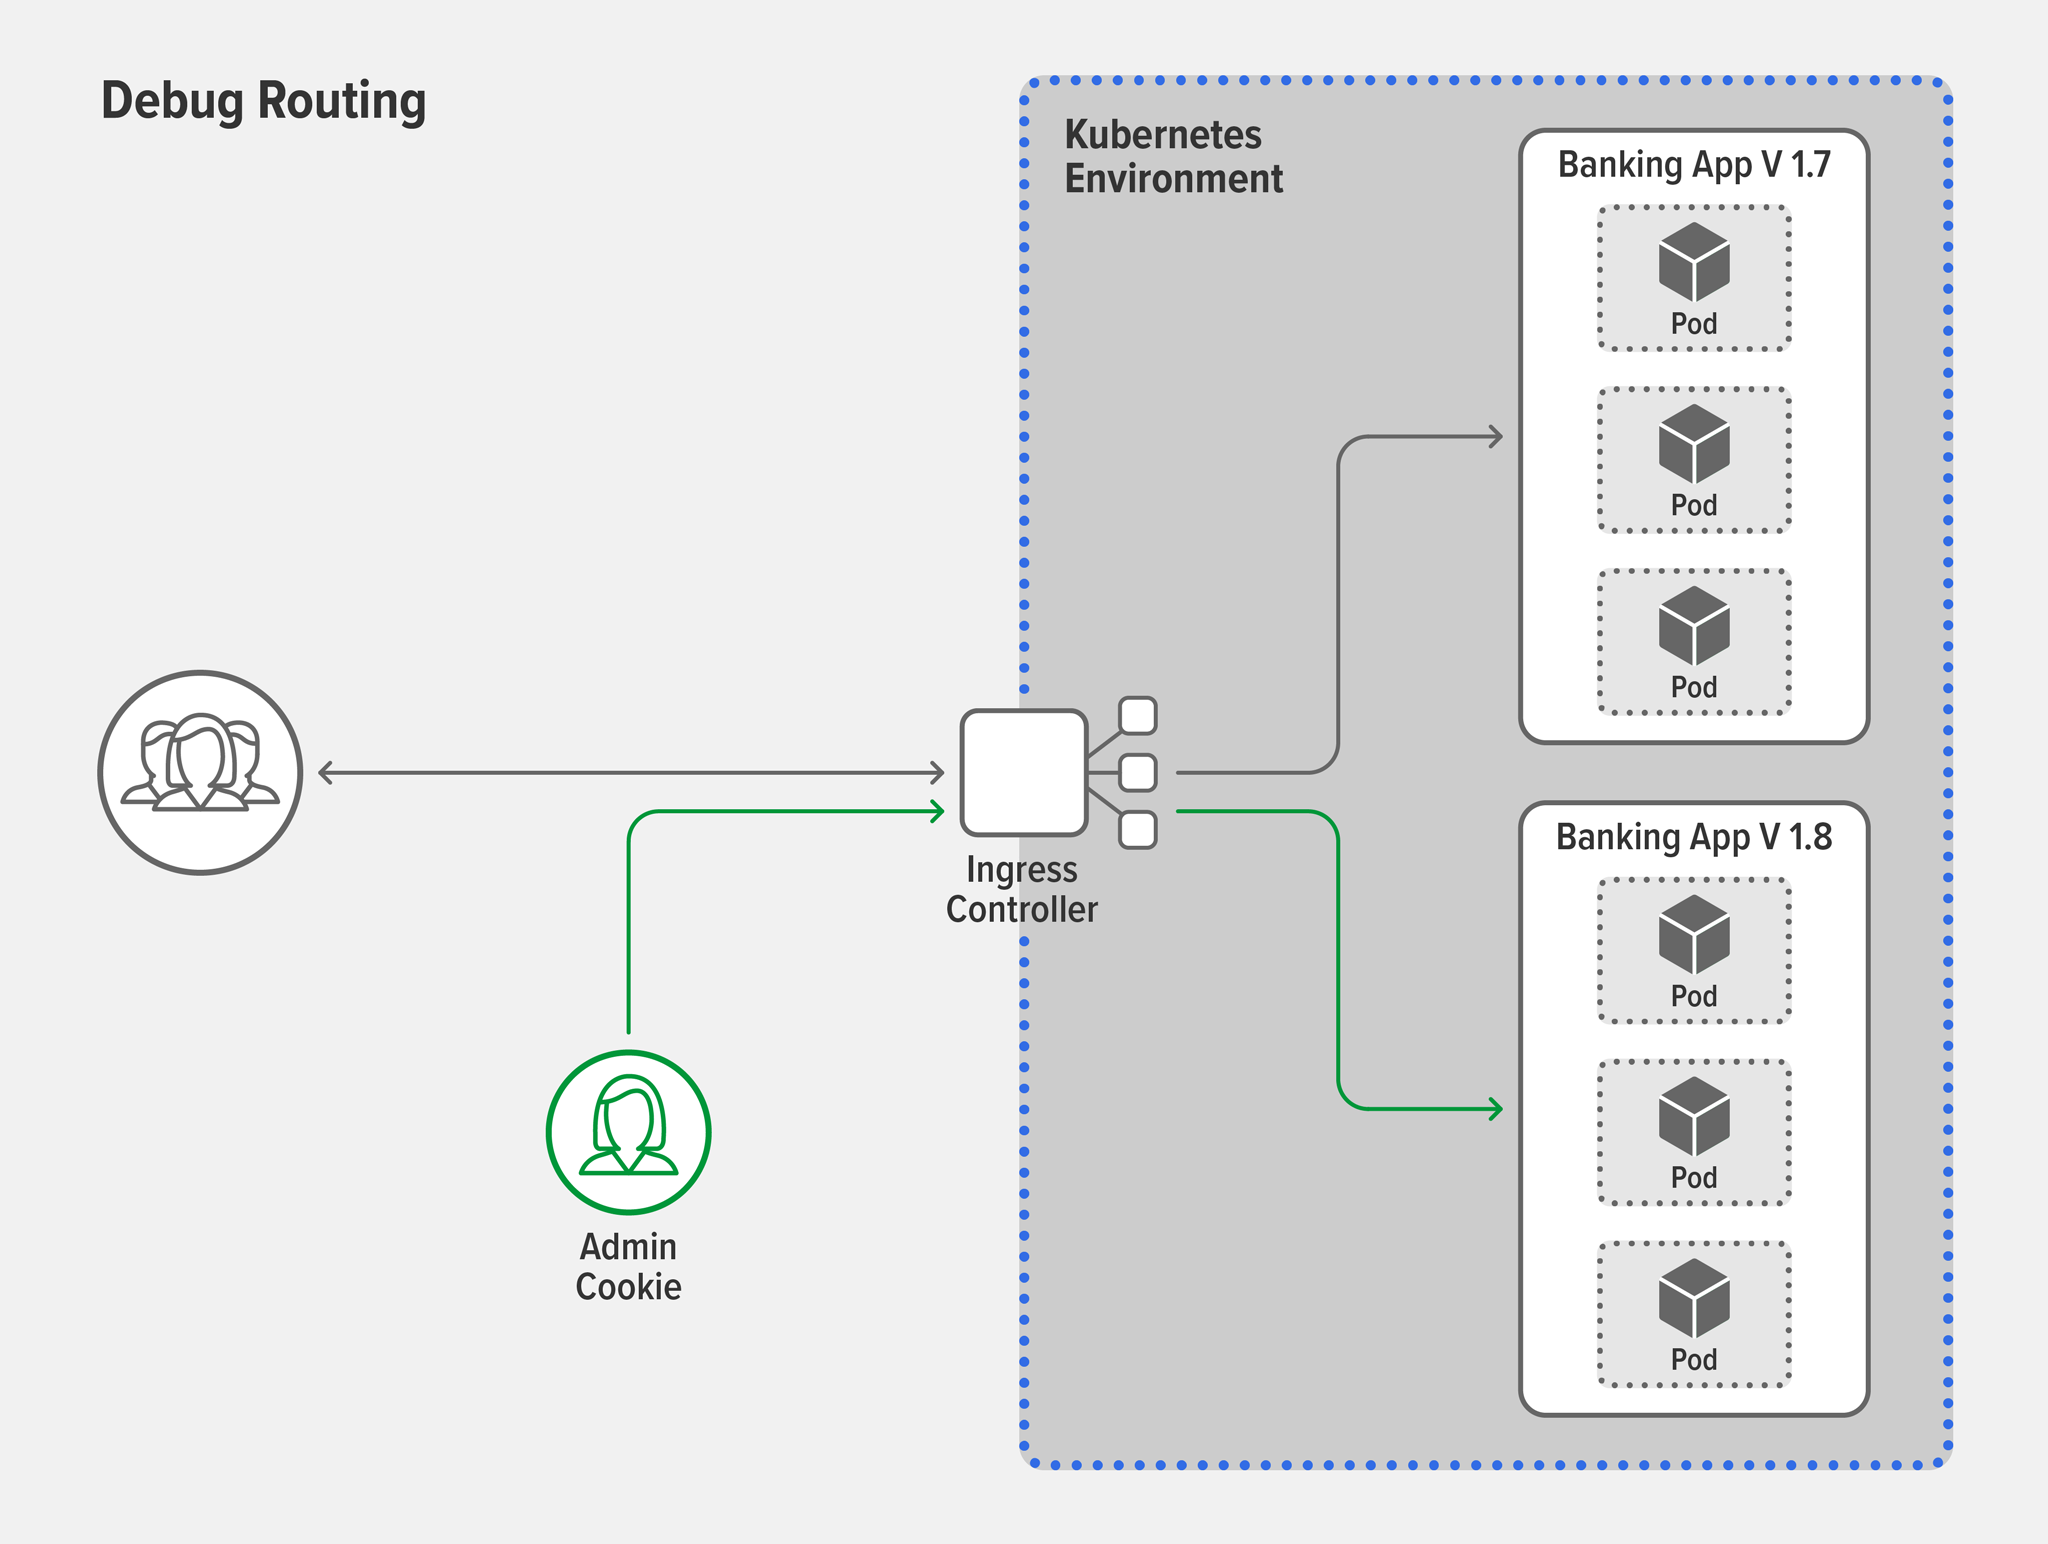
- Cas d’utilisation : Je dois m’assurer que ma nouvelle version est stable
Solution : Déploiement canariLe concept de déploiement canari est inspiré d’une ancienne pratique minière : les mineurs emportaient un canari en cage dans les mines de charbon afin d’être alertés rapidement de la présence de gaz toxiques. Le gaz tuait le canari avant les mineurs, ce qui leur permettait d’échapper rapidement au danger. Dans le monde des applications, aucun oiseau n’est maltraité ! Les déploiements canaris permettent de tester la stabilité d’une nouvelle fonctionnalité ou version de manière sûre et agile. Un déploiement canari classique commence par maintenir une grande majorité (par exemple, 99 %) de vos utilisateurs sur la version stable, tandis qu’un petit groupe (les 1 % restants) est redirigé vers la nouvelle version. Si celle-ci échoue, par exemple en plantant ou en renvoyant des erreurs aux clients, vous pouvez immédiatement réaffecter le groupe de test à la version stable. Si elle fonctionne correctement, vous pouvez faire passer les utilisateurs de la version stable à la nouvelle version, soit en une seule fois, soit, comme c’est généralement le cas, dans le cadre d’une migration progressive et contrôlée.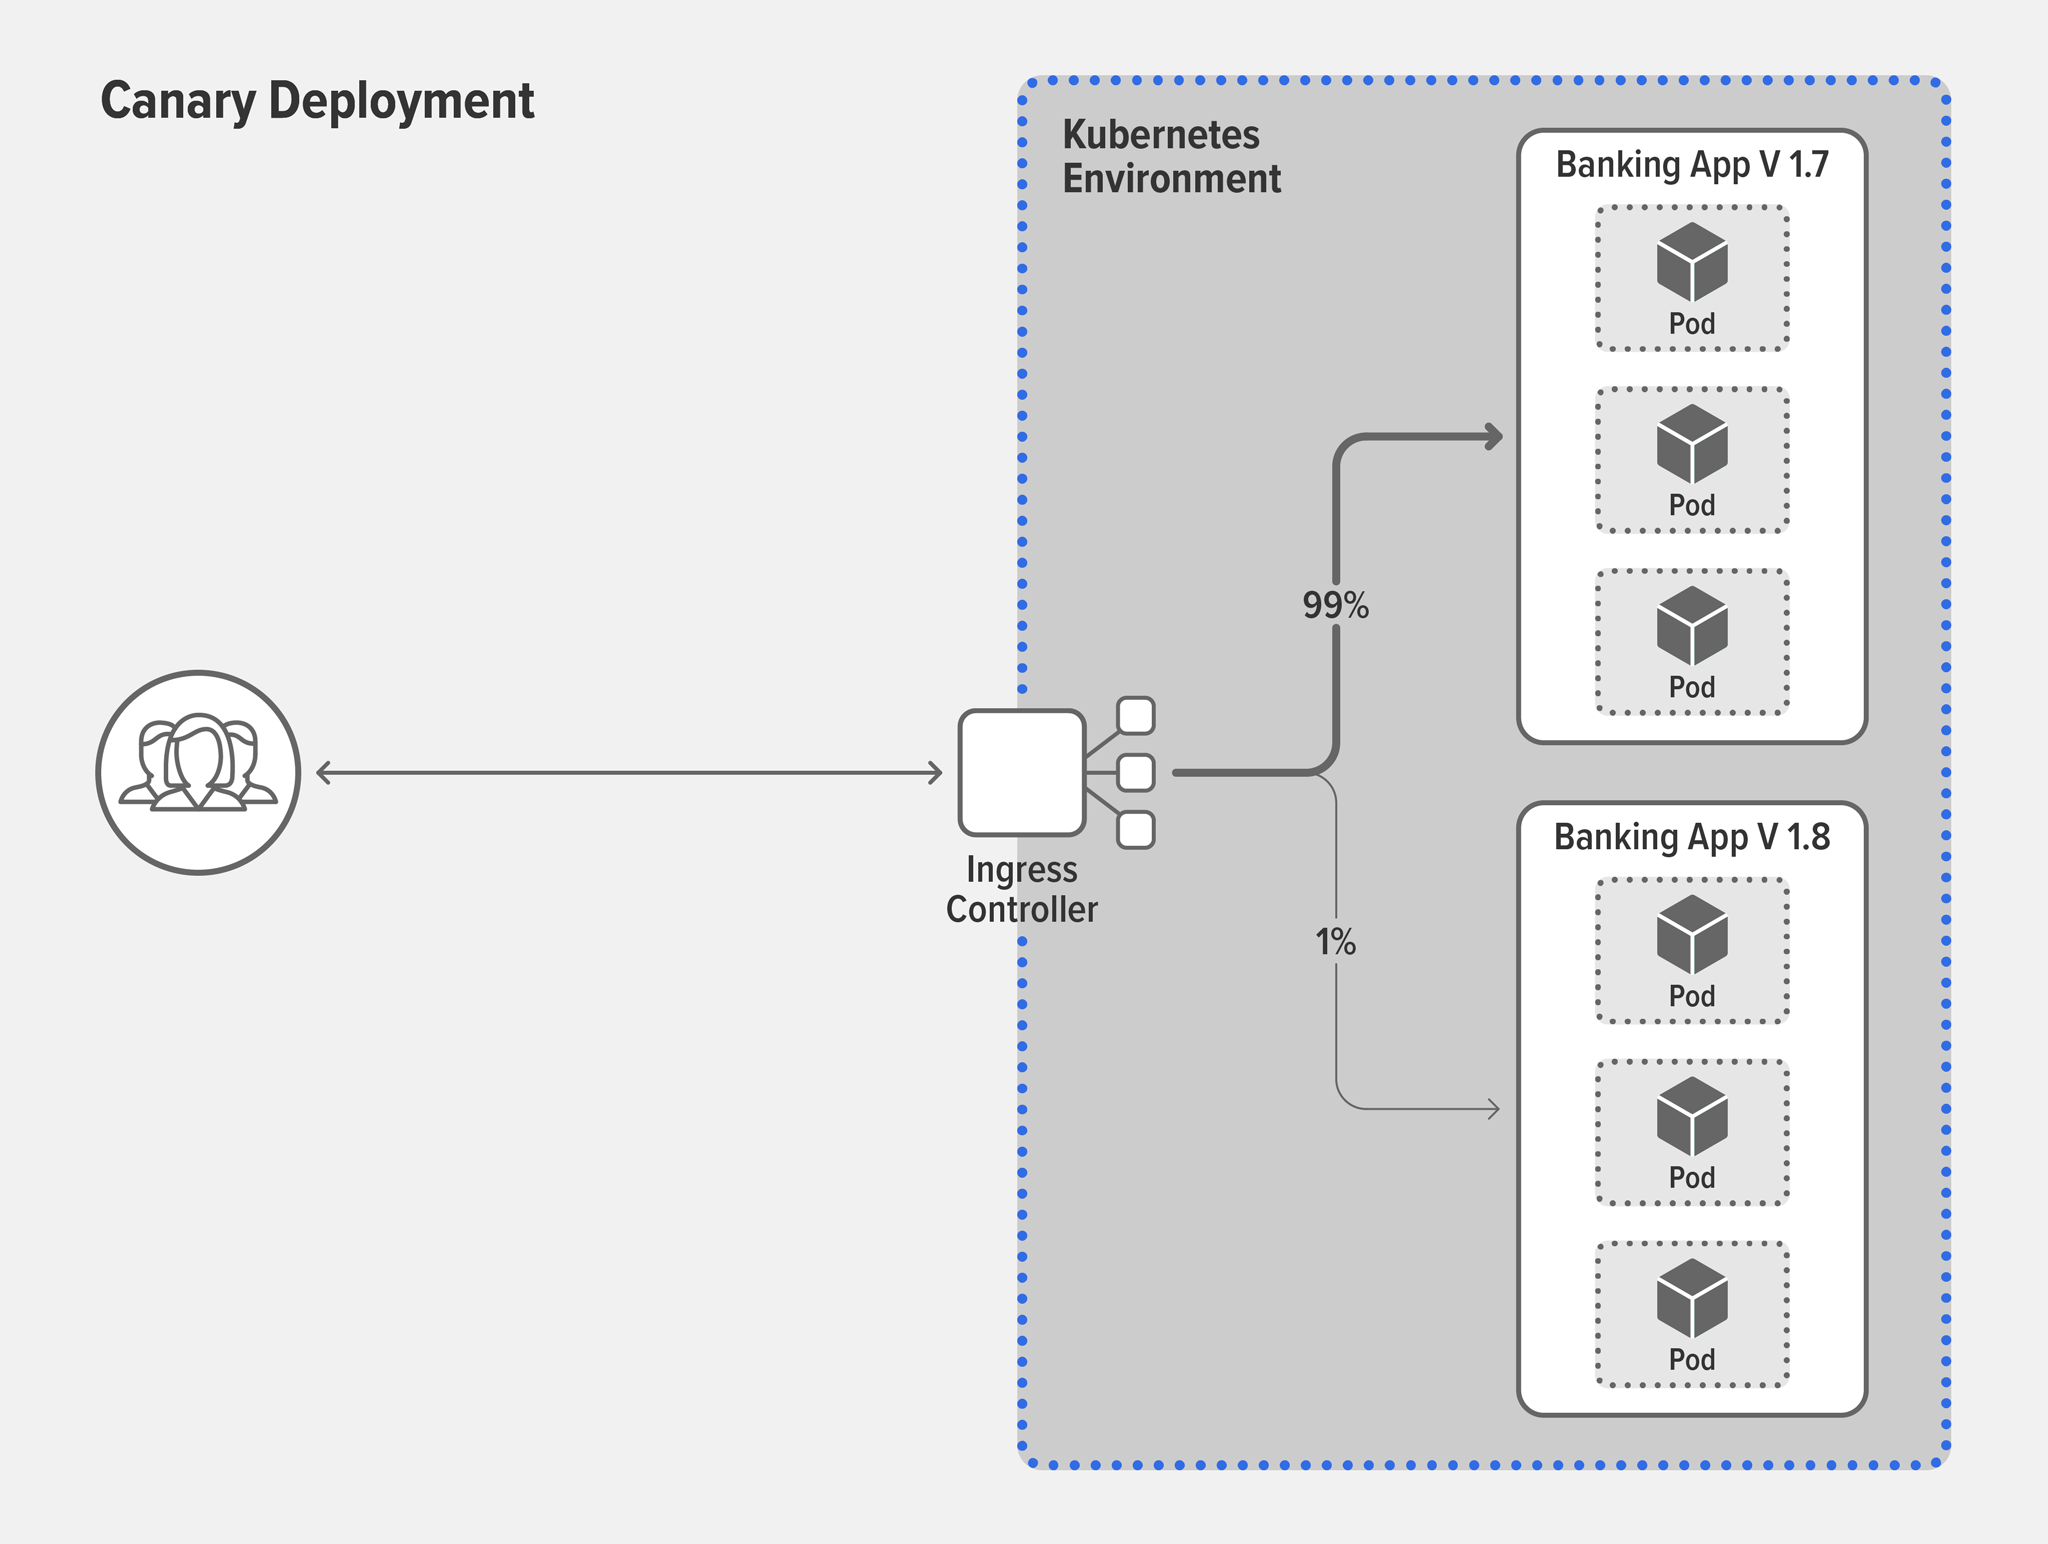
- Cas d’utilisation : Je dois déterminer si les clients préfèrent une nouvelle version à la version actuelle
Solution : Test A/BMaintenant que vous avez confirmé que votre nouvelle fonctionnalité fonctionne en production, vous souhaiterez peut-être recueillir l’avis des clients sur son succès en vous appuyant sur des indicateurs clés de performance (KPI), tels que le nombre de clics, le nombre d’utilisateurs récurrents ou les évaluations explicites. Le test A/B est un processus utilisé dans de nombreux secteurs pour mesurer et comparer le comportement des utilisateurs afin de déterminer le succès relatif de différentes versions d’un produit ou d’une application auprès de l’ensemble de la clientèle. Dans un test A/B classique, 50 % des utilisateurs accèdent à la version A (la version actuelle de l’application), tandis que les 50 % restants accèdent à la version B (la version intégrant la nouvelle fonctionnalité désormais stable). La version gagnante est celle qui obtient globalement les meilleurs KPI.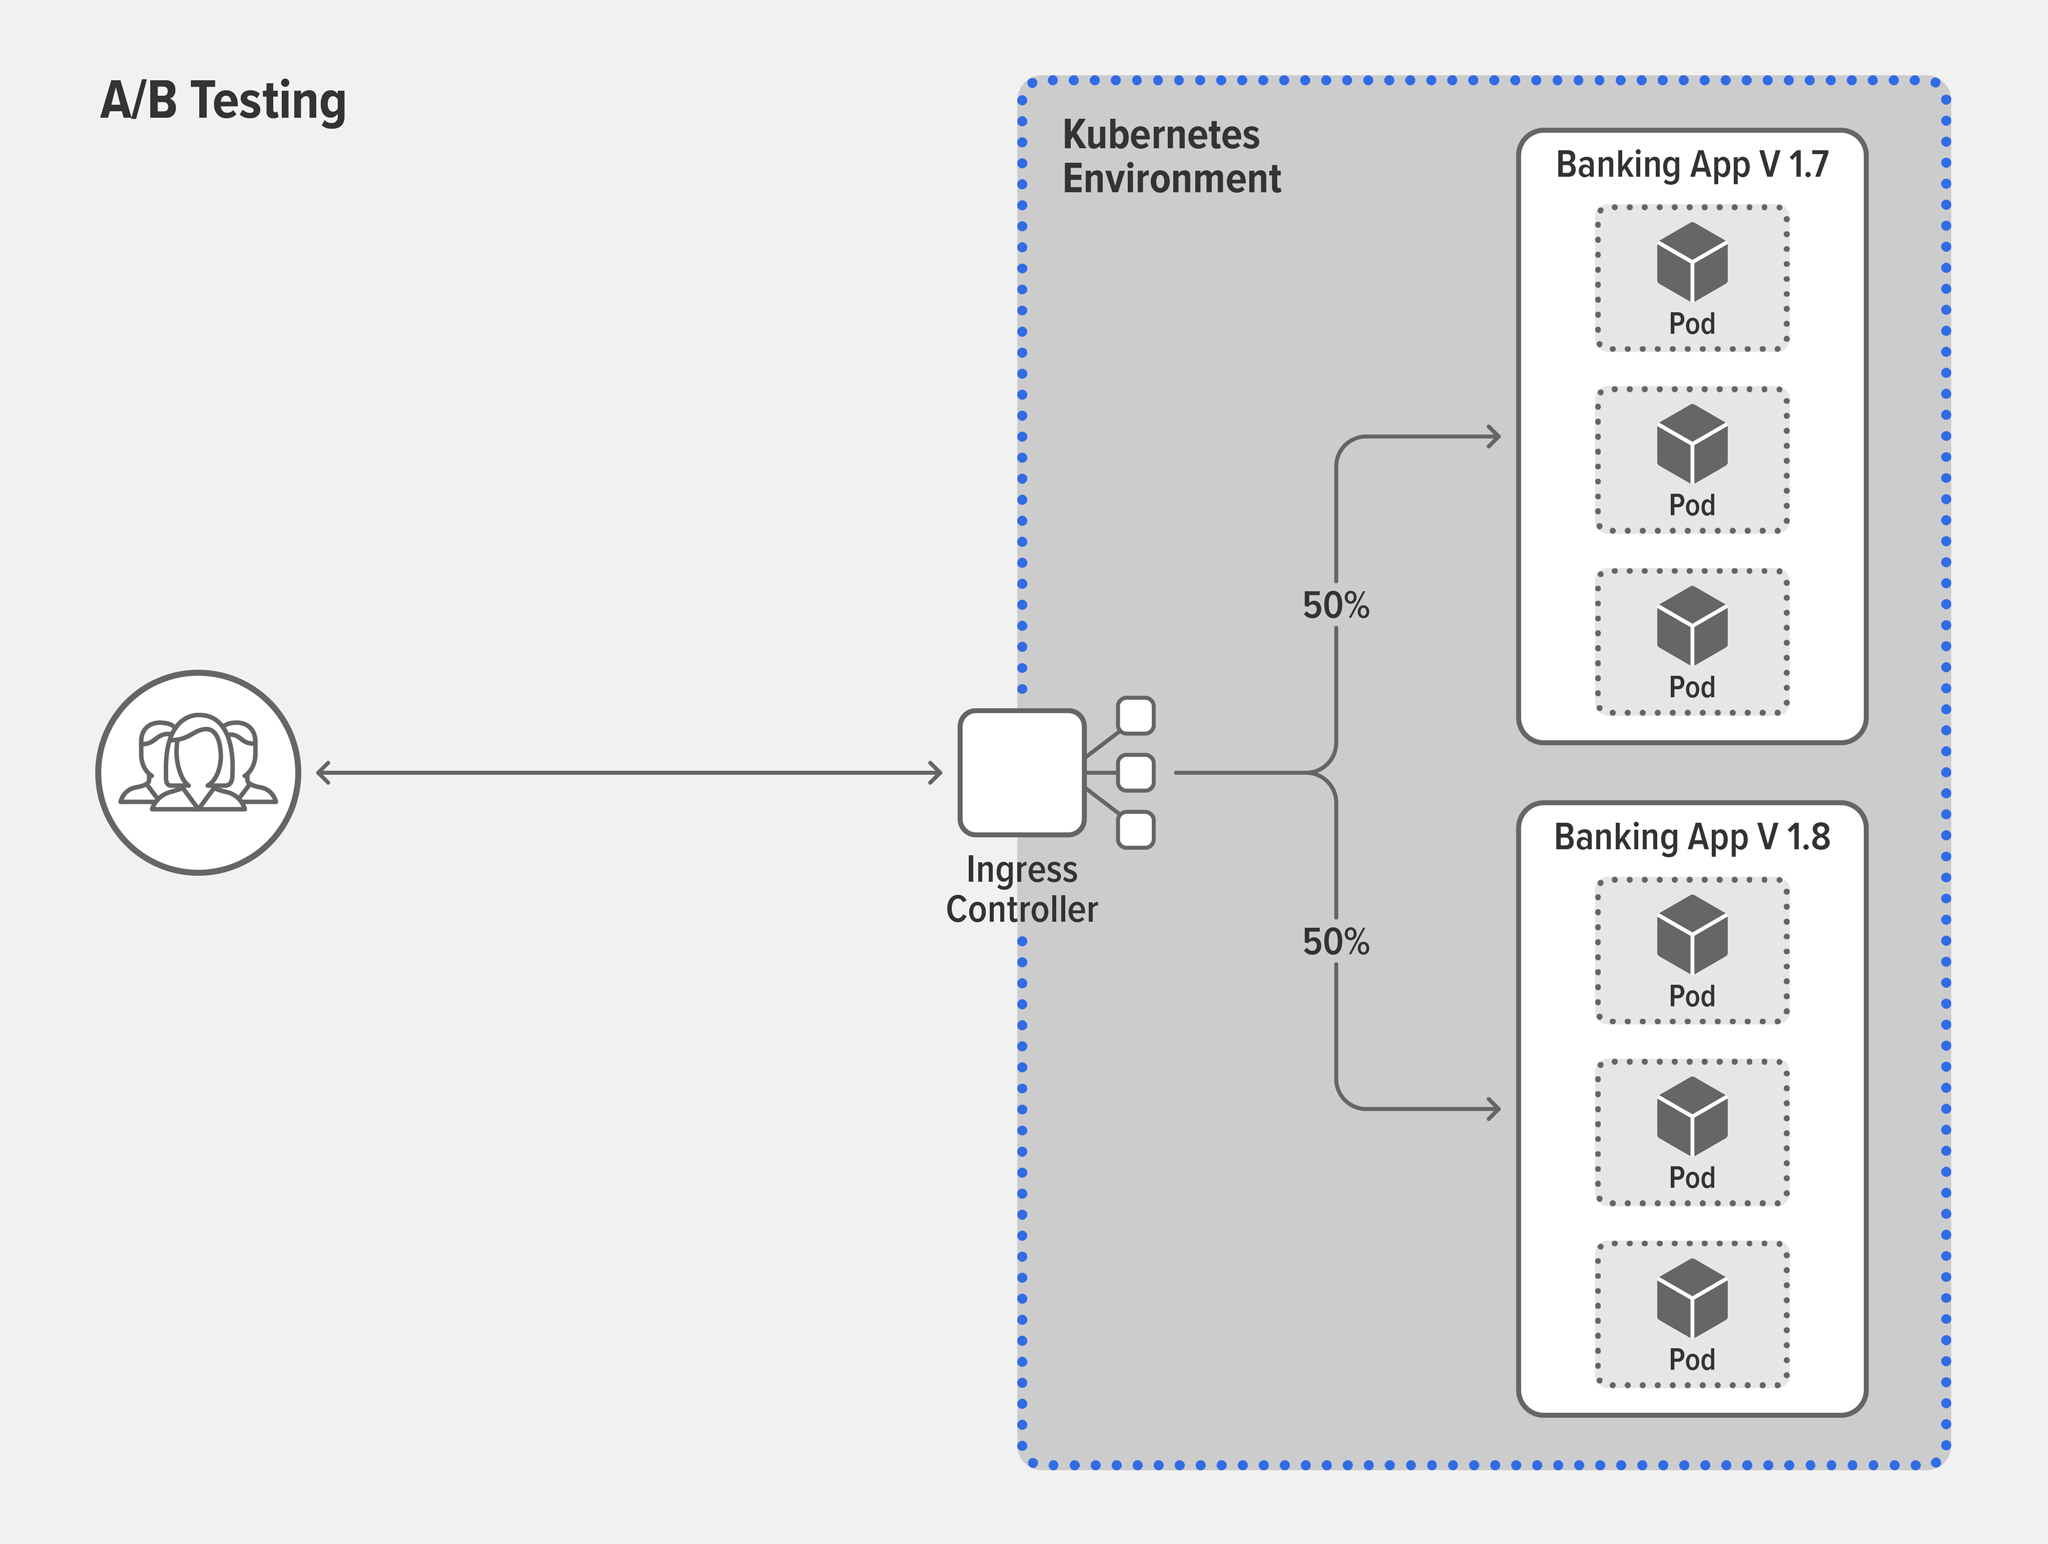
- Cas d’utilisation : Je souhaite faire migrer mes utilisateurs vers une nouvelle version sans interruption de service
Solution : Déploiement bleu-vertImaginons maintenant que votre application bancaire doive faire l’objet d’un changement de version majeur… félicitations ! Auparavant, les mises à niveau entraînaient généralement une interruption de service pour les utilisateurs, car il fallait arrêter l’ancienne version avant de mettre la nouvelle en production. Mais dans l’environnement concurrentiel actuel, les interruptions de service liées aux mises à niveau sont inacceptables pour la plupart des utilisateurs. Les déploiements bleu-vert réduisent considérablement, voire éliminent, ces interruptions. Il suffit de maintenir l’ancienne version (bleue) en production tout en déployant simultanément la nouvelle version (verte) à ses côtés, dans le même environnement de production. La plupart des organisations ne souhaitent pas faire passer 100 % des utilisateurs de la version bleue à la version verte en une seule fois : après tout, que se passerait-il si la version verte échouait ? La solution consiste à utiliser un déploiement canari pour migrer les utilisateurs par paliers adaptés à votre stratégie d’atténuation des risques. Si la nouvelle version s’avère catastrophique, vous pouvez facilement rétablir la version stable pour tous les utilisateurs en quelques frappes.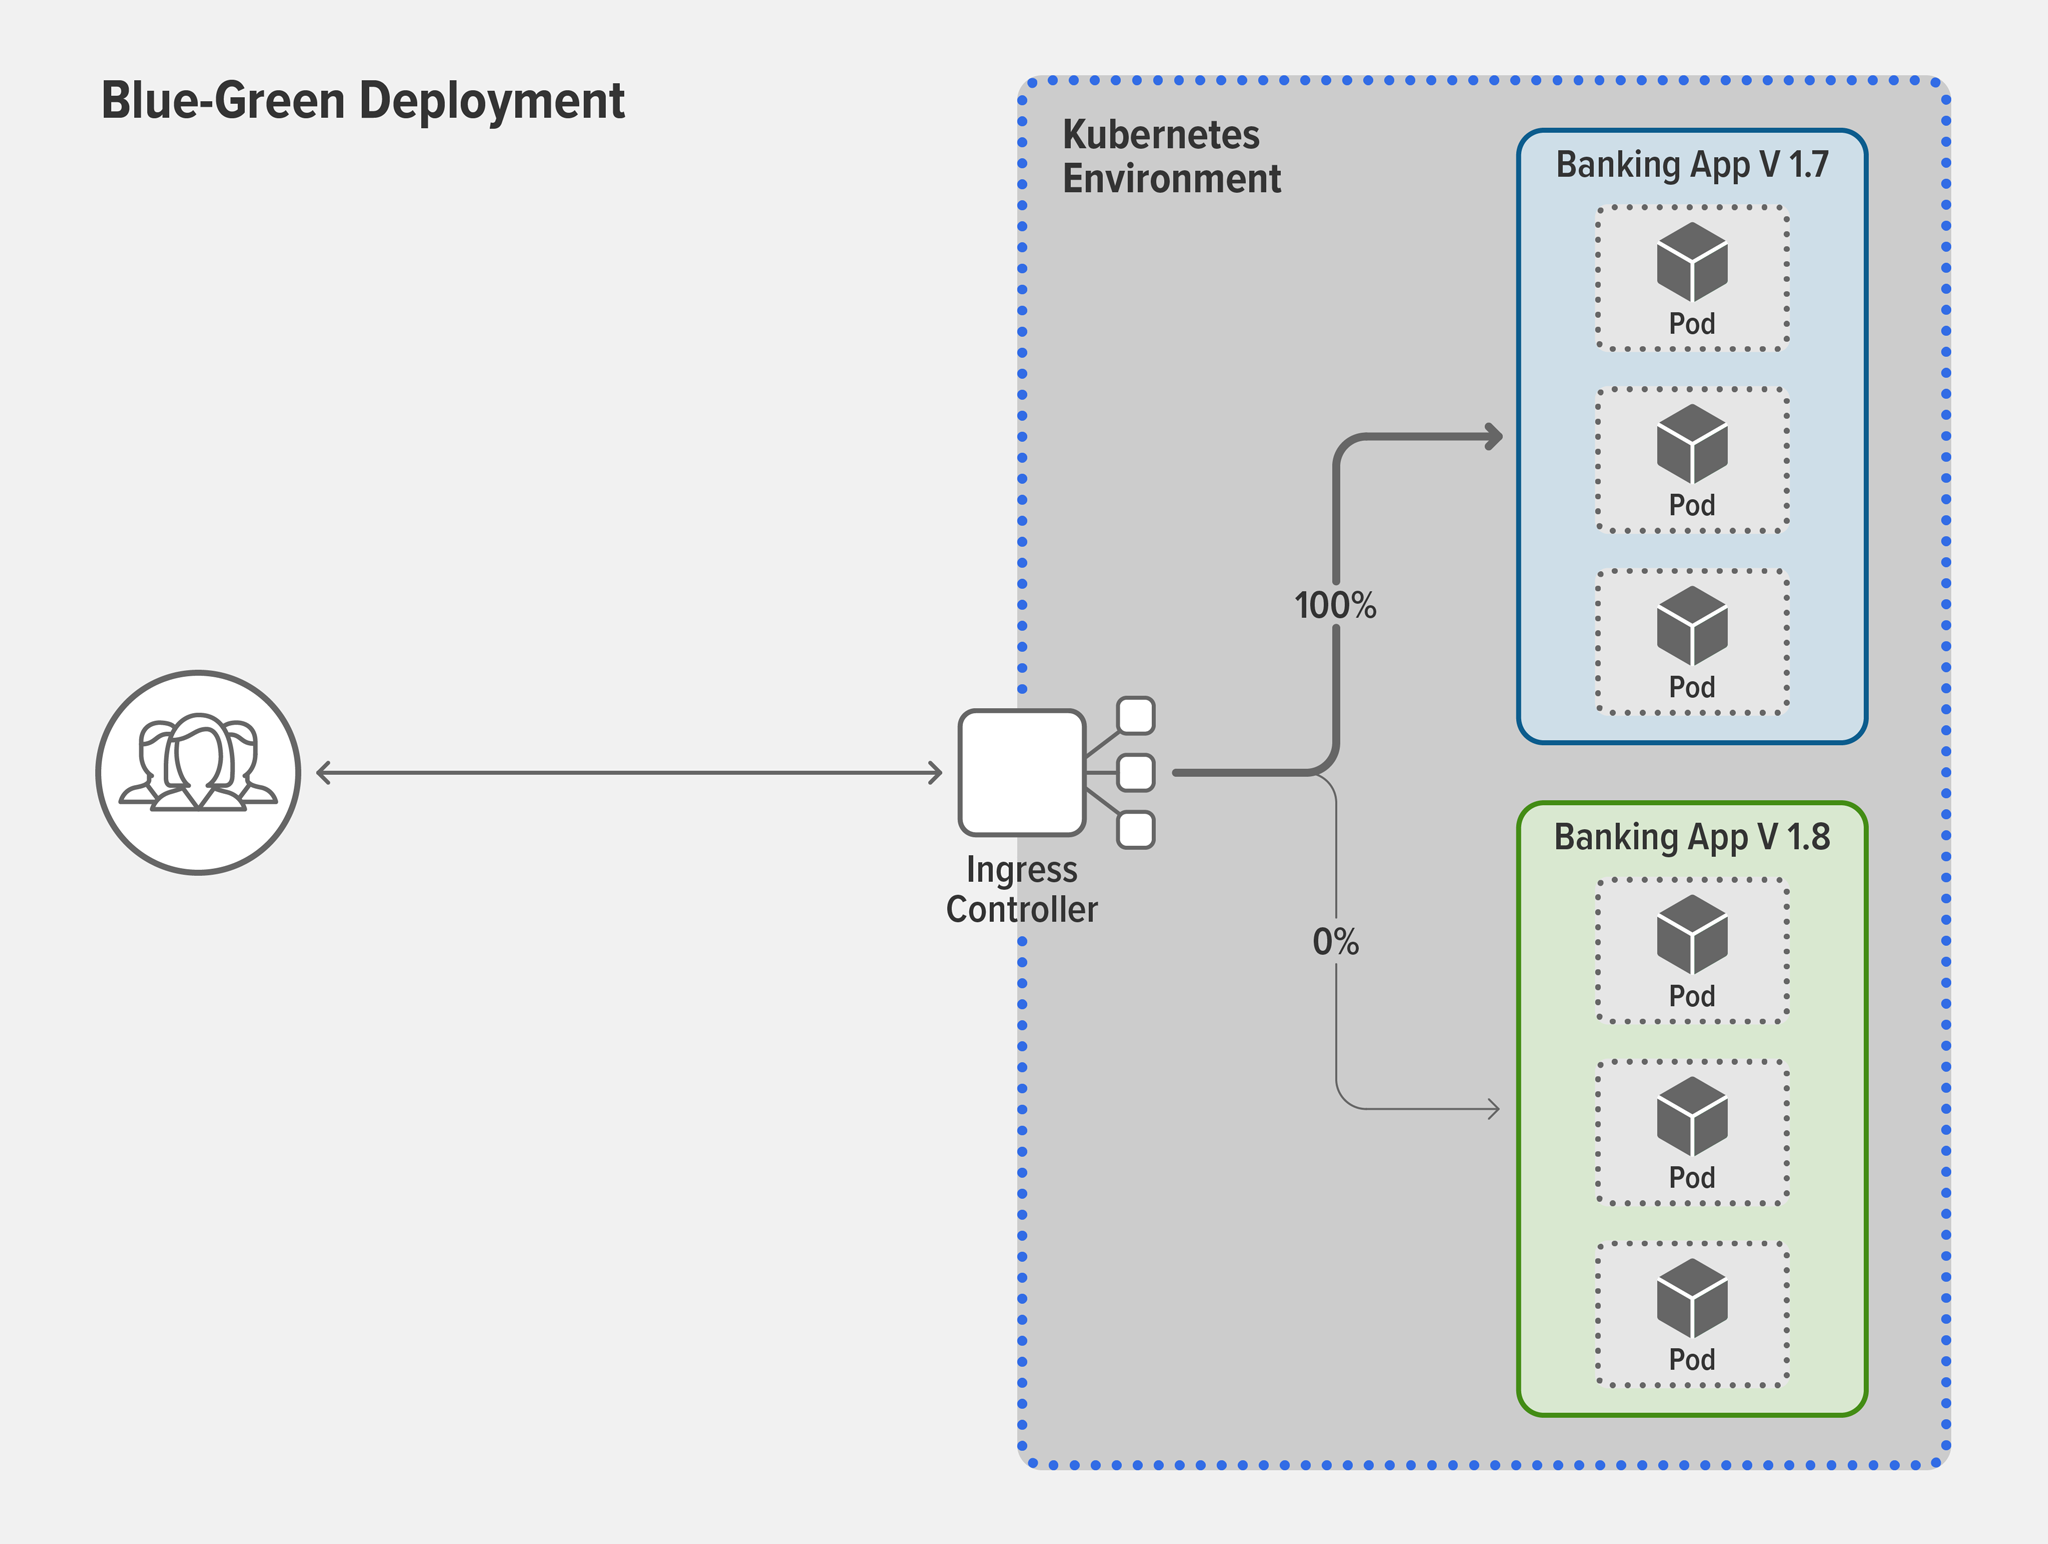
Comment NGINX peut vous aider
Vous pouvez mettre en œuvre une gestion et une répartition avancées du trafic avec la plupart des contrôleurs Ingress et des maillages de services. Le choix de la technologie dépend de l’architecture de votre application et de vos cas d’usage. Par exemple, l’utilisation d’un contrôleur Ingress est pertinente dans les trois scénarios suivants :
- Vos applications ne disposent que d’un seul point de terminaison, comme c’est le cas des applications simples ou des applications monolithiques que vous avez migrées telles quelles vers Kubernetes.
- Il n’y a aucune communication de service à service dans votre cluster.
- Il existe une communication entre les services, mais vous n’utilisez pas encore de maillage de services.
Si votre déploiement est suffisamment complexe pour nécessiter un maillage de services, un cas d’usage courant consiste à répartir le trafic entre les services afin de tester ou de mettre à niveau certains microservices. Par exemple, vous pourriez effectuer un déploiement canari derrière votre interface mobile, entre deux versions différentes de l’API de votre microservice de géolocalisation.
Cependant, la configuration de la répartition du trafic avec certains contrôleurs Ingress et maillages de services peut être chronophage et sujette aux erreurs, et ce, pour diverses raisons :
- Les contrôleurs Ingress et les maillages de services de différents fournisseurs implémentent les fonctionnalités de Kubernetes de différentes manières.
- Kubernetes n’est pas vraiment conçu pour gérer et comprendre le trafic de couche 7.
- Certains contrôleurs Ingress et maillages de services ne prennent pas en charge la gestion avancée du trafic.
Avec NGINX Ingress Controller et NGINX Service Mesh, vous pouvez facilement configurer en quelques secondes des stratégies robustes de routage et de répartition du trafic. Regardez cette démonstration en direct avec nos experts et poursuivez votre lecture pour découvrir comment nous vous faisons gagner du temps grâce à des configurations simplifiées, des personnalisations avancées et une meilleure visibilité.
Configuration simplifiée grâce aux ressources Ingress de NGINX et à la spécification SMI
Ces fonctionnalités de NGINX facilitent la configuration :
- Ressources NGINX Ingress pour NGINX Ingress Controller – Bien que la ressource Ingress standard de Kubernetes facilite la configuration de la terminaison SSL/TLS, de l’équilibrage de charge HTTP et du routage de couche 7, elle n’offre pas les fonctionnalités de personnalisation nécessaires à la mise en place de disjoncteurs, de tests A/B et de déploiements bleu-vert. Les utilisateurs qui n’utilisent pas NGINX doivent donc recourir à des annotations, des ConfigMaps et des modèles personnalisés, qui n’offrent aucun contrôle précis, ne sont pas sécurisés, sont sujets aux erreurs et sont difficiles à utiliser. NGINX Ingress Controller propose les ressources NGINX Ingress comme alternative à la ressource Ingress standard (qu’il prend également en charge). Elles offrent un style de configuration natif, avec vérification des types et indentation, qui simplifie la mise en œuvre de l’équilibrage de charge Ingress. Les ressources NGINX Ingress présentent un avantage supplémentaire pour les utilisateurs actuels de NGINX : elles facilitent la réutilisation des configurations d’équilibrage de charge provenant d’environnements non-Kubernetes, afin que tous vos équilibreurs de charge NGINX puissent utiliser les mêmes configurations.
- NGINX Service Mesh avec SMI – NGINX Service Mesh implémente la Service Mesh Interface (SMI), une spécification qui définit une interface standard pour les maillages de services sur Kubernetes, avec des ressources typées telles que
TrafficSplit,TrafficTargetetHTTPRouteGroup. En utilisant les méthodes de configuration Kubernetes standard, NGINX Service Mesh et les extensions SMI de NGINX facilitent le déploiement de stratégies de répartition du trafic, telles que les déploiements Canary, tout en limitant au minimum les interruptions du trafic de production. Par exemple, voici comment définir un déploiement Canary avec NGINX Service Mesh :
apiVersion: split.smi-spec.io/v1alpha2kind: TrafficSplit
metadata:
name: target-ts
spec:
service: target-svc
backends:
- service: target-v1-0
    weight: 90
- service: target-v2-0
weight: 10- Notre tutoriel, « Déploiements avec répartition du trafic », présente des exemples de modèles de déploiement qui tirent parti de la répartition du trafic, notamment les déploiements Canary et bleu-vert.
Contrôle et répartition du trafic plus sophistiqués grâce à des personnalisations avancées
Ces fonctionnalités de NGINX permettent de contrôler et de répartir facilement le trafic de manière avancée :
- Le magasin clé-valeur pour les déploiements Canary – Lorsque vous effectuez des tests A/B ou des déploiements bleu-vert, vous pouvez souhaiter faire basculer le trafic vers la nouvelle version par paliers précis, par exemple 0 %, 5 %, 10 %, 25 %, 50 % et 100 %. Avec la plupart des outils, ce processus est très manuel, car vous devez modifier le pourcentage et recharger le fichier de configuration à chaque palier. Compte tenu de ces contraintes, vous pourriez décider de prendre le risque de passer directement de 5 % à 100 %. Toutefois, avec la version de NGINX Ingress Controller basée sur NGINX Plus, vous pouvez utiliser le magasin clé-valeur pour modifier les pourcentages sans avoir à recharger la configuration.
- Disjonction avec NGINX Ingress Controller – Les disjoncteurs sophistiqués permettent de gagner du temps et d’améliorer la résilience en détectant plus rapidement les défaillances et en déclenchant un basculement, voire en activant des pages d’erreur personnalisées et mises en forme pour les serveurs en amont défaillants. Par exemple, un disjoncteur associé à un service de recherche peut être configuré pour renvoyer un ensemble de résultats de recherche vide, mais correctement mis en forme. Pour atteindre ce niveau de sophistication, la version de NGINX Ingress Controller basée sur NGINX Plus utilise des contrôles d’intégrité actifs qui surveillent de manière proactive l’état de vos serveurs TCP et UDP en amont. Grâce à cette surveillance en temps réel, vos clients seront moins susceptibles d’utiliser des applications qui renvoient des erreurs.
- Disjonction avec NGINX Service Mesh – La spécification de disjoncteur de NGINX Service Mesh circuit breaker spec comporte trois champs personnalisés : tandis que
errorsettimeoutSecondssont des fonctionnalités standard des disjoncteurs,fallbackrenforce davantage la résilience en vous permettant de définir un serveur de secours. Si les réponses de votre serveur de secours sont spécifiques, elles peuvent constituer un indicateur précoce de problèmes dans votre cluster, ce qui vous permet de commencer immédiatement le dépannage.errors– Le nombre d’erreurs avant le déclenchement du disjoncteurtimeoutSeconds– La fenêtre de temps pendant laquelle les erreurs doivent se produire avant le déclenchement du circuit, ainsi que le délai d’attente avant la fermeture du circuitfallback– Le nom et le port du service Kubernetes vers lequel le trafic est redirigé après le déclenchement du circuit
Interpréter les résultats de la répartition du trafic à l’aide de tableaux de bord
Vous avez mis en œuvre la répartition du trafic… et maintenant ? Il est temps d’analyser les résultats. Cette étape peut être la plus difficile, car de nombreuses organisations ne disposent pas d’informations essentielles sur les performances de leur trafic Kubernetes et de leurs applications. NGINX facilite l’obtention de ces informations grâce au tableau de bord NGINX Plus et à des tableaux de bord Grafana prédéfinis qui permettent de visualiser les métriques exposées par Prometheus Exporter. Pour savoir comment améliorer la visibilité afin d’obtenir des informations pertinentes, consultez l’article Comment améliorer la visibilité dans Kubernetes sur notre blog.
Maîtrisez les microservices avec NGINX
Le contrôleur Ingress NGINX basé sur NGINX Plus est disponible dans le cadre d’un essai gratuit de 30 jours qui inclut NGINX App Protect afin de sécuriser vos applications conteneurisées.
Pour essayer NGINX Ingress Controller avec NGINX Open Source, vous pouvez obtenir le code source de la version, ou télécharger une image de conteneur précompilée depuis DockerHub.
NGINX Service Mesh, toujours gratuit, est disponible en téléchargement sur f5.com.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.