Rédaction – Cet article fait partie d’une série en 10 volets :
- Réduisez la complexité grâce à Kubernetes prêt pour la production
- Comment améliorer la résilience dans Kubernetes grâce à une gestion avancée du trafic
- Comment améliorer la visibilité dans Kubernetes
- Six façons de sécuriser Kubernetes à l’aide d’outils de gestion du trafic (cet article)
- Guide pour choisir un contrôleur Ingress, 1re partie : identifiez vos besoins
- Guide pour choisir un contrôleur Ingress, 2e partie : risques et pérennisation
- Guide pour choisir un contrôleur Ingress, 3e partie : open source, par défaut ou commercial
- Guide pour choisir un contrôleur Ingress, 4e partie : les options du contrôleur Ingress NGINX
- Comment choisir un maillage de services
- Tests de performance des contrôleurs Ingress NGINX dans un environnement cloud Kubernetes dynamique
Vous pouvez également télécharger l’intégralité de cette série d’articles sous forme d’e-book gratuit : « Faire passer Kubernetes des tests à la production ».
Comme indiqué dans « Sécuriser les applications cloud natives sans perdre en rapidité », nous avons identifié trois facteurs qui rendent les applications cloud natives plus difficiles à sécuriser que les applications traditionnelles :
- La livraison d’applications cloud natives entraîne une prolifération des outils et fournit des services de niveau entreprise incohérents
- Les coûts de déploiement des applications cloud natives peuvent être élevés et imprévisibles
- Les équipes SecOps peinent à protéger les applications cloud natives et sont en désaccord avec les équipes DevOps
Bien que ces trois facteurs puissent avoir un impact équivalent sur la sécurité, le troisième peut être le problème le plus difficile à résoudre, peut-être parce qu’il est le plus « humain ». Lorsque les équipes SecOps ne sont pas en mesure de protéger les applications cloud natives ou n’en ont pas les moyens, certaines conséquences sont évidentes (vulnérabilités et failles de sécurité), tandis que d’autres sont moins visibles, notamment une perte d’agilité et une transformation numérique au point mort.
Examinons plus en détail ces coûts cachés. Les organisations choisissent Kubernetes pour sa promesse d’agilité et de réduction des coûts. Mais lorsque des incidents de sécurité surviennent dans un environnement Kubernetes, la plupart des organisations retirent leurs déploiements Kubernetes de la production. Cela ralentit les initiatives de transformation numérique essentielles à l’avenir de l’organisation, sans parler du gaspillage d’argent et des efforts d’ingénierie. La conclusion logique est la suivante : si vous souhaitez faire passer Kubernetes de la phase de test à la production, la sécurité doit être considérée comme une composante stratégique dont la responsabilité incombe à tous les membres de l’organisation.
Dans cet article, nous présentons six cas d’usage de sécurité auxquels vous pouvez répondre grâce aux outils de gestion du trafic Kubernetes, permettant ainsi aux équipes SecOps de collaborer avec les équipes DevOps et NetOps afin de mieux protéger vos applications et API cloud natives. Ces techniques sont souvent combinées pour créer une stratégie de sécurité complète visant à protéger les applications et les API tout en réduisant au minimum l’impact sur les clients.
- Corrigez rapidement les CVE pour éviter les cyberattaques
- Bloquez les attaques du Top 10 de l’OWASP et les attaques par déni de service
- Déchargez les applications de l’authentification et de l’autorisation
- Mettez en place le libre-service avec des garde-fous
- Mettre en œuvre le chiffrement de bout en bout
- Veillez à ce que les clients utilisent un algorithme de chiffrement robuste reposant sur une implémentation fiable
Terminologie de la sécurité et de l’identité
Avant de passer aux cas d’usage, voici un bref aperçu de quelques termes liés à la sécurité et à l’identité que vous rencontrerez tout au long de cet article.
- Authentification et autorisation – Fonctions nécessaires pour garantir que seuls les utilisateurs et services « autorisés » puissent accéder aux systèmes back-end ou aux composants de l’application :
- Authentification – Vérification de l’identité afin de s’assurer que les clients qui envoient des requêtes sont bien ceux qu’ils prétendent être. Cette vérification s’effectue au moyen de jetons d’identité, tels que des mots de passe ou des jetons web JSON (JWT).
- Autorisation – Vérification de l’autorisation d’accéder à une ressource ou à une fonction. Elle s’effectue au moyen de jetons d’accès, tels que des attributs de couche 7 comme les cookies de session, les identifiants de session, les identifiants de groupe ou le contenu des jetons.
- Vulnérabilités et expositions critiques (CVE) – Une base de données recensant les failles rendues publiques « dans un composant logiciel, micrologiciel, matériel ou de service, résultant d’une faiblesse susceptible d’être exploitée et d’avoir des répercussions négatives sur la confidentialité, l’intégrité ou la disponibilité d’un ou de plusieurs composants affectés » (https://www.cve.org/). Les CVE peuvent être découvertes par les développeurs chargés de l’outil, un testeur d’intrusion, un utilisateur ou un client, ou encore un membre de la communauté (tel qu’un « chasseur de bugs »). Il est courant de laisser au propriétaire du logiciel le temps de développer un correctif avant de rendre la vulnérabilité publique, afin de ne pas avantager les acteurs malveillants.
- Attaque par déni de service (DoS) – Une attaque au cours de laquelle un acteur malveillant submerge un site web de requêtes (TCP/UDP ou HTTP/HTTPS) dans le but de le faire tomber en panne. Les attaques DoS affectant la disponibilité, elles nuisent principalement à la réputation de la cible. Une attaque par déni de service distribué (DDoS), dans laquelle plusieurs sources ciblent le même réseau ou service, est plus difficile à contrer en raison du nombre potentiellement élevé d’attaquants. La protection contre les attaques DoS nécessite un outil capable de les détecter et de les bloquer de manière adaptative. Pour en savoir plus, consultez Qu’est-ce qu’une attaque par déni de service distribué (DDoS) ?
- Chiffrement de bout en bout (E2EE) – Pratique consistant à chiffrer intégralement les données lors de leur transfert de l’utilisateur vers l’application, puis de l’application vers l’utilisateur. L’E2EE nécessite des certificats SSL et, éventuellement, le protocole mTLS.
- TLS mutuel (mTLS) – Pratique consistant à exiger une authentification (au moyen d’un certificat SSL/TLS) à la fois pour le client et pour l’hôte. L’utilisation de mTLS protège également la confidentialité et l’intégrité des données échangées entre le client et l’hôte. mTLS peut être mis en œuvre jusqu’au niveau des pods Kubernetes, entre deux services d’un même cluster. Pour une excellente introduction à SSL/TLS et à mTLS, consultez Qu’est-ce que mTLS ? sur F5 Labs.
- Authentification unique (SSO) – Les technologies SSO (notamment SAML, OAuth et OIDC) facilitent la gestion de l’authentification et des autorisations.
- Authentification simplifiée – Le SSO évite à l’utilisateur d’avoir besoin d’un jeton d’identification unique pour chaque ressource ou fonction.
- Autorisation standardisée – Le SSO facilite la définition des droits d’accès des utilisateurs en fonction de leur rôle, de leur service et de leur niveau hiérarchique, évitant ainsi d’avoir à configurer les autorisations de chaque utilisateur individuellement.
- SSL (Secure Sockets Layer)/TLS (Transport Layer Security) – Un protocole permettant d’établir des liaisons authentifiées et chiffrées entre des ordinateurs en réseau. Les certificats SSL/TLS authentifient l’identité d’un site web et établissent une connexion chiffrée. Bien que le protocole SSL ait été abandonné en 1999 et remplacé par le protocole TLS, il est encore courant de désigner ces technologies connexes par « SSL » ou « SSL/TLS ». Par souci de cohérence, nous utiliserons SSL/TLS dans la suite de cet article.
- Pare-feu d’application web (WAF) – Un proxy inverse qui détecte et bloque les attaques sophistiquées visant les applications et les API (notamment celles du Top 10 de l’OWASP et d’autres menaces avancées), tout en laissant passer le trafic « sûr ». Les WAF protègent contre les attaques qui tentent de nuire à la cible en dérobant des données sensibles ou en prenant le contrôle du système. Certains fournisseurs regroupent la protection WAF et la protection contre les attaques DoS dans un même outil, tandis que d’autres proposent des outils distincts pour chacune de ces protections.
- Zero Trust – Un concept de sécurité fréquemment utilisé dans les organisations ayant des exigences élevées en matière de sécurité, mais qui s’applique à tous, selon lequel les données doivent être sécurisées à chaque étape de leur stockage et de leur transport. Cela signifie que l’organisation a décidé de ne faire « confiance » par défaut à aucun utilisateur ni appareil, mais d’exiger au contraire que l’ensemble du trafic soit rigoureusement contrôlé. Une architecture Zero Trust associe généralement l’authentification, l’autorisation et le mTLS, et il est fort probable que l’organisation mette également en œuvre le chiffrement de bout en bout (E2EE).
Cas d’usage : corriger rapidement les CVE pour éviter les cyberattaques
Solution : Utilisez des outils qui envoient des notifications de correctifs rapides et proactives
Selon une étude du Ponemon Institute, en 2019, le « délai de grâce » moyen entre la publication d’un correctif pour une vulnérabilité critique ou hautement prioritaire et l’apparition d’attaques visant à exploiter cette vulnérabilité était de 43 jours. Chez F5 NGINX, nous avons constaté que ce délai s’est considérablement raccourci au cours des années suivantes (jusqu’à atteindre le jour zéro dans le cas d’Apple iOS 15 en 2021), c’est pourquoi nous recommandons d’appliquer les correctifs dès que possible. Mais que faire si les correctifs pour vos outils de gestion du trafic ne sont disponibles que plusieurs semaines, voire plusieurs mois, après l’annonce d’une CVE ?
Les outils développés et maintenus par des contributeurs de la communauté (plutôt que par une équipe d’ingénieurs dédiée) peuvent accuser un retard de plusieurs semaines, voire de plusieurs mois, par rapport aux annonces de CVE, ce qui rend peu probable l’application des correctifs par les entreprises dans ce délai de 43 jours. Dans un cas, OpenResty a mis quatre mois à appliquer un correctif de sécurité lié à NGINX. Tous les utilisateurs d’un contrôleur Ingress basé sur OpenResty sont donc restés vulnérables pendant au moins quatre mois. En pratique, il faut généralement compter un délai supplémentaire avant que les correctifs ne soient disponibles pour les logiciels qui dépendent d’un projet open source.
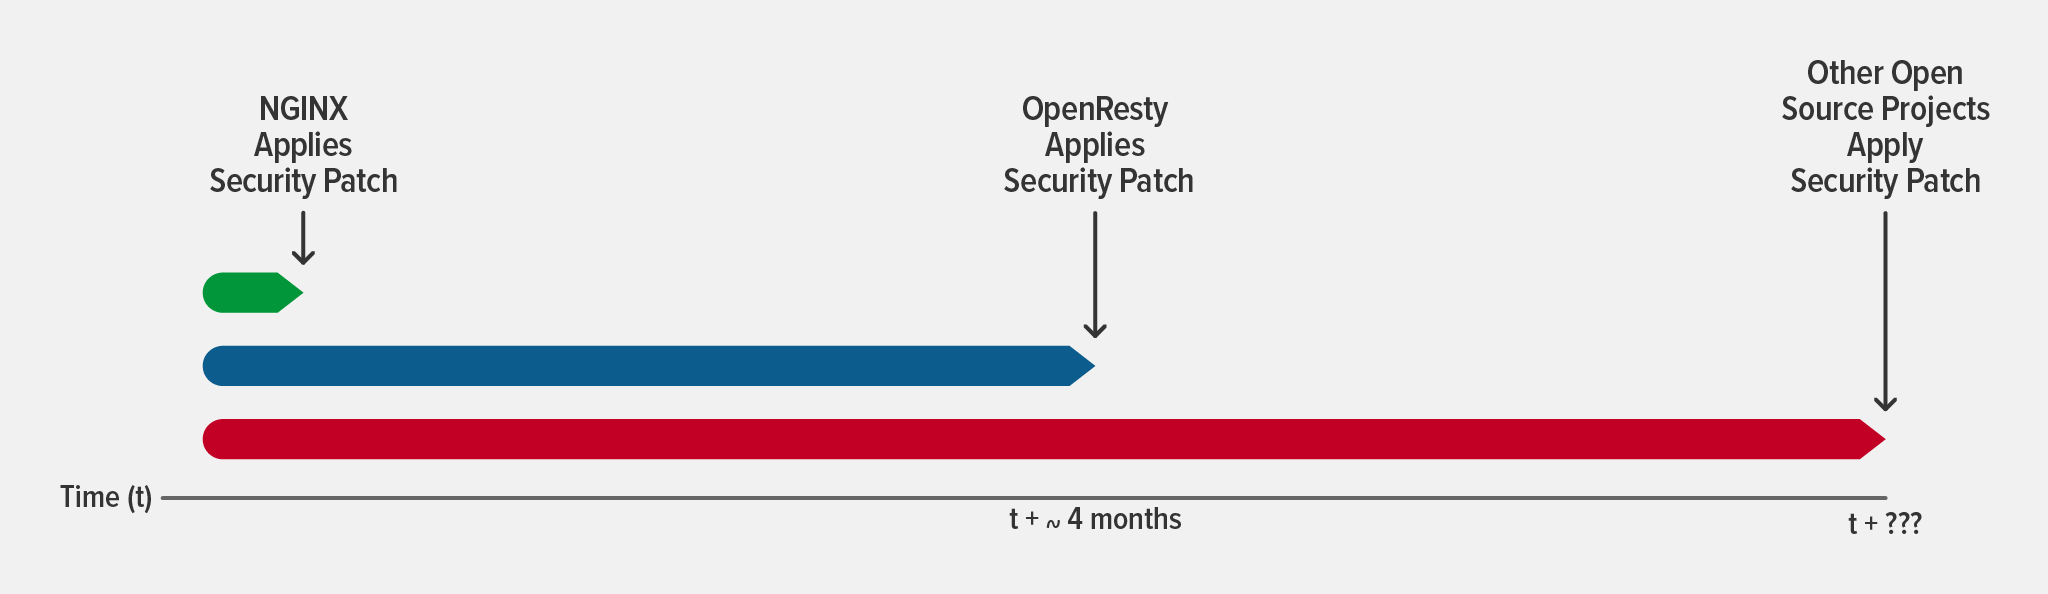
Pour bénéficier de l’application la plus rapide des correctifs de CVE, recherchez deux caractéristiques lors du choix de vos outils de gestion du trafic :
- Une équipe d’ingénierie dédiée – Lorsque le développement de l’outil est géré par une équipe d’ingénierie plutôt que par des bénévoles de la communauté, vous savez qu’un groupe de personnes veille spécifiquement au bon fonctionnement de l’outil et peut donner la priorité à la publication d’un correctif dans les meilleurs délais.
- Une base de code intégrée – Sans aucune dépendance externe (comme nous l’avons évoqué avec OpenResty), les correctifs peuvent être livrés en un seul sprint agile.
Pour en savoir plus sur l’application de correctifs aux CVE, consultez l’article « Atténuer rapidement et facilement les vulnérabilités de sécurité avec NGINX Plus ».
Cas d’usage : bloquez les attaques du Top 10 de l’OWASP et les attaques par déni de service (DoS)
Solution : Déployez une protection WAF et anti-DoS flexible et adaptée à Kubernetes
Le choix de la protection WAF et DoS adaptée aux applications Kubernetes dépend de deux facteurs (outre les fonctionnalités) :
- Flexibilité – Dans certains cas, il est préférable de déployer les outils au sein de Kubernetes. Il vous faut donc des outils indépendants de l’infrastructure, capables de fonctionner aussi bien dans Kubernetes qu’en dehors. L’utilisation du même outil pour tous vos déploiements vous permet de réutiliser les politiques et facilite la prise en main par vos équipes SecOps.
- Empreinte – Les meilleurs outils Kubernetes ont une faible empreinte, ce qui permet une consommation appropriée des ressources tout en réduisant au minimum l’impact sur le débit, le nombre de requêtes par seconde et la latence. Étant donné que les équipes DevOps sont souvent réticentes à utiliser des outils de sécurité, car elles pensent qu’ils ralentissent les applications, le choix d’un outil performant et à faible empreinte peut favoriser son adoption.
Bien qu’un outil regroupant les protections WAF et DoS puisse sembler plus efficace, il risque en réalité de poser des problèmes tant en matière d’utilisation du processeur (en raison d’une empreinte plus importante) que de flexibilité. Vous êtes contraint de déployer simultanément les protections WAF et DoS, même lorsque vous n’avez pas besoin des deux. En définitive, ces deux problèmes peuvent augmenter le coût total de possession de vos déploiements Kubernetes, tout en créant des contraintes budgétaires pour d’autres outils et services essentiels.
Une fois que vous avez choisi les outils de sécurité adaptés à votre organisation, vous devez déterminer où les déployer. Les services applicatifs peuvent généralement être déployés à quatre emplacements pour protéger les applications Kubernetes :
- En frontal (sur un équilibreur de charge externe tel que F5 NGINX Plus ou F5 BIG‑IP) – Idéal pour une protection globale « à gros grain », car cela permet d’appliquer des politiques globales à plusieurs clusters
- À la périphérie (sur un contrôleur Ingress tel que F5 NGINX Ingress Controller) – Idéal pour fournir une protection « fine » standardisée à l’échelle d’un seul cluster
- Au niveau du service (sur un équilibreur de charge léger comme NGINX Plus) – Cette approche peut s’avérer nécessaire lorsqu’un cluster comporte un petit nombre de services qui ont en commun le besoin de stratégies spécifiques
- Au niveau du pod (dans le cadre de l’application) – Une approche hautement personnalisée qui peut être utilisée lorsque la stratégie est propre à l’application
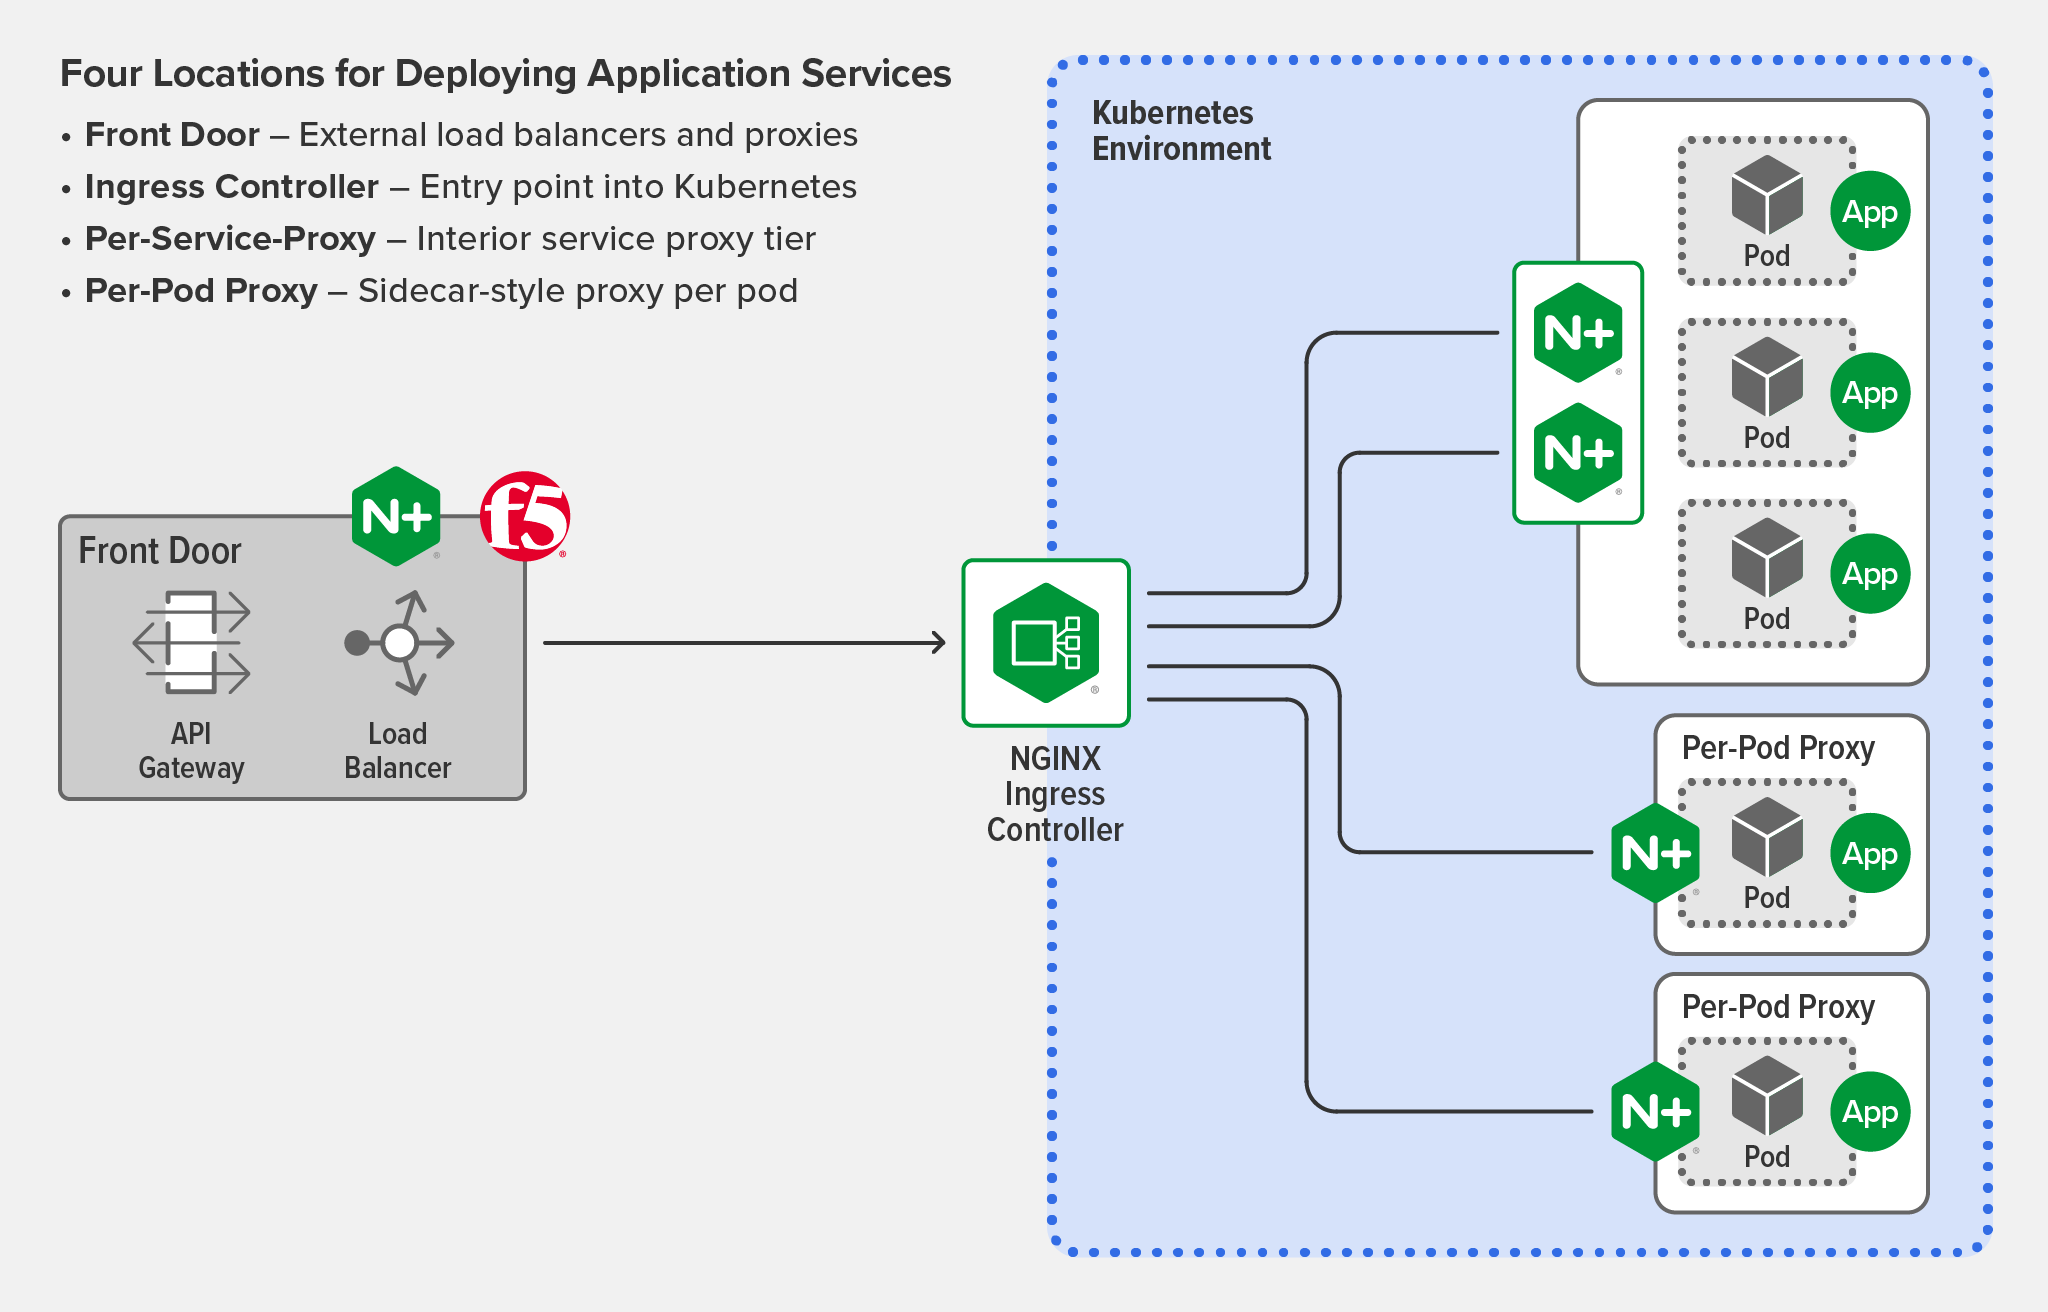
Alors, parmi ces quatre options, laquelle est la meilleure ? Eh bien… ça dépend !
Où déployer un WAF
Nous allons d’abord examiner les différentes options de déploiement d’un WAF, car ce choix est généralement plus complexe.
- Point d’entrée et périphérie – Si votre organisation privilégie une stratégie de sécurité de « défense en profondeur », nous vous recommandons de déployer un WAF à la fois au niveau de l’équilibreur de charge externe et du contrôleur Ingress afin d’assurer un équilibre efficace entre protections globales et personnalisées.
- Point d’entrée ou périphérie – En l’absence d’une stratégie de « défense en profondeur », un emplacement unique est acceptable, et le choix de l’emplacement de déploiement dépend de l’équipe responsable. Lorsqu’une équipe NetOps traditionnelle est chargée de la sécurité, elle peut préférer la gérer sur un proxy traditionnel (l’équilibreur de charge externe). En revanche, les équipes DevSecOps à l’aise avec Kubernetes (et qui préfèrent conserver leur configuration de sécurité à proximité des configurations de leur cluster) peuvent choisir de déployer un WAF au niveau de l’Ingress.
- Par service ou pod – Si vos équipes ont des exigences particulières pour leurs services ou applications, elles peuvent déployer des WAF supplémentaires à la carte. Mais attention : ces emplacements entraînent des coûts plus élevés. Outre l’allongement du temps de développement et l’augmentation du budget cloud, ce choix peut également accroître les coûts opérationnels liés aux opérations de dépannage, par exemple lorsqu’il s’agit de déterminer : « Lequel de nos WAF bloque involontairement le trafic ? »
Où déployer la protection contre les attaques DoS
La protection contre les attaques DoS est plus simple, puisqu’elle n’est nécessaire qu’à un seul emplacement : soit au point d’entrée principal, soit au niveau du contrôleur Ingress. Si vous déployez un WAF à la fois au point d’entrée principal et en périphérie, nous vous recommandons de déployer la protection DoS en amont du WAF du point d’entrée principal, car il s’agit du niveau le plus global. Ainsi, le trafic indésirable peut être filtré avant d’atteindre le WAF, ce qui permet d’utiliser plus efficacement les ressources de calcul.
Pour en savoir plus sur chacun de ces scénarios de déploiement, consultez « Déploiement de services applicatifs dans Kubernetes, partie 2 ».
Cas d’usage : décharger les applications de l’authentification et de l’autorisation
Solution : Centralisez l’authentification et l’autorisation au niveau du point d’entrée
L’authentification et l’autorisation constituent une exigence non fonctionnelle couramment intégrée aux applications et aux services. À petite échelle, cette pratique ajoute un niveau de complexité maîtrisable, qui reste acceptable lorsque l’application ne nécessite pas de mises à jour fréquentes. Mais à plus grande échelle, avec des rythmes de publication plus soutenus, l’intégration de l’authentification et de l’autorisation dans vos applications devient intenable. Veiller à ce que chaque application respecte les protocoles d’accès appropriés peut détourner l’attention de sa logique métier ou, pire encore, être négligé et entraîner une fuite d’informations. Si l’utilisation de technologies SSO peut renforcer la sécurité en remplaçant les différents noms d’utilisateur et mots de passe par un jeu unique d’identifiants, les développeurs doivent néanmoins intégrer à leurs applications du code permettant de communiquer avec le système SSO.
Il existe une meilleure solution : déléguer l’authentification et l’autorisation à un contrôleur Ingress.
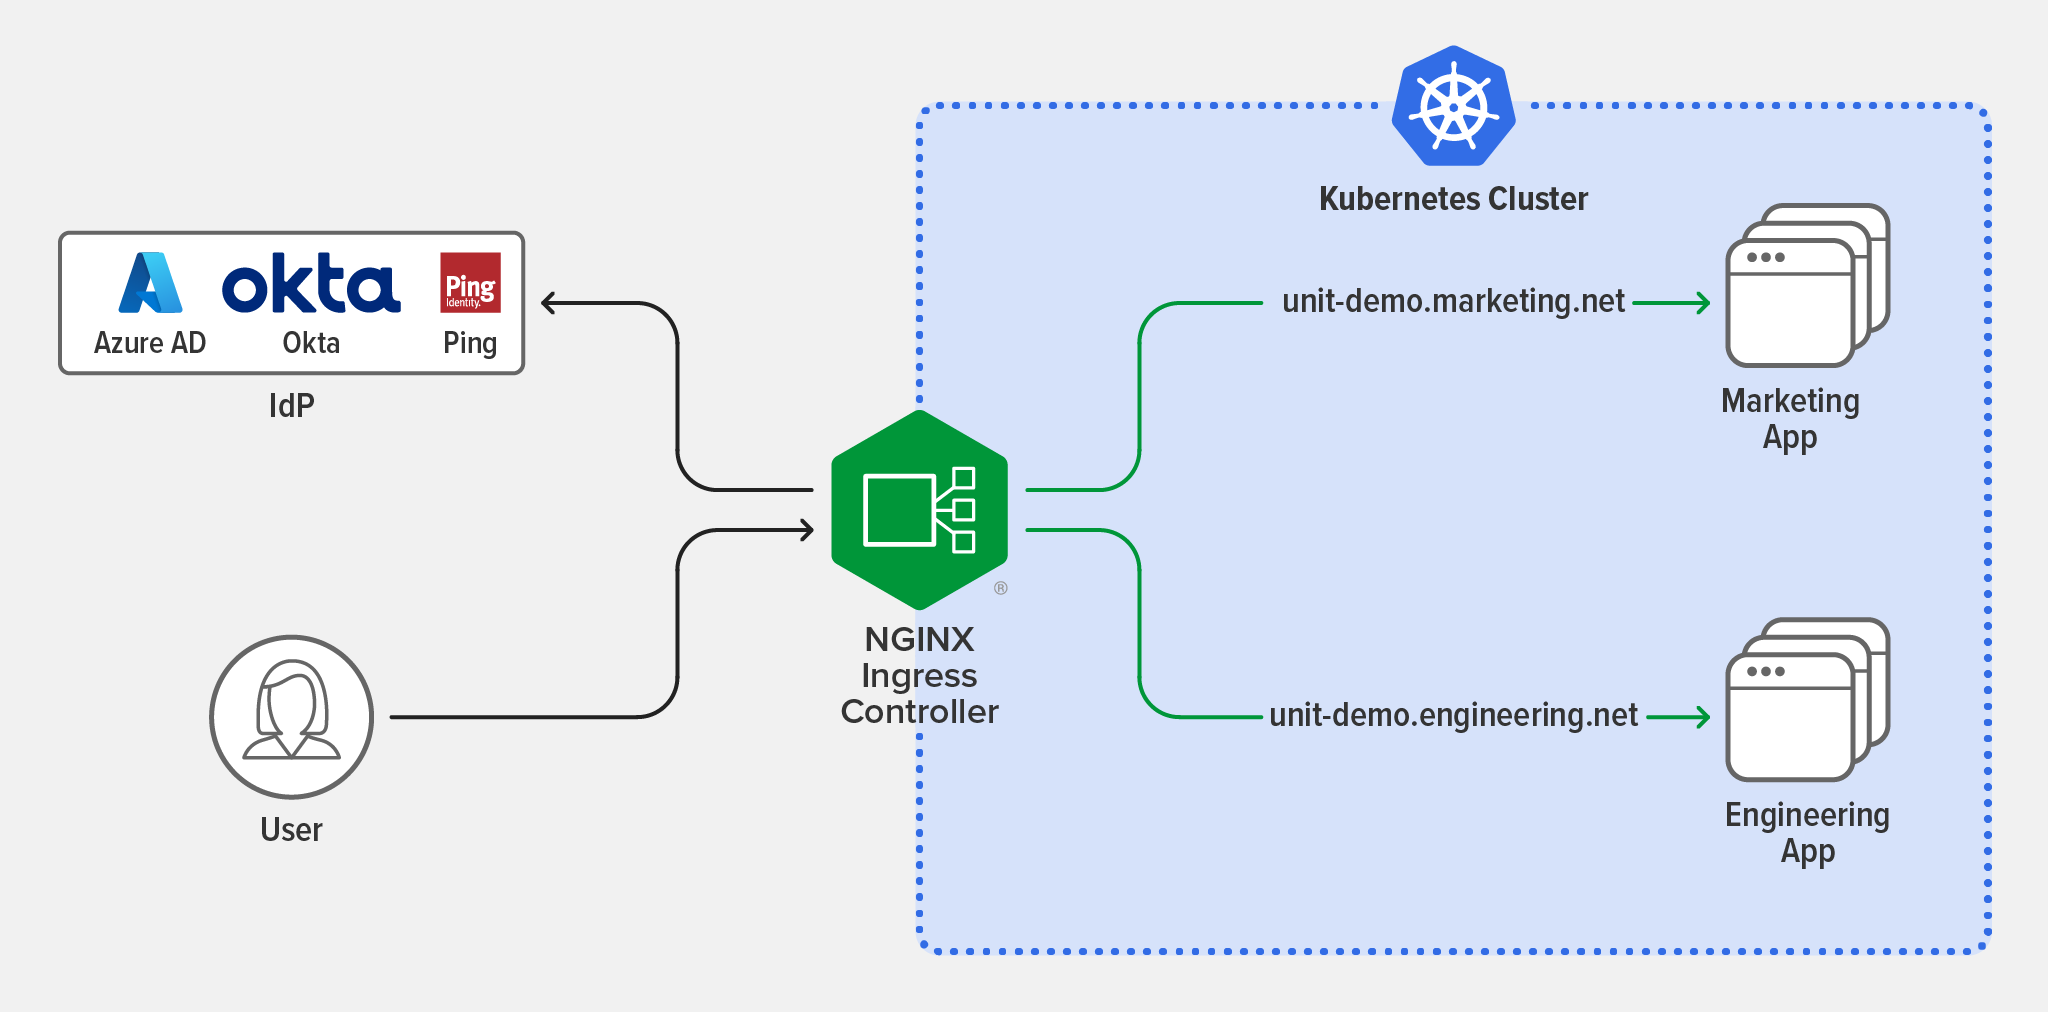
Étant donné que le contrôleur Ingress examine déjà tout le trafic entrant dans le cluster et l’achemine vers les services appropriés, il constitue un choix efficace pour centraliser l’authentification et les autorisations. Les développeurs n’ont ainsi plus à créer, maintenir et répliquer cette logique dans le code de l’application ; ils peuvent à la place tirer rapidement parti des technologies SSO au niveau de la couche d’entrée à l’aide de l’API Kubernetes native.
Pour en savoir plus sur ce sujet, consultez Mise en œuvre de l’authentification OpenID Connect pour Kubernetes avec Okta et le contrôleur Ingress NGINX.
Cas d’usage : mettre en place le libre-service avec des Guardrails
Solution : Mettre en œuvre un contrôle d’accès basé sur les rôles (RBAC)
Kubernetes utilise le contrôle d’accès basé sur les rôles (RBAC) pour gérer les ressources et les opérations accessibles aux différents types d’utilisateurs. Il s’agit d’une mesure de sécurité précieuse, car elle permet à un administrateur ou à un superutilisateur de définir la manière dont les utilisateurs, ou les groupes d’utilisateurs, peuvent interagir avec n’importe quel objet Kubernetes ou espace de noms spécifique du cluster.
Bien que le RBAC de Kubernetes soit activé par défaut, vous devez veiller à ce que vos outils de gestion du trafic Kubernetes prennent également en charge le RBAC et puissent répondre aux besoins de sécurité de votre organisation. Lorsque le RBAC est en place, les utilisateurs bénéficient d’un accès contrôlé aux fonctionnalités dont ils ont besoin pour accomplir leur travail, sans avoir à attendre le traitement d’un ticket. En revanche, si le RBAC n’est pas configuré, les utilisateurs peuvent obtenir des autorisations dont ils n’ont pas besoin ou auxquelles ils n’ont pas droit, ce qui peut créer des vulnérabilités en cas d’utilisation abusive.
Un contrôleur Ingress est un excellent exemple d’outil qui, lorsqu’il est configuré avec le RBAC, peut répondre aux besoins de nombreux utilisateurs et de nombreuses équipes. Lorsque le contrôleur Ingress permet une gestion précise des accès – jusqu’à un espace de noms unique –, vous pouvez utiliser le RBAC pour optimiser l’utilisation des ressources grâce à la mutualisation.
Par exemple, plusieurs équipes peuvent utiliser le contrôleur Ingress comme suit :
- Équipe NetOps – Configure le point d’entrée externe de l’application (comme le nom d’hôte et les certificats TLS) et délègue les politiques de contrôle du trafic à différentes équipes
- Équipe DevOps A – Configure les stratégies d’équilibrage de charge et de routage TCP/UDP
- Équipe DevOps B – Configure des politiques de limitation du débit afin de protéger les services contre un nombre excessif de requêtes
- Équipe chargée de l’identité – Gère les composants d’authentification et d’autorisation tout en configurant les politiques mTLS dans le cadre d’une stratégie de chiffrement de bout en bout
- Équipe DevSecOps – Définit les politiques WAF
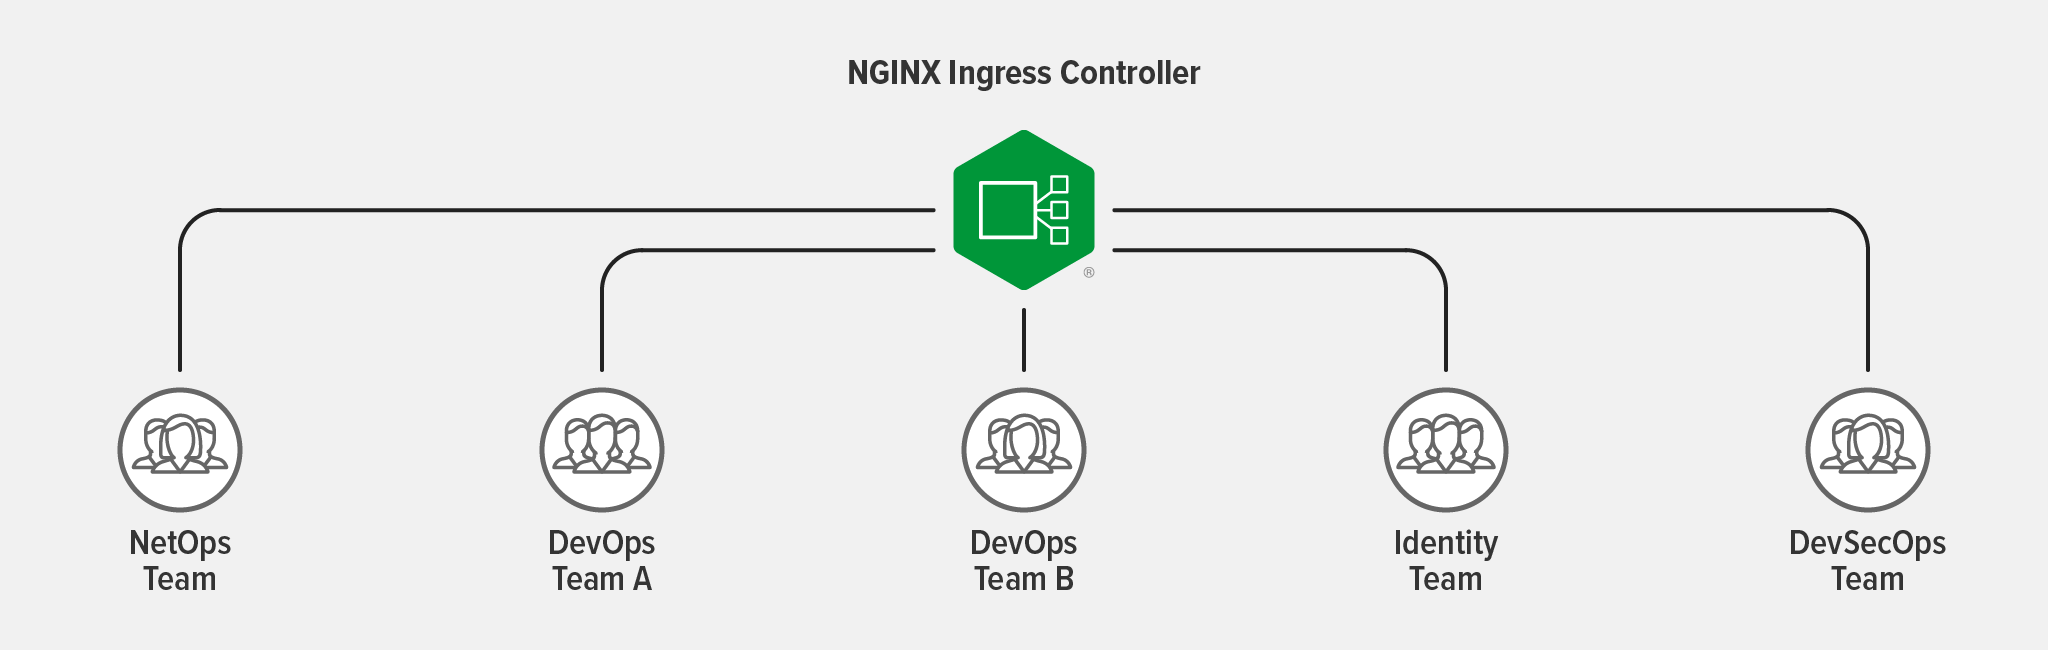
Pour découvrir comment tirer parti du contrôle d’accès basé sur les rôles (RBAC) dans NGINX Ingress Controller, regardez la vidéo « Déploiements Kubernetes avancés avec NGINX Ingress Controller ». À partir de 13:50, nos experts expliquent comment exploiter le RBAC et l’allocation des ressources pour renforcer la sécurité, favoriser le libre-service et assurer la mutualisation.
Cas d’usage : mettre en œuvre le chiffrement de bout en bout
Solution : Utilisez des outils de gestion du trafic
Le chiffrement de bout en bout (E2EE) devient une exigence de plus en plus courante pour les organisations qui traitent des informations sensibles ou personnelles. Qu’il s’agisse de données financières ou de messages sur les réseaux sociaux, les attentes des consommateurs en matière de confidentialité, associées à des réglementations telles que le RGPD et la HIPAA, stimulent la demande pour ce type de protection. La première étape de la mise en œuvre de l’E2EE consiste soit à concevoir vos applications backend de manière à ce qu’elles acceptent le trafic SSL/TLS, soit à utiliser un outil qui décharge vos applications de la gestion SSL/TLS (option à privilégier pour séparer les fonctions de sécurité, optimiser les performances, gérer les clés, etc.). Vous configurez ensuite vos outils de gestion du trafic en fonction de la complexité de votre environnement.
Scénario le plus courant : chiffrement de bout en bout à l’aide d’un contrôleur Ingress
Lorsque vos applications ne comportent qu’un seul point de terminaison (applications simples ou monolithiques que vous avez migrées telles quelles vers Kubernetes), ou qu’il n’existe aucune communication entre services, vous pouvez utiliser un contrôleur Ingress pour mettre en œuvre le chiffrement de bout en bout (E2EE) au sein de Kubernetes.
Étape 1 : Assurez-vous que votre contrôleur Ingress n’autorise que les connexions SSL/TLS chiffrées utilisant des certificats côté service ou mTLS, idéalement pour le trafic entrant comme sortant.
Étape 2 : Modifiez le paramètre par défaut habituel qui impose au contrôleur Ingress de déchiffrer puis de rechiffrer le trafic avant de l’envoyer aux applications. Il existe plusieurs façons de procéder ; la méthode choisie dépend de votre contrôleur Ingress et de vos besoins :
- Si votre contrôleur Ingress prend en charge le relais SSL/TLS, il peut acheminer les connexions chiffrées par SSL/TLS en fonction de l’en-tête Server Name Indication (SNI), sans les déchiffrer ni nécessiter l’accès aux certificats ou aux clés SSL/TLS.
- Vous pouvez également configurer une terminaison SSL/TLS, dans laquelle le contrôleur Ingress termine le trafic, puis le transmet par proxy aux backends ou aux serveurs en amont, soit en clair, soit en le chiffrant à nouveau avec mTLS ou avec SSL/TLS côté service vers vos services Kubernetes.
Scénario moins courant : chiffrement de bout en bout à l’aide d’un contrôleur Ingress et d’un maillage de services
Si des services communiquent entre eux au sein de votre cluster, vous devez mettre en œuvre le chiffrement de bout en bout sur deux plans : le trafic entrant et sortant avec le contrôleur Ingress et le trafic entre services avec un maillage de services. Dans le cadre du chiffrement de bout en bout, le rôle d’un maillage de services est de veiller à ce que seuls certains services soient autorisés à communiquer entre eux et à ce qu’ils le fassent de manière sécurisée. Lorsque vous configurez un maillage de services pour le chiffrement de bout en bout, vous devez mettre en place un environnement Zero Trust reposant sur deux éléments : le protocole mTLS entre les services (configuré pour exiger un certificat) et le contrôle d’accès au trafic entre les services (qui détermine quels services sont autorisés à communiquer). Dans l’idéal, vous devez également mettre en œuvre le protocole mTLS entre les applications (gérées par un maillage de services et le contrôleur du trafic entrant et sortant) afin de garantir une véritable sécurité de bout en bout dans l’ensemble du cluster Kubernetes.
Pour en savoir plus sur le chiffrement des données exposées lors de leur transmission, consultez « L’architecture mTLS dans NGINX Service Mesh ».
Cas d’usage : s’assurer que les clients utilisent un algorithme de chiffrement robuste avec une implémentation fiable
Solution : Respectez les normes fédérales de traitement de l’information (FIPS)
Dans l’industrie du logiciel, FIPS désigne généralement la publication consacrée spécifiquement à la cryptographie, FIPS PUB 140-2 Exigences de sécurité pour les modules cryptographiques, fruit d’un effort conjoint des États-Unis et du Canada. Elle normalise les tests et la certification des modules cryptographiques acceptés par les agences fédérales des deux pays pour protéger les informations sensibles. « Mais attendez ! » dites-vous. « La norme FIPS ne m’intéresse pas, car je ne travaille pas avec des organismes gouvernementaux nord-américains. » Se mettre en conformité avec la norme FIPS peut être judicieux, quels que soient votre secteur d’activité ou votre situation géographique, car elle constitue également la référence cryptographique mondiale de fait.
La mise en conformité avec FIPS n’est pas nécessairement difficile, mais elle exige que votre système d’exploitation et les outils de gestion du trafic concernés puissent fonctionner en mode FIPS. Une idée reçue courante veut qu’il suffise d’exécuter le système d’exploitation en mode FIPS pour assurer la conformité avec FIPS. Même lorsque le système d’exploitation fonctionne en mode FIPS, il est toujours possible que les clients qui communiquent avec votre contrôleur Ingress n’utilisent pas un algorithme de chiffrement robuste. En mode FIPS, votre système d’exploitation et votre contrôleur Ingress ne peuvent utiliser qu’un sous-ensemble des algorithmes de chiffrement SSL/TLS habituels.
La configuration de FIPS pour vos déploiements Kubernetes s’effectue en quatre étapes :
- Étape 1 : Configurez votre système d’exploitation pour le mode FIPS
- Étape 2 : Vérifiez que le système d’exploitation et OpenSSL sont en mode FIPS
- Étape 3 : Installez le contrôleur Ingress
- Étape 4 : Vérifiez la conformité à la norme FIPS 140-2 en effectuant une vérification de l’état FIPS
Dans l’exemple ci-dessous, lorsque le mode FIPS est activé à la fois pour le système d’exploitation et pour l’implémentation OpenSSL utilisée par NGINX Plus, l’ensemble du trafic des utilisateurs finaux à destination et en provenance de NGINX Plus est déchiffré et chiffré à l’aide d’un moteur cryptographique validé et compatible FIPS.
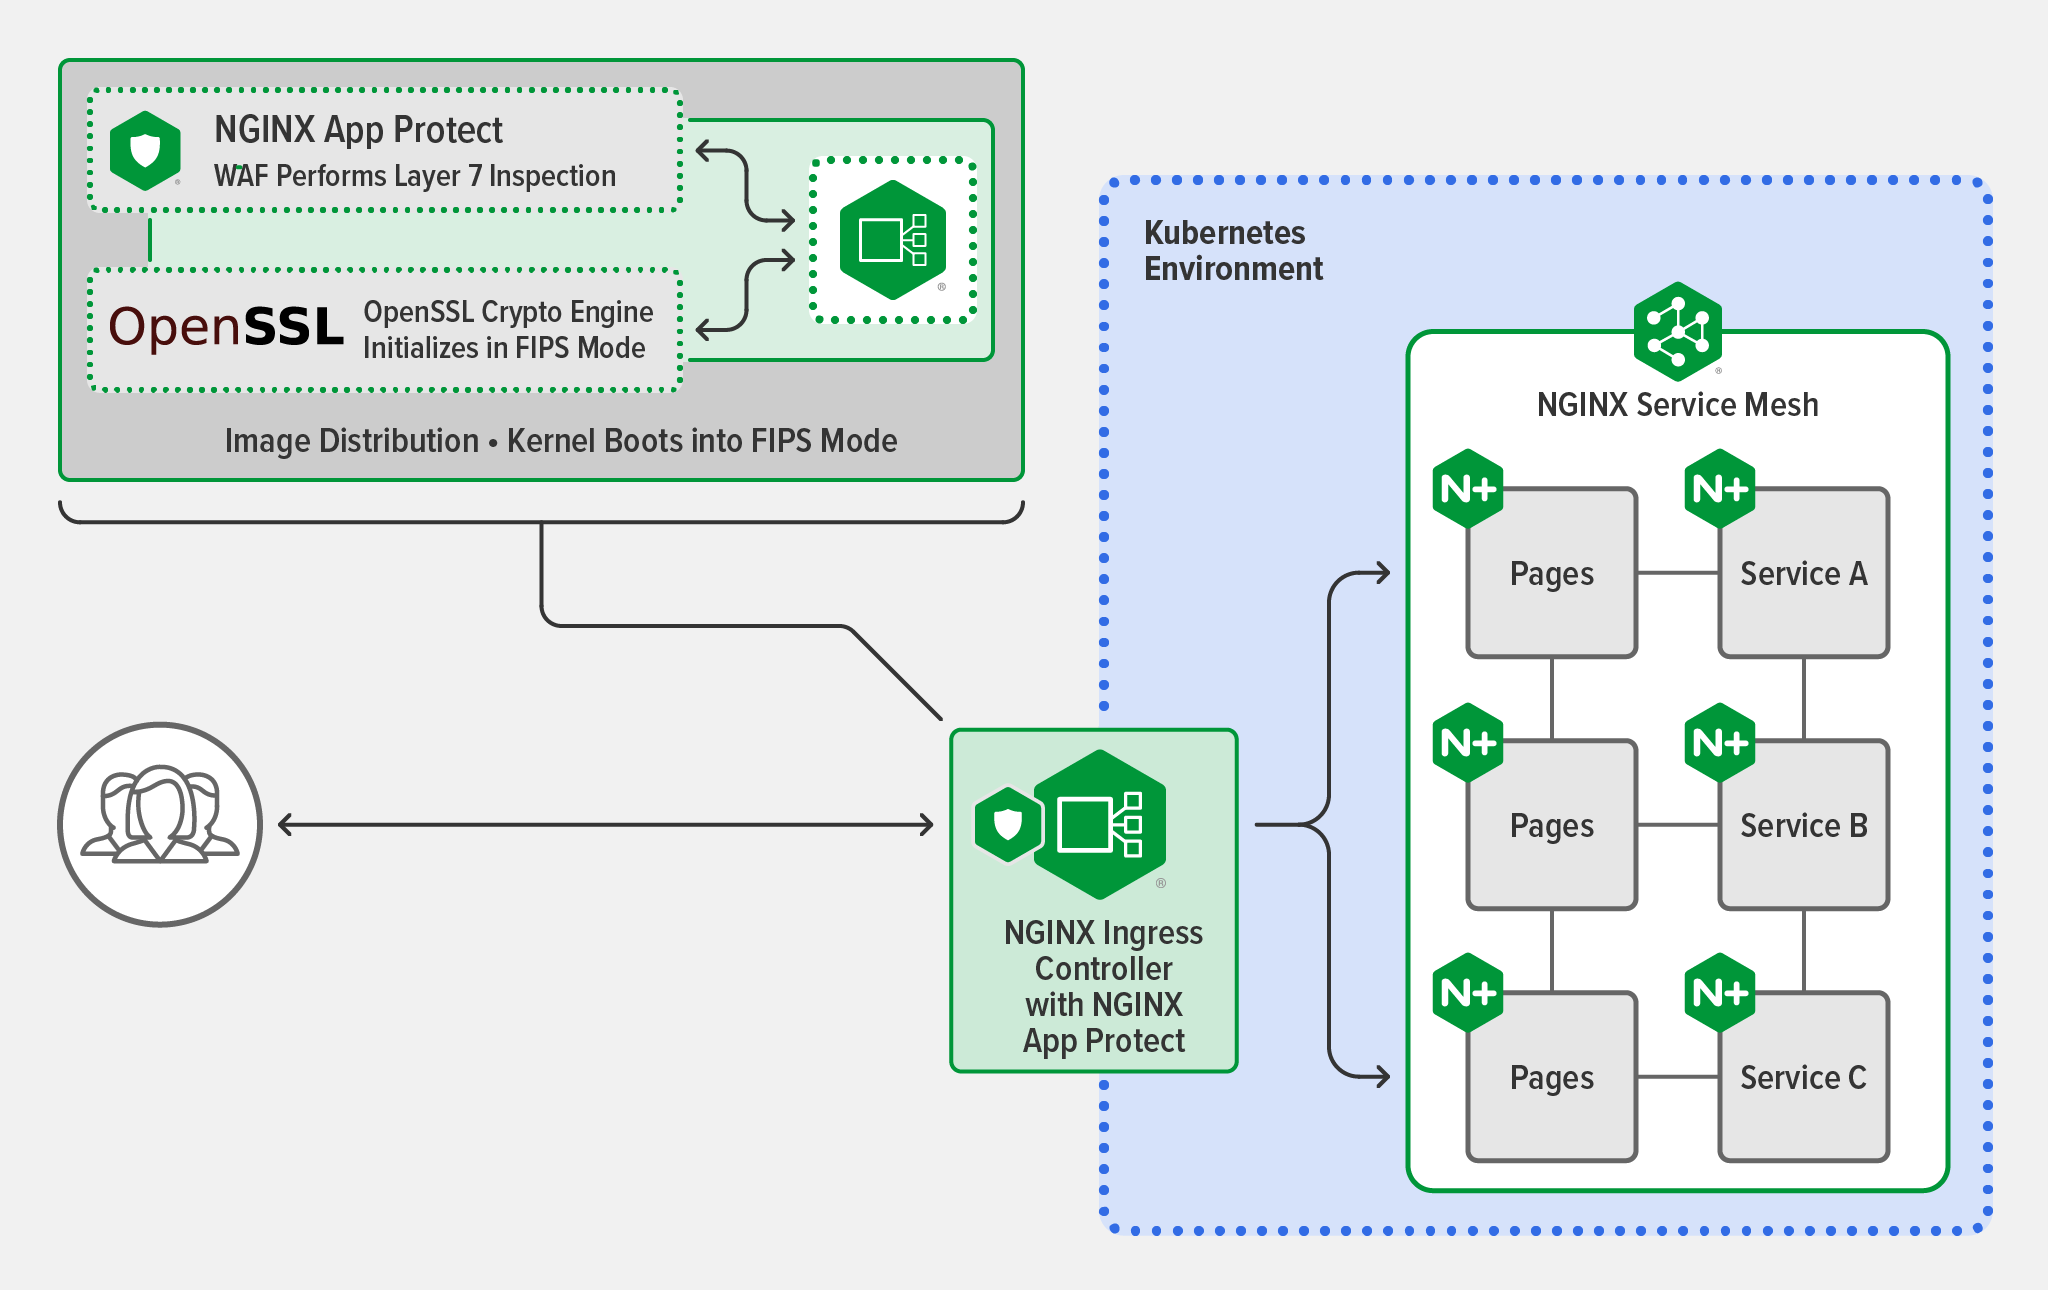
Pour en savoir plus sur FIPS, consultez l’article « Atteindre la conformité FIPS avec NGINX Plus ».
Renforcez la sécurité de Kubernetes avec NGINX
Si vous êtes prêt à mettre en œuvre certaines de ces méthodes de sécurité (voire toutes), vous devez vous assurer que vos outils disposent des fonctionnalités et capacités nécessaires pour répondre à vos cas d’usage. NGINX peut vous aider grâce à sa gamme d’outils de gestion du trafic Kubernetes prêts pour la production :
- NGINX Ingress Controller – Contrôleur Ingress pour Kubernetes basé sur NGINX Plus, qui assure le contrôle et la gestion avancés du trafic, la surveillance et la visibilité, l’authentification et l’authentification unique (SSO), et fait office de passerelle API.
- F5 NGINX App Protect – Une protection complète des applications et API modernes, fondée sur les technologies de sécurité de pointe de F5, qui s’intègre à NGINX Ingress Controller et à NGINX Plus. Adoptez une approche modulaire pour bénéficier d’une plus grande flexibilité dans les scénarios de déploiement et optimiser l’utilisation des ressources :
- NGINX App Protect WAF – Un WAF robuste et léger qui protège contre les 10 principaux risques de l’OWASP et bien plus encore, tout en assurant la conformité à la norme PCI DDS.
- NGINX App Protect DoS – Détection et atténuation comportementales des attaques DoS, avec une protection cohérente et adaptative sur l’ensemble des clouds et des architectures.
- F5 NGINX Service Mesh – Maillage de services léger, clé en main et convivial pour les développeurs, intégrant NGINX Plus comme side-car d’entreprise.
Commencez par demander votre essai gratuit de 30 jours de NGINX Ingress Controller avec NGINX App Protect WAF et DoS, puis téléchargez NGINX Service Mesh, toujours gratuit.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.