La rédaction – Cet article fait partie d’une série en 10 volets :
- Réduisez la complexité avec Kubernetes prêt pour la production
- Comment améliorer la résilience dans Kubernetes grâce à une gestion avancée du trafic
- Comment améliorer la visibilité dans Kubernetes (cet article)
- Six façons de sécuriser Kubernetes à l’aide d’outils de gestion du trafic
- Guide pour choisir un contrôleur Ingress, partie 1 : identifiez vos besoins
- Guide pour choisir un contrôleur Ingress, partie 2 : risques et pérennité
- Guide pour choisir un contrôleur Ingress, partie 3 : open source, par défaut ou commercial
- Guide pour choisir un contrôleur Ingress, partie 4 : les différentes options de contrôleur Ingress NGINX
- Comment choisir un maillage de services
- Tests de performance des contrôleurs Ingress NGINX dans un environnement cloud Kubernetes dynamique
Vous pouvez également télécharger gratuitement l’ensemble des articles de blog sous forme de livre numérique – Kubernetes : des tests à la production.
L’adoption des microservices accélère les expériences numériques, mais les architectures de microservices peuvent également les rendre plus fragiles. Alors que vos développeurs s’empressent de lancer de nouvelles applications, votre architecture peut vous exposer davantage aux interruptions de service, aux failles de sécurité et aux pertes de temps liées à un dépannage inefficace ou à la résolution de problèmes évitables. Dans ce deuxième article de notre série consacrée à Kubernetes en production, nous examinons comment les composants offrant une visibilité sur le trafic peuvent réduire la complexité et améliorer la sécurité de vos environnements de microservices.
Gagnez en visibilité pour mieux comprendre
Tout d’abord, examinons quelques définitions :
- Visibilité – Le fait de pouvoir voir ou être vu
- Compréhension approfondie – Une connaissance fine d’une personne ou d’une chose
Dans une enquête menée par StackRox en 2020, 75 % des utilisateurs de Kubernetes ont jugé la visibilité « indispensable ». Nous partageons cet avis, car il peut être particulièrement difficile de savoir ce qui est déployé dans Kubernetes. Pourtant, 95 % des personnes interrogées dans le cadre de l’édition 2021 du rapport F5 State of Application Strategy (SOAS) ont déclaré que, malgré l’abondance de leurs données, il leur manquait les informations exploitables sur les performances, la sécurité et la disponibilité des applications dont elles ont besoin pour protéger et faire évoluer leur infrastructure et leur activité. Pourquoi ces informations sont-elles si importantes et comment les obtenir ?
Grâce à ces informations exploitables, vous pouvez :
- Renforcez la sécurité et la conformité en détectant les vulnérabilités et les vecteurs d’attaque potentiels
- Réduisez les pannes et les interruptions de service en détectant les problèmes avant vos clients
- Améliorez l’efficacité du dépannage en identifiant la cause profonde des problèmes applicatifs
- Vérifiez que votre trafic est acheminé uniquement vers les destinations souhaitées
- Sachez exactement ce qui s’exécute dans vos environnements Kubernetes et si la configuration et la sécurité sont adéquates
- Déterminez si vous utilisez la bonne quantité de ressources en vous appuyant sur l’historique de latence et de performances.
- Anticipez les besoins saisonniers à partir des tendances de trafic passées
- Mesurer les performances en matière de temps de réponse pour vérifier le respect des accords de niveau de service (SLA) et détecter les problèmes avant qu’ils n’affectent l’expérience utilisateur
Pour mieux comprendre la situation, vous avez besoin de deux types de données de visibilité : en temps réel et historiques. Les données en temps réel vous permettent de diagnostiquer la source d’un problème en cours, tandis que les données historiques vous aident à distinguer ce qui est « normal » de ce qui est inhabituel. Combinées, ces deux sources de visibilité peuvent fournir des informations essentielles sur les performances des applications et de Kubernetes.
Comme pour tout autre investissement technologique, vous devez également définir une stratégie pour en tirer pleinement parti. Le rapport SOAS indique aussi que des facteurs organisationnels empêchent les équipes de dégager des informations pertinentes : le recrutement et le développement des compétences, la stratégie et les processus, ainsi que l’absence de consensus sur l’usage à faire des données, à quel moment et par qui. Voici quelques-uns de ces constats :
- Compétences connexes – La pénurie de professionnels qualifiés dans le secteur des technologies n’est un secret pour personne, comme le confirment 47 % des personnes interrogées, qui déclarent avoir du mal à trouver les talents dont elles ont besoin.
- Initiatives de partage des données – Seuls 12 % des répondants ont mis en place des processus et des stratégies pour transmettre des données aux décideurs de l’entreprise afin de les sensibiliser aux répercussions de la résilience technologique (ou de son absence) sur les activités de l’entreprise.
- L’objectif de la visibilité – La plupart des personnes interrogées utilisent la télémétrie de manière réactive (c’est-à-dire pour résoudre des problèmes), tandis que seules 24 % d’entre elles exploitent les données et les analyses de manière proactive pour détecter d’éventuelles dégradations des performances, et 16 % pour suivre le respect des accords de niveau de service (SLA).
La suite de cet article se concentre sur les aspects techniques de l’analyse des données. Restez à l’affût de nos prochains articles sur la stratégie, les processus et d’autres sujets.
Comment NGINX peut vous aider
Nous savons que la plupart des déploiements Kubernetes utilisent déjà un outil de supervision et n’ont pas besoin d’un outil supplémentaire. C’est pourquoi nous avons instrumenté l’API NGINX Plus pour faciliter l’exportation des métriques et proposons des intégrations avec des outils populaires comme OpenTracing et Grafana et Prometheus, afin que vous puissiez obtenir une vue d’ensemble des performances au sein de vos clusters. Vous bénéficiez d’informations ciblées sur les performances et la disponibilité de vos applications grâce à des traces détaillées qui vous permettent de comprendre comment les requêtes sont traitées dans vos applications à base de microservices.
- Visibilité sur le trafic entrant et sortant (nord-sud)
NGINX Ingress Controller offre une visibilité sur le trafic entrant et sortant de vos clusters Kubernetes. Saviez-vous qu’il existe trois contrôleurs Ingress populaires basés sur NGINX ? Tous ne sont pas prêts pour la production, et un mauvais choix pourrait finir par compliquer votre stratégie de microservices plutôt que de l’améliorer. Notre article de blog Au fait, quel contrôleur Ingress NGINX pour Kubernetes est-ce que j’utilise ? compare les différentes options pour vous aider à faire le choix le mieux adapté à vos besoins. - Visibilité sur le trafic est-ouest
NGINX Service Mesh offre une visibilité sur le trafic circulant entre les applications conteneurisées.
Poursuivez votre lecture pour découvrir comment nous pouvons vous aider à résoudre deux problèmes courants :
Si vous souhaitez voir cette technologie en action, regardez cette démonstration diffusée en direct et cette séance de questions-réponses avec des experts NGINX et Grafana. Ils vous montreront comment surveiller en temps réel les principaux indicateurs d’équilibrage de charge et de performance, exporter ces indicateurs vers Prometheus et créer des tableaux de bord Grafana pour obtenir une vue des performances cumulées.
Problème : mon application est lente (ou en panne !)
Vous soupçonnez une attaque DDoS ? Des utilisateurs signalent des erreurs sur votre site web ? Vous ne pouvez pas commencer à résoudre le problème sans en avoir identifié précisément l’origine.
- Surveillance en temps réel avec NGINX Ingress Controller
Avec NGINX Plus, le tableau de bord de surveillance de l’activité en temps réel, alimenté par l’API NGINX Plus, affiche des centaines d’indicateurs clés de charge et de performance. Accédez à des informations détaillées jusqu’à l’échelle d’un seul pod pour mesurer rapidement et facilement les temps de réponse des applications et identifier l’origine d’un problème. Si votre environnement Kubernetes se développe, vous disposez automatiquement de tableaux de bord pour chaque instance supplémentaire de NGINX Ingress Controller. Par exemple, deux colonnes de l’onglet HTTP Upstreams vous permettent de connaître instantanément l’état des applications et de l’infrastructure :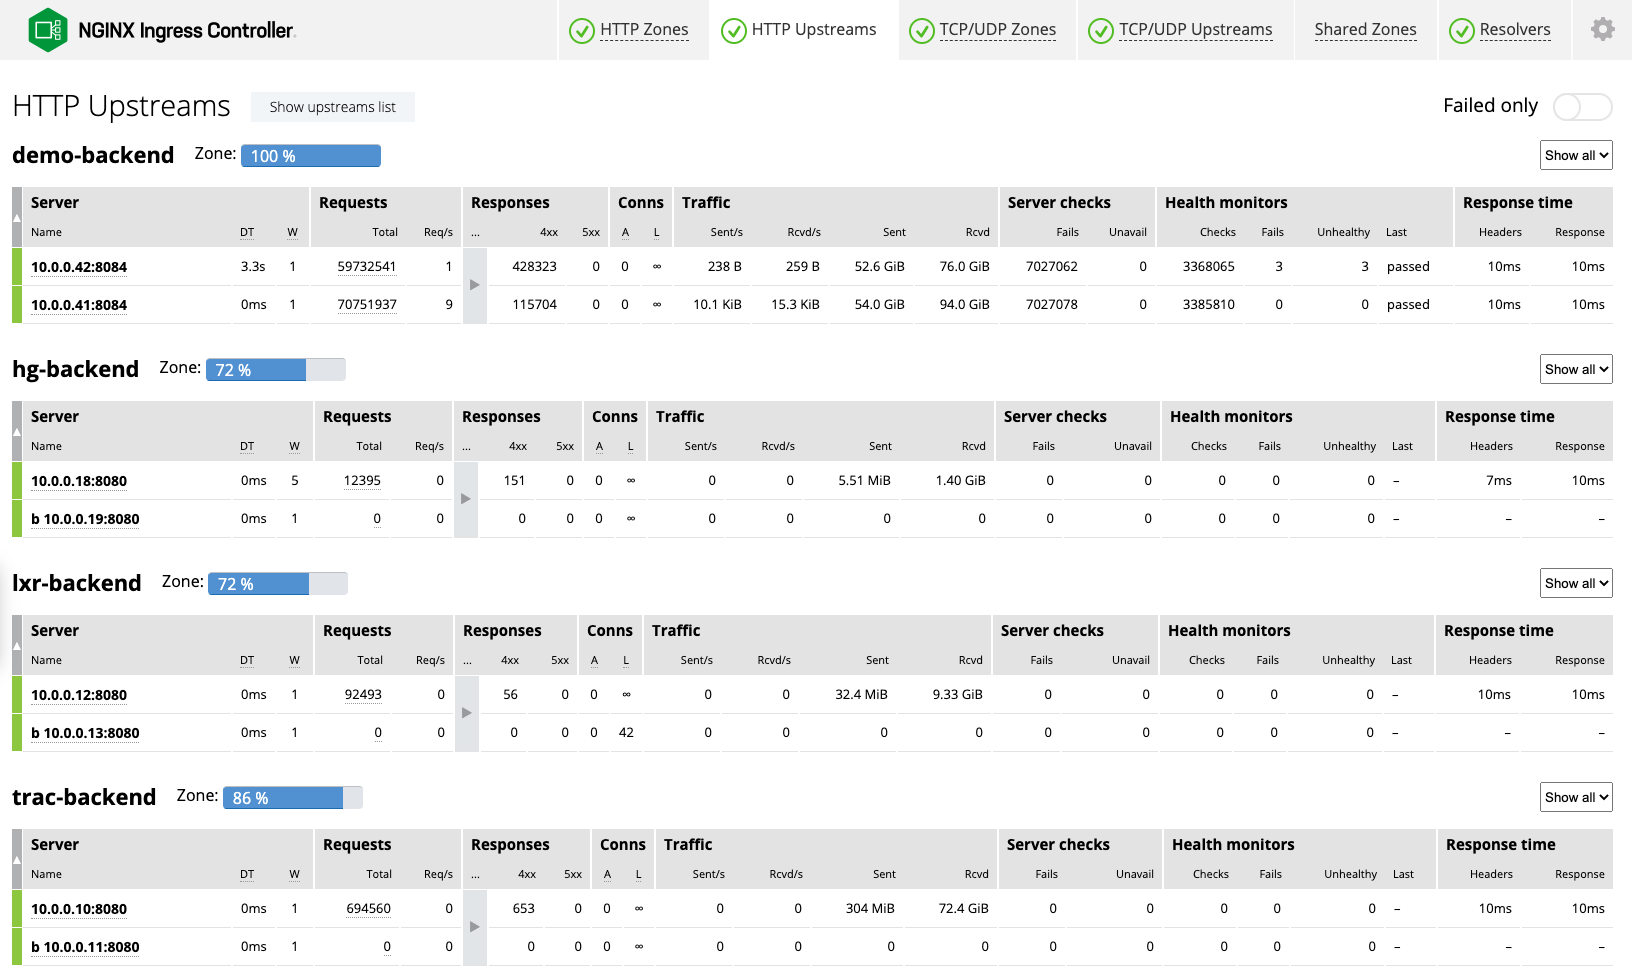
- Requêtes – Si le nombre de requêtes par seconde (Req/s) passe en dessous de la normale pour l’application concernée (par exemple, 5 requêtes par seconde alors que la normale est de 40), il se peut que le contrôleur Ingress ou l’application soit mal configuré.
- Temps de réponse – Si les temps de réponse sont inférieurs ou égaux à 10 millisecondes (ms), tout va très bien. Une latence supérieure à 30–40 ms indique un problème au niveau de vos applications en amont.
- État de base de NGINX Ingress Controller
Avec NGINX Open Source, NGINX Ingress Controller inclut une page d’état qui présente huit métriques de base. - OpenTracing avec NGINX Service Mesh
NGINX Service Mesh prend en charge OpenTracing grâce au module NGINX OpenTracing. Au moment de la rédaction de cet article, le module prend en charge Datadog, LightStep, Jaeger et Zipkin.
Problème : mon cluster ou ma plateforme manque de ressources
Vous rencontrez des erreurs HTTP ? 503 et 40x indiquent un problème au niveau de vos ressources, tandis que les erreurs 502 signifient qu’une modification de configuration n’a pas fonctionné. Utilisez les données historiques pour déterminer où vos ressources risquent de s’épuiser.
- Journalisation avec NGINX Ingress Controller
La première étape du diagnostic des problèmes réseau consiste à consulter les journaux de NGINX Ingress Controller, dans lesquels chaque entrée est annotée avec le service Kubernetes concerné. Les entrées signalant des erreurs précisent le service associé. Les journaux contiennent des informations détaillées sur l’ensemble du trafic ayant transité par le contrôleur Ingress, notamment un horodatage, l’adresse IP source et le code d’état de la réponse. Vous pouvez également exporter les journaux vers des agrégateurs populaires tels que Datadog, Grafana et Splunk. - Métriques Prometheus
L’une des fonctionnalités les plus populaires de NGINX Ingress Controller est sa liste toujours plus complète de métriques Prometheus, qui comprend des métriques sur les performances du réseau et le trafic du contrôleur Ingress. Avec NGINX Plus, NGINX Ingress Controller exporte des métriques sur les connexions, la mise en cache, le trafic HTTP et TCP/UDP traité par des groupes de processus de travail NGINX qui partagent des données dans une zone mémoire, le trafic HTTP et TCP/UDP traité par des groupes de serveurs backend, et bien plus encore. NGINX Service Mesh déploie un serveur Prometheus qui utilise l’API NGINX Plus pour collecter les métriques des sidecars de NGINX Service Mesh et des pods de NGINX Ingress Controller. Si vous préférez utiliser un déploiement Prometheus existant, nous fournissons également des configurations de collecte à ajouter à votre fichier de configuration Prometheus. - Tableaux de bord Grafana
Nous proposons des tableaux de bord Grafana officiels pour NGINX Ingress Controller et NGINX Service Mesh qui permettent de visualiser les métriques exposées par l’exportateur Prometheus. Les utilisateurs apprécient la granularité des données, qui offrent une précision à la milliseconde, des superpositions permettant de comparer les données d’un jour à l’autre et une visibilité sur les pics de trafic. Par exemple, le tableau de bord NGINX Service Mesh peut indiquer que vos pods ont atteint leur capacité maximale en affichant le volume de trafic sur un service ou un pod donné, ainsi que le nombre de pods actifs surveillés.
Préparer la mise en production avec NGINX
Le contrôleur Ingress NGINX prêt pour la production (basé sur NGINX Plus) est disponible en essai gratuit de 30 jours, qui inclut NGINX App Protect pour sécuriser vos applications conteneurisées. NGINX Service Mesh, toujours gratuit, est disponible en téléchargement sur f5.com.
À propos de l’auteur
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.