Lorsque nous avons présenté le projet NGINX Modern Apps Reference Architecture (MARA) l’automne dernier lors de Sprint 2.0, nous avons souligné notre volonté de ne pas en faire un « jouet » comme certaines architectures, mais plutôt une solution « robuste, testée et prête à être déployée dans des applications en production exécutées dans des environnements Kubernetes ». Pour un tel projet, les outils d’observabilité sont absolument indispensables. Tous les membres de l’équipe MARA ont pu constater par eux-mêmes à quel point le manque de visibilité sur l’état et les performances rend le développement et la livraison d’applications frustrants. Nous nous sommes immédiatement accordés sur la nécessité d’intégrer à MARA une instrumentation permettant le débogage et le traçage dans un environnement de production.
Un autre principe directeur de MARA est de privilégier les solutions open source. Dans cet article, nous expliquons comment notre recherche d’un outil d’observabilité open source multifonction nous a conduits à OpenTelemetry, puis nous détaillons les compromis, les choix de conception, les techniques et les technologies qui nous ont permis d’intégrer OpenTelemetry à une application de microservices développée avec Python, Java et NGINX.
Nous espérons que notre retour d’expérience vous aidera à éviter les écueils potentiels et à accélérer votre adoption d’OpenTelemetry. Veuillez noter que cet article est un rapport d’étape dont la pertinence est limitée dans le temps : nous prévoyons que les technologies abordées arriveront à maturité d’ici un an. Par ailleurs, même si nous soulignons les lacunes actuelles de certains projets, nous sommes extrêmement reconnaissants de tout le travail accompli dans le domaine de l’open source et enthousiastes à l’idée de le voir progresser.
Notre application
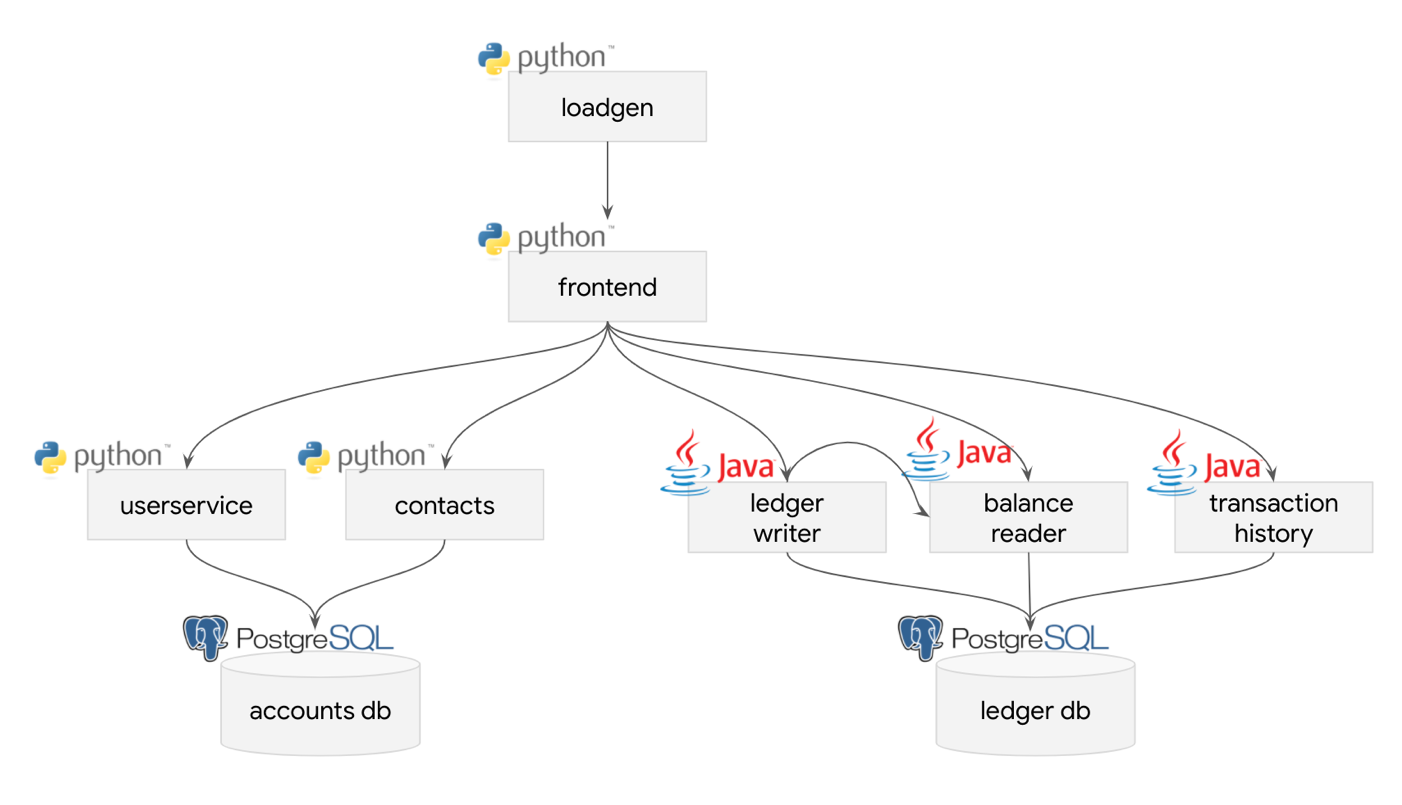
Pour intégrer une solution d’observabilité à une application, nous avons choisi Bank of Sirius, notre fork de Bank of Anthos, l’application de démonstration de Google. Il s’agit d’une application web reposant sur une architecture de microservices, qui peut être déployée à l’aide de l’infrastructure en tant que code. Cette application peut être améliorée de nombreuses façons en matière de performances et de fiabilité, mais elle est suffisamment mature pour être raisonnablement considérée comme une application existante de type « brownfield ». À ce titre, nous estimons qu’elle constitue un bon exemple pour montrer comment intégrer OpenTelemetry dans une application, car, en théorie, le traçage distribué fournit des informations précieuses sur les lacunes de l’architecture d’une application.
Comme le montre le schéma, les services sur lesquels repose l’application sont relativement simples.
Comment nous avons choisi OpenTelemetry
Le parcours qui nous a menés à choisir OpenTelemetry a été assez sinueux et s’est déroulé en plusieurs étapes.
Établir une liste des fonctionnalités souhaitées
Avant d’évaluer les outils d’observabilité open source disponibles, nous avons déterminé les aspects de l’observabilité qui nous importaient. En nous appuyant sur nos expériences passées, nous avons établi la liste suivante.
- Journalisation – Au sens où nous l’entendons, ce terme désigne la génération par les applications d’ensembles classiques de messages séparés par des sauts de ligne ; l’application Bank of Sirius structure ses journaux au format Bunyan
- Traçage distribué – Mesures de temps et métadonnées pour chaque composant de l’ensemble de l’application, comme celles fournies par les éditeurs de solutions de gestion des performances applicatives (APM)
- Métriques – Mesures recueillies sur une période donnée et représentées graphiquement sous forme de séries temporelles
- Agrégation et notification des exceptions et des erreurs – Un ensemble regroupant les exceptions et les erreurs les plus fréquentes, dans lequel il doit être possible d’effectuer des recherches afin de déterminer quelles erreurs d’application sont les plus courantes
- Contrôles de santé – Sondes envoyées périodiquement aux services pour vérifier leur bon fonctionnement au sein de l’application
- Introspection de l’état d’exécution – Un ensemble d’API accessibles uniquement aux administrateurs, qui renvoient des informations sur l’état d’exécution de l’application
- Dumps du tas/de la mémoire – Instantanés complets de l’état d’un service en cours d’exécution ; ce qui importe pour nous, c’est la facilité avec laquelle ces dumps peuvent être obtenus à la demande ou lorsqu’un service plante
Comparaison des fonctionnalités des outils avec la liste des fonctionnalités souhaitées
Bien sûr, nous ne nous attendions pas à ce qu’un seul outil ou une seule approche open source intègre toutes ces fonctionnalités, mais cela nous donnait au moins une base de comparaison idéale pour évaluer les outils disponibles. Nous avons consulté la documentation de chaque outil pour déterminer lesquelles des sept fonctionnalités de notre liste de souhaits il prenait en charge. Le tableau résume nos conclusions.
Technologie Journalisation Traçage distribué Métriques Agrégation des erreurs Vérifications de l’état de santé Introspection à l’exécution Vidages du tas/de la mémoireELK + Elastic APM ✅ ✅ ✅ ✅ ✅ ❌ ❌Grafana ✅ ✅ ✅ ✅ ✅ ❌ ❌Graylog ✅ ❌ ❌ ❌ ❌ ❌ ❌Jaeger ❌ ✅ ❌ ✅ ❌ ❌ ❌OpenCensus ❌ ❌ ✅ ❌ ❌ ❌ ❌OpenTelemetry Bêta ✅ ✅ ✅ ✅ * ❌ ❌Prometheus ❌ ❌ ✅ ❌ ❌ ❌ ❌StatsD ❌ ❌ ✅ ❌ ❌ ❌ ❌Zipkin ❌ ✅ ❌ ✅ ❌ ❌ ❌
* En tant qu’extension
La création de ce tableau nous a brutalement ouvert les yeux. Les différents outils présentent des capacités et des usages si variés qu’il était impossible de les ranger tous dans la même catégorie : c’était comme comparer des pommes à des grille-pain !
Par exemple, ELK (Elasticsearch-Logstash-Kibana, avec Filebeat) et Zipkin remplissent des fonctions si fondamentalement différentes que tenter de les comparer ne fait que semer la confusion. Malheureusement, l’élargissement progressif de leur périmètre fonctionnel brouille encore davantage les pistes : sans doute pour répondre aux demandes des utilisateurs, des fonctionnalités secondaires par rapport à la vocation première de chaque outil ont été ajoutées, créant ainsi des recoupements avec d’autres outils. À première vue, ELK assure le stockage et la visualisation des journaux, tandis que Zipkin se charge du traçage distribué. Mais en explorant un peu plus en détail le portefeuille de produits Elastic, on découvre rapidement Elastic APM, qui prend en charge le traçage distribué et offre même une compatibilité avec Jaeger.
Au-delà de la question de la dérive fonctionnelle, bon nombre de ces outils peuvent être intégrés les uns aux autres, donnant lieu à différentes combinaisons de collecteurs, d’agrégateurs, de tableaux de bord, etc. Certaines de ces technologies sont compatibles entre elles, d’autres non.
Mener une étude qualitative
Ce tableau comparatif ne nous donnait donc pas une vision suffisamment précise pour nous permettre de faire notre choix. Nous devions mener une étude qualitative des objectifs, des principes directeurs et des orientations futures possibles de chaque projet, en partant du principe que plus les valeurs d’un projet sont proches des nôtres, plus nous avons de chances de rester compatibles sur le long terme. En consultant les pages des projets, nous avons immédiatement remarqué ceci sur la page d’OpenCensus.
OpenCensus et OpenTracing ont fusionné pour donner naissance à OpenTelemetry, qui constitue la prochaine version majeure d’OpenCensus et d’OpenTracing. OpenTelemetry assurera la rétrocompatibilité avec les intégrations OpenCensus existantes, et nous continuerons à fournir des correctifs de sécurité pour les bibliothèques OpenCensus existantes pendant deux ans.
C’était une information essentielle à nos yeux. Nous savions que nous ne pouvions pas garantir la pérennité de notre choix, mais nous voulions au moins nous assurer qu’il bénéficierait à l’avenir d’un solide soutien de la communauté. Grâce à cette information, nous pouvions rayer OpenCensus de notre liste de candidats. Utiliser Jaeger n’était probablement pas non plus une bonne idée, car il s’agit de l’implémentation de référence du projet OpenTracing, désormais officiellement abandonné : l’essentiel des nouvelles contributions se fera sur OpenTelemetry.
Nous nous sommes ensuite renseignés sur le OpenTelemetry Collector.
Le collecteur OpenTelemetry propose une implémentation indépendante de tout fournisseur pour recevoir, traiter et exporter les données de télémétrie. Il évite également d’avoir à exécuter, exploiter et maintenir plusieurs agents ou collecteurs pour prendre en charge les formats de données de télémétrie open source (par exemple, Jaeger, Prometheus, etc.) et les transmettre à plusieurs back-ends open source ou commerciaux.
Le collecteur OpenTelemetry agit comme un agrégateur qui nous permet de combiner différentes méthodes de collecte de données d’observabilité et d’instrumentation avec différents backends. Concrètement, notre application peut collecter des traces avec Zipkin et des métriques provenant de Prometheus, que nous pouvons ensuite envoyer à un backend configurable et visualiser avec Grafana. Plusieurs autres variantes de cette architecture sont possibles : nous pouvons donc tester différentes approches pour déterminer quelles technologies sont les mieux adaptées à notre cas d’usage.
Intégrer OpenTelemetry pour aller de l’avant
En fait, nous avons été convaincus par le Collector OpenTelemetry, car il nous permet en théorie de passer d’une technologie d’observabilité à une autre. Malgré le manque relatif de maturité du projet, nous avons décidé de nous lancer et d’utiliser OpenTelemetry uniquement avec des intégrations open source, car la seule façon de comprendre l’écosystème est d’utiliser ces technologies.
Il manque toutefois certaines fonctionnalités à OpenTelemetry Collector, ce qui nous oblige à recourir à d’autres technologies pour en bénéficier. Les sections suivantes présentent nos choix et les raisons qui les ont motivés.
- Mise en œuvre de la journalisation
- Mise en œuvre du traçage distribué
- Mise en œuvre de la collecte de métriques
- Mise en œuvre de l’agrégation des erreurs
- Mise en œuvre des contrôles d’état et de l’introspection à l’exécution
- Mise en œuvre des vidages du tas et de la mémoire
Mise en place de la journalisation
La journalisation est un aspect de l’observabilité dont la simplicité apparente conduit rapidement à des décisions complexes. Elle est simple parce qu’il suffit de collecter les journaux générés par vos conteneurs, mais complexe parce qu’il faut ensuite décider où stocker ces données, comment les acheminer vers cet espace de stockage, comment les indexer pour les rendre exploitables et combien de temps les conserver. Pour être utiles, les fichiers journaux doivent permettre d’effectuer facilement des recherches selon des critères suffisamment variés pour répondre aux besoins des différentes personnes qui les consultent.
Nous avons examiné la prise en charge de la journalisation par le collecteur OpenTelemetry et, à l’heure où nous écrivons ces lignes, elle est encore loin d’être mature. Nous avons décidé d’utiliser ELK pour la journalisation à court terme, tout en continuant à explorer d’autres options.
En l’absence de raison impérieuse de faire autrement, nous avons choisi par défaut d’utiliser les outils Elasticsearch, ce qui nous a permis de répartir le déploiement entre des nœuds d’ingestion, de coordination, maîtres et de données. Pour faciliter le déploiement, nous avons utilisé un chart Bitnami. Pour acheminer les données, nous avons déployé Filebeat au sein d’un DaemonSet Kubernetes. Nous avons ajouté des fonctionnalités de recherche en déployant Kibana et en exploitant les index, recherches, visualisations et tableaux de bord préchargés.
Il est assez vite apparu que, même si cette solution fonctionnait, sa configuration par défaut était très gourmande en ressources, ce qui rendait son exécution difficile dans un environnement plus léger comme K3S ou Microk8s. L’ajout de la possibilité d’ajuster le nombre de réplicas de chaque composant a permis de résoudre ce problème, mais a entraîné quelques défaillances potentiellement dues à un épuisement des ressources ou à des volumes de données excessifs.
Loin d’être déçus par ce constat, nous y voyons l’occasion d’évaluer les performances de notre système de journalisation avec différentes configurations, ainsi que d’explorer d’autres options telles que Grafana Loki et Graylog. Nous pourrions bien découvrir que les solutions de journalisation plus légères n’offrent pas toutes les fonctionnalités dont certains utilisateurs ont besoin et qu’ils peuvent trouver dans des outils plus gourmands en ressources. Compte tenu de la nature modulaire de MARA, nous développerons probablement des modules supplémentaires pour ces solutions afin d’offrir davantage de choix aux utilisateurs.
Mise en œuvre du traçage distribué
Au-delà du choix de l’outil offrant les fonctionnalités de traçage souhaitées, nous devions réfléchir à la manière de mettre en œuvre la solution et aux technologies à y intégrer.
Tout d’abord, nous voulions nous assurer que l’instrumentation ne dégradait pas la qualité de service de l’application elle-même. Nous avions tous travaillé sur des systèmes dont les performances chutaient systématiquement une fois par heure lors de l’exportation des journaux, et nous n’avions aucune envie de revivre cette expérience. L’architecture du collecteur OpenTelemetry était séduisante à cet égard, car elle permet d’exécuter une instance par hôte. Chaque collecteur reçoit les données des clients et des agents de toutes les applications exécutées sur l’hôte, qu’elles soient conteneurisées ou non. Le collecteur agrège les données et les compresse éventuellement avant de les envoyer à un système de stockage, ce qui nous semblait idéal.
Ensuite, nous avons évalué la prise en charge d’OpenTelemetry dans les différents langages de programmation et frameworks que nous utilisons dans l’application. À ce stade, les choses se sont un peu compliquées. Bien que nous n’utilisions que les deux langages de programmation et les frameworks associés présentés dans le tableau, le niveau de complexité était étonnamment élevé.
Langage Framework Nombre de servicesJava Spring Boot 3Python Flask 3
Pour ajouter le traçage au niveau du langage, nous avons d’abord essayé les agents d’instrumentation automatique d’OpenTelemetry, mais nous avons trouvé les données produites trop encombrées et difficiles à interpréter. Nous sommes convaincus que cela s’améliorera à mesure que les bibliothèques d’instrumentation automatique gagneront en maturité, mais pour le moment, nous avons écarté les agents OpenTelemetry et décidé d’intégrer le traçage directement dans notre code.
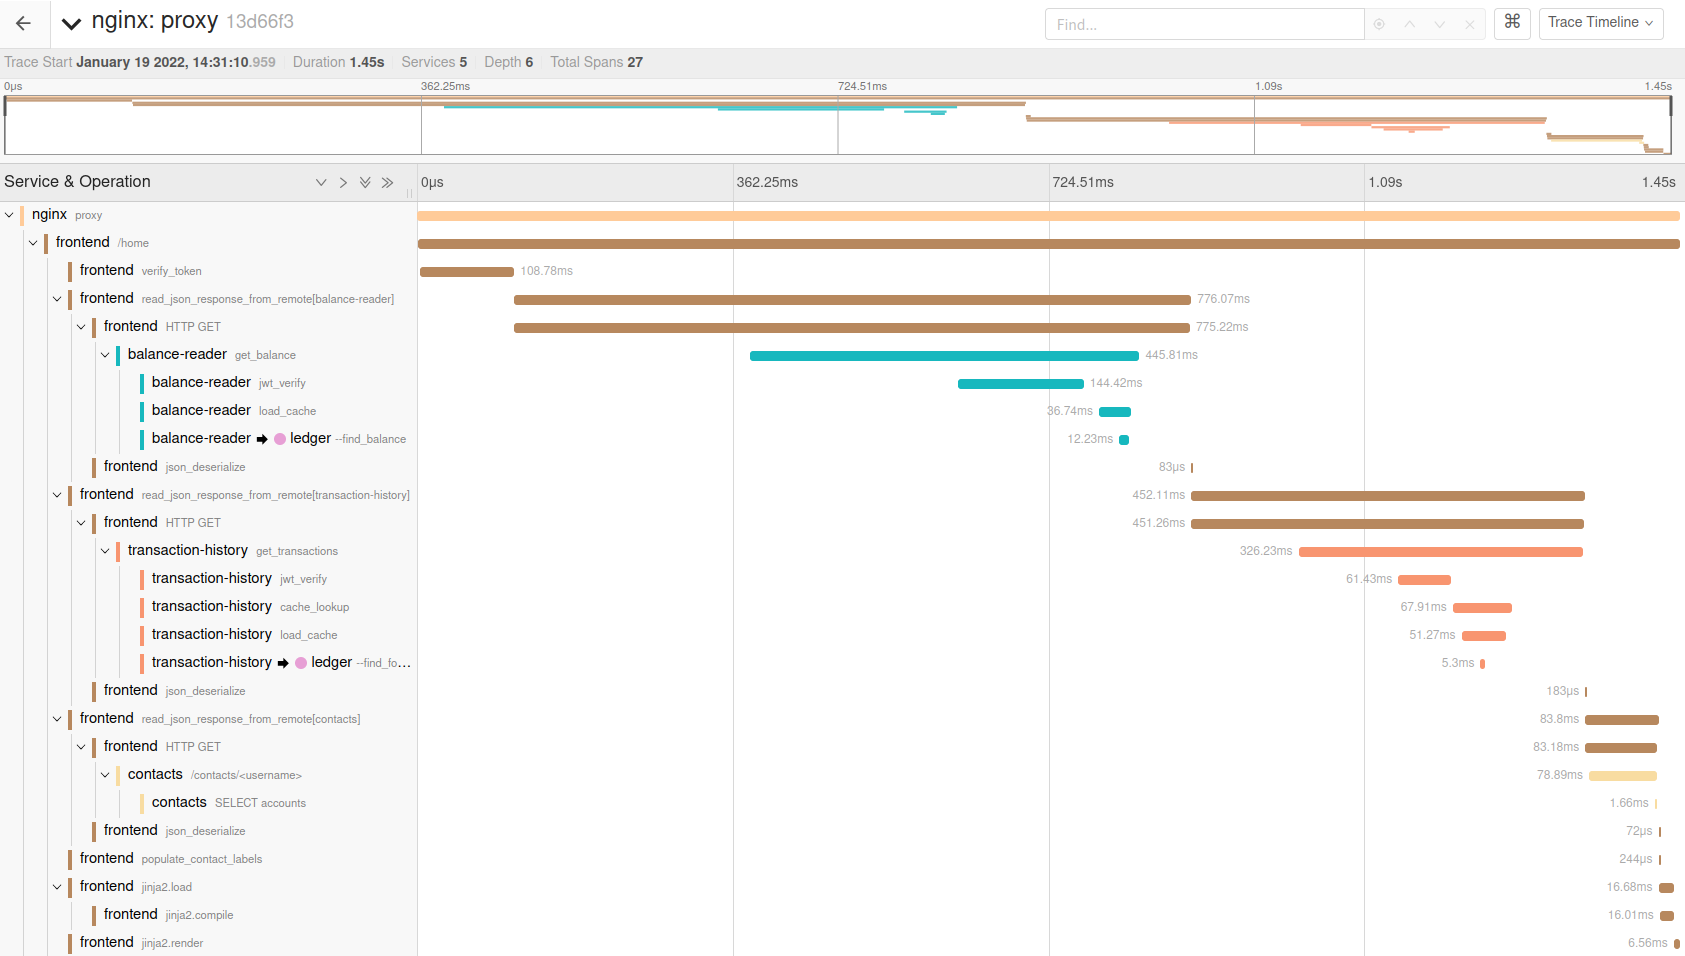
Avant de nous lancer dans l’implémentation du traçage directement dans le code, nous avons d’abord configuré le collecteur OpenTelemetry pour qu’il envoie toutes les données de trace à une instance Jaeger exécutée localement, où nous pouvions les consulter plus facilement. Cela s’est avéré très utile, car nous pouvions tester différentes présentations visuelles des données de trace tout en cherchant comment intégrer pleinement OpenTelemetry. Par exemple, si nous constations qu’une bibliothèque cliente HTTP n’incluait pas de données de trace lors des appels à un service dont notre application dépendait, nous ajoutions immédiatement ce problème à notre liste de correctifs à apporter. Jaeger offre une vue claire des différents spans au sein d’une même trace :
Traçage distribué pour Python
L’ajout du traçage à notre code Python a été relativement simple. Nous avons ajouté deux fichiers source Python référencés par tous nos services et mis à jour les fichiers requirements.txt correspondants pour y inclure les dépendances opentelemetry-instrumentation-* appropriées. Nous avons ainsi pu utiliser la même configuration de traçage pour tous les services Python, inclure l’identifiant de trace de chaque requête dans les messages de journalisation et l’intégrer aux requêtes adressées aux services dont ils dépendent.
Traçage distribué pour Java
Ensuite, nous nous sommes penchés sur les services Java. Utiliser directement les bibliothèques Java d’OpenTelemetry dans un projet créé de zéro est relativement simple : il suffit d’importer les bibliothèques nécessaires et d’utiliser directement l’API de traçage. Cependant, si vous utilisez Spring comme nous, vous aurez d’autres choix à faire.
Spring dispose déjà d’une API de traçage distribué, Spring Cloud Sleuth. Elle fournit une façade à l’implémentation sous-jacente du traçage distribué, qui remplit les fonctions suivantes, comme indiqué dans la documentation :
- Ajoute les identifiants de trace et de span au MDC de Slf4J, afin de vous permettre d’extraire tous les journaux associés à une trace ou à un span donné dans un agrégateur de journaux.
- Instrumente les points d’entrée et de sortie courants des applications Spring (filtre de servlet, RestTemplate, actions planifiées, canaux de messagerie, client Feign).
- Si
spring-cloud-sleuth-zipkinest disponible, … [génère et transmet] des traces compatibles avec Zipkin via HTTP. Par défaut, ces traces sont envoyées à un service de collecte Zipkin sur localhost (port 9411). Configurez l’adresse du service à l’aide despring.zipkin.baseUrl.
L’API nous permet également d’ajouter des traces aux tâches annotées avec @Scheduled.
Autrement dit, Spring Cloud Sleuth nous permet à lui seul d’obtenir des traces au niveau des points de terminaison des services HTTP sans configuration supplémentaire, ce qui est un avantage appréciable. Comme notre projet utilise déjà Spring, nous avons décidé de rester dans ce framework et de tirer parti des fonctionnalités proposées. Nous avons toutefois rencontré quelques problèmes en assemblant le tout avec Maven :
- Le module Spring Cloud Sleuth Autoconfigure est encore en version préliminaire (milestone).
- Le module Spring Cloud Sleuth Autoconfigure dépend d’une version alpha obsolète de
opentelemetry-instrumentation-api. Il n’existe actuellement aucune version 1.x récente de cette bibliothèque qui ne soit pas en phase alpha. - Le projet doit récupérer le modèle objet du projet parent (POM)
spring-cloud-builddepuis les dépôts Spring Snapshot en raison de la manière dont Spring Cloud Sleuth définit ses références de dépendances pour les versions jalons.
Cela a quelque peu compliqué la définition de notre projet Maven, car nous devions configurer Maven pour qu’il récupère les dépendances dans les dépôts Spring en plus de Maven Central, ce qui montrait clairement à quel point la prise en charge d’OpenTelemetry dans Spring Cloud était encore à ses débuts. Nous avons néanmoins poursuivi nos efforts et créé un module de télémétrie commun pour configurer le traçage distribué à l’aide de Spring Cloud Sleuth et d’OpenTelemetry, avec diverses fonctions utilitaires et extensions liées à la télémétrie.
Dans le module de télémétrie commun, nous enrichissons les fonctionnalités de traçage offertes par les bibliothèques Spring Cloud Sleuth et OpenTelemetry en proposant :
- des classes
Autoconfigurationcompatibles avec Spring qui configurent le traçage et les fonctionnalités étendues du projet, et chargent des attributs de ressource de trace supplémentaires. - Implémentations NoOp des interfaces, afin de pouvoir désactiver le traçage au démarrage en injectant des instances NoOp dans toutes les interfaces de Spring Cloud Sleuth.
- Un intercepteur de nommage des traces pour normaliser les noms des traces.
- Un gestionnaire d’erreurs qui signale les erreurs via slf4j et le traçage de Spring Cloud Sleuth.
- Une implémentation améliorée des attributs de traçage qui encode des informations supplémentaires dans chaque trace émise, notamment la version du service, l’identifiant de l’instance du service, l’identifiant de la machine, le nom du pod, l’identifiant du conteneur, le nom du conteneur et le nom de l’espace de noms.
- Un inspecteur d’instructions pour le traçage qui injecte des identifiants de trace dans les commentaires précédant les instructions SQL émises par Hibernate. Apparemment, il est désormais possible de le faire avec SQLCommenter, mais nous n’avons pas encore migré vers cet outil.
De plus, nous avons implémenté un client HTTP compatible avec Spring qui s’appuie sur Apache HTTP Client, car nous souhaitions disposer de davantage de métriques et de possibilités de personnalisation pour les appels HTTP entre services. Dans cette implémentation, les identifiants de trace et de span sont transmis dans les en-têtes lors des appels aux services dépendants, ce qui permet de les inclure dans les données de traçage. Cette implémentation fournit également des métriques sur le pool de connexions HTTP, qui sont agrégées par OpenTelemetry.
Dans l’ensemble, la mise en place du traçage avec Spring Cloud Sleuth et OpenTelemetry a été laborieuse, mais nous pensons que le jeu en valait la chandelle. Nous espérons que ce projet et cet article aideront à ouvrir la voie à ceux qui souhaitent se lancer dans cette démarche.
Traçage distribué pour NGINX
Pour obtenir des traces reliant tous les services tout au long du cycle de vie d’une requête, nous avons dû intégrer OpenTelemetry à NGINX. Nous avons utilisé le module OpenTelemetry pour NGINX (encore en version bêta) à cette fin. Anticipant la difficulté potentielle à obtenir des binaires fonctionnels du module compatibles avec toutes les versions de NGINX, nous avons créé un dépôt GitHub d’images de conteneurs intégrant des modules NGINX non pris en charge. Nous effectuons des compilations chaque nuit et distribuons le binaire du module via des images Docker à partir desquelles il est facile de l’importer.
Nous n’avons pas encore intégré ce processus au processus de compilation de NGINX Ingress Controller dans le cadre du projet MARA, mais nous prévoyons de le faire prochainement.
Mise en œuvre de la collecte de métriques
Après avoir terminé l’intégration du traçage avec OpenTelemetry, nous nous sommes concentrés sur les métriques. Nos applications Python ne disposaient d’aucune métrique, et nous avons décidé de reporter leur ajout pour le moment. Pour les applications Java, le code source d’origine de Bank of Anthos, qui utilise Micrometer conjointement avec Stackdriver de Google Cloud, prend en charge les métriques. Cependant, nous avons supprimé ce code de Bank of Sirius après avoir créé un fork de Bank of Anthos, car il ne nous permettait pas de configurer un backend de métriques. Néanmoins, la présence de points d’instrumentation pour les métriques témoignait déjà de la nécessité d’une intégration adéquate des métriques.
Pour trouver une solution configurable et pragmatique, nous avons d’abord examiné la prise en charge des métriques dans les bibliothèques Java d’OpenTelemetry et dans Micrometer. En recherchant des comparatifs entre ces technologies, nous avons trouvé plusieurs résultats qui énuméraient les lacunes d’OpenTelemetry en tant qu’API de métriques pour la JVM, alors même que la prise en charge des métriques par OpenTelemetry est encore en version alpha au moment de la rédaction de cet article. Micrometer est une couche de façade mature pour les métriques sur la JVM, comparable à slf4j, qui fournit une API commune servant d’interface à une implémentation configurable des métriques, plutôt que sa propre implémentation. Fait intéressant, il s’agit de l’API de métriques par défaut de Spring.
À ce stade, nous prenions en compte les éléments suivants :
- Le collecteur OpenTelemetry peut ingérer des métriques provenant de pratiquement n’importe quelle source, notamment Prometheus, StatsD et le protocole natif OpenTelemetry Protocol (OTLP)
- Micrometer prend également en charge un grand nombre de backends de métriques, notamment Prometheus et StatsD
- Le SDK OpenTelemetry Metrics pour la JVM permet d’envoyer des métriques via OTLP
Après quelques essais, nous avons décidé que l’approche la plus pragmatique consistait à utiliser la façade Micrometer avec une implémentation sous-jacente Prometheus, et à configurer le collecteur OpenTelemetry pour qu’il récupère les métriques de l’application via l’API Prometheus. Nous savions, pour l’avoir lu dans de nombreux articles, que l’absence de certains types de métriques dans OpenTelemetry pouvait poser problème, mais nos cas d’usage ne nécessitaient pas ces types de métriques. Ce compromis était donc acceptable.
Nous avons découvert un point intéressant concernant le collecteur OpenTelemetry : même si nous l’avions configuré pour recevoir les traces via OTLP et les métriques via l’API Prometheus, il reste possible de le configurer pour envoyer ces deux types de données à un destinataire externe via OTLP ou tout autre protocole pris en charge. Cela nous a permis de tester facilement notre application avec LightStep.
Dans l’ensemble, coder les métriques en Java a été assez simple, car nous avons suivi l’API Micrometer, pour laquelle de nombreux exemples et tutoriels sont disponibles. Le plus difficile, tant pour les métriques que pour le traçage, a probablement été de configurer correctement le graphe des dépendances Maven dans le fichier pom.xml de telemetry-common.
Mise en œuvre de l’agrégation des erreurs
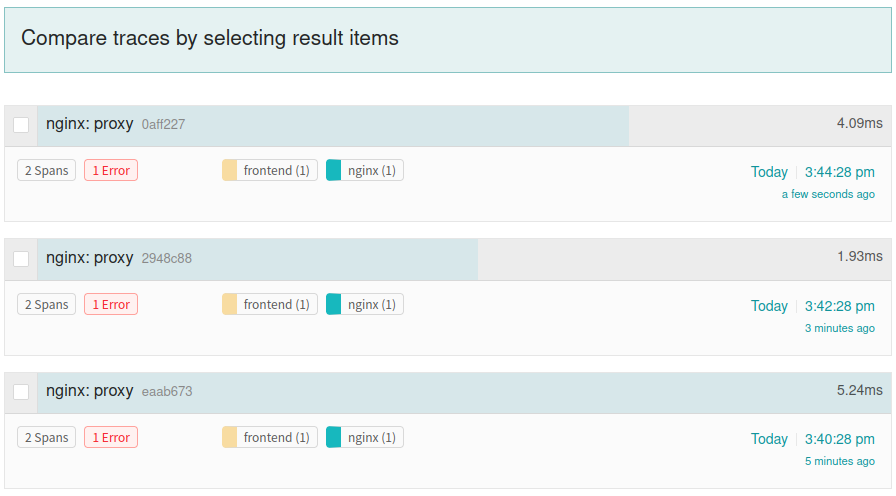
L’agrégation des erreurs ne fait pas partie de la mission du projet OpenTelemetry à proprement parler, et sa mise en œuvre de l’étiquetage des erreurs n’est pas aussi élégante que celle de solutions comme Sentry ou Honeybadger.io. Nous avons néanmoins décidé d’utiliser OpenTelemetry pour l’agrégation des erreurs à court terme plutôt que d’ajouter un autre outil. Avec un outil comme Jaeger, nous pouvons rechercher error=true pour trouver toutes les traces présentant une erreur. Cela nous donne au moins une idée des problèmes les plus fréquents. À l’avenir, nous pourrions envisager d’ajouter une intégration avec Sentry.
Mise en œuvre des contrôles de santé et de l’introspection à l’exécution
Dans le contexte de notre application, les contrôles d’état permettent à Kubernetes de savoir si un service fonctionne correctement ou a terminé sa phase de démarrage. Si le service ne fonctionne pas correctement, Kubernetes peut être configuré pour arrêter ou redémarrer les instances. Dans notre application, nous avons décidé de ne pas utiliser les contrôles d’état d’OpenTelemetry, car nous avons jugé la documentation insuffisante.
Pour les services JVM, nous utilisons plutôt un projet Spring appelé Spring Boot Actuator, qui fournit non seulement des points de terminaison de vérification de l’état de santé, mais aussi des points de terminaison d’introspection à l’exécution et de vidage du tas mémoire. Pour les services Python, nous utilisons le module Flask Management Endpoints, qui propose un sous-ensemble des fonctionnalités de Spring Boot Actuator. À l’heure actuelle, il fournit uniquement des informations personnalisables sur l’application et des vérifications de l’état de santé.
Spring Boot Actuator s’intègre à la JVM et à Spring pour fournir des points de terminaison d’introspection, de supervision et de vérification de l’état de santé. Il propose également un framework permettant d’enrichir les données présentées par défaut sur ses points de terminaison avec des informations personnalisées. Ces points de terminaison permettent d’inspecter, à l’exécution, des éléments tels que l’état du cache, l’environnement d’exécution, les migrations de bases de données, les vérifications de l’état de santé, les informations personnalisables sur l’application, les métriques, les tâches périodiques, l’état des sessions HTTP et les dumps de threads.
Les points de terminaison de contrôle de santé implémentés par Spring Boot Actuator disposent d’une configuration modulaire : l’état de santé d’un service peut ainsi être déterminé par plusieurs vérifications individuelles, classées en vérifications de vivacité (liveness) ou de disponibilité (readiness). Un contrôle de santé complet affichant tous les modules de vérification est également disponible et se présente généralement comme ceci.
Les points de terminaison d’information sont définis dans un document JSON sous la forme d’un objet JSON unique de premier niveau et d’une série hiérarchisée de clés et de valeurs. En général, le document précise le nom et la version du service, l’architecture, le nom d’hôte, des informations sur le système d’exploitation, l’identifiant du processus, le nom de l’exécutable et des détails sur l’hôte, tels qu’un identifiant de machine ou un identifiant unique de service.
Mise en œuvre des dumps de tas et des dumps mémoire
Vous vous souvenez peut-être, à la lecture du tableau de la section « Comparaison des fonctionnalités des outils avec la liste des fonctionnalités souhaitées », qu’aucun des outils ne prend en charge l’introspection à l’exécution ni les dumps du tas ou les dumps mémoire (core dumps). Toutefois, Spring, le framework sur lequel repose notre application, prend en charge ces deux fonctionnalités, même si l’intégration des fonctionnalités d’observabilité dans l’application a demandé quelques efforts. Comme indiqué dans la section précédente, nous utilisons un module Python conjointement avec Spring Boot Actuator pour l’introspection à l’exécution.
De même, pour les dumps du tas, nous utilisons les points de terminaison de dump des threads fournis par Spring Boot Actuator afin de couvrir une partie des fonctionnalités souhaitées. Nous ne pouvons pas obtenir de dumps mémoire à la demande ni de dumps du tas de la JVM avec la granularité aussi fine que nous le souhaiterions, mais nous disposons de certaines des fonctionnalités recherchées au prix d’un effort supplémentaire limité. Les dumps mémoire des services Python nécessiteront malheureusement un travail supplémentaire assez conséquent, que nous avons reporté à plus tard.
Résumé
Après avoir beaucoup pleuré et remis en question nos choix de vie, nous avons fini par retenir les technologies suivantes pour l’observabilité dans MARA (dans ce qui suit, OTel désigne OpenTelemetry) :
- Journalisation (pour tous les conteneurs) – Filebeat → Elasticsearch / Kibana
- Traçage distribué
- Java – Spring Cloud Sleuth → exportateur Spring Cloud Sleuth pour OTel → OTel Collector → exportateurs interchangeables comme Jaeger, Lightstep, Splunk, etc.
- Python – Bibliothèques Python OTel → OTel Collector → système de stockage interchangeable
- NGINX et NGINX Plus (NGINX Ingress Controller n’est pas encore pris en charge) – module OTel NGINX → collecteur OTel → exportateur interchangeable
- Collecte des métriques
- Java – Micrometer via Spring → exportateur Prometheus → collecteur OTel
- Python – Aucune implémentation pour le moment
- Python WSGI – GUnicorn StatsD → Prometheus (via StatsD / ServiceMonitor)
- NGINX – Point de terminaison Prometheus → Prometheus (via ServiceMonitor)
- Agrégation des erreurs – traces distribuées OTel → exportateur interchangeable → fonctionnalité de recherche de l’exportateur pour trouver les traces marquées avec
error - Contrôles d’état
- Java – Spring Boot Actuator → Kubernetes
- Python – module Flask Management Endpoints → Kubernetes
- Introspection à l’exécution
- Java – Spring Boot Actuator
- Python – module Flask Management Endpoints
- Vidages du tas / de la mémoire
- Java – Prise en charge des dumps de threads via Spring Boot Actuator
- Python – Pas encore pris en charge
Cette implémentation reflète l’état actuel du développement. Elle sera assurément amenée à changer et à évoluer au fil du développement. Nous soumettrons bientôt l’application à des tests de charge approfondis. Nous pensons en apprendre beaucoup sur les limites de notre approche de l’observabilité et ajouter de nouvelles fonctionnalités dans ce domaine.
Nous vous invitons à essayer l’architecture de référence pour les applications modernes et l’application de démonstration (Bank of Sirius). Si vous avez des idées pour nous aider à nous améliorer, vos contributions sont les bienvenues sur notre dépôt GitHub !
Articles connexes
Cet article fait partie d’une série. À mesure que nous ajoutons de nouvelles fonctionnalités à MARA, nous en publions les détails sur le blog :
- Une nouvelle architecture de référence open source pour les applications modernes
- Intégration d’OpenTelemetry dans l’architecture de référence pour les applications modernes – Rapport d’avancement (cet article)
- MARA : désormais disponible sur un poste de travail près de chez vous
- Annonce de la version 1.0.0 de l’architecture de référence NGINX pour les applications modernes
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.