Nous avons clairement exposé nos objectifs de conception lorsque nous avons dévoilé l’architecture de référence NGINX pour les applications modernes (MARA) lors de Sprint 2.0, en août 2021. Nous souhaitions créer un exemple d’architecture d’application moderne s’exécutant dans Kubernetes et conçue pour assurer la sécurité, l’évolutivité, la fiabilité, la supervision et l’introspection. Ce projet devait pouvoir être déployé sur différentes infrastructures, selon une approche « plug-and-play » permettant de combiner des composants fonctionnels sans consacrer trop de temps aux efforts d’intégration.
Au cours des mois qui ont suivi Sprint, nous avons continué à avancer sur notre feuille de route. Comme dans tout projet, nous avons connu notre lot de réussites et d’échecs. Nous avons intégré nos réussites à MARA, tout en enrichissant progressivement la liste des enseignements tirés. Nous espérons éviter à d’autres de rencontrer les mêmes problèmes en les documentant et en tenant compte de ces enseignements dès la conception.
Nous avons récemment franchi une étape importante avec MARA version 1.0.0, qui réorganise le répertoire du projet et modifie le processus de création et de destruction de l’environnement. Nous avons éliminé le code dupliqué, créé une structure de répertoires permettant d’intégrer facilement de futurs ajouts et standardisé les scripts de gestion. Cette version marquant une étape importante dans l’histoire de MARA, nous souhaitions prendre le temps de faire le point auprès de la communauté sur nos progrès, de présenter certains des principaux enseignements que nous en avons tirés et de fournir quelques informations sur notre feuille de route pour la suite.
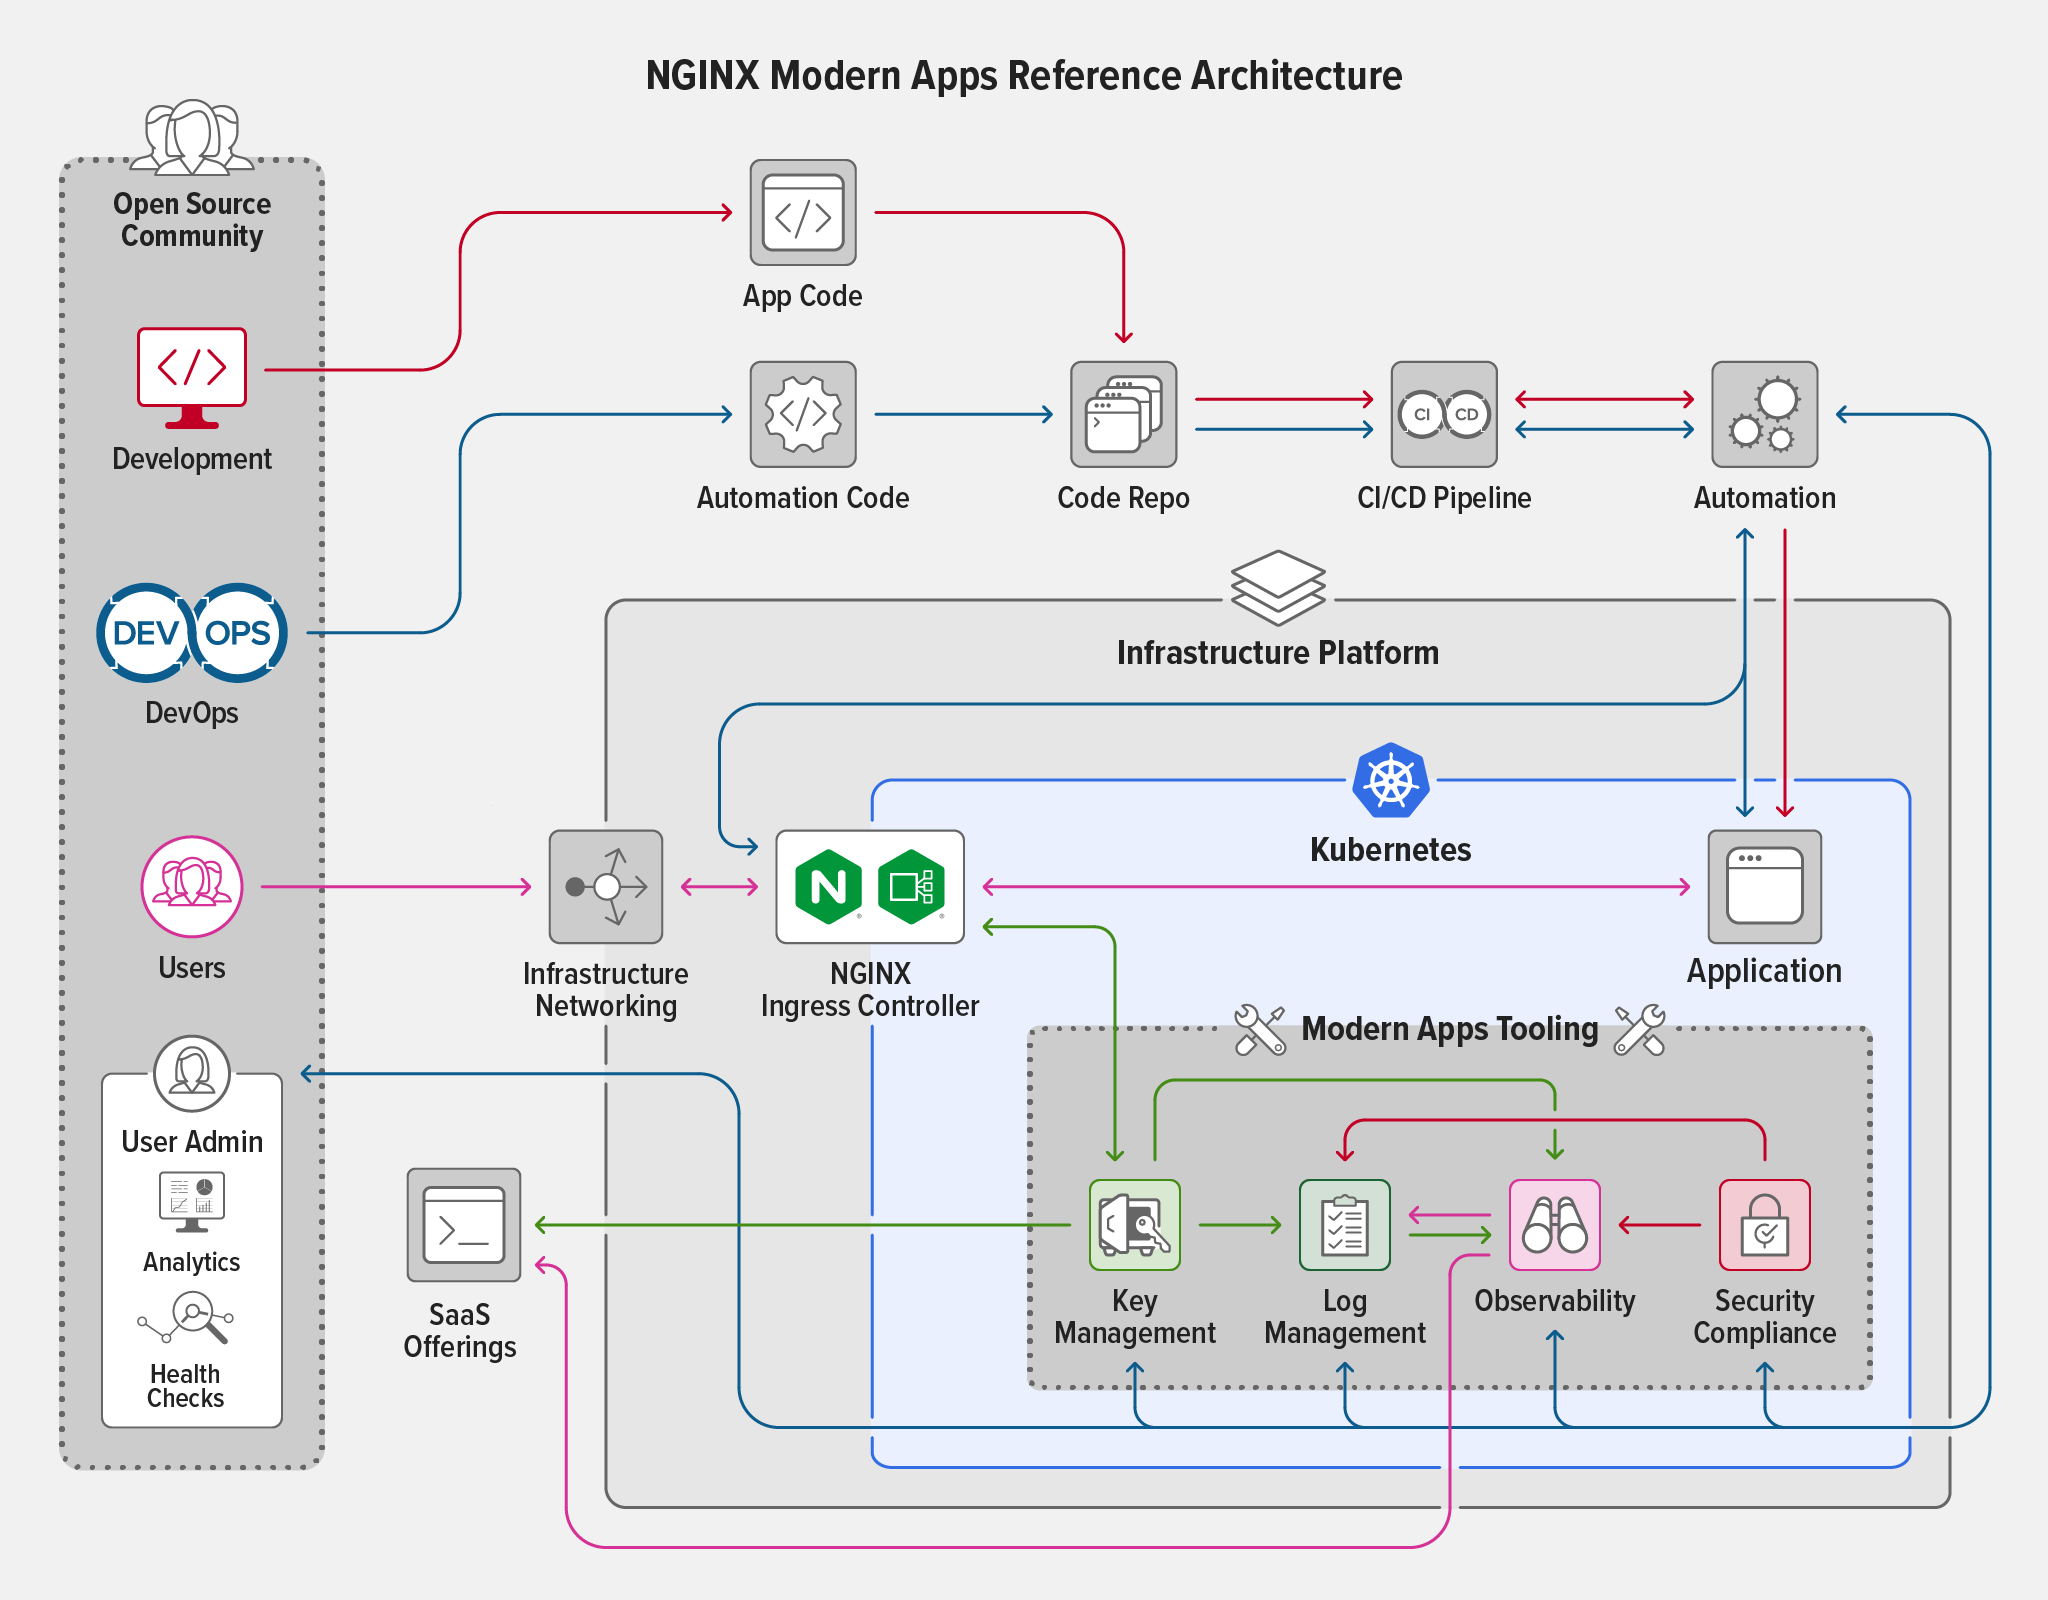
Télémétrie – Métriques, journalisation et traçage
Les principaux contributeurs de MARA ont l’expérience de l’exploitation de logiciels à grande échelle et savent ce qu’implique la fourniture de services sur les plans opérationnel, technique et managérial. Ils connaissent ce sentiment d’angoisse qui vous envahit lorsqu’une application ne fonctionne pas correctement et que vous ne disposez d’aucun moyen simple de déterminer précisément l’origine du problème. Une citation qui circule dans le monde du DevOps résume parfaitement la situation : « Déboguer des microservices, c’est comme résoudre une série d’enquêtes pour meurtre. »
Dans cette optique, nous avons fait de l’ajout de l’observabilité une priorité absolue de notre feuille de route à court terme. Dans ce contexte, l’observabilité englobe la gestion des journaux, les métriques et les données de traçage. Toutefois, la simple collecte de données ne suffit pas : vous devez pouvoir les analyser en profondeur et prendre des décisions éclairées sur ce qui se passe dans l’environnement.
Notre exploration des différentes options de traçage nous a conduits à choisir OpenTelemetry (OTEL), car cette solution prend en charge l’ensemble des données de télémétrie : journaux, métriques et traces. Nous avons envisagé une mise en œuvre dans laquelle l’agent OTEL collecte, traite et déduplique toutes les données de traçage avant de les transmettre au collecteur OTEL à des fins d’agrégation et d’exportation, avec un système de visualisation en fin de chaîne pour rendre les données exploitables. Cette approche offre aux utilisateurs le plus large éventail d’options pour afficher et analyser les données, tout en tirant parti de la norme OTEL afin de simplifier les étapes précédentes (collecte, agrégation, etc.).
Nous avons réalisé l’implémentation en deux étapes :
- Déployer l’opérateur OpenTelemetry pour Kubernetes afin de gérer un collecteur OTEL dans l’environnement
- Instrumenter l’application Bank of Sirius afin qu’elle émette des traces et des métriques
La version originale de MARA utilisait Elasticsearch avec Filebeat pour la journalisation. Bien que nous ayons envisagé de les remplacer par Grafana Loki, nous avons décidé de conserver la solution d’origine pour le moment. Concernant les métriques, nous avons constaté qu’il fallait revoir le déploiement initial reposant sur Prometheus et Grafana, en remplaçant la configuration Prometheus personnalisée que nous utilisions au départ par le chart Helm kube-prometheus-stack, maintenu par la communauté. Celui-ci déploie un environnement Prometheus complet comprenant Grafana, des exportateurs de nœuds, ainsi qu’un ensemble de tableaux de bord préconfigurés et de cibles de collecte adaptés à la gestion d’un environnement Kubernetes. Nous y avons ajouté des tableaux de bord supplémentaires pour F5 NGINX Ingress Controller et l’application Bank of Sirius.
Ceci n’est qu’un bref résumé de l’immense travail nécessaire à la mise en œuvre d’OTEL. Pour éviter à d’autres d’avoir à gravir la même courbe d’apprentissage abrupte, nous avons documenté l’intégralité du processus dans l’article Intégration d’OpenTelemetry à l’architecture de référence pour les applications modernes – Rapport d’avancement publié sur notre blog.
Options de déploiement – Kubeconfig
Dans la version initiale de MARA, nous avions choisi Amazon Elastic Kubernetes Service (EKS) comme environnement de déploiement. Depuis, de nombreux utilisateurs nous ont indiqué que, pour des raisons de coût, ils souhaitaient exécuter MARA dans des environnements « locaux » nécessitant moins de ressources, comme un laboratoire ou un poste de travail. La portabilité était l’un des principaux objectifs du projet initial (et le reste), c’était donc l’occasion de prouver que nous pouvions y parvenir. Pour faciliter la tâche, nous avons décidé de concevoir une procédure de déploiement pouvant s’exécuter sur n’importe quel cluster Kubernetes répondant à certaines exigences minimales.
Dans un premier temps, nous avons ajouté à MARA un nouveau projet Pulumi qui lit un fichier kubeconfig afin de communiquer avec le cluster Kubernetes. Ce projet fait le lien entre les projets Pulumi Kubernetes et les projets d’infrastructure (par exemple, les projets pour AWS et Digital Ocean). Concrètement, la création du projet kubeconfig facilite l’intégration d’un nouveau projet d’infrastructure. Si un projet d’infrastructure peut transmettre au projet kubeconfig un fichier kubeconfig, le nom du cluster et le contexte du cluster, le reste de la procédure de déploiement de MARA fonctionne de manière fluide.
Pour nos tests, nous avons utilisé plusieurs distributions Kubernetes faciles à installer et peu gourmandes en ressources processeur et mémoire, notamment K3s, Canonical MicroK8s et minikube. Toutes les distributions ont été déployées sur une machine virtuelle (VM) exécutant Ubuntu 21.10, dotée de 2 processeurs et de 16 Go de RAM. De plus, elles ont toutes été configurées pour prendre en charge les volumes persistants et les services Kubernetes de type LoadBalancer.
La partie la plus difficile de ce processus a été de travailler avec le registre privé utilisé pour le contrôleur NGINX Ingress personnalisé qui fait partie du projet. (Notez que lors du déploiement de MARA, vous pouvez utiliser le contrôleur NGINX Ingress standard basé sur NGINX Open Source ou NGINX Plus, ainsi que ce contrôleur NGINX Ingress personnalisé.) Nous avons constaté que nous devions dissocier notre logique de registre d’Amazon Elastic Container Registry (ECR) au profit d’une approche plus indépendante de la plateforme, une tâche actuellement en cours. Nous avons également constaté que notre logique de récupération du nom d’hôte de l’adresse de sortie était très spécifique à AWS Elastic Load Balancing (ELB) et devait être réécrite pour s’appliquer à d’autres cas d’utilisation.
Les scripts de gestion de MARA et les projets Pulumi utilisent actuellement une logique spécifique pour contourner les problèmes décrits ci-dessus. Pour l’instant, les déploiements basés sur la configuration Kubernetes doivent utiliser NGINX Ingress Controller (basé sur NGINX Open Source ou NGINX Plus) provenant des registres officiels de NGINX.
Nous avons ajouté plusieurs paramètres de réglage aux fichiers de configuration de MARA afin de prendre en charge les déploiements locaux qui ne disposent pas des ressources nécessaires à un déploiement dans le cloud. La plupart de ces paramètres concernent le nombre de réplicas requis pour les différents composants de l’Elastic Stack. À mesure que les tests progresseront, des paramètres supplémentaires seront ajoutés afin d’affiner la configuration de MARA en fonction des contraintes de ressources de l’environnement de déploiement.
Grâce à ces modifications, nous pouvons désormais effectuer des déploiements sur K3s, MicroK8s et Minikube, et nous avons testé avec succès cette logique sur Azure Kubernetes Service (AKS), Digital Ocean, Google Kubernetes Engine, Linode et Harvester de Rancher. Pour plus d’informations, consultez la page sur l’état des fournisseurs MARA ainsi que l’article MARA : désormais disponible sur votre poste de travail sur notre blog.
Collaboration avec les partenaires
Nos partenaires ont accueilli très favorablement notre travail avec MARA et nous ont apporté tout leur soutien. Nombre d’entre eux nous ont contactés pour en savoir plus sur le projet, découvrir comment l’exploiter avec leurs produits, voire y ajouter des fonctionnalités.
Nous avons choisi Pulumi comme composant central de MARA pour sa facilité d’utilisation et sa prise en charge de Python. Ce dernier étant un langage très populaire, le code de MARA est facilement compréhensible par une vaste communauté. En outre, la communauté dynamique de Pulumi et son engagement dans le projet ont servi de modèle pour l’implication communautaire que nous espérons susciter autour de MARA.
Fin 2021, nous avons collaboré avec Sumo Logic afin d’intégrer MARA à sa solution de surveillance du cloud avec NGINX Ingress Controller. Ce fut l’occasion de vérifier notre affirmation selon laquelle MARA est modulaire. Le défi consistait à remplacer Grafana, Prometheus et Elastic dans MARA par la solution Sumo Logic. Nous avons eu le plaisir de réussir à déployer la solution en suivant la même logique que pour nos autres déploiements, et de la configurer non seulement pour qu’elle se connecte au SaaS de Sumo Logic, mais aussi pour qu’elle collecte les métriques de notre environnement.
Dans le cadre de nos travaux avec OpenTelemetry, nous avons collaboré avec Lightstep et avons facilement reconfiguré notre collecteur OTEL afin d’exporter les traces et les métriques vers l’offre SaaS de Lightstep. Nous souhaitons vivement approfondir nos recherches dans ce domaine, car nous sommes convaincus qu’OTEL représente l’avenir de l’observabilité.
Leçons tirées… jusqu’à présent
Le principal enseignement que nous avons tiré jusqu’à présent est la pertinence d’une approche modulaire. Le travail réalisé avec Sumo Logic montre que nous pouvons combiner efficacement les composants MARA. Nous nous attendons à en avoir une nouvelle confirmation à mesure que nous intégrerons plus complètement OTEL à l’environnement. Nous avons indiqué précédemment que nous envisagions de remplacer Elasticsearch par Grafana Loki comme environnement de gestion des journaux, car cela réduit l’empreinte en ressources de la pile. Cela étant dit, nous préconisons une « modularité pragmatique » plutôt que de tomber dans l’excès en transformant chaque élément en microservice. Par exemple, s’il est pertinent de disposer d’un service spécialisé capable de traiter les journaux de nombreuses applications, la nécessité de recourir à des microservices distincts pour la collecte, le stockage et la visualisation des journaux est moins évidente.
Nous avons également constaté qu’il est utile de définir explicitement les valeurs par défaut dans la configuration, plutôt que de simplement omettre le paramètre concerné. Cela facilite la tâche des administrateurs à deux égards : ils n’ont pas besoin de mémoriser les valeurs par défaut et peuvent les modifier facilement en changeant simplement un paramètre qui figure déjà au bon endroit dans la configuration, avec la syntaxe appropriée.
Une autre leçon que nous avons apprise à nos dépens est que certaines solutions sont populaires non pas parce qu’elles sont les meilleures, mais parce qu’elles sont les plus faciles à installer ou qu’elles disposent du meilleur tutoriel. C’est pourquoi il est si important de remettre en question vos hypothèses et de consulter vos collègues pendant le processus de conception : une culture de communication ouverte contribue grandement à repérer et à corriger les problèmes en amont.
Cela dit, à plusieurs reprises, nous avons mis en œuvre une logique qui fonctionnait, mais qui nous enfermait dans une impasse ou entraînait d’autres problèmes. Par exemple, lorsque nous avons commencé à déployer des applications via Pulumi, nous utilisions des manifestes YAML pour les ConfigMaps, en nous appuyant sur les transformations Pulumi pour mettre à jour les variables. Cette approche fonctionnait, mais elle était loin d’être idéale pour plusieurs raisons, notamment en matière de maintenabilité. Lors de l’itération suivante, nous avons amélioré la lisibilité et la maintenabilité du code en utilisant kube2pulumi pour convertir les manifestes en code Pulumi, que nous pouvions ensuite utiliser pour créer les ConfigMaps.
Nous avons tiré un autre enseignement lorsqu’une fusion a introduit des paramètres non valides dans le fichier YAML de déploiement. Nous avons dû réécrire et examiner attentivement de grandes parties du YAML afin de nous assurer que le code était syntaxiquement correct et qu’il produisait le résultat souhaité, un processus frustrant et chronophage. Pour éviter que ce problème ne se reproduise, nous avons désormais automatisé l’analyse statique et la validation des fichiers YAML génériques ainsi que celles propres à Kuberneteslinting lors du processus de push sur GitHub.
Enfin, notre objectif a toujours été de veiller à ce que notre branche principale soit toujours exécutable. Il est frustrant de récupérer un nouveau projet et de devoir résoudre un problème introduit par les responsables du projet dans la branche principale. Malheureusement, nous avons échoué à plusieurs reprises sur ce point, notamment dans les exemples suivants concernant le sous-module Bank of Sirius :
- Nous avons malencontreusement oublié de remplacer le protocole de l’URL ssh:// par https://. Cela ne nous posait aucun problème, car nous utilisons tous
sshpour nous connecter à GitHub. En revanche, les utilisateurs qui ne disposaient pas d’une clé SSH pour GitHub ont été submergés de messages d’erreur lorsqu’ils ont tenté d’initialiser le sous-module. - Une version des scripts de gestion dépendait d’un paquet courant dont nous avions supposé à tort qu’il serait installé sur les machines de tout le monde, comme il l’est sur les nôtres.
- Lors de la réécriture de la logique de démarrage, nous avons oublié d’ajouter une vérification de la source du sous-module. Celui-ci contient les manifestes nécessaires au déploiement de Bank of Sirius et, malheureusement, les erreurs et avertissements générés lorsque ces manifestes n’étaient pas disponibles étaient suffisamment obscurs pour nous entraîner dans plusieurs jours de débogage de comportements étranges avant que nous n’en découvrions la cause profonde.
Et maintenant ?
Nous avons de grands projets pour les prochains mois de développement, notamment la refactorisation de la compilation de NGINX Ingress Controller, de la publication dans le registre et de la logique relative au nom d’hôte et à l’adresse IP de l’Ingress.
À chaque déploiement de MARA, nous avons constaté que les analyses et les attaques visant NGINX Ingress Controller commencent très rapidement. Cela nous a incités à intégrer NGINX Ingress Controller avec NGINX App Protect WAF dans MARA. Cette intégration présente à la fois le défi et l’occasion de déterminer la meilleure façon de gérer les journaux générés par App Protect.
Un autre changement que nous prévoyons d’apporter dans les mois à venir consiste à faire en sorte que tous les modules récupèrent les secrets depuis Kubernetes, plutôt que depuis Pulumi et Kubernetes. Ainsi, tous les modules utiliseront un référentiel de secrets commun, et l’administrateur pourra contrôler la manière dont les secrets y sont ajoutés. Nous développons actuellement un nouveau module qui lira les secrets depuis le référentiel choisi par l’utilisateur et créera les secrets Kubernetes correspondants.
MARA comprend actuellement un outil de génération de charge qui est une version améliorée et légèrement modifiée de l’outil basé sur Locust fourni avec l’application Bank of Anthos d’origine, à partir de laquelle nous avons créé un fork pour développer Bank of Sirius. Le nouvel outil de test que nous développons, Cicada Swarm, ne se contente pas de générer de la charge : il détecte et signale également les dépassements des seuils que vous avez définis pour les métriques, ce qui en fait un framework permettant de tester rapidement les performances de produits logiciels dans le cloud. Il utilise des techniques de parallélisation pour fournir des résultats de test avec le niveau de confiance dont vous avez besoin, une plus grande précision et une analyse de régression personnalisable afin de déterminer la réussite ou l’échec des builds dans vos pipelines CI/CD.
Enfin, nous ne pouvons pas parler de tests de charge sans évoquer la manière dont nous allons en mesurer l’impact, ce qui nous ramène à la télémétrie. Le potentiel d’OpenTelemetry nous enthousiasme et nous espérons bientôt disposer d’une implémentation plus complète. Même sans implémentation complète, notre objectif est de pouvoir exécuter un test, mesurer son impact et prendre des décisions opérationnelles en fonction des enseignements tirés des données.
Comme toujours, vos pull requests, signalements de problèmes et commentaires sont les bienvenus. Avec MARA, notre objectif est d’inciter la communauté à collaborer pour discuter, expérimenter, tester et améliorer de manière itérative différentes solutions potentielles, afin de mieux comprendre comment déployer et gérer au mieux une application moderne.
Articles connexes
Cet article fait partie d’une série. À mesure que nous enrichissons les fonctionnalités de MARA, nous en publions les détails sur le blog :
- Une nouvelle architecture de référence open source pour les applications modernes
- Intégration d’OpenTelemetry à l’architecture de référence pour les applications modernes – Rapport d’avancement
- MARA : désormais disponible sur un poste de travail près de chez vous
- Annonce de la version 1.0.0 de l’architecture de référence NGINX pour les applications modernes (cet article)
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.