Red Hat OpenShift Container Platform (OCP) est l’une des plateformes Kubernetes gérées les plus populaires et, à l’instar de ses concurrents, OCP intègre par défaut des outils de gestion du trafic pour aider les utilisateurs à démarrer rapidement. L’OCP Router – basé sur HAProxy – est le point d’entrée par défaut des clusters OCP. Il peut répartir la charge du trafic HTTP et WebSocket, prend en charge la terminaison TLS ainsi que le protocole TLS entre le routeur et les instances d’application, et peut répartir la charge des connexions TLS en mode passthrough.
Nos clients nous demandent souvent : « Pourquoi devrais-je utiliser NGINX Ingress Controller dans OpenShift alors que le Router est disponible gratuitement ? » Dans l’article « Pourquoi avez-vous besoin d’un contrôleur Ingress de niveau entreprise sur OpenShift », Max Mortillaro de GigaOm, auteur invité sur notre blog, présente plusieurs raisons qualitatives d’utiliser NGINX Ingress Controller : gestion avancée du trafic, facilité d’utilisation, validation JWT et intégration d’un WAF. Mais il est également important de répondre à cette question d’un point de vue quantitatif. C’est pourquoi nous avons testé les performances du Router et de NGINX Ingress Controller basé sur NGINX Plus (nginxinc/kubernetes-ingress) dans l’environnement OCP, au sein d’un déploiement dynamique où nous avons augmenté et réduit le nombre de serveurs en amont (back-end) pendant le test.
Lorsque nous effectuons des tests de performances, nous examinons deux facteurs pour évaluer les performances des outils :
- Facteur 1 : résultats de latence pour les déploiements dynamiquesNous constatons que la distribution des percentiles de latence est l’indicateur le plus efficace pour mesurer l’expérience de l’utilisateur final dans le cadre d’un déploiement dynamique. Plus un système ajoute de latence, plus l’expérience utilisateur est affectée. Nous avons également constaté que, pour obtenir une vision fidèle de l’expérience utilisateur, il est nécessaire d’inclure les latences correspondant aux percentiles supérieurs de la distribution. Pour une explication détaillée, consultez la section Résultats des performances de l’article NGINX et HAProxy : évaluer l’expérience utilisateur dans le cloud sur notre blog.
- Facteur 2 : délais d’expiration et erreursLorsqu’un système testé entraîne une latence dans un déploiement dynamique, c’est généralement parce qu’il gère difficilement les rechargements dynamiques, ce qui provoque des délais d’expiration ou des erreurs.
Résultats des tests de performance
Entrons directement dans le vif du sujet et examinons les résultats. Vous trouverez ensuite des informations détaillées sur la topologie et la méthode de test utilisées.
Comme indiqué précédemment, nous prenons en compte deux facteurs pour évaluer les performances : la latence et les délais d’expiration/erreurs.
Facteur 1 : distribution des percentiles de latence
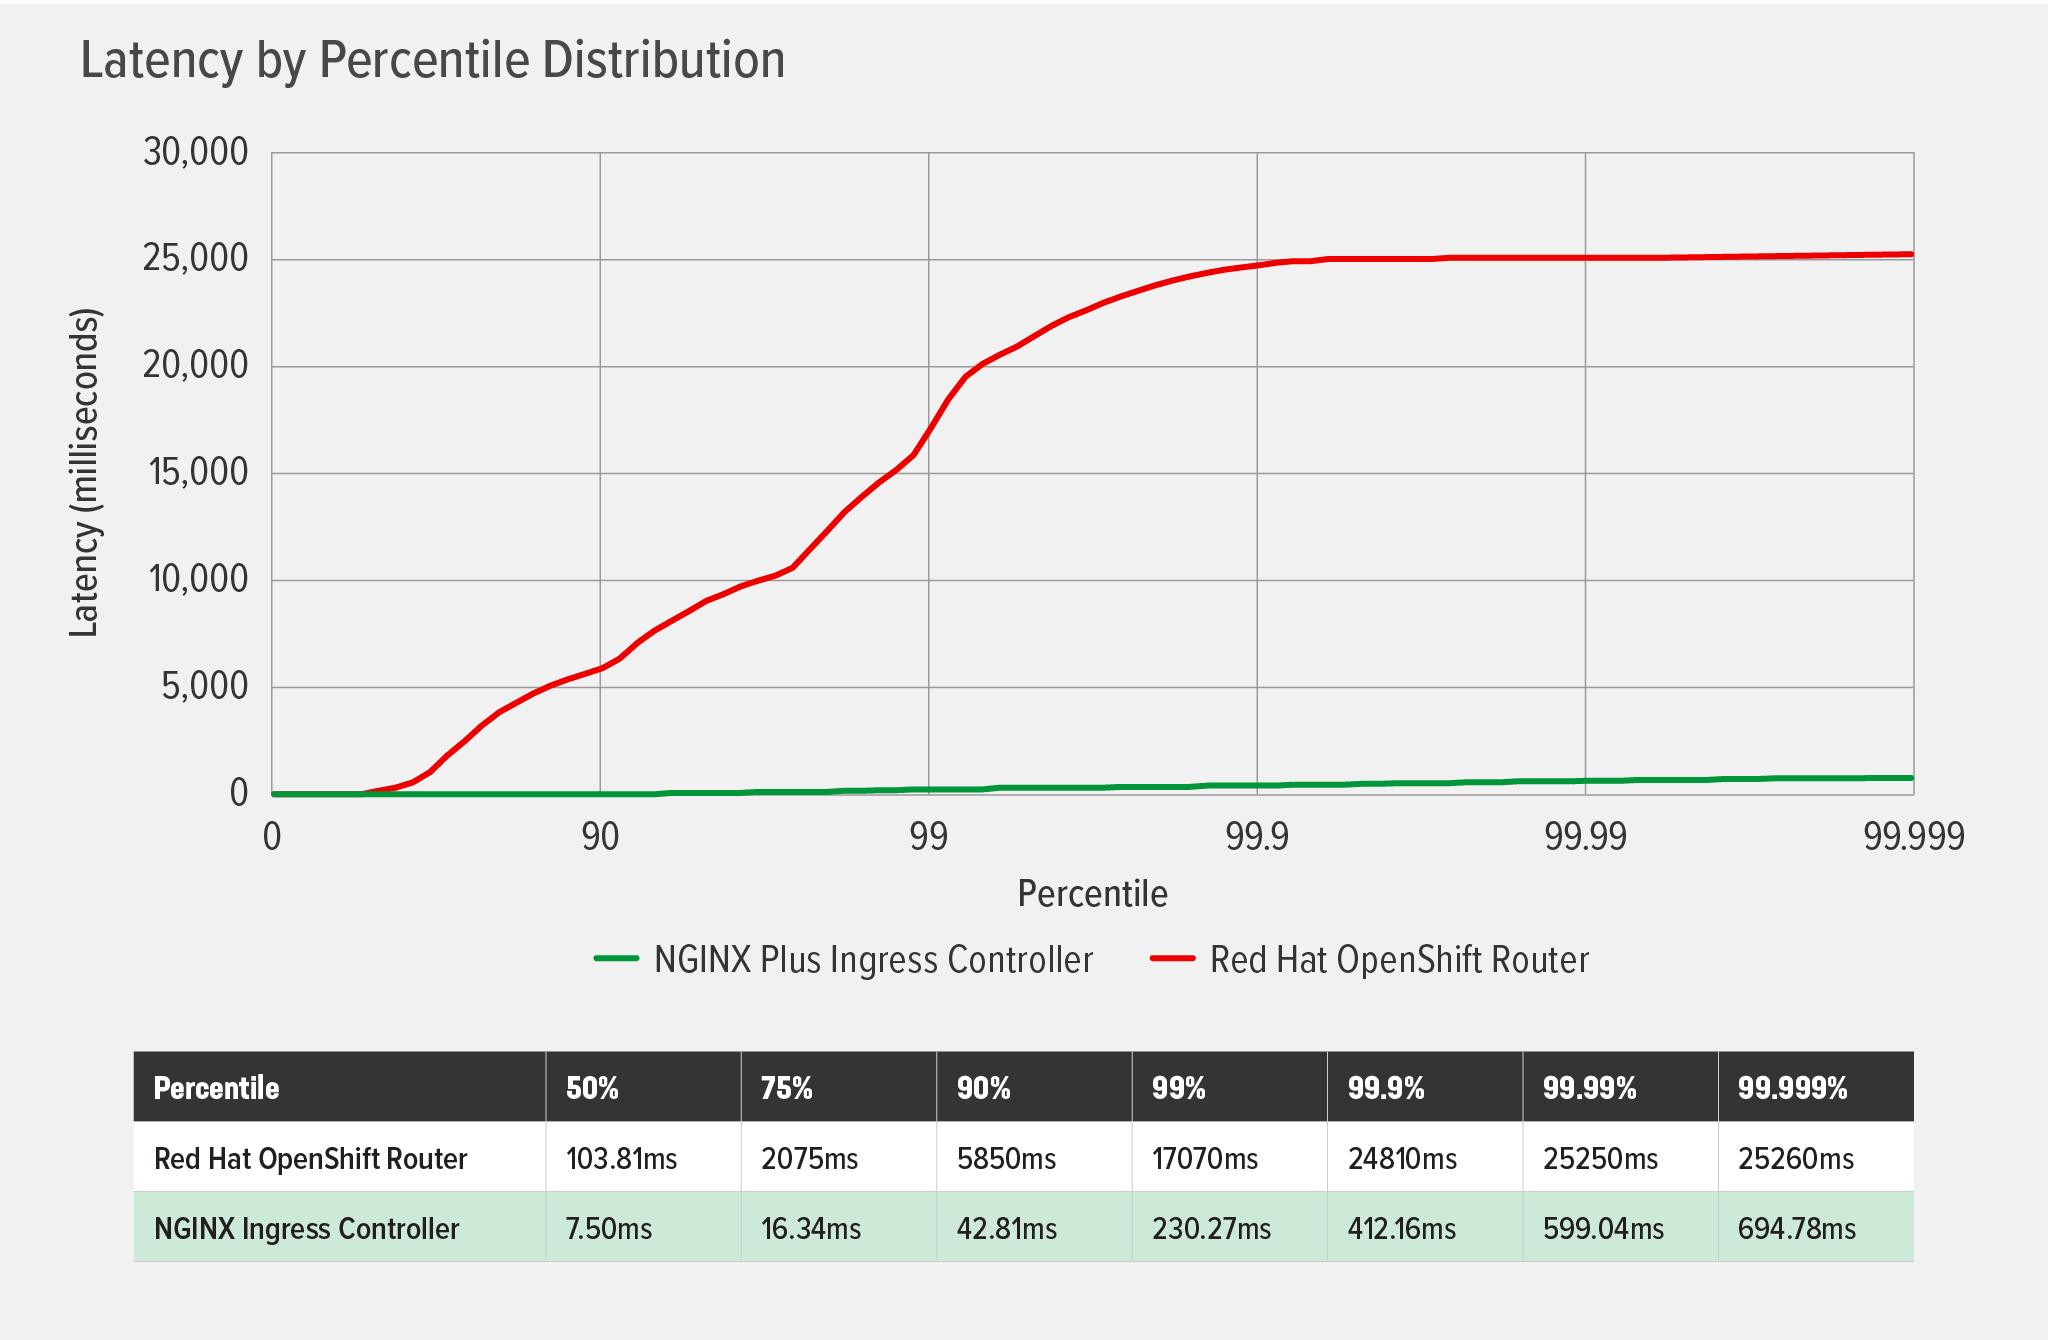
Comme l’illustre le graphique suivant, NGINX Ingress Controller a ajouté une latence négligeable tout au long du test, atteignant un maximum inférieur à 700 ms au 99,999e percentile. En revanche, OCP Router a ajouté de la latence dès des percentiles relativement bas, puis celle-ci a augmenté de manière exponentielle avant de se stabiliser à un peu plus de 25 000 ms (25 secondes) au 99,99e percentile. Cela montre que, lorsqu’il est soumis à une charge tandis que des modifications sont fréquemment apportées à l’environnement du cluster, le Router peut dégrader l’expérience utilisateur.
Facteur 2 : délais d’expiration et erreurs
La latence observée ci-dessus peut être attribuée à des délais d’expiration et à des erreurs : le routeur OCP a généré 260 expirations de connexion et 85 erreurs de lecture de socket, tandis que NGINX Ingress Controller n’en a généré aucune. Comme nous l’avons constaté lors d’autres tests de performances (voir Tests de performances des contrôleurs Ingress NGINX dans un environnement cloud Kubernetes dynamique), les délais d’expiration et les erreurs du routeur sont dus à la manière dont HAproxy gère les rechargements dynamiques. NGINX Ingress Controller, basé sur NGINX Plus, ne provoque ni délai d’expiration ni erreur, car il utilise l’API NGINX Plus pour mettre à jour dynamiquement la configuration NGINX lorsque les points de terminaison changent.
Configuration et méthodologie des tests
Topologie de test
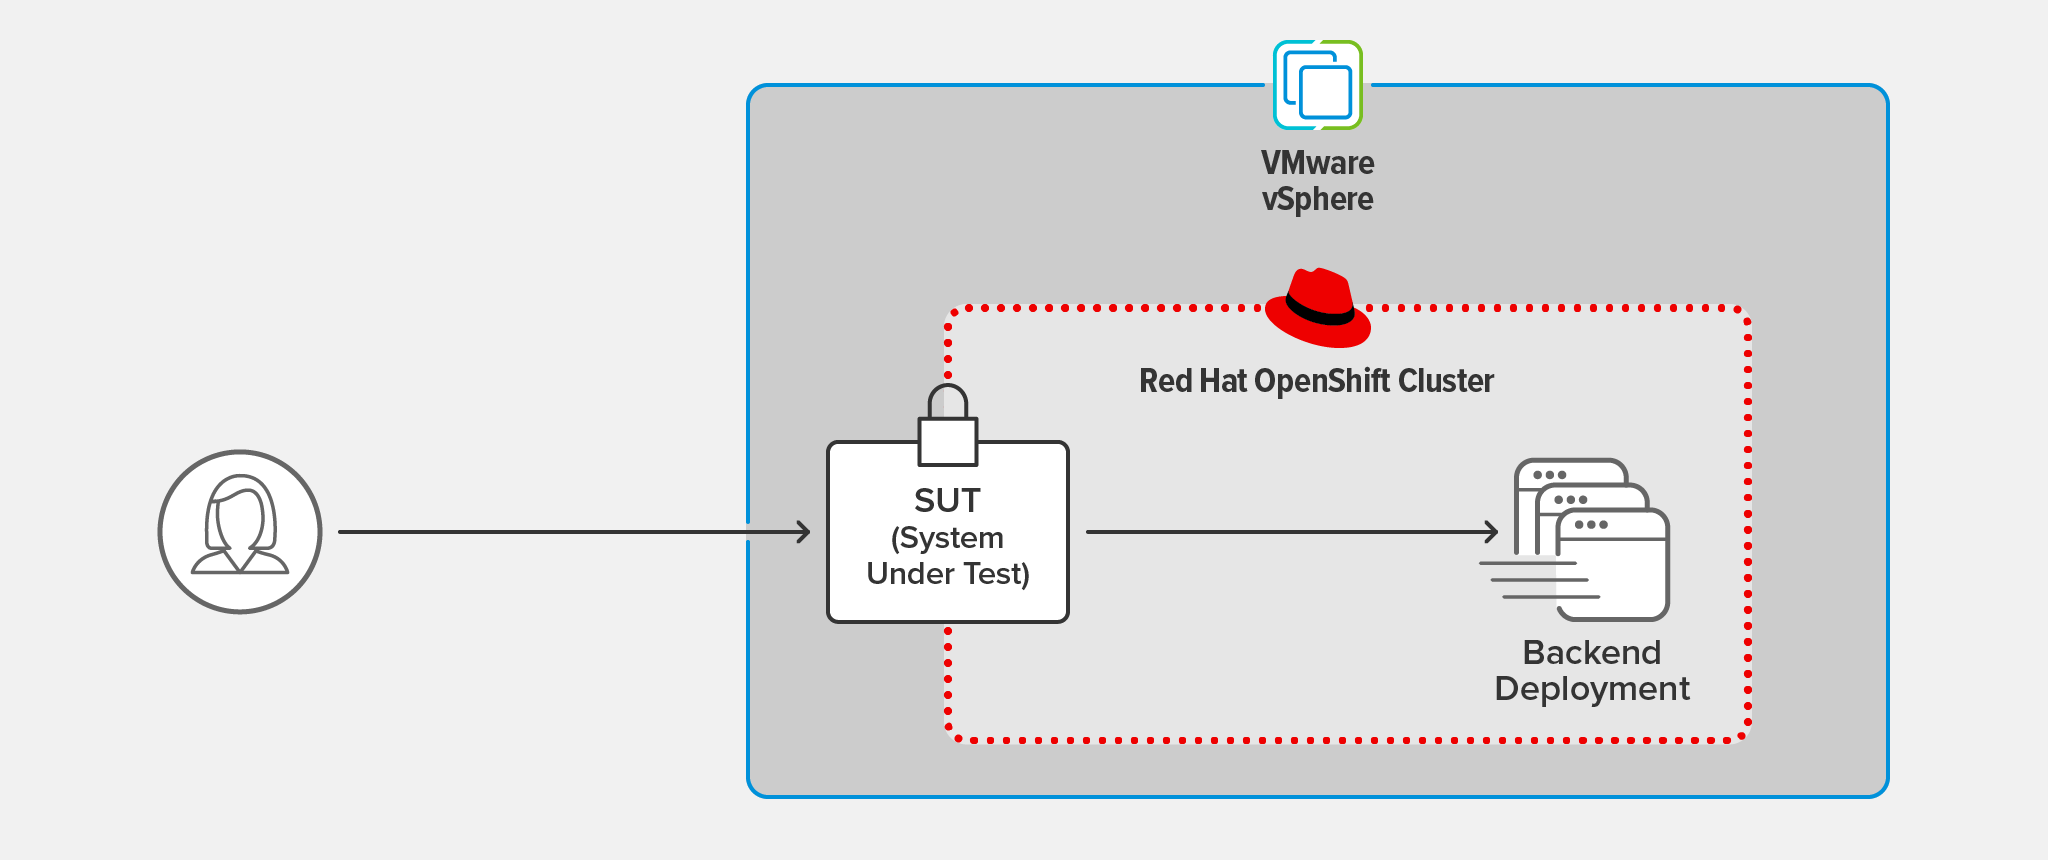
Nous avons exécuté les mêmes tests sur le contrôleur Ingress NGINX et sur le routeur OpenShift, utilisés comme système sous test (SUT). Le SUT mettait fin aux connexions TLS 1.3 provenant du client et transmettait la requête du client au déploiement backend via une connexion distincte.
Le client était hébergé sur une machine distincte exécutant CentOS 7 et située sur le même réseau local que le cluster OpenShift.
Le système testé et le déploiement du backend s’exécutaient dans un cluster OCP hébergé sur VMware vSphere 6.7.0.45100.
Pour le chiffrement TLS, nous avons utilisé RSA avec une clé de 2 048 bits et la confidentialité persistante (Perfect Forward Secrecy).
Chaque réponse de l’application backend contenait environ 1 Ko de métadonnées serveur de base, ainsi que le code d’état HTTP 200 OK.
Méthodologie de test
Déploiement du client
À l’aide de wrk2 (version 4.0.0), nous avons exécuté le script suivant sur la machine cliente, en lançant le test pendant 60 secondes (durée définie avec l’option -d) à un débit constant de 1 000 requêtes par seconde (RPS, défini avec l’option -R) :
./wrk -t 2 -c 50 -d 60s -R 1000 -L https://ingress-url:443/Logiciels utilisés pour le système testé
- OpenShift Platform version 4.8, qui inclut par défaut le routeur basé sur HAProxy
- NGINX Ingress Controller version 1.11.0 (NGINX Plus R22)
Déploiement du backend
Nous avons effectué des tests avec un déploiement dynamique de l’application backend, en utilisant le script suivant pour augmenter et réduire périodiquement le nombre de réplicas du backend. Cela simule un environnement OpenShift dynamique et permet de mesurer l’efficacité avec laquelle le contrôleur Ingress NGINX ou le routeur OCP s’adapte aux changements de points de terminaison.
while [ 1 -eq 1 ]
do
  oc scale deployment nginx-backend --replicas=4
  sleep 10
  oc scale deployment nginx-backend --replicas=2
  sleep 10
done
Conclusion
La plupart des entreprises qui adoptent des méthodologies fondées sur les microservices déploient de nouveaux développements via leurs pipelines CI/CD à une fréquence plus élevée que jamais. Il est donc essentiel de s’appuyer sur un plan de données dont les capacités et les performances évoluent au rythme de ces nouvelles méthodologies, sans perturber l’expérience utilisateur. Pour offrir une expérience utilisateur optimale, il faut garantir en permanence une faible latence pour toutes les connexions clientes, quelles que soient les circonstances.
D’après les résultats de performance, NGINX Ingress Controller offre une expérience utilisateur optimale dans les environnements conteneurisés où les besoins d’itération et d’amélioration du développement sont importants.
Pour commencer, téléchargez une version d’essai gratuite de NGINX Ingress Controller et découvrez comment effectuer le déploiement à l’aide de NGINX Ingress Operator.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.