Il est bien connu que NGINX utilise une approche asynchrone et événementielle pour gérer les connexions. Cela signifie qu’au lieu de créer un processus ou un thread dédié supplémentaire pour chaque requête (comme le font les serveurs dotés d’une architecture traditionnelle), il gère plusieurs connexions et requêtes au sein d’un même processus de travail. Pour ce faire, NGINX utilise des sockets en mode non bloquant et des méthodes efficaces telles que epoll et kqueue.
Comme le nombre de processus complets est faible (généralement un seul par cœur de processeur) et constant, la consommation de mémoire est nettement réduite et aucun cycle processeur n’est gaspillé en changements de contexte. Les avantages d’une telle approche sont bien connus, comme l’illustre NGINX lui-même. Il gère avec succès des millions de requêtes simultanées et offre une excellente évolutivité.
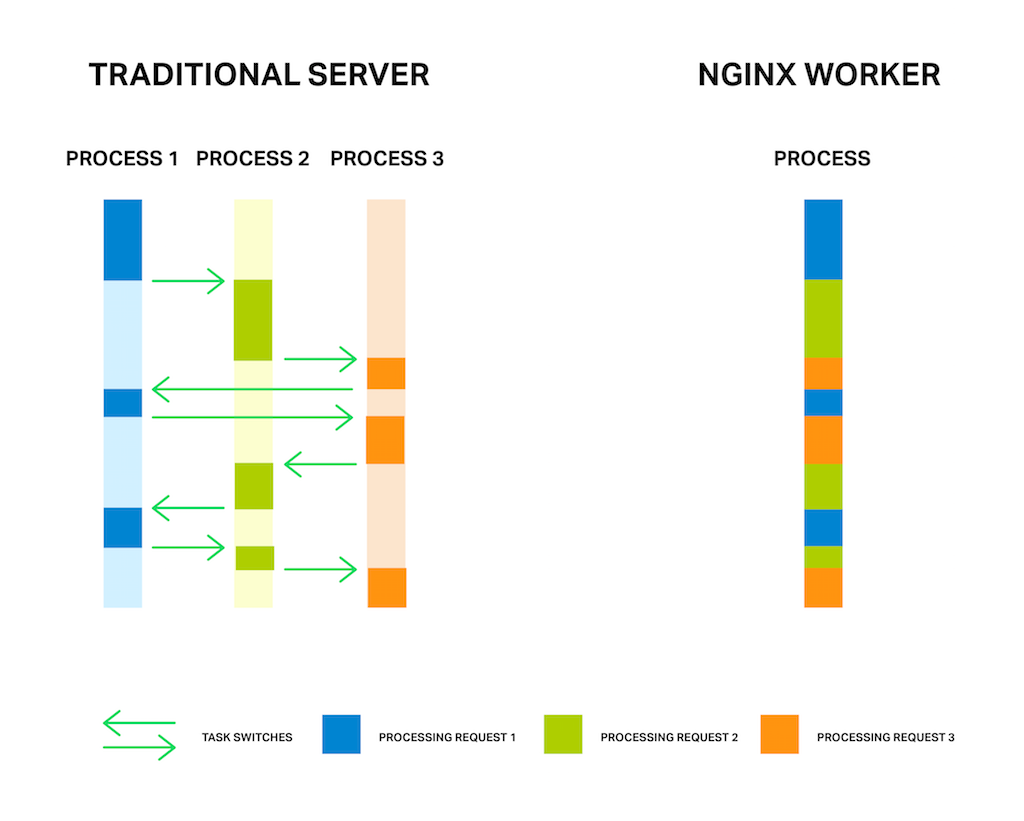
Mais l’approche asynchrone pilotée par les événements présente encore un problème. Ou, comme j’aime à le voir, un « ennemi ». Et cet ennemi porte un nom : le blocage. Malheureusement, de nombreux modules tiers utilisent des appels bloquants, et les utilisateurs (et parfois même les développeurs de ces modules) n’en connaissent pas les inconvénients. Les opérations bloquantes peuvent nuire aux performances de NGINX et doivent être évitées à tout prix.
Même dans le code officiel actuel de NGINX, il n’est pas toujours possible d’éviter les opérations bloquantes. Pour résoudre ce problème, le nouveau mécanisme de « pools de threads » a été implémenté dans NGINX version 1.7.11 et NGINX Plus version 7. Nous verrons plus loin de quoi il s’agit et comment il est censé être utilisé. Pour l’heure, allons à la rencontre de notre ennemi.
Note de la rédaction – Pour une présentation de NGINX Plus R7, consultez « Présentation de NGINX Plus R7 » sur notre blog.
Pour une présentation détaillée des autres nouvelles fonctionnalités de NGINX Plus R7, consultez les articles de blog connexes suivants :
- HTTP/2 désormais entièrement pris en charge dans NGINX Plus
- Partitionnement des sockets dans NGINX
- Le nouveau tableau de bord NGINX Plus dans la version 7<.htmla>
- Équilibrage de charge TCP dans NGINX Plus R7<.htmla>
Le problème
Tout d’abord, pour mieux comprendre le problème, quelques mots sur le fonctionnement de NGINX.
De manière générale, NGINX est un gestionnaire d’événements, un contrôleur qui reçoit du noyau des informations sur tous les événements survenant au niveau des connexions, puis indique au système d’exploitation ce qu’il doit faire. En réalité, NGINX effectue tout le travail complexe en orchestrant le système d’exploitation, tandis que ce dernier se charge des tâches courantes de lecture et d’envoi des octets. Il est donc essentiel que NGINX réagisse rapidement et en temps voulu.
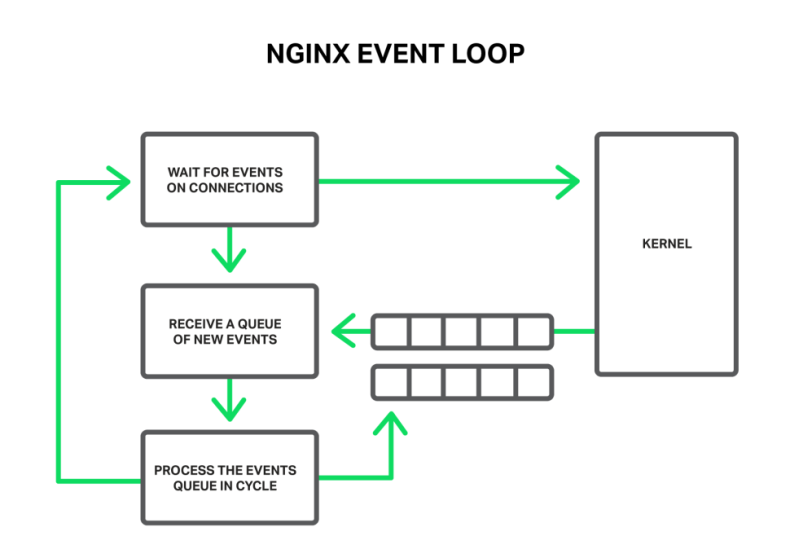
Les événements peuvent être des expirations de délai, des notifications indiquant que des sockets sont prêts pour la lecture ou l’écriture, ou encore des notifications signalant qu’une erreur s’est produite. NGINX reçoit un ensemble d’événements, puis les traite un par un en effectuant les actions nécessaires. L’ensemble du traitement s’effectue donc dans un seul thread, au moyen d’une simple boucle parcourant une file d’attente. NGINX retire un événement de la file, puis y réagit, par exemple en écrivant dans un socket ou en lisant depuis celui-ci. Dans la plupart des cas, cette opération est extrêmement rapide (elle ne nécessite parfois que quelques cycles de processeur pour copier des données en mémoire), et NGINX traite en un instant tous les événements de la file d’attente.
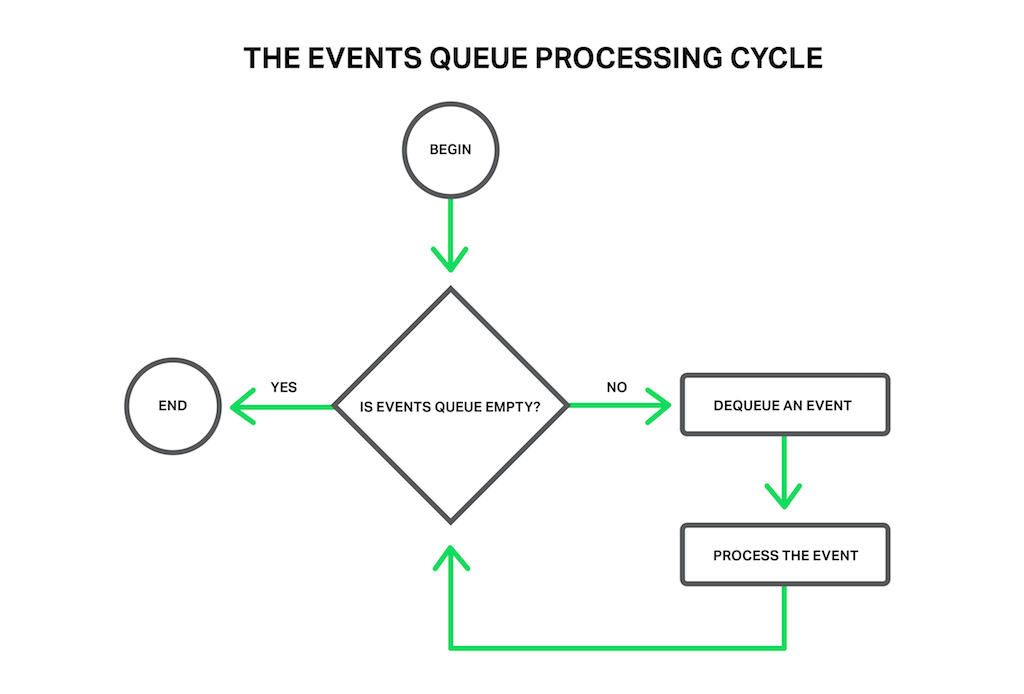
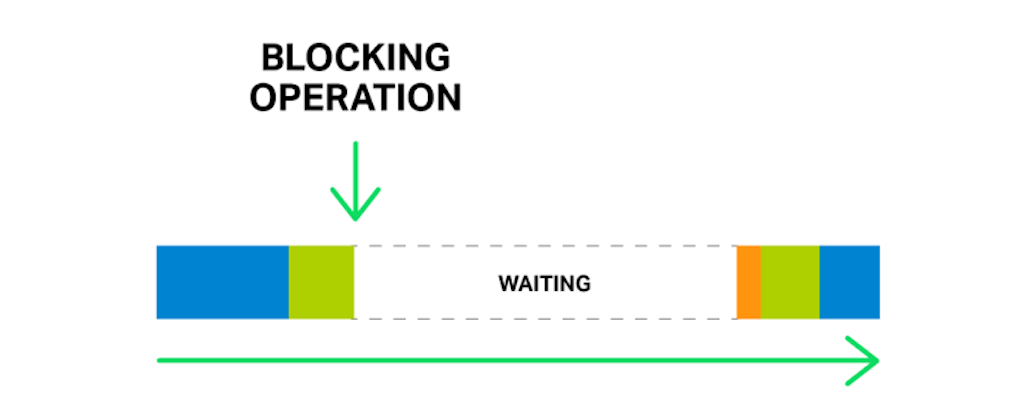
Mais que se passera-t-il si une opération longue et lourde se produit ? L’ensemble du cycle de traitement des événements restera bloqué en attendant que cette opération se termine.
Ainsi, par « opération bloquante », nous entendons toute opération qui interrompt le cycle de traitement des événements pendant une durée significative. Une opération peut être bloquante pour diverses raisons. Par exemple, NGINX peut être occupé par un traitement long et gourmand en ressources processeur, ou devoir attendre de pouvoir accéder à une ressource (comme un disque dur, un mutex ou un appel à une fonction de bibliothèque qui récupère de manière synchrone les réponses d’une base de données, etc.). Le point essentiel est que, pendant le traitement de telles opérations, le processus de travail ne peut rien faire d’autre ni traiter d’autres événements, même si des ressources système supplémentaires sont disponibles et que certains événements de la file d’attente pourraient les utiliser.
Imaginez un vendeur dans un magasin, avec une longue file d’attente devant lui. La première personne dans la file demande un article qui n’est pas disponible dans le magasin, mais qui se trouve dans l’entrepôt. Le vendeur part donc le chercher. Toute la file doit alors attendre quelques heures qu’il revienne avec l’article, au grand mécontentement de chacun. Imaginez la réaction des clients ! Le temps d’attente de chaque personne dans la file s’allonge de plusieurs heures, alors même que les articles qu’elles souhaitent acheter se trouvent peut-être juste là, dans le magasin.
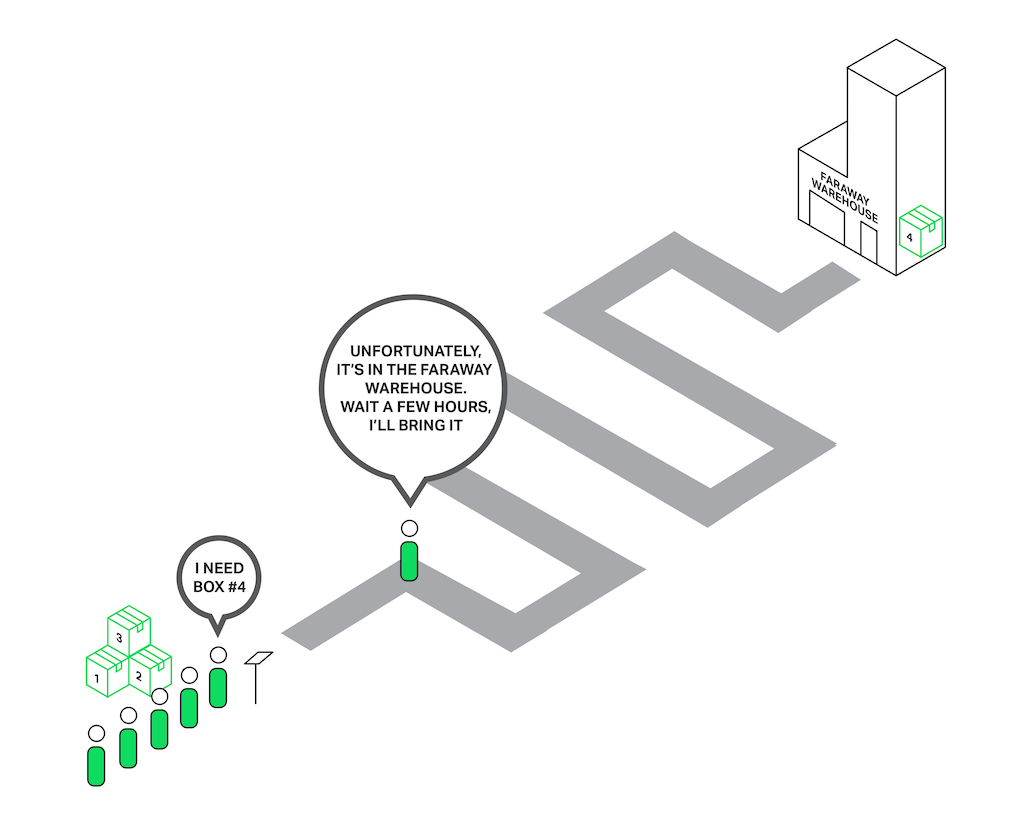
Une situation presque identique se produit avec NGINX lorsqu’il demande à lire un fichier qui n’est pas mis en cache en mémoire et doit donc être lu sur le disque. Les disques durs sont lents (en particulier les disques mécaniques) et, même si les autres requêtes en attente dans la file n’ont pas forcément besoin d’accéder au disque, elles sont tout de même contraintes d’attendre. Par conséquent, les temps de latence augmentent et les ressources du système ne sont pas pleinement exploitées.
Certains systèmes d’exploitation proposent une interface asynchrone pour la lecture et l’envoi de fichiers, et NGINX peut l’utiliser (voir la directive aio). FreeBSD en est un bon exemple. Malheureusement, on ne peut pas en dire autant de Linux. Bien que Linux propose une forme d’interface asynchrone pour la lecture de fichiers, celle-ci présente quelques inconvénients majeurs. L’un d’eux concerne les contraintes d’alignement pour l’accès aux fichiers et les tampons, mais NGINX les gère correctement. Le second problème est toutefois plus grave. L’interface asynchrone exige que l’indicateur O_DIRECT soit défini sur le descripteur de fichier, ce qui signifie que tout accès au fichier contournera le cache en mémoire et augmentera la charge sur les disques durs. Cette solution est donc loin d’être optimale dans de nombreux cas.
Pour résoudre ce problème en particulier, les pools de threads ont été introduits dans NGINX 1.7.11 et NGINX Plus version 7.
Voyons maintenant plus en détail ce que sont les pools de threads et comment ils fonctionnent.
Pools de threads
Revenons à notre pauvre vendeur qui va chercher des marchandises dans un entrepôt éloigné. Mais il est devenu plus malin (peut-être après avoir été passé à tabac par une foule de clients furieux ?) et a fait appel à un service de livraison. Désormais, lorsque quelqu’un demande un article provenant de cet entrepôt, au lieu d’aller le chercher lui-même, il transmet simplement la commande au service de livraison, qui s’en charge pendant que notre vendeur continue de servir les autres clients. Ainsi, seuls les clients dont les articles ne sont pas en magasin doivent attendre la livraison, tandis que les autres peuvent être servis immédiatement.
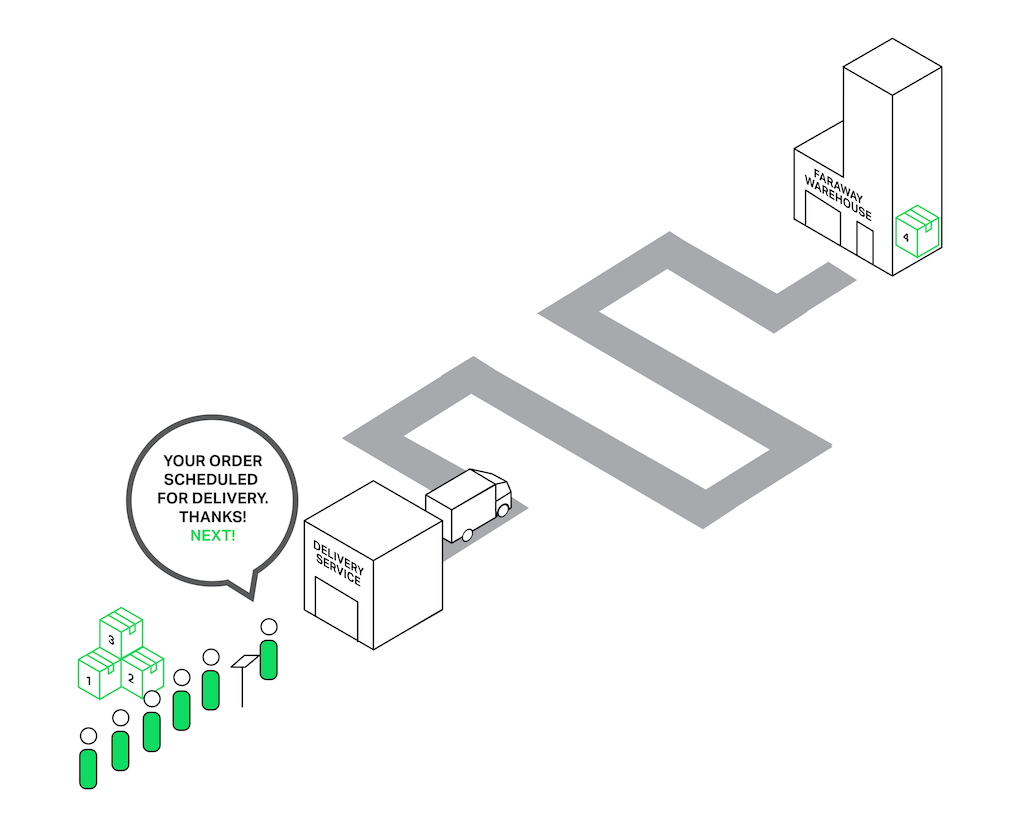
Dans le contexte de NGINX, le pool de threads remplit les fonctions du service de livraison. Il se compose d’une file d’attente de tâches et de plusieurs threads qui traitent cette file. Lorsqu’un processus worker doit effectuer une opération potentiellement longue, au lieu de la traiter lui-même, il place une tâche dans la file d’attente du pool, où elle peut être récupérée et traitée par n’importe quel thread disponible.
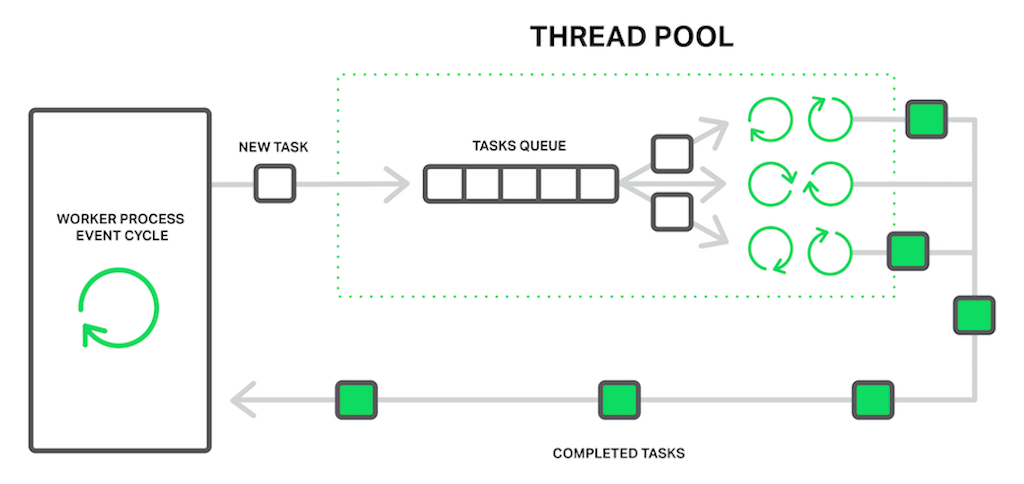
Il semble donc que nous ayons une autre file d’attente. En effet. Mais dans ce cas, la file d’attente est limitée par une ressource spécifique. Nous ne pouvons pas lire les données d’un disque plus vite que celui-ci ne peut les fournir. Désormais, au moins, le disque ne retarde pas le traitement des autres événements et seules les requêtes qui doivent accéder à des fichiers sont mises en attente.
L’opération de « lecture depuis le disque » est souvent citée comme l’exemple le plus courant d’une opération bloquante, mais l’implémentation des pools de threads dans NGINX peut en réalité être utilisée pour toutes les tâches qu’il n’est pas approprié de traiter dans le cycle de travail principal.
À l’heure actuelle, le déport vers les pools de threads n’est mis en œuvre que pour trois opérations essentielles : l’appel système read() sur la plupart des systèmes d’exploitation, sendfile() sous Linux et aio_write() sous Linux, utilisé lors de l’écriture de certains fichiers temporaires, tels que ceux du cache. Nous continuerons à tester l’implémentation et à en mesurer les performances. Dans les prochaines versions, nous pourrons déporter d’autres opérations vers les pools de threads si cela présente un avantage manifeste.
Note de la rédaction – La prise en charge de l’ aio_write() appel système a été ajoutée dans NGINX 1.9.13 et NGINX Plus R9.
Analyse comparative des performances
Il est temps de passer de la théorie à la pratique. Pour illustrer l’effet de l’utilisation de pools de threads, nous allons réaliser un benchmark synthétique qui simule la pire combinaison d’opérations bloquantes et non bloquantes.
Cela nécessite un jeu de données dont la taille dépasse assurément la capacité de la mémoire. Sur une machine dotée de 48 Go de RAM, nous avons généré 256 Go de données aléatoires réparties dans des fichiers de 4 Mo, puis configuré NGINX 1.9.0 pour les servir.
La configuration est assez simple :
worker_processes 16;
events {
    accept_mutex off;
}

http {
    include mime.types;
    default_type application/octet-stream;

    access_log off;
    sendfile on;
    sendfile_max_chunk 512k;

    server {
        listen 8000;

        location / {
            root /storage;
        }
    }
}
Comme vous pouvez le constater, certains réglages ont été effectués afin d’améliorer les performances : logging et accept_mutex ont été désactivés, sendfile a été activé et sendfile_max_chunk a été défini. Cette dernière directive permet de réduire la durée maximale des appels bloquants à sendfile() : NGINX n’essaiera pas d’envoyer le fichier entier en une seule fois, mais procédera par blocs de 512 Ko.
La machine est équipée de deux processeurs Intel Xeon E5645 (soit 12 cœurs et 24 threads avec l’Hyper-Threading au total) et d’une interface réseau à 10 Gbit/s. Le sous-système de stockage se compose de quatre disques durs Western Digital WD1003FBYX configurés en RAID 10. L’ensemble fonctionne sous Ubuntu Server 14.04.1 LTS.
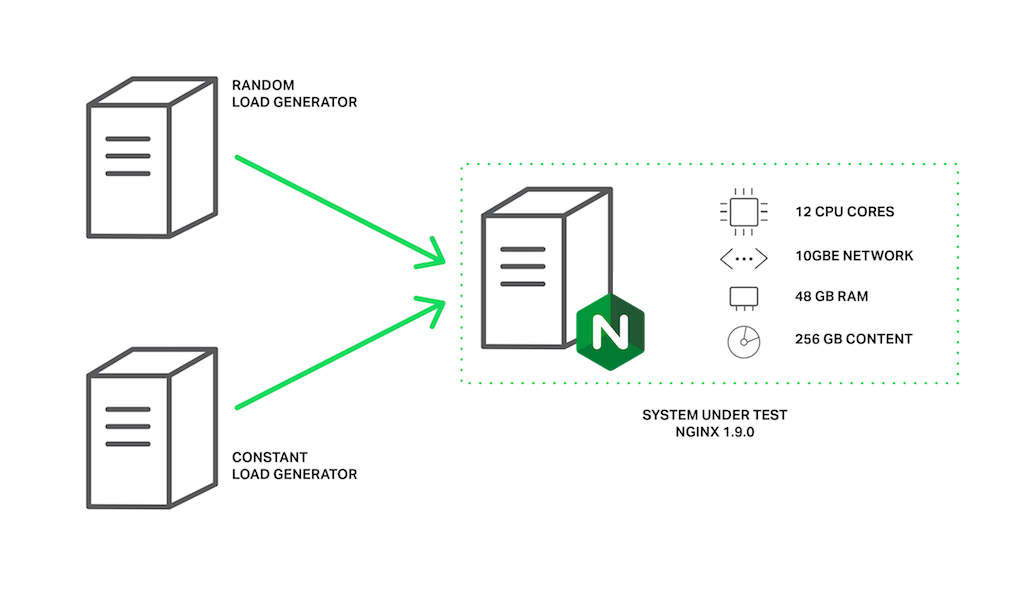
Les clients sont représentés par deux machines aux caractéristiques identiques. Sur l’une d’elles, wrk génère une charge à l’aide d’un script Lua. Ce script demande des fichiers à notre serveur dans un ordre aléatoire au moyen de 200 connexions parallèles, et chaque requête est susceptible d’entraîner un défaut de cache et une lecture bloquante sur le disque. Appelons cette charge la charge aléatoire.
Sur la deuxième machine cliente, nous exécuterons une autre instance de wrk qui demandera plusieurs fois le même fichier au moyen de 50 connexions parallèles. Comme ce fichier sera fréquemment consulté, il restera en permanence en mémoire. Dans des circonstances normales, NGINX traiterait ces requêtes très rapidement, mais les performances diminueront si les processus de travail sont bloqués par d’autres requêtes. Appelons cette charge la charge constante.
Les performances seront mesurées en surveillant le débit de la machine serveur à l’aide de ifstat et en récupérant les résultats de wrk sur le second client.
À présent, le premier test sans pools de threads ne donne pas de résultats très encourageants :
% ifstat -bi eth2eth2
Kbps in  Kbps out
5531.24  1.03e+06
4855.23  812922.7
5994.66  1.07e+06
5476.27  981529.3
6353.62  1.12e+06
5166.17  892770.3
5522.81  978540.8
6208.10  985466.7
6370.79  1.12e+06
6123.33  1.07e+06
Comme vous pouvez le constater, avec cette configuration, le serveur est capable de générer au total environ 1 Gbit/s de trafic. Dans la sortie de « top », nous pouvons voir que tous les processus de travail passent la majeure partie de leur temps à effectuer des E/S bloquantes (ils sont dans l’état « D ») :
top - 10:40:47 up 11 days,  1:32,  1 user,  load average: 49.61, 45.77 62.89Tasks: 375 total,  2 running, 373 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.0 us,  0.3 sy,  0.0 ni, 67.7 id, 31.9 wa,  0.0 hi,  0.0 si,  0.0 st
KiB Mem:  49453440 total, 49149308 used,   304132 free,    98780 buffers
KiB Swap: 10474236 total,    20124 used, 10454112 free, 46903412 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4639 vbart    20   0   47180  28152     496 D   0.7  0.1  0:00.17 nginx
 4632 vbart    20   0   47180  28196     536 D   0.3  0.1  0:00.11 nginx
 4633 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.11 nginx
 4635 vbart    20   0   47180  28136     480 D   0.3  0.1  0:00.12 nginx
 4636 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.14 nginx
 4637 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.10 nginx
 4638 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4640 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4641 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4642 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.11 nginx
 4643 vbart    20   0   47180  28276     536 D   0.3  0.1  0:00.29 nginx
 4644 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.11 nginx
 4645 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.17 nginx
 4646 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4647 vbart    20   0   47180  28208     532 D   0.3  0.1  0:00.17 nginx
 4631 vbart    20   0   47180    756     252 S   0.0  0.1  0:00.00 nginx
 4634 vbart    20   0   47180  28208     536 D   0.0  0.1  0:00.11 nginx< 4648 vbart 20 0 25232 1956 1160 R 0.0 0.0 0:00.08 top
25921 vbart    20   0  121956   2232    1056 S   0.0  0.0  0:01.97 sshd
25923 vbart    20   0   40304   4160    2208 S   0.0  0.0  0:00.53 zsh
Dans ce cas, le débit est limité par le sous-système de stockage, tandis que le processeur reste inactif la plupart du temps. Les résultats obtenus avec wrk sont également très faibles :
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg    Stdev     Max  +/- Stdev
    Latency     7.42s  5.31s   24.41s   74.73%
    Req/Sec     0.15    0.36     1.00    84.62%
  488 requests in 1.01m, 2.01GB read
Requests/sec:      8.08
Transfer/sec:     34.07MB
Et n’oubliez pas qu’il s’agit du fichier qui devrait être servi depuis la mémoire ! Ces temps de latence excessivement élevés s’expliquent par le fait que tous les processus de travail sont occupés à lire des fichiers sur les disques afin de répondre à la charge aléatoire générée par les 200 connexions du premier client, et ne peuvent donc pas traiter nos requêtes dans les délais impartis.
Il est temps de mettre nos pools de threads à contribution. Pour cela, il suffit d’ajouter la directive « aio threads » au bloc « location »:
location / {    root /storage;
    aio threads;
}
et demandez à NGINX de recharger sa configuration.
Après cela, nous répétons le test :
% ifstat -bi eth2eth2
Kbps in  Kbps out
60915.19  9.51e+06
59978.89  9.51e+06
60122.38  9.51e+06
61179.06  9.51e+06
61798.40  9.51e+06
57072.97  9.50e+06
56072.61  9.51e+06
61279.63  9.51e+06
61243.54  9.51e+06
59632.50  9.50e+06
Notre serveur atteint désormais 9,5 Gbit/s, contre environ 1 Gbit/s sans pools de threads !
Il pourrait probablement fournir un débit encore plus élevé, mais il a déjà atteint la capacité maximale du réseau en pratique. Dans ce test, NGINX est donc limité par l’interface réseau. Les processus de travail passent la majeure partie de leur temps en veille, dans l’attente de nouveaux événements (ils sont à l’état S dans top) :
top - 10:43:17 up 11 days,  1:35,  1 user,  load average: 172.71, 93.84, 77.90Tasks: 376 total,  1 running, 375 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.2 us,  1.2 sy,  0.0 ni, 34.8 id, 61.5 wa,  0.0 hi,  2.3 si,  0.0 st
KiB Mem:  49453440 total, 49096836 used,   356604 free,    97236 buffers
KiB Swap: 10474236 total,    22860 used, 10451376 free, 46836580 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4654 vbart    20   0  309708  28844     596 S   9.0  0.1  0:08.65 nginx
 4660 vbart    20   0  309748  28920     596 S   6.6  0.1  0:14.82 nginx
 4658 vbart    20   0  309452  28424     520 S   4.3  0.1  0:01.40 nginx
 4663 vbart    20   0  309452  28476     572 S   4.3  0.1  0:01.32 nginx
 4667 vbart    20   0  309584  28712     588 S   3.7  0.1  0:05.19 nginx
 4656 vbart    20   0  309452  28476     572 S   3.3  0.1  0:01.84 nginx
 4664 vbart    20   0  309452  28428     524 S   3.3  0.1  0:01.29 nginx
 4652 vbart    20   0  309452  28476     572 S   3.0  0.1  0:01.46 nginx
 4662 vbart    20   0  309552  28700     596 S   2.7  0.1  0:05.92 nginx
 4661 vbart    20   0  309464  28636     596 S   2.3  0.1  0:01.59 nginx
 4653 vbart    20   0  309452  28476     572 S   1.7  0.1  0:01.70 nginx
 4666 vbart    20   0  309452  28428     524 S   1.3  0.1  0:01.63 nginx
 4657 vbart    20   0  309584  28696     592 S   1.0  0.1  0:00.64 nginx
 4655 vbart    20   0  30958   28476     572 S   0.7  0.1  0:02.81 nginx
 4659 vbart    20   0  309452  28468     564 S   0.3  0.1  0:01.20 nginx
 4665 vbart    20   0  309452  28476     572 S   0.3  0.1  0:00.71 nginx 5180 vbart 20 0 25232 1952 1156 R 0.0 0.0 0:00.45 top
 4651 vbart    20   0   20032    752     252 S   0.0  0.0  0:00.00 nginx
25921 vbart    20   0  121956   2176    1000 S   0.0  0.0  0:01.98 sshd
25923 vbart    20   0   40304   3840    2208 S   0.0  0.0  0:00.54 zsh
Il reste encore beaucoup de ressources CPU disponibles.
Les résultats de « wrk » :
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg      Stdev     Max  +/- Stdev
    Latency   226.32ms  392.76ms   1.72s   93.48%
    Req/Sec    20.02     10.84    59.00    65.91%
  15045 requests in 1.00m, 58.86GB read
Requests/sec:    250.57
Transfer/sec:      0.98GB
Le temps moyen nécessaire pour servir un fichier de 4 Mo est passé de 7,42 secondes à 226,32 millisecondes (soit 33 fois moins), et le nombre de requêtes par seconde a été multiplié par 31 (250 contre 8) !
Cela s’explique par le fait que nos requêtes n’attendent plus d’être traitées dans la file d’attente des événements pendant que les processus de travail sont bloqués par des opérations de lecture, mais sont prises en charge par des threads disponibles. Tandis que le sous-système de disque s’acquitte au mieux de sa tâche en traitant notre charge aléatoire provenant de la première machine cliente, NGINX utilise les ressources processeur et la capacité réseau restantes pour répondre depuis la mémoire aux requêtes du second client.
Toujours pas une solution miracle
Après toutes nos craintes concernant les opérations bloquantes et au vu de certains résultats prometteurs, la plupart d’entre vous envisagent probablement déjà de configurer des pools de threads sur leurs serveurs. Ne vous précipitez pas.
En réalité, heureusement, la plupart des opérations de lecture et d’envoi de fichiers ne sollicitent pas les disques durs lents. Si vous disposez de suffisamment de RAM pour stocker le jeu de données, le système d’exploitation sera assez intelligent pour mettre en cache les fichiers fréquemment utilisés dans ce que l’on appelle un « cache de pages ».
Le cache de pages fonctionne plutôt bien et permet à NGINX d’offrir d’excellentes performances dans presque tous les cas d’utilisation courants. La lecture depuis le cache de pages est assez rapide, et personne ne peut qualifier de telles opérations de « bloquantes ». En revanche, leur délégation à un pool de threads entraîne une certaine surcharge.
Ainsi, si vous disposez d’une quantité raisonnable de RAM et que votre jeu de données de travail n’est pas très volumineux, NGINX fonctionne déjà de manière optimale sans recourir à des pools de threads.
Le transfert des opérations de lecture vers le pool de threads est une technique adaptée à des tâches très spécifiques. Elle est particulièrement utile lorsque le volume de contenu fréquemment demandé dépasse la capacité du cache de mémoire virtuelle du système d’exploitation. Cela peut être le cas, par exemple, d’un serveur de diffusion multimédia basé sur NGINX et soumis à une forte charge. C’est cette situation que nous avons simulée dans notre test de performance.
Ce serait formidable de pouvoir améliorer la délégation des opérations de lecture aux pools de threads. Il nous suffit de disposer d’un moyen efficace de savoir si les données de fichier nécessaires se trouvent ou non en mémoire, et de ne déléguer l’opération de lecture à un thread distinct que dans ce dernier cas.
Pour reprendre notre analogie avec la vente, le vendeur ne peut actuellement pas savoir si l’article demandé est disponible en magasin et doit donc soit toujours transmettre toutes les commandes au service de livraison, soit toujours s’en charger lui-même.
Le problème vient du fait que les systèmes d’exploitation ne disposent pas de cette fonctionnalité. Les premières tentatives visant à l’ajouter à Linux sous la forme de l’appel système fincore() remontent à 2010, mais elles n’ont pas abouti. Par la suite, plusieurs tentatives ont été menées pour l’implémenter sous la forme d’un nouvel appel système preadv2() avec l’indicateur RWF_NONBLOCK (voir Opérations de lecture de fichiers mises en mémoire tampon non bloquantes et Opérations de lecture mises en mémoire tampon asynchrones sur LWN.net pour plus de détails). Le sort de tous ces correctifs reste incertain. Ce qui est regrettable ici, c’est que la principale raison pour laquelle ces correctifs n’ont toujours pas été intégrés au noyau semble être d’interminables débats sur des détails secondaires (« bikeshedding »).
En revanche, les utilisateurs de FreeBSD n’ont aucun souci à se faire. FreeBSD dispose déjà d’une interface asynchrone suffisamment performante pour la lecture de fichiers, qu’il convient d’utiliser à la place des pools de threads.
Configuration des pools de threads
Donc, si vous êtes certain que l’utilisation de pools de threads peut être avantageuse dans votre cas, il est temps d’examiner la configuration en détail.
La configuration est assez simple et flexible. Vous devez tout d’abord disposer de NGINX version 1.7.11 ou ultérieure, compilé avec l’argument --with-threads de la commande configure. Les utilisateurs de NGINX Plus doivent disposer de la version 7 ou ultérieure. Dans le cas le plus simple, la configuration est très basique. Il suffit d’inclure la directive aio threads dans le contexte approprié :
# in the 'http', 'server', or 'location' contextaio threads;Il s’agit de la configuration minimale possible des pools de threads. En fait, c’est une version abrégée de la configuration suivante :
# in the 'main' contextthread_pool default threads=32 max_queue=65536;

# in the 'http', 'server', or 'location' context
aio threads=default;
Il définit un pool de threads appelé « default », comprenant 32 threads de travail et une file d’attente des tâches d’une longueur maximale de 65 536 tâches. Si la file d’attente est saturée, NGINX rejette la requête et consigne l’erreur suivante :
thread pool "NAME" queue overflow: N tasks waitingCette erreur signifie qu’il est possible que les threads ne puissent pas traiter les tâches aussi rapidement qu’elles sont ajoutées à la file d’attente. Vous pouvez essayer d’augmenter la taille maximale de la file d’attente, mais si cela ne résout pas le problème, cela indique que votre système n’est pas en mesure de traiter autant de requêtes.
Comme vous l’avez déjà remarqué, la directive « thread_pool » permet de configurer le nombre de threads, la longueur maximale de la file d’attente et le nom d’un pool de threads spécifique. Ce dernier point signifie que vous pouvez configurer plusieurs pools de threads indépendants et les utiliser à différents endroits de votre fichier de configuration à des fins distinctes :
# in the 'main' context
thread_pool one threads=128 max_queue=0;
thread_pool two threads=32;

http {
    server {
        location /one {
            aio threads=one;
        }

        location /two {
            aio threads=two;
        }

    }
    # ...
}
Si le paramètre « max_queue » n’est pas spécifié, la valeur 65536 est utilisée par défaut. Comme indiqué, il est possible de définir max_queue sur zéro. Dans ce cas, le pool de threads ne pourra traiter qu’autant de tâches qu’il y a de threads configurés ; aucune tâche ne sera mise en attente dans la file.
Imaginons maintenant que vous disposiez d’un serveur équipé de trois disques durs et que vous souhaitiez l’utiliser comme « proxy de mise en cache » afin de mettre en cache toutes les réponses de vos serveurs back-end. Le volume de données à mettre en cache devrait largement dépasser la quantité de RAM disponible. Il s’agit en fait d’un nœud de cache pour votre CDN personnel. Bien entendu, dans ce cas, le plus important est de tirer le maximum de performances des disques.
L’une des possibilités consiste à configurer une grappe RAID. Cette approche présente des avantages et des inconvénients. Avec NGINX, vous disposez désormais d’une autre option :
# We assume that each of the hard drives is mounted on one of these directories:# /mnt/disk1, /mnt/disk2, or /mnt/disk3

# in the 'main' context
thread_pool pool_1 threads=16;
thread_pool pool_2 threads=16;
thread_pool pool_3 threads=16;

http {
    proxy_cache_path /mnt/disk1 levels=1:2 keys_zone=cache_1:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk2 levels=1:2 keys_zone=cache_2:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk3 levels=1:2 keys_zone=cache_3:256m max_size=1024G
                     use_temp_path=off;

    split_clients $request_uri $disk {
        33.3%     1;
        33.3%     2;
        *         3;
    }

    server {
        # ...
        location / {
            proxy_pass http://backend;
            proxy_cache_key $request_uri;
            proxy_cache cache_$disk;
            aio threads=pool_$disk;
            sendfile on;
        }
    }
}
Dans cette configuration, les directives thread_pool définissent un pool de threads dédié et indépendant pour chaque disque, tandis que les directives proxy_cache_path définissent un cache dédié et indépendant sur chaque disque.
Le module « split_clients » est utilisé pour répartir la charge entre les caches (et donc entre les disques), ce qui convient parfaitement à cette tâche.
Le paramètre « use_temp_path=off » de la directive proxy_cache_path indique à NGINX d’enregistrer les fichiers temporaires dans les mêmes répertoires que les données de cache correspondantes. Cela permet d’éviter de copier les données de réponse d’un disque dur à l’autre lors de la mise à jour de nos caches.
L’ensemble de ces mesures nous permet de tirer le maximum de performances du sous-système de disques actuel, car NGINX interagit avec les disques en parallèle et de manière indépendante au moyen de pools de threads distincts. Chaque disque est pris en charge par 16 threads indépendants disposant d’une file d’attente de tâches dédiée à la lecture et à l’envoi de fichiers.
Je parie que vos clients apprécient cette approche sur mesure. Soyez certain que vos disques durs l’apprécient eux aussi.
Cet exemple illustre bien la grande souplesse avec laquelle NGINX peut être configuré spécifiquement pour votre matériel. C’est comme si vous indiquiez à NGINX la meilleure façon d’interagir avec la machine et votre jeu de données. En affinant la configuration de NGINX dans l’espace utilisateur, vous pouvez vous assurer que vos logiciels, votre système d’exploitation et votre matériel fonctionnent ensemble de manière optimale afin d’exploiter toutes les ressources du système aussi efficacement que possible.
Conclusion
En résumé, les pools de threads sont une fonctionnalité remarquable qui permet à NGINX d’atteindre de nouveaux niveaux de performances en éliminant l’un de ses ennemis les plus connus et les plus anciens — le blocage —, notamment lorsqu’il s’agit de très gros volumes de contenu.
Et ce n’est pas tout. Comme indiqué précédemment, cette toute nouvelle interface permet potentiellement de déléguer toute opération longue et bloquante sans aucune perte de performances. NGINX ouvre de nouveaux horizons en permettant l’ajout d’une multitude de nouveaux modules et de nouvelles fonctionnalités. De nombreuses bibliothèques populaires ne proposent toujours pas d’interface asynchrone non bloquante, ce qui les rendait jusqu’ici incompatibles avec NGINX. Nous pourrions consacrer beaucoup de temps et de ressources au développement de notre propre prototype non bloquant pour une bibliothèque donnée, mais le jeu en vaut-il toujours la chandelle ? Désormais, grâce aux pools de threads, il est relativement facile d’utiliser de telles bibliothèques et de créer des modules qui les exploitent sans nuire aux performances.
Restez à l’écoute.
Testez vous-même les pools de threads dans NGINX Plus : commencez votre essai gratuit de 30 jours dès aujourd’hui ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.