Récemment, en me replongeant dans l’aquariophilie récifale, je me suis rappelé combien il était important d’étalonner les mesures. À l’instar des évolutions rapides du paysage applicatif, l’aquariophilie récifale a radicalement changé au cours des cinq dernières années.
Aujourd’hui, je peux compter sur des moniteurs et des sondes connectés qui assurent un suivi automatique et m’alertent en cas d’anomalie. Des tableaux de bord web et mobiles permettent de surveiller et de programmer le système, mais aussi de consulter en un coup d’œil l’état de santé de mon aquarium et celui des nombreux appareils qui assurent son bon fonctionnement.
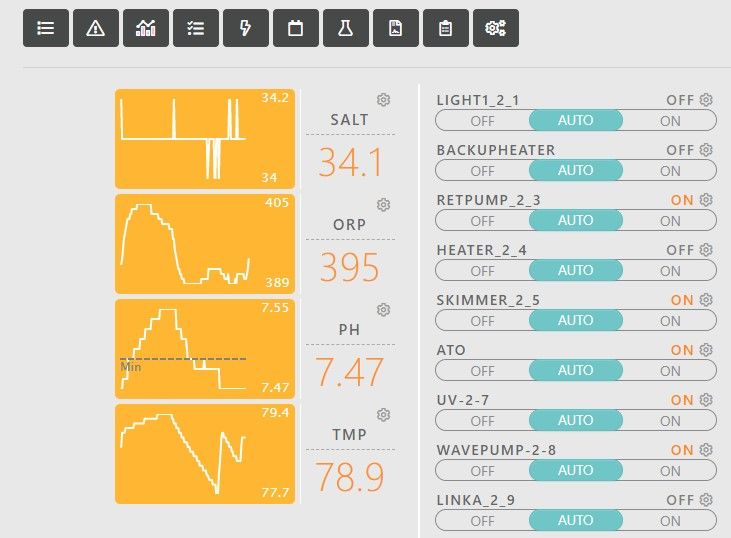
Les lecteurs attentifs remarqueront que le pH semble être « inférieur au minimum ». Pas d’inquiétude, tout va bien. En fait, la sonde (le capteur) n’est pas correctement étalonnée. C’est un problème courant : l’étalonnage des sondes est une opération qui échoue souvent. Pour le moment, je sais que la sonde est étalonnée trop bas et je corrige automatiquement la mesure en conséquence.
À l’instar de la santé d’un aquarium récifal, celle des applications exige une surveillance attentive des indicateurs clés. Les écarts, en particulier les fortes fluctuations, peuvent signaler un problème. Pour les applications, le réglage manuel des indicateurs n’est pas une pratique à reproduire. Ces ajustements manuels peuvent convenir à une ou deux applications, mais une organisation possède en moyenne entre 100 et 200 applications dans son portefeuille numérique. Vous avez besoin de mesures précises, étalonnées par rapport à des profils de fonctionnement habituels.
Comme pour la plupart des métriques réseau et applicatives, cela implique de recueillir des échantillons pendant un certain temps afin d’identifier les valeurs « hautes » et « basses ». Des seuils peuvent ensuite être utilisés pour détecter les comportements anormaux.
Le problème ne réside pas dans le principe, mais plutôt dans sa mise en œuvre.
Tout d’abord, nous nous concentrons généralement sur un seul point de mesure : l’application. Il est intéressant de noter que, pour évaluer la santé d’un aquarium récifal, il faut mesurer la salinité et le pH en plus de la température, car ces deux valeurs sont influencées par celle-ci. Il en va de même pour la santé d’une application : elle dépend d’autres indicateurs, tels que les performances et la charge du réseau. Malheureusement, la plupart des organisations n’adoptent pas nécessairement une vision globale de la santé des applications. L’application elle-même peut parfaitement fonctionner, mais l’expérience client peut être désastreuse en raison des mauvaises performances d’un appareil connecté ou du réseau.
Nous devons élargir notre vision de l’état de santé des applications en étendant le champ de nos mesures. En outre, nous devons étalonner ces mesures supplémentaires afin de pouvoir distinguer ce qui est habituel de ce qui ne l’est pas. Car ce qui est inhabituel peut être le signe d’un problème ou, pire encore, d’une attaque.
Deuxièmement, le défi du passage à l’échelle découle de la nécessité d’effectuer un étalonnage sur plusieurs points pour chaque application à surveiller (spoiler : elles le sont toutes). On ne peut pas demander aux opérateurs d’étalonner manuellement autant de points de données. C’est humainement impossible.
C’est là que les machines entrent en jeu.
Analyses avancées
L’analytique avancée et l’apprentissage automatique constituent l’une des réponses au problème du passage à l’échelle. Les machines peuvent traiter, et traitent effectivement, d’immenses volumes de données de télémétrie à des cadences élevées. Elles peuvent ingérer et normaliser des quantités de données que nous, êtres humains, sommes tout simplement incapables de gérer, puis en analyser les tendances et les relations. L’apprentissage automatique permet ainsi d’étalonner ce qui est considéré comme « normal » sur un ensemble de points de données connexes et de détecter immédiatement les tendances anormales révélant un problème.
Il est assez facile de faire le lien entre les problèmes de performances d’une application et un pic de connexions le lundi matin. Ce qui est moins évident, c’est de remarquer que Bob ne se connecte généralement pas avant le lundi après-midi. Pourtant, aujourd’hui, il se connecte le matin. Il s’agit d’une anomalie difficilement détectable par les opérateurs humains, car nous ne disposons pas de ce niveau de visibilité. Avec suffisamment de données de télémétrie émises par l’application, le client et les services applicatifs qui composent l’expérience allant du code au client, l’analytique avancée peut détecter cette anomalie. Elle peut également la signaler ou déclencher un nouveau processus métier afin de vérifier que Bob essaie bien de se connecter.
Cette fonctionnalité s’apparente à ce que font aujourd’hui de nombreuses applications au niveau de l’appareil. Beaucoup de processus numériques envoient des codes de vérification et nous demandent de prouver que nous sommes humains en identifiant toutes les voitures sur une image floue. Mais ce sont les informations relatives à l’appareil qui déclenchent le nouveau processus métier, et non le fait de se connecter à une heure inhabituelle de la journée. À l’avenir, nous devrons pouvoir déclencher des processus en fonction de ces deux éléments, surtout si nous continuons à prendre en charge une main-d’œuvre répartie géographiquement.
L’étalonnage constitue donc une étape essentielle du processus. Il s’effectue en prenant (beaucoup de) mesures afin de déterminer ce qui est « normal ». Là encore, il s’agit d’un processus qui dépasse les capacités humaines et nécessite que des machines ingèrent et analysent d’importants volumes de données télémétriques.
À terme, l’analytique avancée permettra l’observabilité et donnera naissance à de nouveaux services capables de révéler des informations jusque-là cachées sur les applications (DEM), d’orchestrer plus intelligemment les services applicatifs (AIOps) et de générer une valeur métier jusqu’alors insoupçonnée (services enrichis par l’IA).
Pour ce faire, nous devons générer de grandes quantités de données de télémétrie afin de pouvoir étalonner le comportement « normal » des applications, des utilisateurs et de tous les éléments intermédiaires du chemin de données.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.