A produção não foi feita para falhar.
As arquiteturas tradicionais de serviços de rede e de aplicações são projetadas para serem confiáveis mesmo diante de falhas. A redundância e o failover são recursos essenciais da infraestrutura que fica entre os clientes e o ativo mais valioso de uma organização: suas aplicações.
O failover — o failover de verdade — não pode ser obtido simplesmente iniciando um novo contêiner. Essa abordagem só funciona para aplicações modernas projetadas para não manter estado. Essa raramente é uma característica das aplicações tradicionais e nem sequer é uma certeza nas modernas. Escalabilidade e confiabilidade de nível empresarial são essenciais para manter a disponibilidade do que ainda representa a maior parte do portfólio de aplicações corporativas: as aplicações tradicionais.
Mas isso não significa que devemos ignorar o número crescente de aplicações modernas. Toda nova arquitetura de aplicações começa com apenas alguns projetos e depois se expande rapidamente à medida que as organizações aprendem a desenvolver, implantar e operar os sistemas e as soluções necessários para escalar e proteger essas novas aplicações. O número de aplicações totalmente novas desenvolvidas com arquiteturas modernas ainda é pequeno nas empresas, mas está crescendo rapidamente. E precisa crescer para que as organizações acompanhem o ritmo da economia digital.
Arquitetura na velocidade das aplicações
Mais de uma em cada cinco organizações agora tem cinquenta (50) ou mais solicitações importantes de aplicativos em seu backlog de aplicações. Mais de 61% têm mais de dez (10) novas solicitações de aplicativos na fila. As abordagens tradicionais de desenvolvimento não conseguem acompanhar essa demanda. Mais aplicativos baseados em arquiteturas modernas surgirão à medida que as organizações adotarem metodologias ágeis e microsserviços para acelerar as entregas.
E, à medida que fizerem isso, precisarão de uma forma de superar a lacuna entre o modelo de escalabilidade e confiabilidade das arquiteturas modernas e os rigorosos níveis de escalabilidade e confiabilidade necessários para viabilizar implantações de nível empresarial.
Essas arquiteturas modernas geralmente incluem o NGINX. Na verdade, pode-se dizer que a maioria das novas arquiteturas modernas depende do NGINX em uma ou mais funções.
Entre os doze principais componentes de aplicações executados em contêineres está o NGINX. Entre os principais provedores de ingresso de contêineres em uso (na verdade, no topo da lista), está o NGINX. Em todas as pesquisas e relatórios baseados em dados sobre nuvem, contêineres e microsserviços, é provável que o NGINX apareça em uma lista de componentes em execução.
O NGINX atende principalmente à necessidade de escalabilidade das arquiteturas modernas. Ele oferece confiabilidade às aplicações modernas: se uma instância de uma aplicação falhar, o NGINX detectará a falha e direcionará as solicitações seguintes para outras instâncias. Ele compensa as falhas inerentes ao projeto dos ambientes de contêineres. Também atende aos requisitos de disponibilidade das aplicações que a maioria dos profissionais de DevOps e desenvolvedores tem a responsabilidade de cumprir.
Mas isso não significa necessariamente que seja possível escalar toda uma arquitetura empresarial e garantir sua confiabilidade. O mesmo sistema “projetado para falhar”, que funciona tão bem para aplicações modernas, não é tão adequado para oferecer os mesmos benefícios a aplicações tradicionais e à infraestrutura de serviços de aplicações. No cerne dessa diferença está um modelo de “estado versus com estado”. As aplicações modernas buscam não manter estado, pois é isso que permite o funcionamento da arquitetura. Já as aplicações tradicionais — e a própria rede — mantêm estado. Uma falha interrompe transações e sessões em andamento e compromete a disponibilidade.
Confiabilidade moderna
O raio de impacto de uma falha em produção que afeta a infraestrutura compartilhada (ou seja, a maior parte dela) é grande. Muito grande. As redes e os serviços de aplicações responsáveis pela entrega e pela segurança de centenas de aplicações não são projetados para falhar, mas para serem confiáveis.
A F5, com o BIG-IP, oferece escalabilidade e confiabilidade de nível empresarial. Projetado para ser confiável e capaz de escalar para atender tanto à demanda quanto a ataques de grande escala, o BIG-IP é a solução usada por mais de 25 mil empresas para disponibilizar aplicativos. Ele atende aos requisitos de disponibilidade da rede e dos aplicativos que as equipes de NetOps têm a responsabilidade de cumprir.
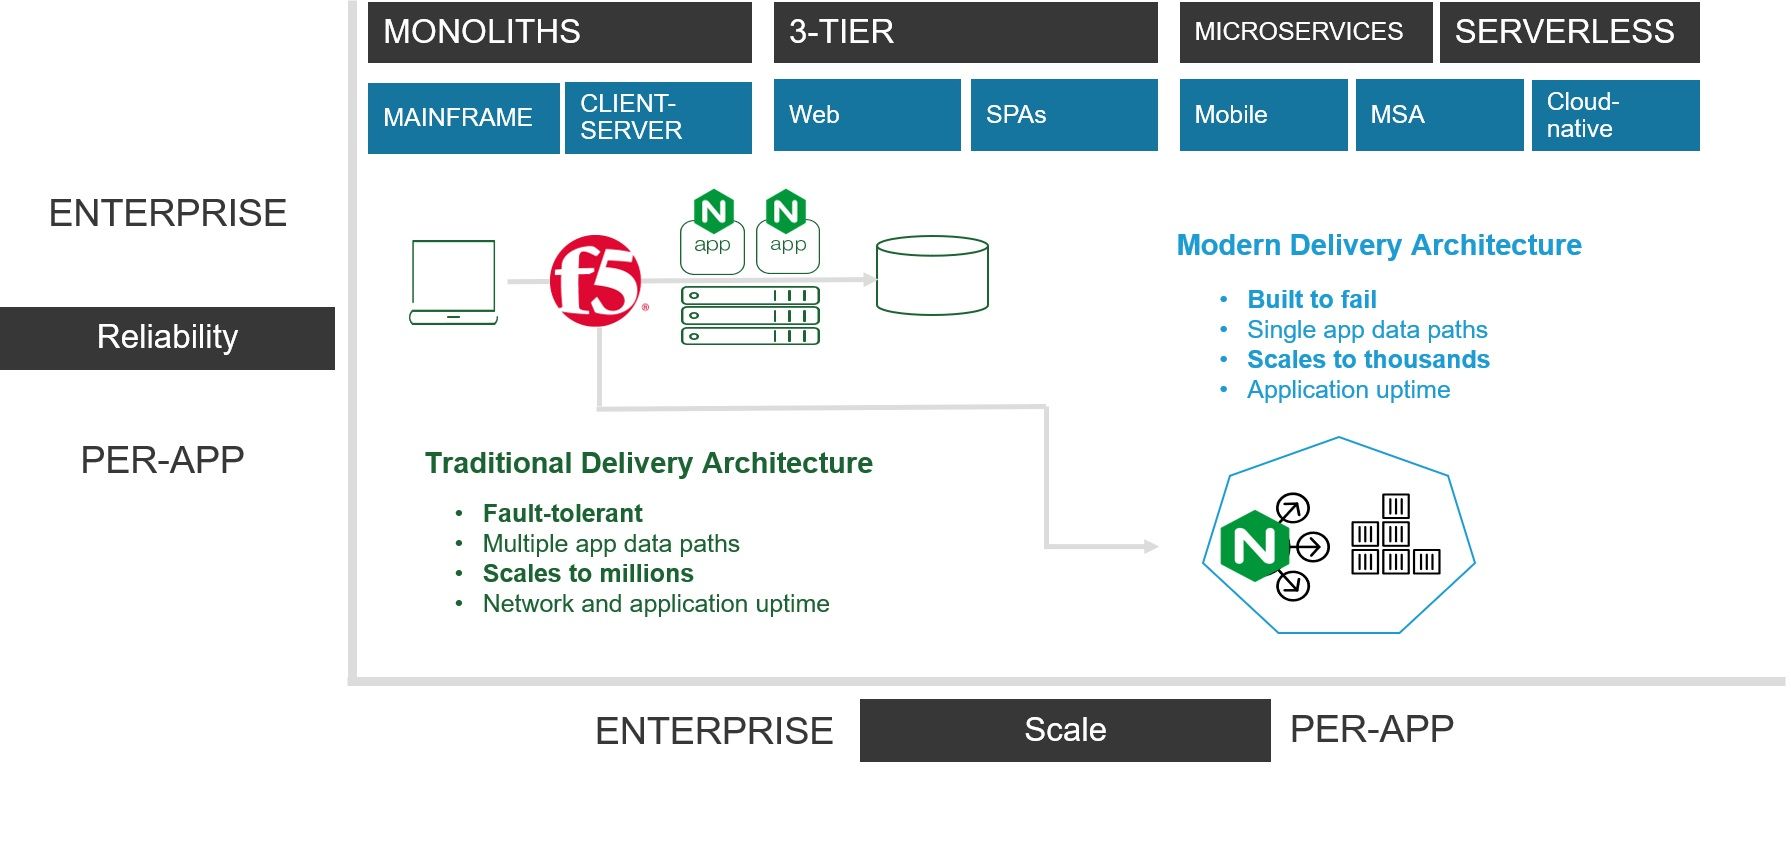
Ao reunir os dois, poderemos atender aos requisitos de “confiabilidade”, independentemente da definição. Seja para garantir a confiabilidade de pequenas implantações conduzidas por desenvolvedores, que escalam aplicações modernas, ou de grandes implantações, que escalam tanto serviços de aplicações quanto aplicações tradicionais, um portfólio combinado permitirá que os clientes usem a ferramenta certa para cada aplicação.
Para saber mais sobre as vantagens de unir a F5 e a NGINX, confira a publicação do CEO da F5 que apresenta a série de posts “Bridging the Divide”.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...