
A equipe de soluções da Volterra desenvolve e mantém diversos casos de uso em potencial da plataforma Volterra para demonstrar o valor que ela pode oferecer. Esses casos de uso geralmente são transformados em guias de instruções que os clientes utilizam para ter sua primeira experiência prática com a Volterra.
A equipe de soluções queria um método mais rápido e automatizado para implantar internamente nossos casos de uso sob demanda, exigindo o mínimo possível de intervenção humana. Nossas implantações abrangiam um ambiente híbrido de múltiplas nuvens, utilizando tanto plataformas de IaaS (AWS, Azure e GCP) quanto ambientes de data center privados (VMware vSphere e Vagrant KVM). Queríamos simplificar o gerenciamento desses ambientes oferecendo uma única ferramenta capaz de criar implantações em qualquer ambiente, sem que cada usuário precisasse criar contas de acesso adicionais ou gerenciar credenciais de usuário específicas para cada plataforma de virtualização ou provedor de IaaS. Essa ferramenta também precisava ser escalável para comportar vários usuários e implantações simultâneos.
Em suma, o principal problema que queríamos resolver era criar uma ferramenta automatizada para a implantação de casos de uso de soluções, capaz de escalar e gerenciar implantações simultâneas em ambientes híbridos de múltiplas nuvens, exigindo o mínimo possível de intervenção do usuário.
O Projeto Altered-Carbon (AC)
Para isso, criamos um projeto chamado Altered-Carbon, muitas vezes abreviado como AC. O projeto AC é um pipeline dinâmico do GitLab capaz de criar mais de 20 casos de uso diferentes para soluções da Volterra. Por meio da automação do pipeline, criamos “implantações com o toque de um botão” acionadas por um único comando, permitindo que os usuários implantem facilmente vários clusters de casos de uso sob demanda ou por meio de tarefas cron diárias agendadas.
Para fins de referência, no AC chamamos cada implantação de STACK e cada caso de uso exclusivo de SLEEVE.
Desenvolvimento de Projetos
Iniciamos o desenvolvimento do projeto AC automatizando o caso de uso hello-cloud no primeiro SLEEVE. O caso de uso hello-cloud cria um site Volterra na AWS e outro no Azure, combina esses sites em um cluster Volterra VK8s (Kubernetes virtual) e implanta uma aplicação com 10 pods em ambos os sites usando o VK8s. Começamos o processo criando templates adicionais do Terraform e scripts de shell que utilizam a API da Volterra para criar um fluxo de trabalho totalmente automatizado no GitLab, gerenciável por pipelines de CI/CD. Em seguida, começamos a trabalhar para tornar essa metodologia de implantação reutilizável e escalável.
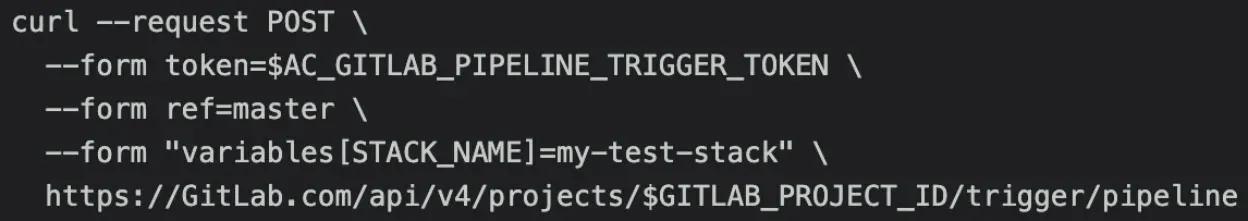
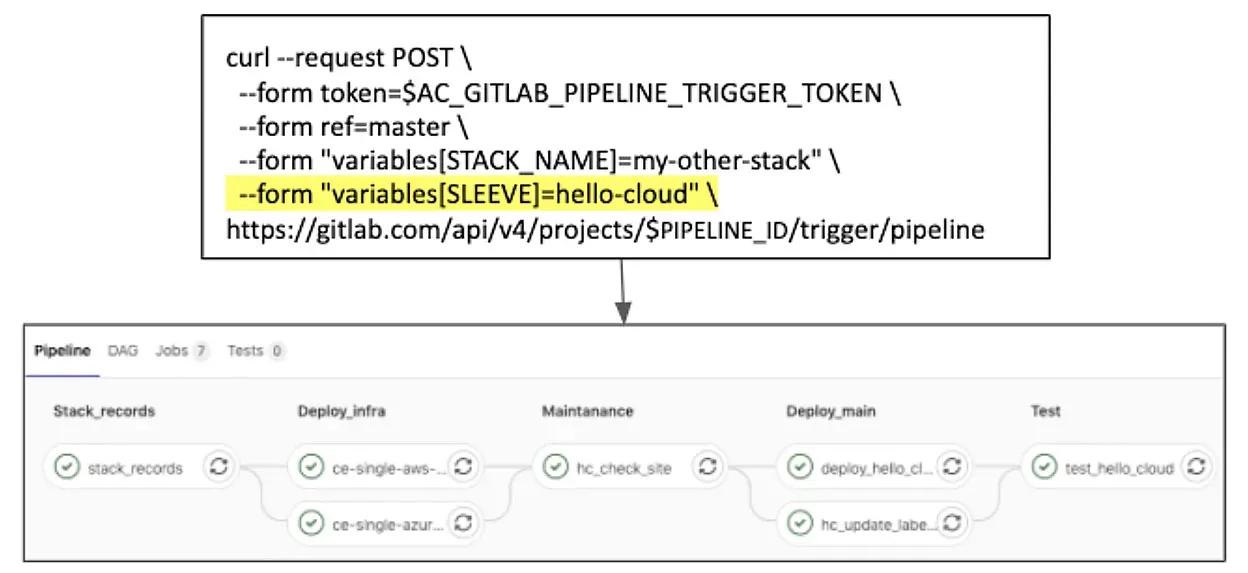
Adicionar convenções de nomenclatura exclusivas foi a próxima questão que abordamos em nosso projeto. Para permitir várias implantações do caso de uso em um único ambiente de locatário da Volterra, precisávamos garantir que os recursos criados em cada STACK tivessem nomes exclusivos e não tentassem criar recursos com nomes iguais aos de outras STACKs no mesmo ambiente de locatário da Volterra. Para solucionar possíveis conflitos de nomenclatura, começamos a incorporar aos acionadores de pipeline a ideia de variáveis de ambiente exclusivas fornecidas pelo usuário, que se tornariam fundamentais para o projeto. A variável de ambiente STACK_NAME foi introduzida e usada pelo terraform para incluir uma string definida pelo usuário nos nomes de todos os recursos associados a uma STACK específica. Em vez de serem acionadas a cada commit, as condições de acionamento dos jobs dos pipelines do AC foram configuradas para executá-los somente quando acionados por uma chamada de API de um usuário do GitLab usando um GitLab Project CI Trigger Token, permitindo que o pipeline fosse controlado por intervenção humana ou por chamadas de API externas. Com chamadas de API semelhantes ao exemplo a seguir, os usuários podiam atingir nosso objetivo de criar várias implantações sem conflitos de recursos usando um único comando.
Em seguida, buscamos criar opções adicionais de implantação com base nesse modelo. As implantações do site hello-cloud na AWS e no Azure também eram casos de uso distintos que queríamos implantar de forma independente com o AC. Isso nos levou ao nosso primeiro grande problema com o GitLab. Nos pipelines de CI/CD do GitLab, todos os jobs do pipeline de um projeto estão conectados. Isso não era intuitivo, pois muitos dos jobs necessários para a implantação do hello-cloud não seriam necessários nas implantações do site na AWS ou no Azure. Em essência, queríamos que um único pipeline de CI de um projeto do GitLab contivesse vários pipelines independentes, que pudessem ser acionados sob demanda com conjuntos separados de jobs de CI quando necessário.
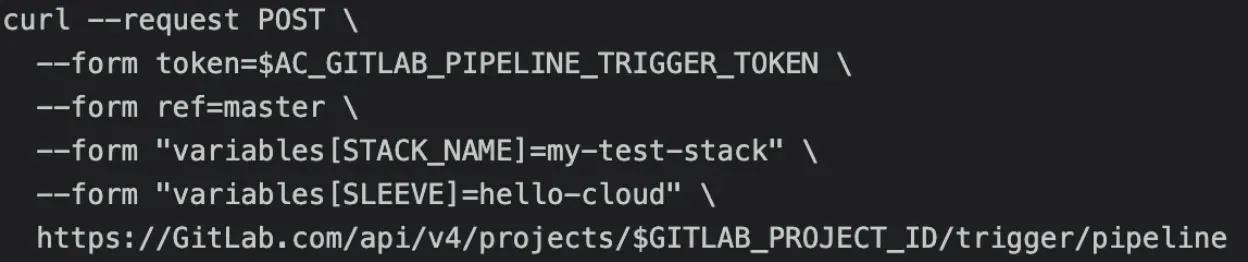
Para resolver esse problema, introduzimos a variável de ambiente SLEEVE na estrutura do pipeline, que incorporava as opções only/except do GitLab CI/CD. Isso permitiu limitar os jobs de CI acionados em qualquer pipeline com base no valor de SLEEVE fornecido no acionamento do pipeline. Por fim, definimos nossas três opções iniciais de SLEEVE: simple-aws, simple-azure e hello-cloud. Cada SLEEVE definiria o caso de uso que o usuário desejava implantar (controlando, assim, os jobs de CI em um pipeline acionado) e um STACK_NAME para nomear os recursos criados por qualquer pipeline acionado. A estrutura de comando a seguir, que incorpora ambas as variáveis de ambiente, serviu como o comando AC mais básico e ainda é usada atualmente:
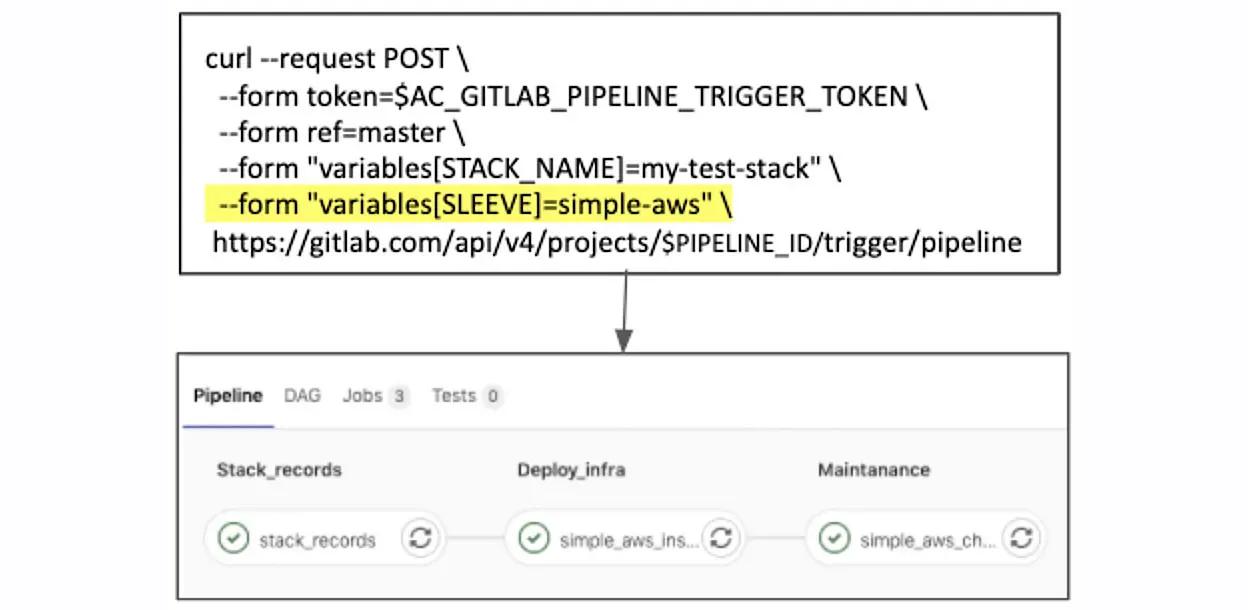
A imagem a seguir mostra uma visualização de como a alteração da variável de ambiente SLEEVE modifica os jobs acionados em cada execução do pipeline de AC.
Pipeline SLEEVE “simple-aws”:
Pipeline “hello-cloud” do SLEEVE:
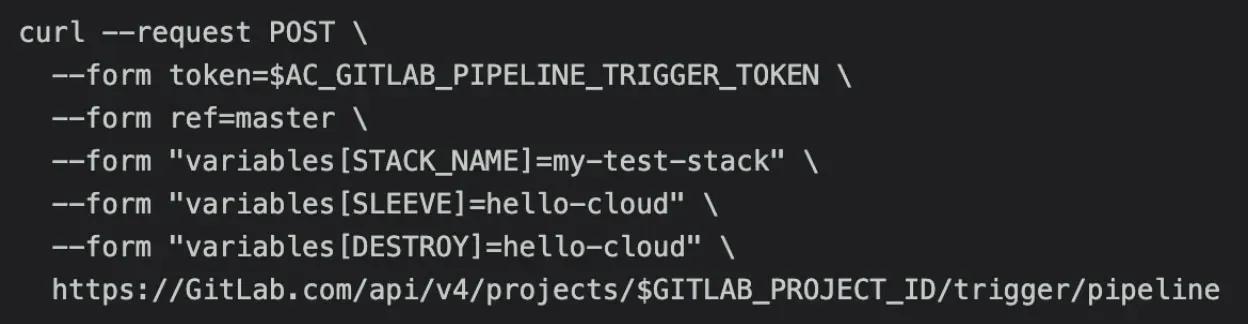
Também introduzimos jobs adicionais que seriam acionados caso a variável de ambiente DESTROY fosse fornecida em qualquer acionamento do pipeline. Isso disponibilizaria uma opção inversa para remover os recursos criados pelo AC. Veja a seguir um exemplo que removeria os recursos de uma STACK existente:
Outras variáveis de ambiente eram armazenadas no GitLab com valores padrão que podiam ser substituídos pela inclusão de valores no comando de acionamento. Por exemplo, a URL da API dos nossos ambientes de tenant da Volterra era armazenada na variável de ambiente VOLTERRATENANT. Se um usuário adicionasse a variável de ambiente VOLTERRATENANT ao comando da API, isso substituiria o valor padrão e redirecionaria a implantação para o local desejado. Isso se mostrou muito importante para nossa capacidade de realizar testes internos, pois a equipe de soluções gerencia dezenas de ambientes de tenant da Volterra e precisa poder alternar entre eles de acordo com a tarefa em questão:
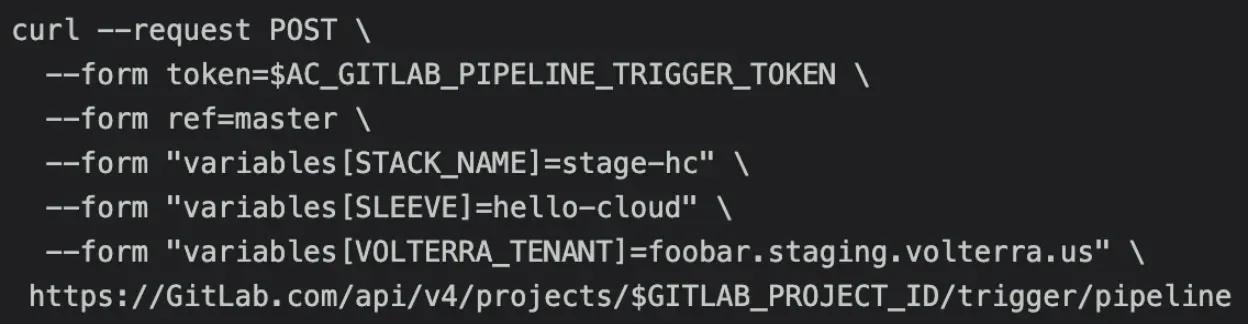
Essas variáveis de ambiente opcionais podiam ser usadas para proporcionar um maior nível de controle sobre as implantações quando necessário, ao mesmo tempo que permitiam uma opção de implantação padrão mais simples para os usuários que não queriam gerenciar essa sobrecarga adicional. Elas também nos permitiam alternar facilmente entre implantações nos ambientes de staging e produção, o que se mostraria essencial para o nosso maior consumidor de AC.
Caso de uso de soluções: testes de regressão noturnos
Como mencionado anteriormente, cada SLEEVE no AC representava um caso de uso da Volterra que muitas vezes seria o primeiro contato dos clientes com o produto. Garantir que esses casos de uso estivessem funcionando e sem bugs era fundamental para causar uma boa primeira impressão do produto. Antes da criação do AC, testar os casos de uso para confirmar que estavam funcionando e atualizados com as versões mais recentes do software e da API da Volterra era uma tarefa demorada. As etapas manuais exigidas em cada caso de uso limitavam os testes de regressão, que não eram realizados com a frequência necessária e estavam sujeitos a erros humanos.
No entanto, com a automação do AC, era possível usar tarefas agendadas diariamente para acionar a implantação de qualquer caso de uso específico com um SLEEVE e, em seguida, remover os recursos criados após a conclusão ou falha da implantação. Isso era feito tanto em ambientes de homologação quanto de produção para verificar se alterações recentes em algum deles haviam afetado a implantação do caso de uso ou causado bugs no software da Volterra. Assim, podíamos atualizar nossos guias de casos de uso para abordar os bugs encontrados ou identificar rapidamente bugs no software da Volterra e abrir chamados para solucioná-los.
Criamos um repositório e um pipeline separados, com jobs agendados que usavam os comandos de acionamento da API do GitLab para gerar simultaneamente várias stacks usando diferentes SLEEVEs. Cada job de teste de fumaça começava acionando a criação de uma stack com um pipeline de AC independente. Em seguida, o job de teste de fumaça obtinha o ID do pipeline na saída padrão da chamada de acionamento do pipeline e usava a API do GitLab para monitorar o status do pipeline acionado. Quando o pipeline era concluído (com sucesso ou falha), o pipeline de destruição era executado na mesma STACK criada para remover os recursos após o teste.
A imagem a seguir detalha esse processo e mostra os jobs que ele aciona no AC para os comandos de criação e destruição:
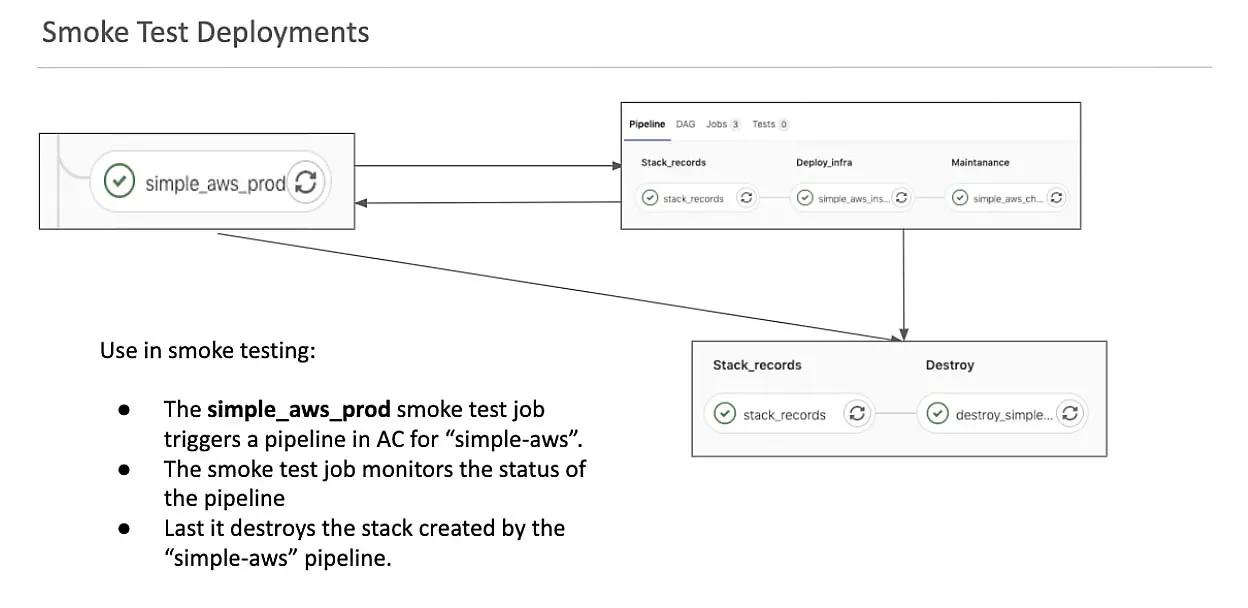
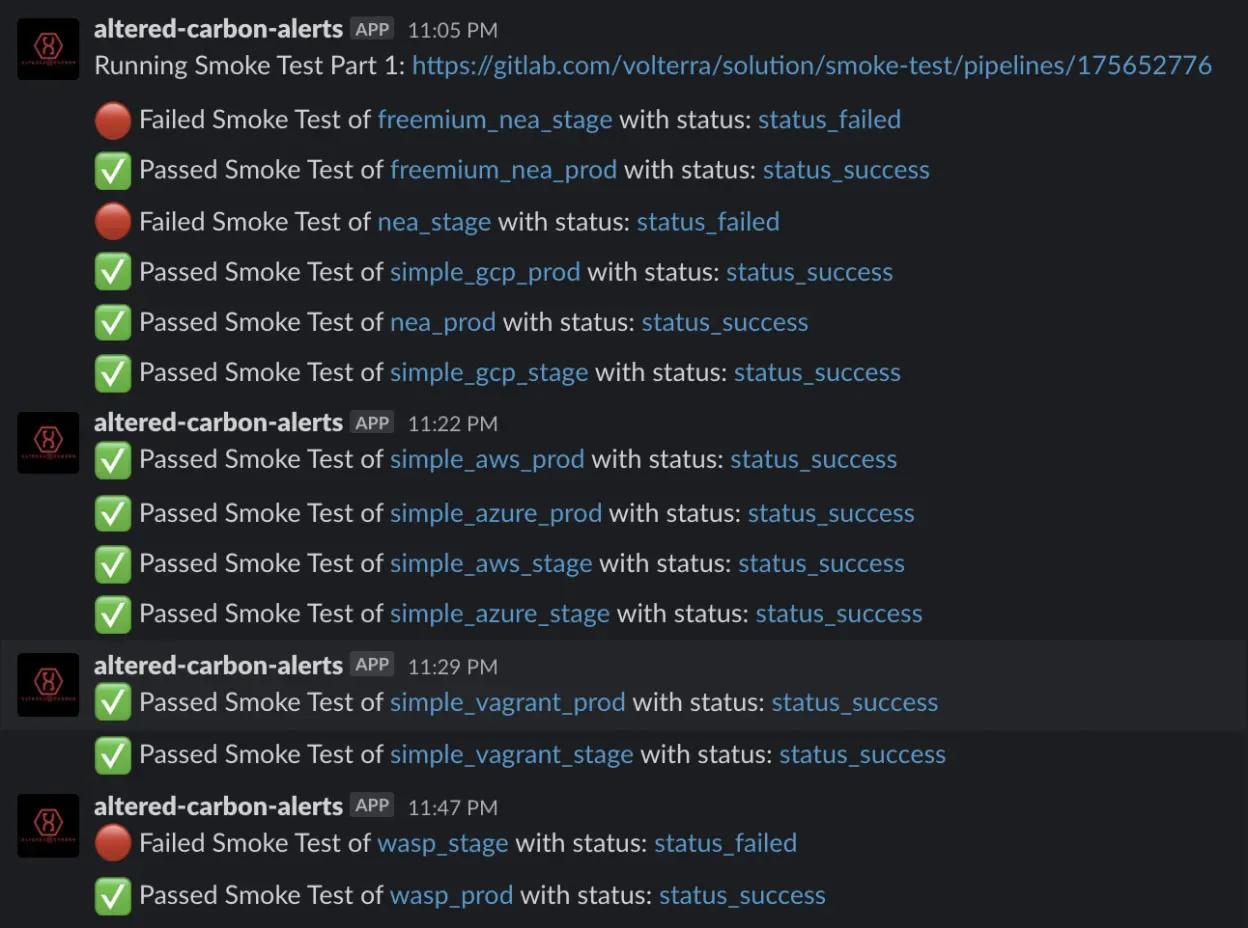
Quando um pipeline de testes de fumaça falhava, conseguíamos fornecer as variáveis de ambiente que poderiam ser usadas em um gatilho do AC para reproduzir o problema. Essas informações podiam ser incluídas em nossos tíquetes de problemas técnicos, permitindo que nossos desenvolvedores recriassem facilmente as implantações com falha. À medida que mais SLEEVES eram concluídos, adicionávamos cada vez mais tarefas aos pipelines de CI, ampliando a cobertura dos testes. Para melhorar ainda mais a visibilidade desses testes, adicionamos uma integração com o Slack e configuramos as tarefas de testes de fumaça para enviar uma mensagem informando o sucesso ou a falha de cada execução do pipeline, com links e detalhes para as páginas web de CI correspondentes nos projetos Altered-Carbon e Smoke-Test.
Manutenção de registros da pilha e navegação pela URL web do pipeline
A complexidade do projeto aumentou à medida que o AC evoluiu, incorporou novos usuários da equipe de soluções e criou cada vez mais stacks. Isso começou a gerar problemas significativos ao navegar pela interface web do GitLab Pipeline. Estávamos usando os pipelines do GitLab de uma forma bastante incomum, o que dificultava o uso da interface web do GitLab Pipeline para rastrear execuções individuais de pipelines relacionadas às STACKs que estávamos criando.
Os pipelines do GitLab que gerenciam implantações por meio de fluxos de trabalho GitOps parecem ser mais adequados quando usados com um conjunto estático e predefinido de clusters. Nesse caso, cada execução de um pipeline do GitLab afetaria sempre os mesmos clusters e recursos. Assim, o histórico de implantação desses clusters corresponde ao histórico de pipelines exibido na interface web do GitLab. No entanto, o AC é dinâmico e gerencia um conjunto de recursos em constante mudança, no qual cada execução do pipeline pode utilizar um conjunto de jobs totalmente diferente, gerenciando diferentes STACKs de recursos em diferentes provedores de virtualização. Essa diferenciação criada pelas convenções SLEEVE e STACK tornou muito difícil determinar qual pipeline corresponde a qual stack. Por exemplo, podemos observar a interface web dos pipelines de CI/CD do GitLab para o AC:
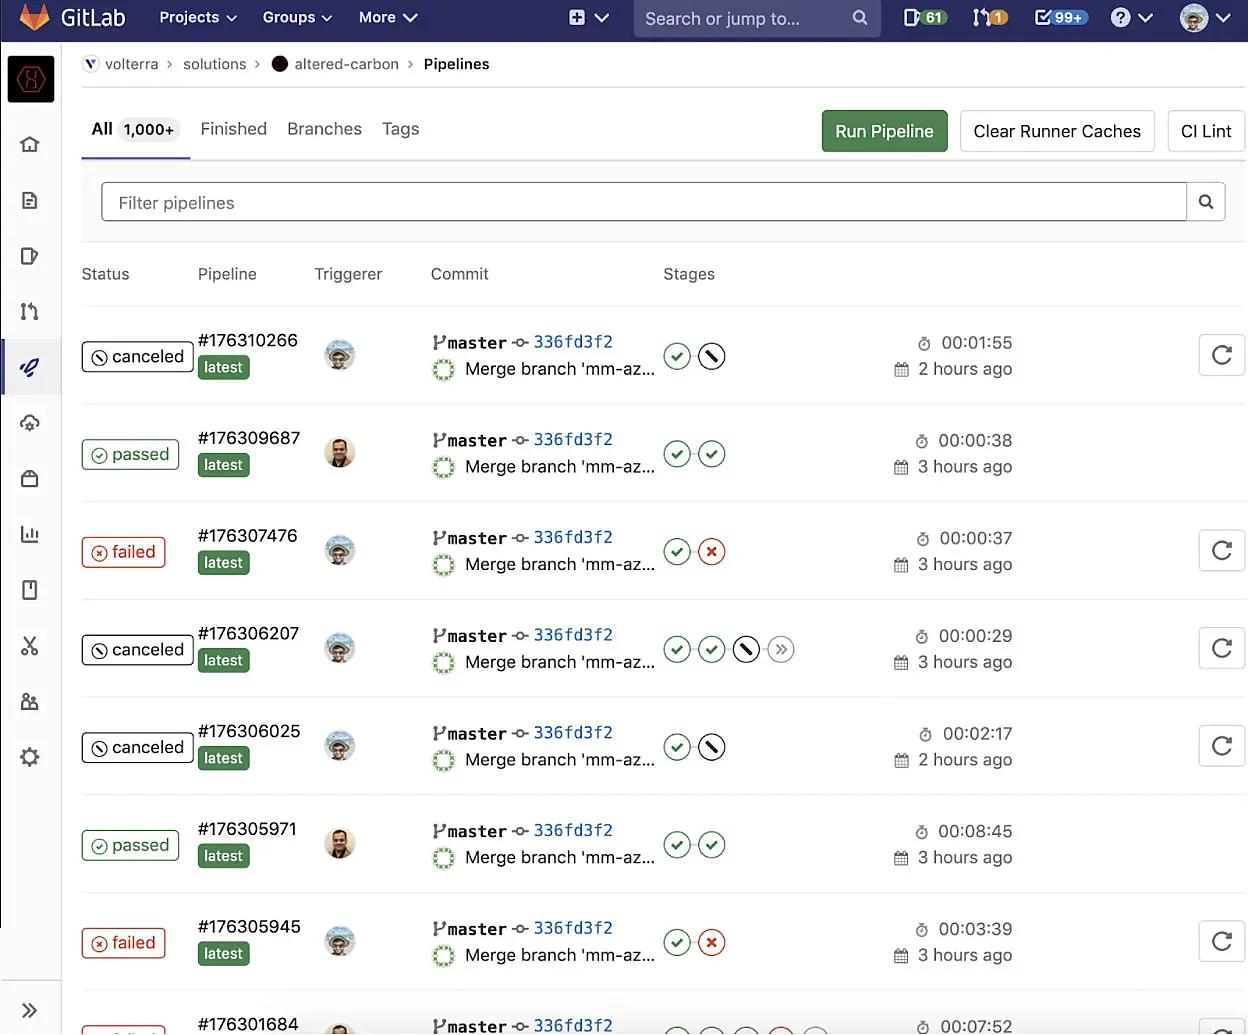
Nessa visualização, não é possível determinar qual STACK ou SLEEVE está sendo alterada por uma determinada pipeline sem analisar cada pipeline individualmente. Quando centenas de pipelines são executadas por dia, pode ser trabalhoso encontrar a execução específica que criou ou destruiu uma determinada STACK ou localizar detalhes específicos sobre ela. Para resolver esse problema logo no início do desenvolvimento do AC, adicionamos um sistema simples de registro. Antes de qualquer pipeline, era executado um job chamado stack-records. Esse job coletava os detalhes da stack no momento de sua criação e gerava um arquivo json, que era enviado ao nosso bucket de armazenamento S3 usado para armazenar os backups do tfstate. Abaixo, vemos um exemplo de registro de stack:
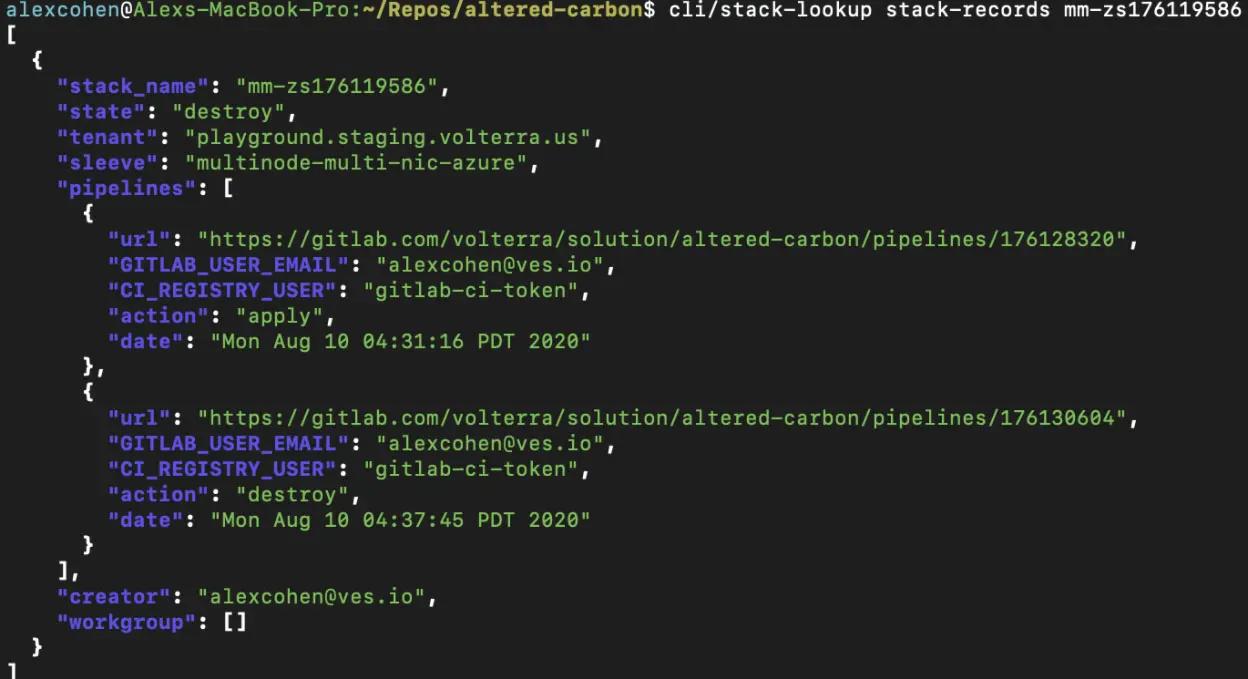
Os arquivos stack-record.json incluem detalhes de cada stack, como:
- Qual ambiente de locatário da Volterra foi usado.
- Qual SLEEVE foi usado.
- Se a STACK estava em execução no estado “apply” ou se os recursos dela foram removidos com o estado “destroy”.
- Qual usuário do GitLab criou a stack.
- Um grupo de trabalho que lista outros usuários com acesso para alterar uma STACK.
- E, o mais importante, um array de pipelines que incluiria a URL da web de cada execução de pipeline realizada na STACK, quem acionou o pipeline, se ele aplicou ou destruiu uma STACK e quando foi acionado.
Isso forneceu um histórico registrado de todas as URLs de pipelines associadas a cada stack, e um script simples de CLI, capaz de acessar esses arquivos por meio de chamadas à API do S3, foi criado para simplificar ainda mais o processo. Nossos usuários do AC podiam usar esses documentos para acompanhar o histórico das stacks e consultar seus registros para ver quando elas foram alteradas.
Os registros de stacks também nos permitiram implementar determinados níveis de controle de usuários e detecção de erros nos pipelines que implantamos. Por exemplo, uma alteração feita no software Volterra após a criação do AC nos obrigou a começar a limitar a 17 caracteres os nomes dos clusters de sites (um valor derivado de STACKNAME) usados na criação de sites no Volterra. Por isso, adicionamos uma verificação à tarefa de registros de stacks que faria os pipelines falharem antes de executar qualquer etapa de implantação caso STACKNAME excedesse o limite de caracteres. Outros controles personalizados foram adicionados, como a inclusão de níveis de permissão de usuários no AC, que restringem quais usuários têm acesso para alterar stacks específicos controlados pelo AC.
- Permissões de nível de administrador, nas quais os dois principais desenvolvedores do AC podem criar ou destruir qualquer stack para fins de depuração. -O nível de proprietário ou criador destina-se ao usuário do GitLab que cria inicialmente uma STACK. O endereço de e-mail desse usuário no GitLab é registrado nos registros da stack como o criador, e ele pode criar ou destruir uma stack.
- Em seguida, temos as permissões no nível de grupo de trabalho: o e-mail do usuário do GitLab pode ser adicionado ao array de grupo de trabalho do registro da stack, concedendo a usuários que não sejam o criador a capacidade de aplicar ou destruir uma STACK.
- Um usuário sem nenhum desses níveis de permissão não poderá alterar uma stack. Se esse usuário tentar alterar uma stack para a qual não tem permissão, o job stack-records falhará antes que qualquer recurso seja implantado.
Uso interno e cobertura atual de testes
Hoje, o AC se tornou essencial para a equipe de soluções, sendo responsável pela maior parte dos nossos testes de regressão e da automação. Seus principais usos são testes rápidos de regressão, testes de escala, testes de faturamento de produtos e implantações simplificadas usadas em demonstrações de produtos.
As implantações automatizadas têm seu maior uso em nossos testes de regressão noturnos. Todas as noites, testamos cada um dos nossos SLEEVES em ambientes de produção e de homologação, acionando uma implantação e, em seguida, removendo os recursos criados. Quando ocorrem alterações, conseguimos detectá-las rapidamente e enviar relatórios de bugs para atualizar nossos guias. Nossa cobertura de testes atual inclui:
- Gateway seguro do Kubernetes.
- Segurança de aplicações web.
- Aplicações de borda de rede que implantam nosso aplicativo padrão “hipster-co”, composto por 10 pods, e um aplicativo mais leve, composto por um único pod.
- Olá, Nuvem.
- Sites Volterra CE de nó único e interface de rede única na AWS, GCP, Azure, VSphere e KVM/Vagrant.
- Sites Volterra CE de nó único com duas interfaces de rede na AWS, GCP, Azure, VSphere e KVM/Vagrant.
- Implantações em escala de sites Volterra CE de nó único e interface de rede única (usando GCP, VSphere e KVM), com a criação de vários sites CE de nó único e uma única placa de rede para testar a capacidade de escalabilidade do Volterra.
- Sites Volterra CE de nó único com múltiplas interfaces de rede na AWS, GCP, Azure, VSphere e KVM/Vagrant.
- Sites Volterra CE com vários nós e uma única interface de rede na AWS, GCP, Azure, VSphere e KVM/Vagrant.
- Sites Volterra CE com vários nós e várias interfaces de rede na AWS, GCP, Azure, VSphere e KVM/Vagrant.
Também temos conjuntos especializados de testes de escala que automatizam o processo de implantação de até 400 sites simultaneamente para testar a capacidade de escalabilidade do software Volterra e que foram testados usando GCP, vSphere e KVM.
A implantação rápida e automatizada de casos de uso permite que os membros da equipe de soluções se concentrem em outras tarefas, aumentando a eficiência interna. A equipe de soluções costuma usar o AC para implantar dezenas de sites KVM, GCP e vSphere para a gravação de demonstrações em vídeo, economizando o tempo necessário para criar sites Volterra usados na elaboração de infraestruturas mais complexas com base na automação já implementada. Isso também é usado em tarefas cron diárias que testam os recursos de faturamento da plataforma Volterra, automatizando a implantação de casos de uso de AWS, segurança de aplicações web, gateway seguro do Kubernetes e aplicações na borda da rede em um tenant Volterra especializado que registra informações de faturamento.
Planos futuros e roteiro
Nosso uso do AC já está gerando resultados muito positivos, e ainda há muitos outros recursos e melhorias a serem adicionados ao projeto em um futuro próximo.
A maior novidade do projeto é a inclusão constante de novas opções de SLEEVE para abranger a implantação de outros casos de uso. Para cada novo SLEEVE adicionado, incluímos uma nova tarefa em nossos testes rápidos noturnos de regressão, ampliando a cobertura dos projetos de implantação de soluções. A maioria dos sleeves anteriores se concentrava em casos de uso com um único nó e uma única interface de rede, mas recentemente ampliamos nossa cobertura de SLEEVE para clusters de sites Volterra com vários nós e casos de uso com várias interfaces de rede nas plataformas AWS, Azure, GCP, VMWare e KVM/Vagrant.
Também buscamos aprimorar nosso sistema de registros de stacks. Aumentaremos o nível de detalhamento dos nossos registros do AC e adicionaremos recursos de pesquisa mais avançados com a incorporação de bancos de dados RDS para armazená-los. O objetivo é permitir pesquisas mais rápidas em nosso ambiente do AC e oferecer uma funcionalidade de pesquisa mais seletiva, como consultas de stacks com base no estado, nos criadores etc. Também está em nosso roadmap usar esses registros para criar uma interface personalizada que permita visualizar com mais eficiência as implantações criadas com o AC.
Sobre o autor
Publicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...