E a escala leva à velocidade. E a velocidade leva ao sucesso.
Suponha que um engenheiro consiga processar uma solicitação de alteração em duas horas. Suponha que outro engenheiro consiga processar essa mesma solicitação em 1,5 hora. Se trabalharem juntos, quanto tempo levarão para processar duzentas solicitações de alteração?
Sim, a resposta é obviamente cerveja.
Todo mundo provavelmente se lembra (com uma boa dose de medo e aversão) dos infames problemas de matemática sobre “trens” ou “pintura”, criados para nos ensinar sobre relações entre frações. Essa era mesmo a intenção, embora muitos de nós tenham acabado desenvolvendo aversão a pintar e a viajar de trem. E rendendo muitos memes. Não podemos nos esquecer dos memes.
A questão é que esse tipo de medição baseada em fórmulas está se tornando uma exigência no data center, especialmente na rede. Isso porque os orçamentos são limitados (eu sei, não é? Que loucura!) e só é possível contratar X engenheiros para realizar Y tarefas. Em um mundo de aplicações no qual ciclos de lançamento rápidos e frequentes são essenciais, o número de profissionais “X” que podem ser contratados para garantir lançamentos dentro do prazo é limitado.
É por isso que a escala é um dos principais impulsionadores do “devops” na rede, também conhecido como “netops”. Ao aplicar os princípios operacionais do DevOps à rede, acredita-se que o netops possa alcançar a escala operacional necessária para permitir que “X” engenheiros realizem “Y” tarefas dentro do prazo e das restrições orçamentárias, mesmo quando a relação entre X e Y é exponencial (em termos leigos: extremamente desproporcional).
O problema das solicitações de mudança é real e foi apresentado por um engenheiro de redes que enfrentava um número crescente dessas solicitações (definidas como criar um endpoint de balanceador de carga para uma aplicação, adicioná-lo ao DNS e criar uma regra de firewall para permitir o acesso), o que acabou ameaçando sobrecarregar a equipe disponível e, ao mesmo tempo, aumentar o tempo necessário para concluí-las.
A solução foi encontrada, naturalmente, na automação, na aplicação dos princípios de DevOps e na disponibilização de uma interface de autoatendimento que permitia a outros engenheiros fazer solicitações, posteriormente registradas no sistema de chamados e executadas por meio de diversas APIs de rede e de serviços de aplicações.
A adoção da automação (e da orquestração, pois todo o processo também está sendo automatizado) não só permite que os engenheiros atuais ampliem a escala das operações, como também tornou o processo mais rápido. O processamento de uma solicitação de alteração, que antes podia levar até duas horas, agora pode ser concluído em apenas cinco minutos.
Sim, você leu certo. Cinco minutos em vez de até duas horas.
Essa é uma melhoria significativa na velocidade decorrente da capacidade de ganhar escala por meio da automação e da orquestração. E, embora não seja um projeto ambicioso que abranja todo o data center, ele resolve um problema específico que tanto os engenheiros quanto os responsáveis pelas aplicações enfrentavam com frequência. Nesse caso, aparentemente até 200 vezes por semana.
É exatamente assim que as equipes de operações de rede devem abordar a automação e a orquestração na rede de produção. Identificar tarefas repetíveis e consideradas triviais pelo comitê de revisão de mudanças (ou seja, que comprovadamente não causam interrupções e que a maioria dos engenheiros consegue realizar de olhos fechados) pode gerar oportunidades significativas de expansão, proporcionando a agilidade que, segundo as áreas de negócios e os responsáveis pelas aplicações, precisamos alcançar na rede.
Identificar aquelas oportunidades que podem ser automatizadas com o menor risco possível de interrupção permite que os engenheiros se concentrem nas tarefas que ainda não são consideradas adequadas para automação. Esse foco também agiliza a implementação de outros serviços, pois eles deixam de gastar uma quantidade excessiva de tempo com tarefas mais simples e repetitivas.
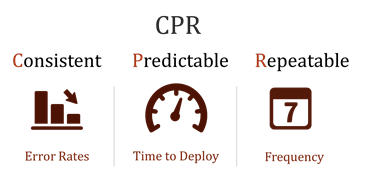
Nunca é demais enfatizar o quanto é essencial adotar uma abordagem CPR para a automação de redes: uma automação consistente, previsível e repetível permitirá escalar com mais eficiência e reduzir o tempo de entrega, com menor risco de interrupções causadas por erros. Trata-se da união dos chamados modelos operacionais “modo 1” e “modo 2”, em que a confiabilidade e a estabilidade são prioritárias, mas a agilidade continua sendo desejável. Ao viabilizar uma abordagem CPR para a automação e a orquestração da rede, as organizações podem aumentar a agilidade com um risco muito menor de comprometer a confiabilidade de uma rede responsável por dar suporte a muitas e muitas outras aplicações — em média, cerca de 200.
As redes de data centers são compostas por tecnologias legadas e emergentes, muitas vezes mantidas juntas com soluções improvisadas ao estilo MacGyver, usando chiclete e linha de pesca. Essas redes precisam oferecer suporte simultâneo a aplicações que estão em produção há quase cinquenta anos (os mainframes ainda existem) e a aplicações emergentes desenvolvidas com tecnologias que mal saíram das fraldas (como contêineres). Elas precisam disponibilizar todas as aplicações com confiabilidade e segurança. Esses padrões não podem ser deixados de lado em favor da velocidade e da frequência exigidas por aplicações mais novas e atraentes.
Mas as operações de rede podem alcançar um equilíbrio que permita que ambos coexistam, desde que consigam identificar e, em seguida, automatizar ao máximo as tarefas e opções de entrega de serviços que não causem interrupções e sejam consideradas meras formalidades pelo controle de mudanças e por outros responsáveis pela aprovação.
Afinal, nossa equação favorita para determinar o tempo necessário para pintar uma casa muda drasticamente quando os pintores envolvidos recebem rolos de pintura automáticos em vez de pincéis manuais.
Não se preocupe tanto em mudar a rede; basta mudar a equação.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...