O renascimento da infraestrutura tem um bordão: deixe os servidores servirem e a inferência inferir.
Nos primórdios da tecnologia, passei anos envolvido em testes e análises de aceleradores SSL. Essas pequenas placas foram projetadas para solucionar um problema significativo decorrente do crescimento explosivo dos negócios e do comércio digitais: as funções de segurança que utilizavam SSL consumiam ciclos de CPU e eram uma importante fonte de problemas de desempenho. Por isso, o setor — incluindo a F5 — desenvolveu hardware para transferir o processamento dessas funções e deixar os servidores servirem.
Hoje, estamos vendo os mesmos problemas surgirem com a IA — especificamente com a inferência — e, sem ironia, estamos vendo surgir o mesmo tipo de solução: hardware especializado que deixa os servidores servirem e a inferência inferir.
É, não tenho certeza se isso está gramaticalmente correto, mas vamos deixar assim por enquanto, pode ser? Vlw.
Como já destacamos, as aplicações de IA são aplicações modernas em termos de sua arquitetura. Mas, no cerne de uma aplicação de IA, está a inferência, e é nisso que a IA se diferencia das aplicações modernas “normais”.
Inferência em ação
Vimos como os complexos computacionais de IA são construídos com conjuntos de CPUs e GPUs. Esses recursos computacionais têm proporções e equilíbrios que precisam ser mantidos para que o cluster funcione com eficiência. Sempre que uma CPU não consegue acompanhar o ritmo, uma GPU muito cara fica ociosa.
Veja bem, apenas parte do processamento de um servidor de inferência é realmente dedicada à inferência. Grande parte dele consiste no processamento web padrão de solicitações HTTP e API. É essa parte do serviço de inferência que usa a CPU e muitas vezes fica sobrecarregada. Quando isso acontece, as GPUs são cada vez menos utilizadas, pois o lado do servidor responsável pela inferência fica congestionado tentando processar as solicitações.
É provavelmente por isso que 15% das organizações relatam que menos de 50% das GPUs disponíveis e adquiridas estão em uso (Estado da infraestrutura de IA em escala em 2024).
Parte do problema está no uso de recursos de CPU para tarefas que deveriam ser executadas pela infraestrutura. Serviços como gerenciamento de tráfego, operações de segurança e monitoramento também consomem recursos de CPU e contribuem para a carga geral do sistema. Isso reduz a capacidade e o desempenho dos servidores de inferência e resulta em uma menor utilização dos recursos de GPU.
Felizmente, esse renascimento da infraestrutura busca preservar os recursos de CPU para tarefas de inferência, transferindo as operações de infraestrutura para uma nova unidade de processamento: a DPU.
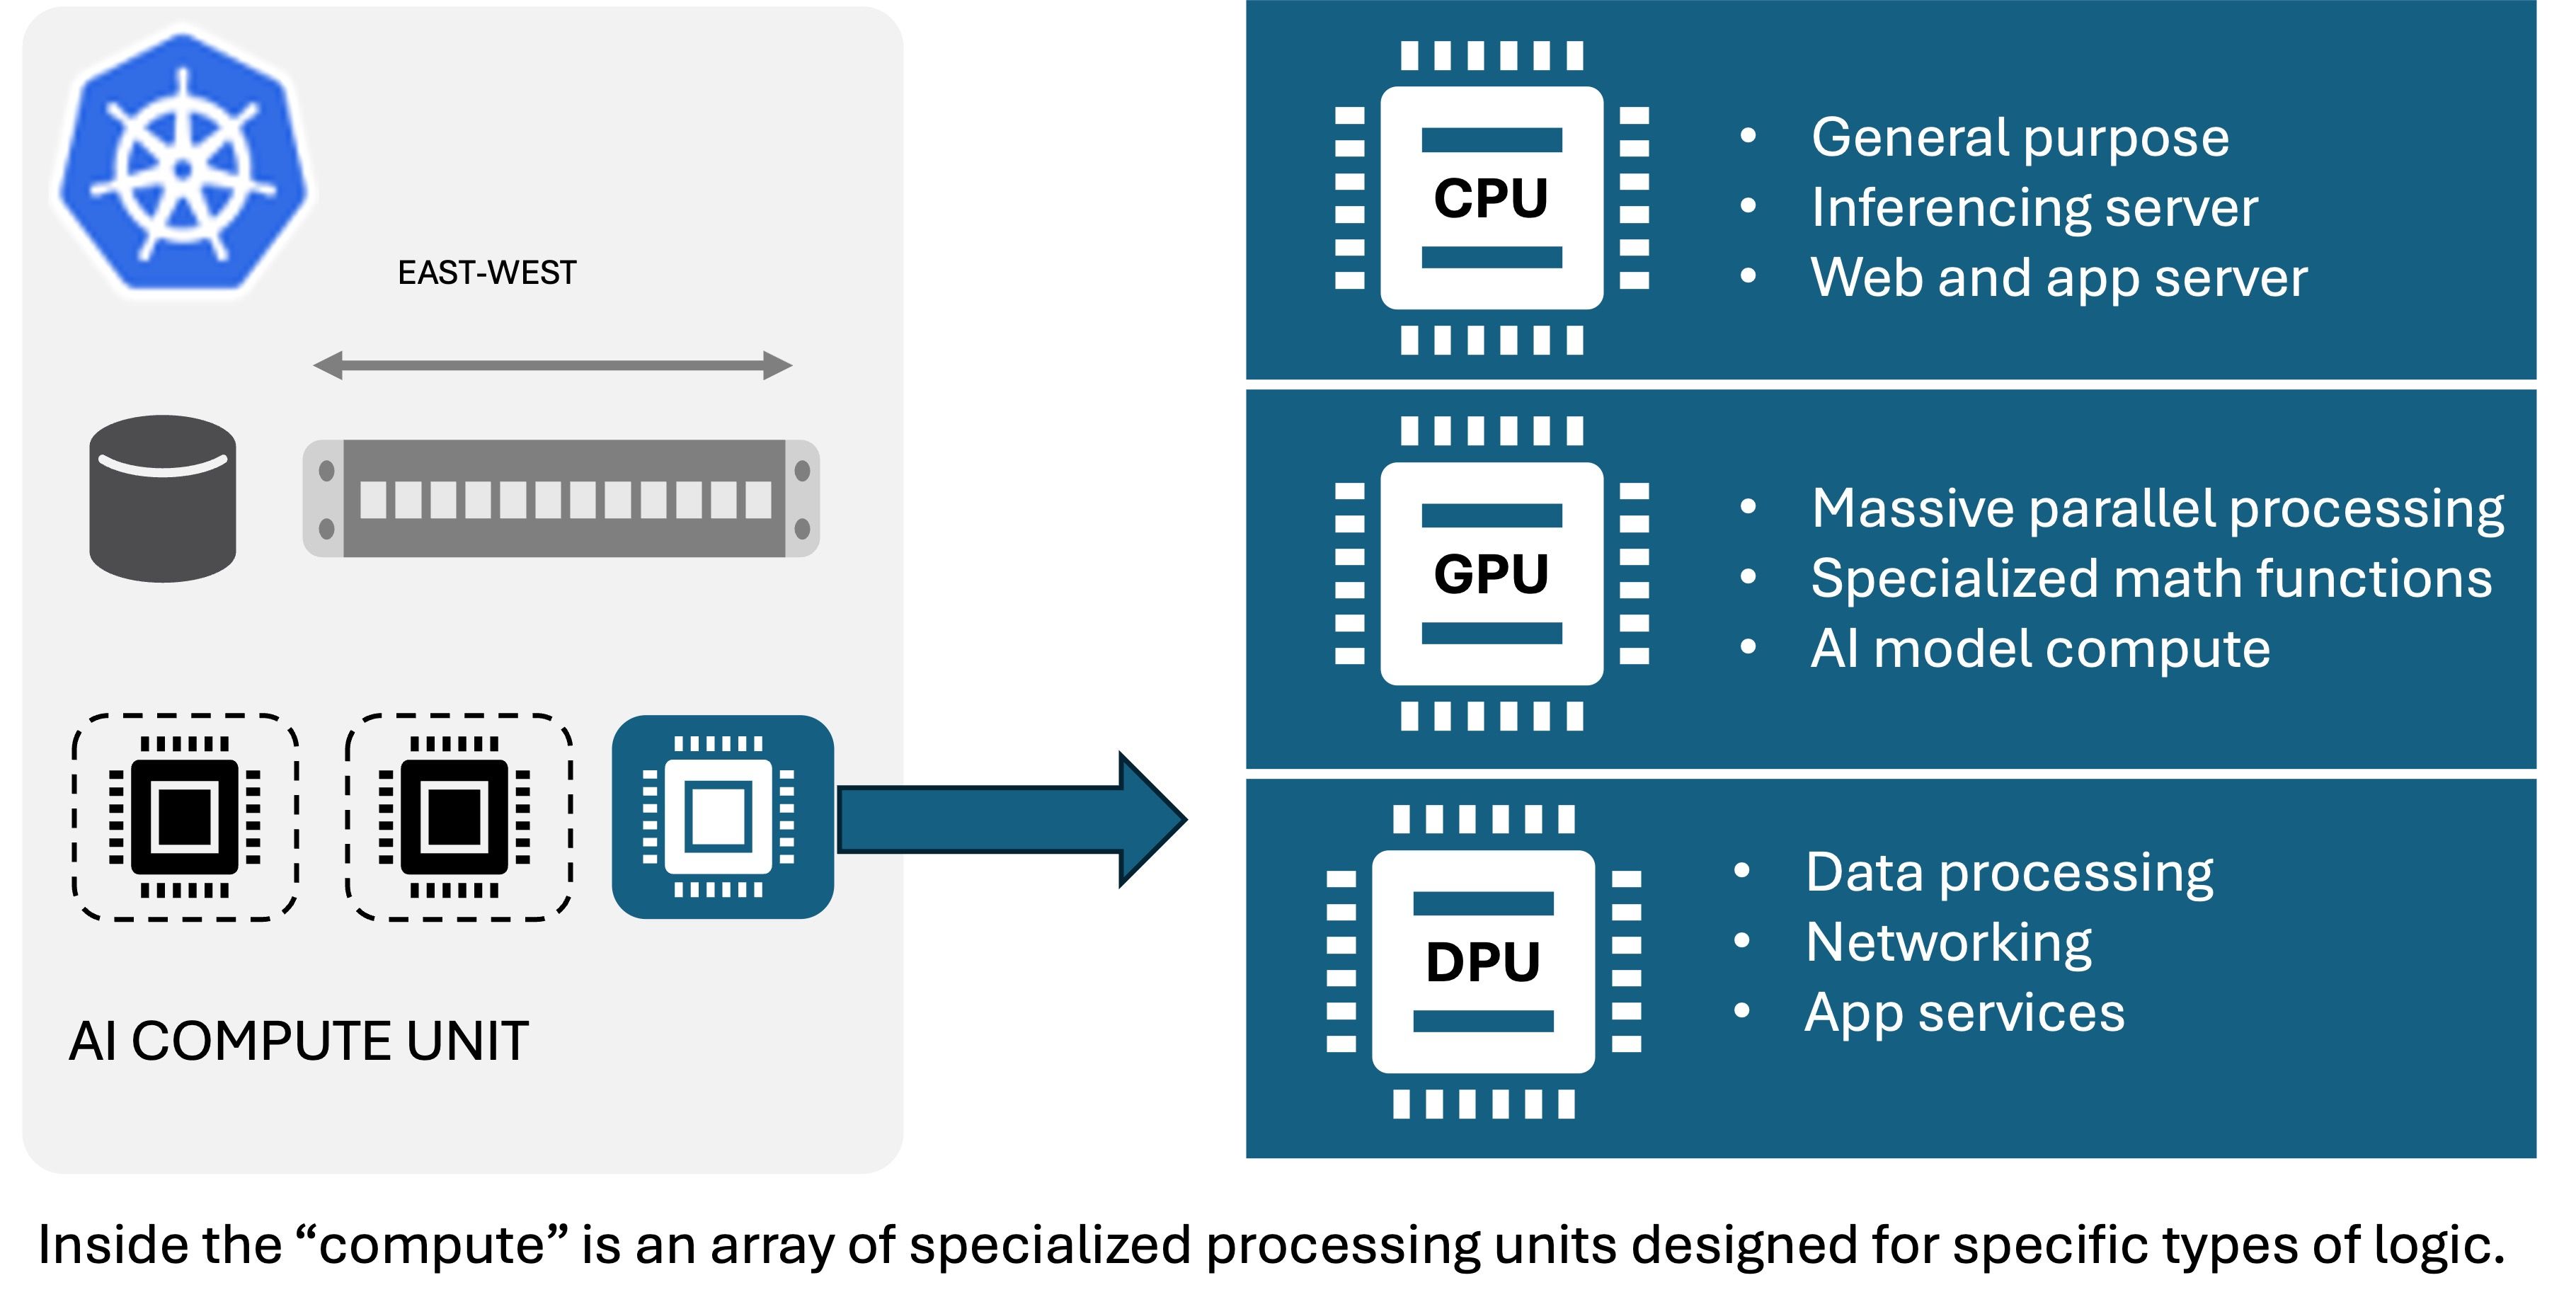
O interessante sobre as DPUs é que elas oferecem suporte a dois modos diferentes. Em um deles, podem transferir o processamento de rede, como RDMA sobre InfiniBand ou Ethernet. Isso ajuda muito na criação de um complexo de computação de IA em que grandes volumes de dados serão movimentados, como no treinamento de um modelo de IA ou na expansão da inferência para atender a uma ampla base de usuários.
Mas as DPUs também podem ser configuradas no modo ‘DPU’. No Kubernetes, isso faz com que apareçam como um nó separado, no qual podem ser executadas funções como entrega de aplicações e segurança. Na prática, isso reserva a capacidade de processamento da CPU para serviços de inferência ao ‘transferir’ as cargas de trabalho de infraestrutura menos previsíveis e mais exigentes para um nó próprio no cluster. Isso permite que soluções como F5 BIG-IP Next SPK (Service Proxy for Kubernetes) gerenciem e protejam, via API, as solicitações de IA N-S recebidas e as distribuam adequadamente ao serviço de inferência correspondente no complexo computacional de IA.
Essa abordagem permite que as organizações aproveitem o conhecimento e os investimentos existentes no gerenciamento de infraestrutura com Kubernetes, pois nossa solução é nativa do Kubernetes. Seja no núcleo, na nuvem ou na borda, não importa, pois a operação ocorre no nível do cluster e é consistente em todos os ambientes.
Isso também separa a responsabilidade pelo gerenciamento da entrega de aplicações e dos serviços de segurança, permitindo que as equipes de operações de rede e segurança gerenciem a infraestrutura independentemente das cargas de trabalho de IA administradas pelas equipes de operações de desenvolvimento e machine learning.
Por fim, o uso da DPU para a entrega e a segurança de aplicações atende melhor às necessidades de multilocação das organizações. Não se trata apenas de isolar as cargas de trabalho dos clientes, mas também as cargas de trabalho dos modelos. Nossa pesquisa mostra que as organizações já usam, em média, 2,9 modelos diferentes. A capacidade de gerenciar o uso de cada um deles por meio de uma solução consistente proporcionará maior confiança na segurança e na privacidade dos dados consumidos e gerados por cada modelo.
Esta não é a primeira vez que a F5 trabalha com as DPUs da NVIDIA em casos de uso relacionados à IA. Mas é a primeira vez que trabalhamos em conjunto para desenvolver uma solução que ajude clientes de todos os portes a criar complexos de computação de IA escaláveis e seguros, permitindo que aproveitem com segurança e confiança o poder da inferência em qualquer ambiente e otimizem o uso dos recursos de GPU, evitando que fiquem ociosos.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

O estado da maturidade digital empresarial: a transformação digital ainda não terminou
Explore como a IA impacta as empresas, as aplicações da IA generativa, as estratégias para modernizar as operações de TI e os benefícios da maturidade digital com a F5.
Como a IA generativa acelera a transformação digital
Veja como a IA generativa impulsiona a transformação digital nas empresas, acelerando tendências como a integração de APIs, os desafios dos modelos operacionais de TI híbrida e a adoção de AIOps.
Seis capacidades técnicas para acelerar a transformação digital
As arquiteturas empresariais atuais carecem dos fatores necessários de agilidade, escalabilidade, segurança e observabilidade, essenciais para impulsionar a mudança tecnológica. No entanto, estas seis capacidades fundamentais ajudarão as empresas a gerenciar riscos e desafios ao longo de sua transformação digital.
Inverter a API é a transformação digital de que as empresas precisam para participar e competir em uma economia de APIs
As organizações detêm um valor latente — na forma de APIs internas — que precisam explorar para competir em uma economia de APIs. Embora os desafios técnicos e de segurança possam desestimular algumas delas, as empresas precisam reconhecer que inverter suas APIs permitirá liberar o valor da organização como plataforma.
A modernização da TI começa pela infraestrutura
O hardware e o software evoluíram rapidamente desde os primórdios da internet, mas, para aproveitar ao máximo os benefícios resultantes dessa evolução, as organizações precisam avaliar e modernizar sua infraestrutura e a entrega de aplicativos. Acelere os esforços de modernização com a nova F5 rSeries.