
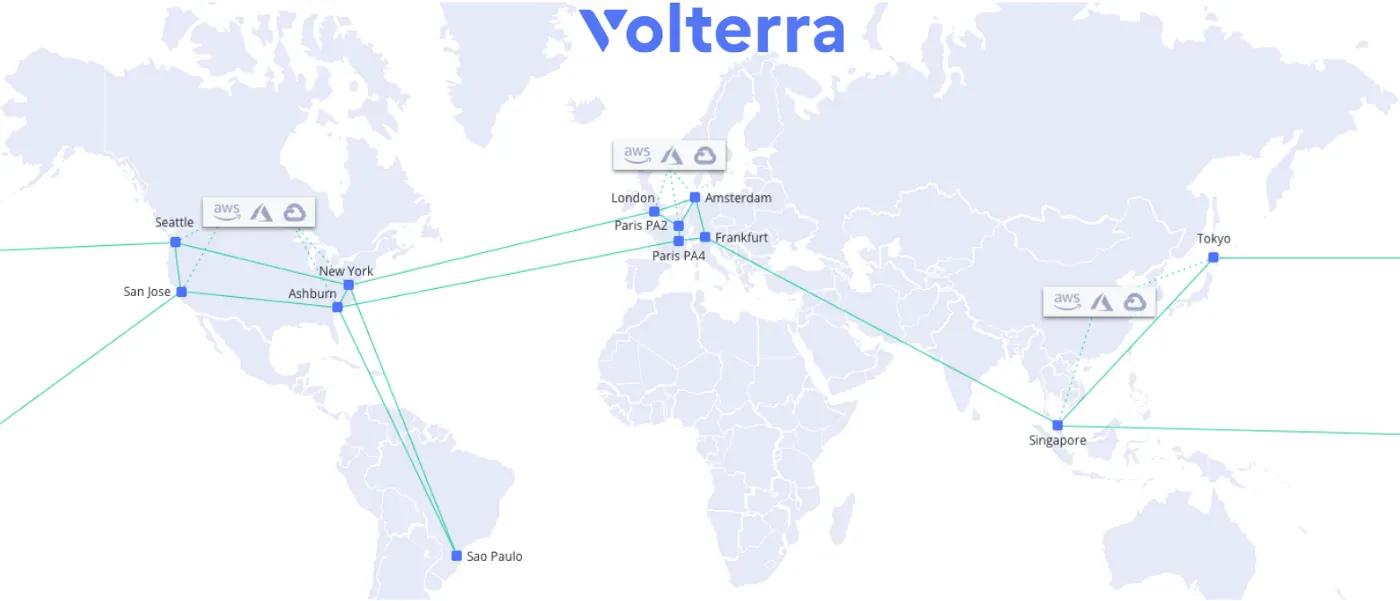
Como parte do nosso plano de controle baseado em SaaS, construímos e operamos nosso próprio backbone global (AS35280), usando vários links de 100G e 400G entre nossos PoPs.
Dessa forma, temos controle total sobre a conectividade de ponta a ponta entre nossas bordas regionais, além de podermos oferecer aos nossos clientes a mesma conectividade de alto desempenho e baixa latência — abrangendo seus data centers privados, sites de borda, VPCs de nuvem pública (AWS, Azure, GCP), bem como provedores de SaaS.
O requisito
Nossa presença na Europa já era bastante sólida, com operações em Paris, Londres, Amsterdã e Frankfurt, mas clientes atuais e novos demandavam um novo PoP em Lisboa, Portugal.
Tudo isso foi acordado no início de 2020, e a implantação estava prevista para o terceiro trimestre de 2020. É claro que isso foi antes da COVID-19 :)
Com a crise, observamos um aumento significativo no tráfego em nosso backbone (e também nos ataques DDoS, mas falaremos mais sobre isso em uma futura publicação no blog), e nossos clientes também.
Eles nos pediram que fizéssemos a implantação antes do terceiro trimestre, pois precisavam desse PoP o quanto antes — mais precisamente, antes do fim de maio. E como nós da Volterra somos gente boa e também gostamos de desafios, analisamos cuidadosamente o tempo necessário para atender à demanda do cliente:
- Precisávamos de pelo menos duas semanas para implantar e testar,
- E uma semana para validar
Como estávamos no início de abril, isso parecia viável e decidimos seguir em frente e lançar o projeto, embora aquele fosse realmente o pior momento possível para fazer isso, devido a:
- Proibição de viagens,
- Sem acesso ao data center,
- Escassez global de componentes,
- Sem falar nos riscos à saúde.
O que é necessário?
Implantar um novo PoP não envolve apenas roteadores, switches e cabos. Você também precisa:
- realizar a engenharia de rede para escolher a melhor localização e os melhores provedores de circuitos ópticos,
- fechar um acordo/negociar com o data center escolhido (Equinix LS1, nesse caso),
- negociar com o IXP para garantir portas de peering,
- e, é claro, solicitar o hardware/material necessário (roteadores, switches, cabos, firewalls, …)
Como fizemos isso
Com a crise em curso, foi impossível obter o hardware necessário a tempo. Por isso, decidimos reutilizar alguns equipamentos que tínhamos disponíveis, principalmente do nosso laboratório. Essa foi uma concessão aceitável (por exemplo, os roteadores usados serão Juniper QFX10K em vez dos MX10K planejados).
A preparação, que normalmente fazemos, obviamente, em um data center (devido à necessidade de energia e espaço em racks, mas também… ao barulho!), teria que ser realizada em casa por causa do lockdown. Raphaël, nosso CTO de Infraestrutura, tinha um escritório grande o suficiente (além de um contrato de fornecimento de 60 amperes, o que pode ser útil ao ligar equipamentos que consomem até 16 amperes!), então ele faria toda a preparação sozinho, o que também evitaria envolver outros funcionários ou obrigá-los a sair de casa.
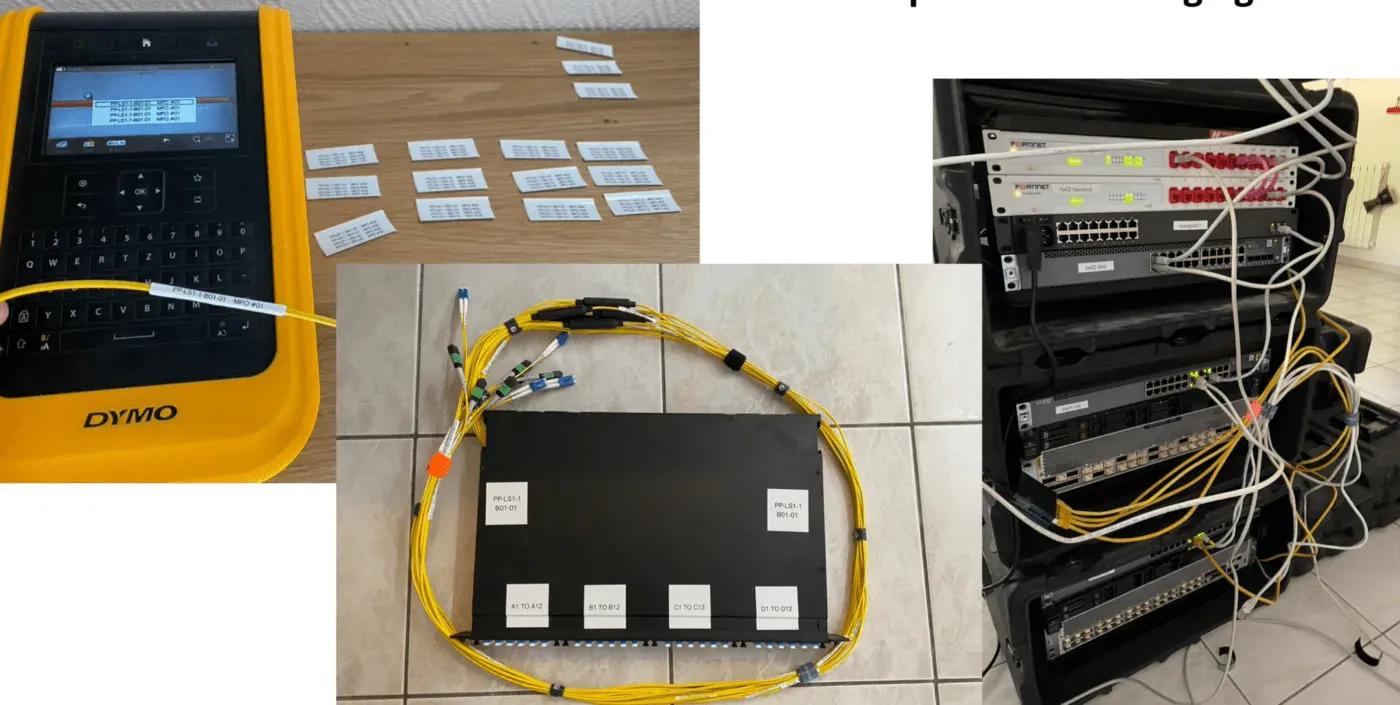
Depois que tudo foi configurado e testado várias vezes, enviamos para Lisboa:
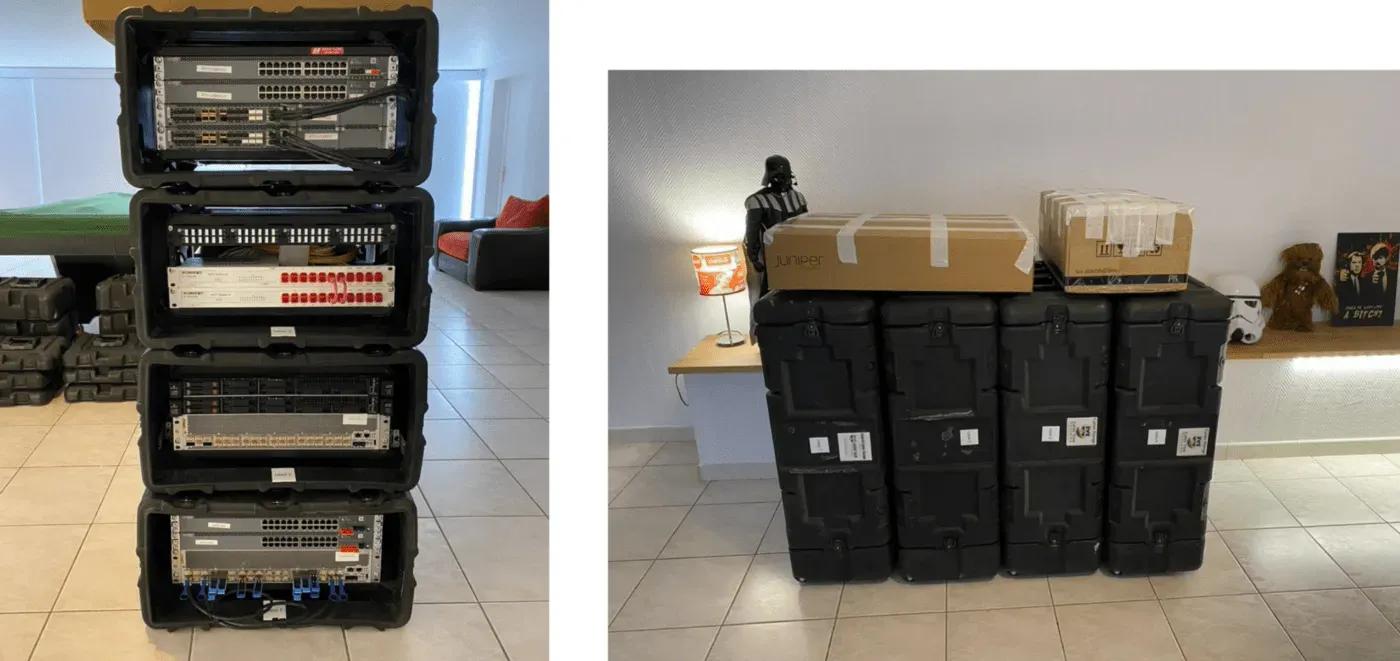
Instalação do rack em Lisboa pela equipe de suporte remoto da Equinix
Embora estivéssemos confiantes na configuração que fizemos (e, de qualquer forma, tivéssemos acesso remoto via OOB ou pelo nosso backbone), essa ainda era a primeira vez que um novo PoP não seria implantado diretamente por nós, mas por outra pessoa 😅
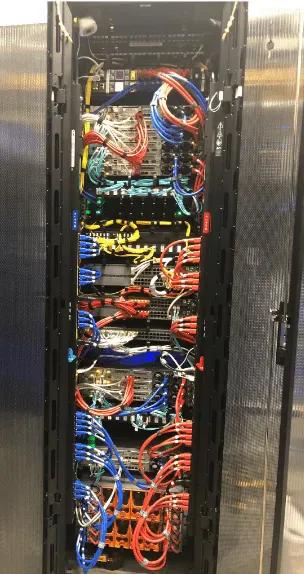
Usamos o mesmo design de rack em todo o mundo, e o objetivo era manter a consistência e ter a mesma configuração neste novo PoP de Lisboa.
Por isso, tivemos que ser extremamente precisos nas instruções que dávamos à equipe de suporte remoto da Equinix, para que ela pudesse reproduzir a configuração simplesmente “seguindo o guia”.
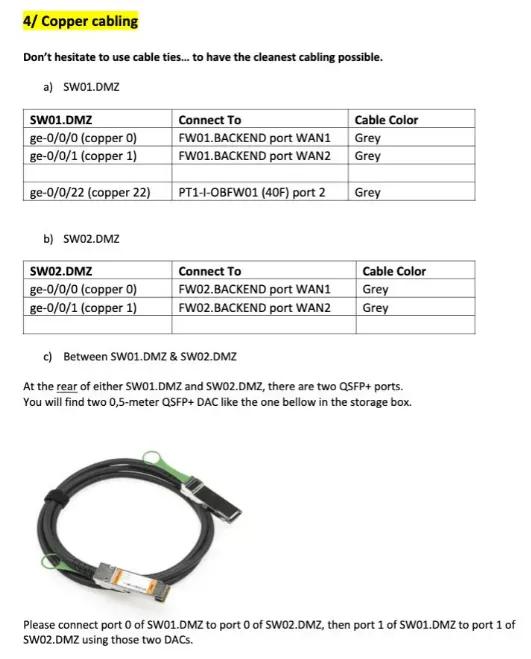
Abaixo está uma parte do procedimento que enviamos à Equinix, para que eles pudessem instalar tudo no rack e fazer todas as conexões com facilidade.
Há muitos componentes com os quais lidar — não apenas os equipamentos de hardware (roteadores, switches, firewalls e servidores), mas também o cabeamento e, mais importante, as portas dos switches e servidores às quais os cabos devem ser conectados.
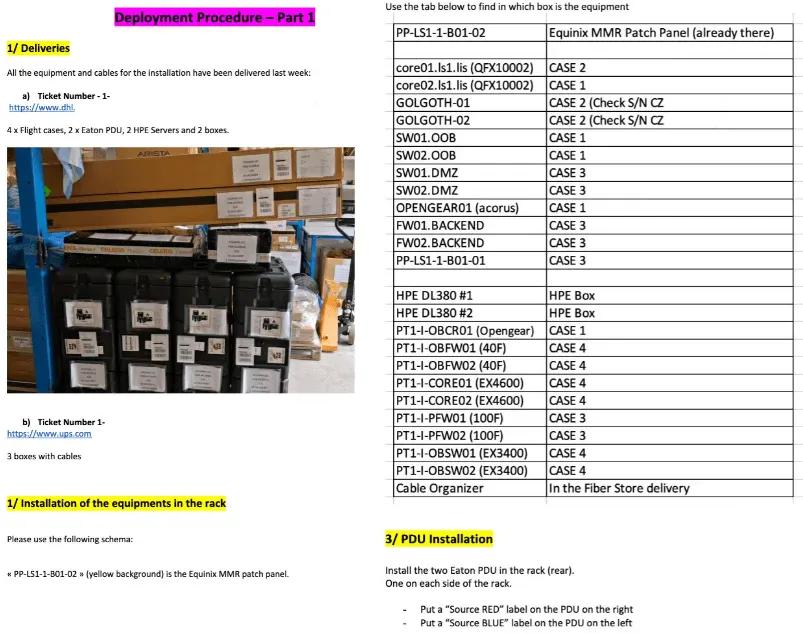
Como você pode ver abaixo, o procedimento é o mais detalhado possível, levando em consideração que os técnicos da Equinix têm muitas instalações para realizar. Portanto, quanto mais precisos formos, melhor!
Isso funcionou?
Sim! A instalação começou em 5 de maio, com todos os dispositivos montados nos racks e ligados, sem nenhuma falha de hardware — tivemos sorte, ou talvez, graças à nossa experiência, o envio e a embalagem tenham sido feitos corretamente, ou quem sabe ambos — mas, de qualquer forma, tudo funcionou perfeitamente.
No dia seguinte, os técnicos da Equinix cuidaram do cabeamento (cobre/fibra) e, às 23h30, já conseguíamos pingar nosso PoP de Lisboa a partir de Paris!
A instalação foi concluída em 7 de maio, após a realização das tarefas finais, como a configuração das PDUs, a conexão cruzada das portas OOB e a verificação de ponta a ponta das portas do IXP. Como as configurações dos nossos switches e do firewall estavam totalmente funcionais, não foi necessário solicitar nenhuma alteração de configuração à Equinix.
A instalação final ficou assim:
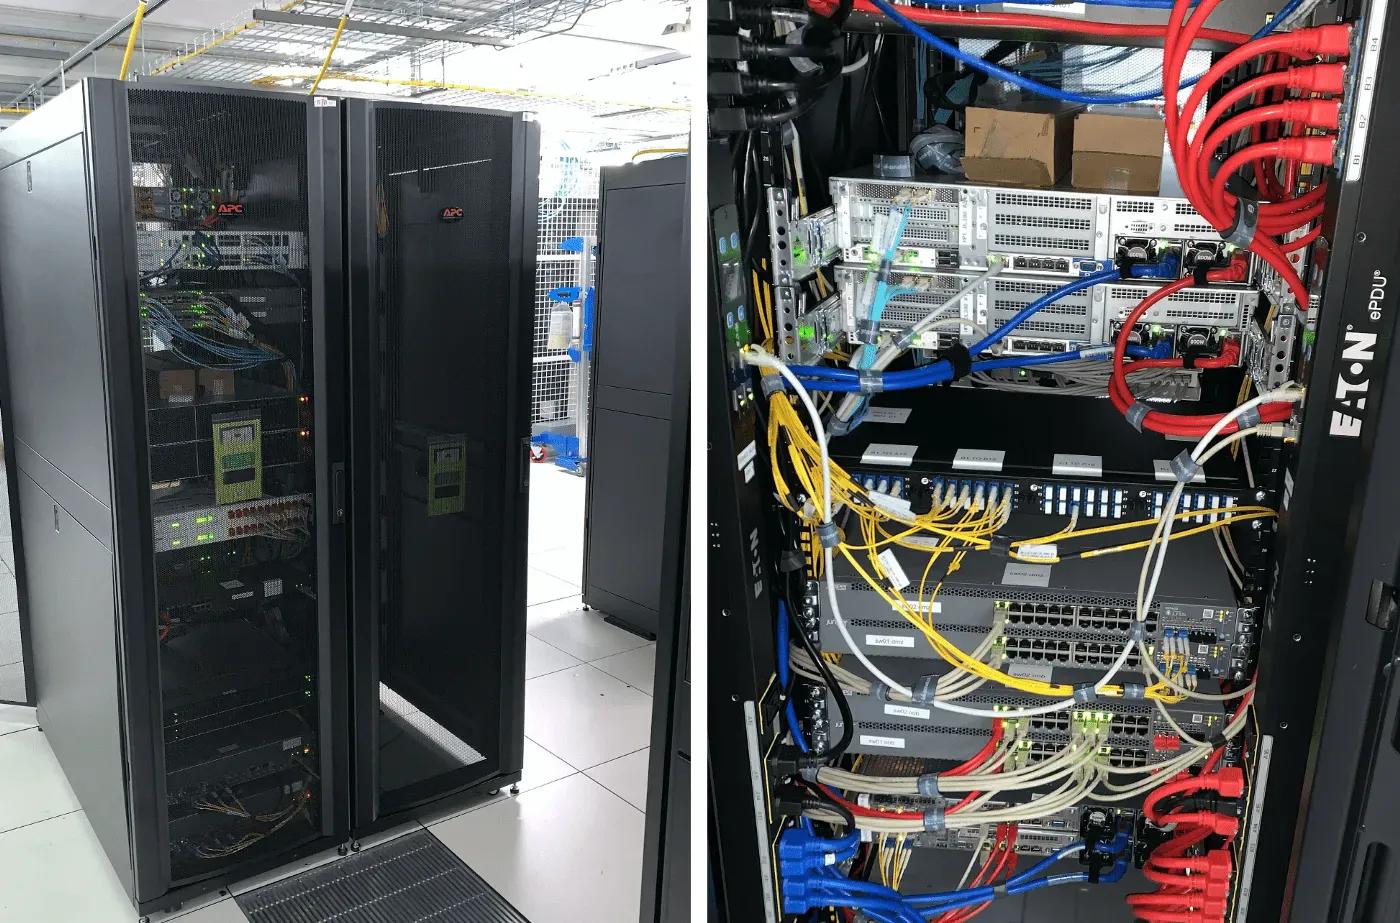
Como somos extremamente exigentes, não estamos 100% satisfeitos. Por exemplo, o painel traseiro do rack não está tão bem-acabado quanto gostaríamos — mas vamos corrigir isso assim que a crise passar e pudermos viajar novamente para Portugal.
“Post-mortem” — o que funcionou, por quê e o que pode ser melhorado
Embora estejamos extremamente felizes e orgulhosos por termos conseguido superar o desafio, gostamos de dar um passo atrás e refletir sobre o que funcionou, mas principalmente sobre o que pode ser melhorado.
O que funcionou:
- Equinix: é importante informar um fornecedor quando as coisas não estão indo bem, mas é ainda mais importante fazer isso quando tudo correu bem e superou as expectativas — e esse é o caso aqui. Da equipe de Vendas e da Alta Administração aos técnicos do Data Center, o suporte e a agilidade que recebemos foram simplesmente incríveis — especialmente durante aqueles momentos difíceis —, então, realmente, parabéns à Equinix!
Por que isso funcionou?
- A Volterra já era, em grande parte, uma empresa distribuída e que priorizava o trabalho remoto — especialmente nossa equipe francesa, responsável por NetOps, cujos integrantes estão espalhados por toda a França e acostumados a trabalhar remotamente usando ferramentas colaborativas.
- Tínhamos hardware reserva/de laboratório suficiente para usar, o que nos permitiu cumprir o prazo
- O procedimento que explicamos brevemente acima é resultado de anos de implantações e experiência, com melhorias iterativas, e valeu a pena.
- Ter um bom relacionamento com nossos fornecedores é fundamental para nós: quando algo dá errado, entramos em uma chamada e não hesitamos em dizer isso a eles. Por outro lado, isso permite que eles melhorem não apenas para nós, mas para todos os seus clientes.
- Necessidade de rapidez/preço/qualidade: é preciso ter expectativas elevadas — e isso inclui investir em recursos ANTES de precisar deles!
O que pode ser melhorado?
- Percebemos que apenas algumas pessoas (de 3 a 4) na empresa conseguiriam realizar uma implantação desse tipo — precisamos encontrar uma forma de ganhar escala
- Além disso, queremos melhorar a forma como fazemos o staging, para evitar ter que fazer primeiro um staging completo
- Por fim, uma implantação desse tipo não é apenas uma questão técnica: as equipes de Vendas/Pré-vendas precisam estar cientes do tempo necessário para todo o projeto e para cada uma de suas etapas — e não presumir que a equipe de NetOps pode resolver qualquer coisa e, por isso, repassar projetos sem uma avaliação adequada dos prazos.
Apresentamos essa implantação durante a primeira reunião remota do RIPE (RIPE 80). Você pode assistir à gravação aqui:
Sobre o autor
Publicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...