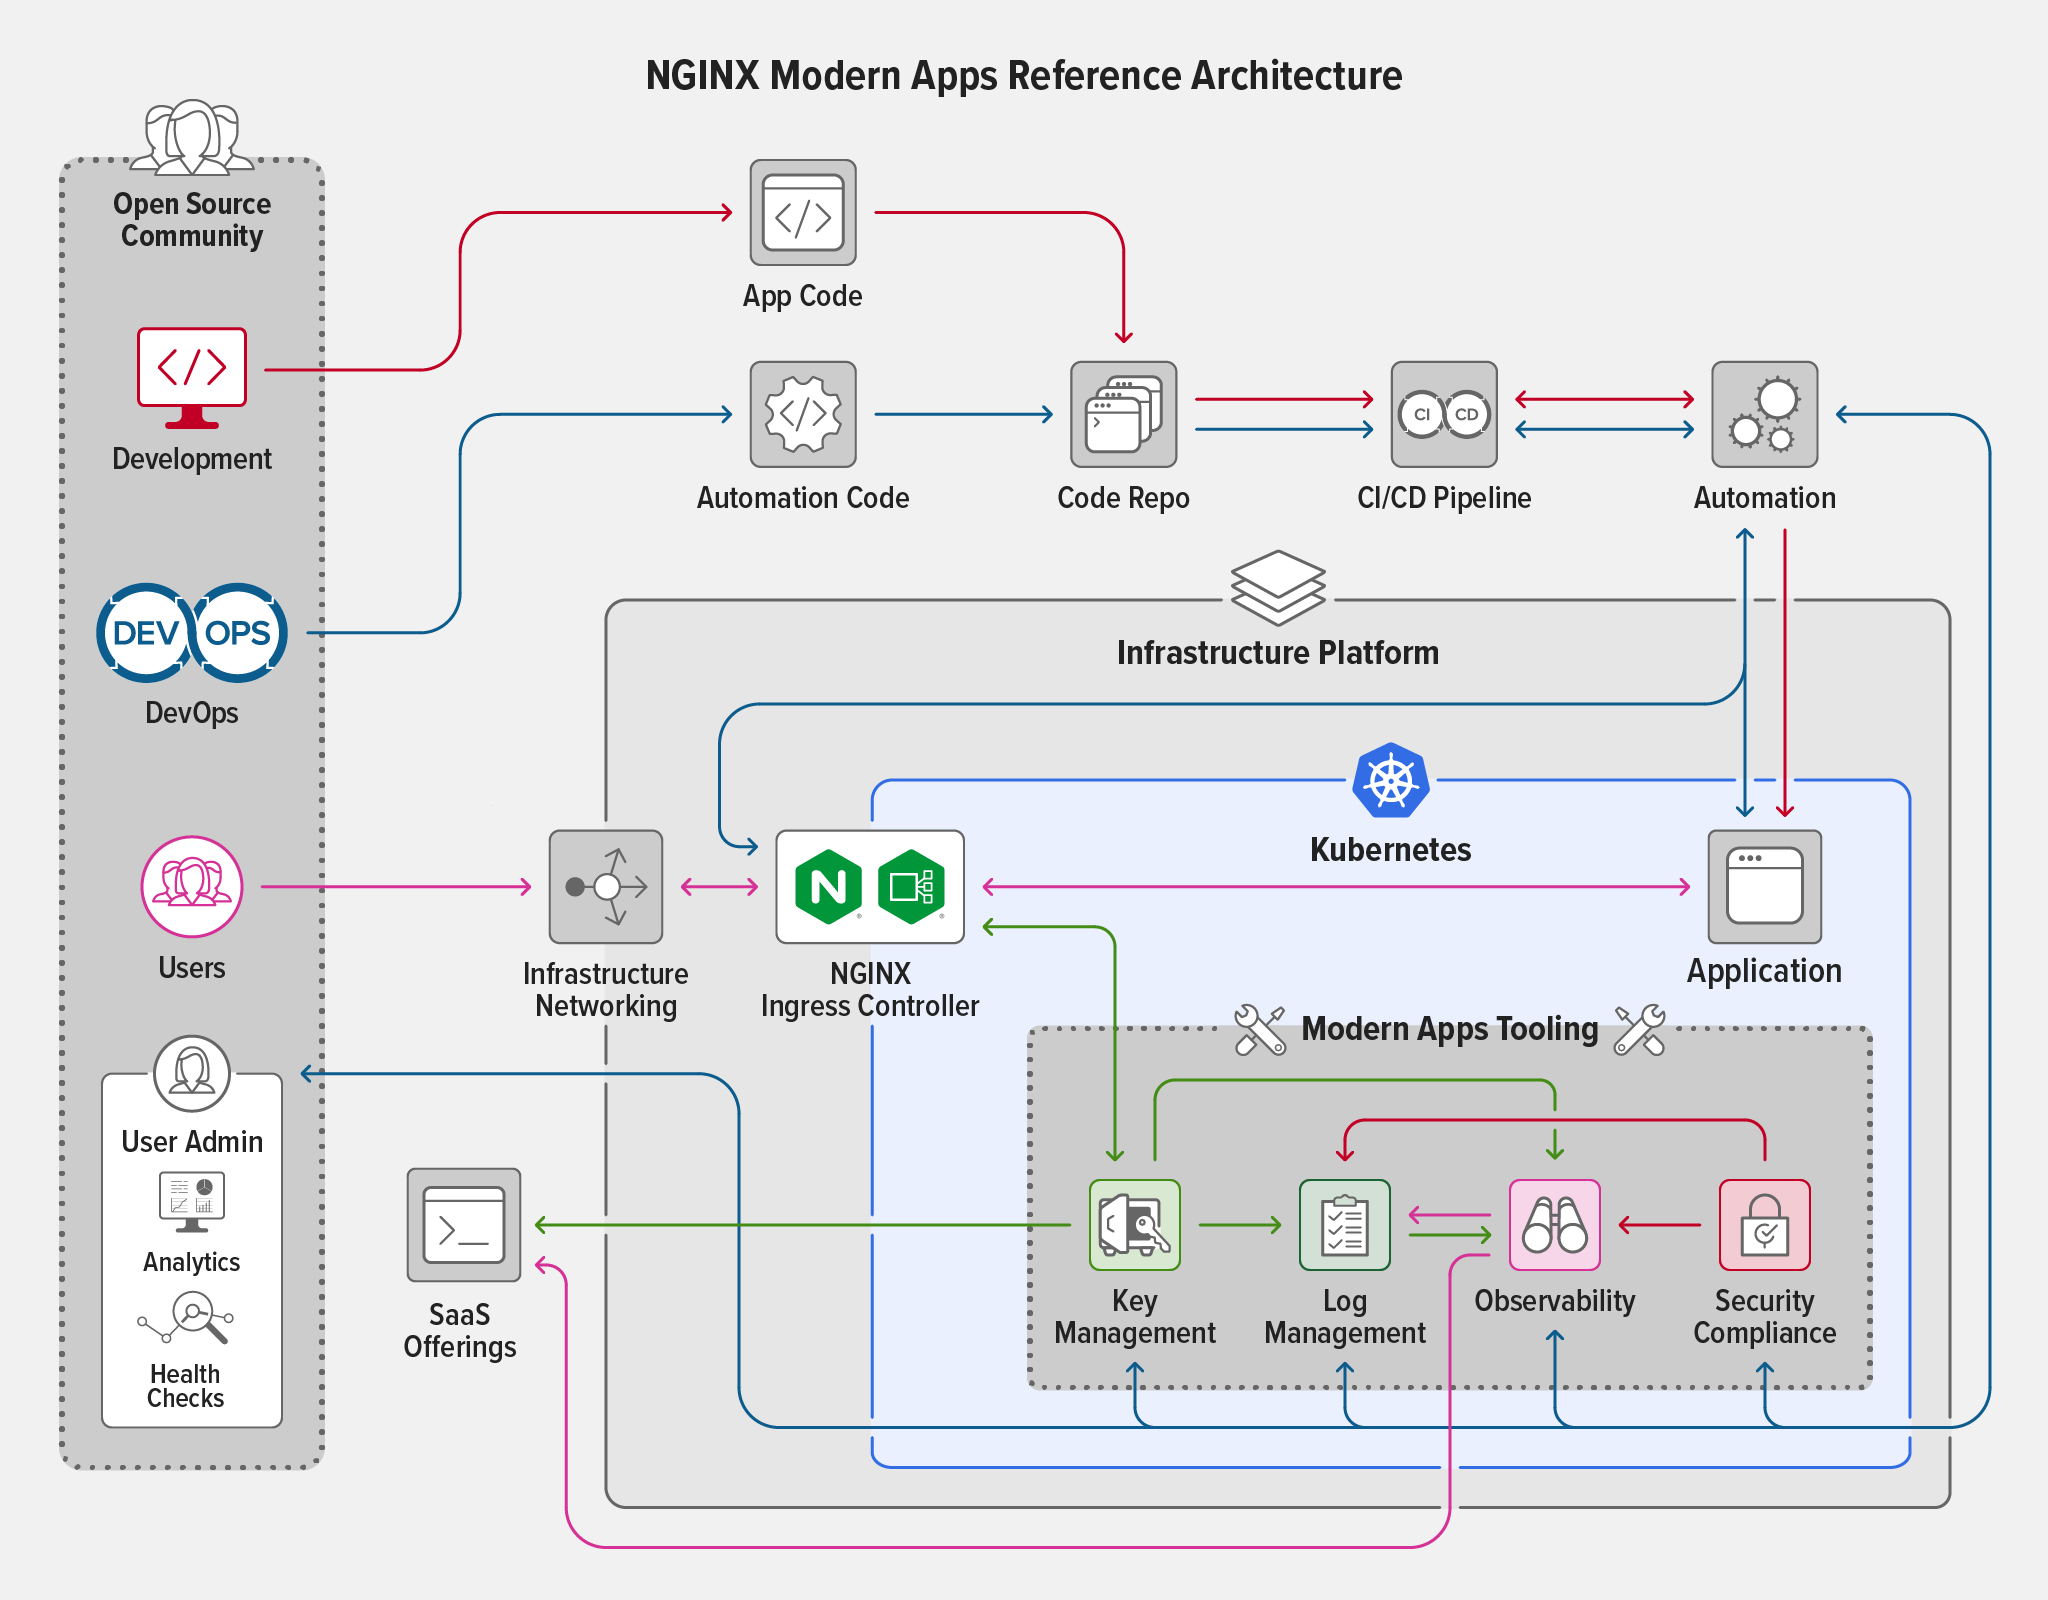
Fomos transparentes quanto aos nossos objetivos de design quando apresentamos a Arquitetura de Referência para Aplicações Modernas da NGINX (MARA) no Sprint 2.0, em agosto de 2021. Queríamos criar um exemplo de arquitetura de aplicação moderna executada no Kubernetes e projetada para oferecer segurança, escalabilidade, confiabilidade, monitoramento e introspecção. Esse projeto precisava poder ser implantado em diferentes infraestruturas, com uma abordagem “plug and play” para combinar componentes funcionais sem esforços demorados de integração.
Nos meses que se seguiram ao Sprint, avançamos em nosso roteiro. Como em qualquer projeto, tivemos sucessos e fracassos e incorporamos nossos acertos à MARA, ao mesmo tempo que mantivemos uma lista cada vez maior de lições aprendidas. Esperamos evitar que outras pessoas enfrentem os mesmos problemas documentando essas questões e projetando com essas lições em mente.
Recentemente, alcançamos um marco importante com a versão 1.0.0 do MARA, que reorganiza o diretório do projeto e altera o processo de criação e destruição do ambiente. Eliminamos códigos duplicados, criamos uma estrutura de diretórios que facilita futuras adições e padronizamos os scripts de gerenciamento. Como esta versão representa um momento importante na história do MARA, gostaríamos de fazer uma pausa para compartilhar nosso progresso com a comunidade, destacar algumas das lições que consideramos mais importantes e fornecer informações sobre os próximos passos do nosso roteiro.
Telemetria – Métricas, Logs e Rastreamento
Os principais colaboradores do MARA têm experiência na operação de software em larga escala e entendem o que é necessário para prestar serviços sob as perspectivas operacional, de engenharia e de gestão. Eles conhecem a sensação angustiante que surge quando uma aplicação apresenta um comportamento inesperado e não há uma maneira fácil de identificar exatamente qual é o problema. Uma frase que circula no mundo de DevOps resume bem a questão: “Depurar microsserviços é como solucionar uma série de mistérios de assassinato”.
Com isso em mente, tornamos a implementação da observabilidade uma das principais prioridades do nosso roteiro de curto prazo. Nesse contexto, a observabilidade inclui o gerenciamento de logs, métricas e dados de rastreamento. No entanto, apenas coletar dados não é suficiente — é preciso analisá-los a fundo e tomar decisões relevantes sobre o que está acontecendo no ambiente.
Nossa análise das opções de rastreamento nos levou ao OpenTelemetry (OTEL), pois ele oferece suporte a todo o espectro de dados de telemetria: logs, métricas e rastreamentos. Idealizamos uma implementação na qual o agente OTEL coleta, processa e elimina duplicidades de todos os dados de rastreamento antes de encaminhá-los ao coletor OTEL para agregação e exportação, com um sistema de visualização no final do fluxo de trabalho para tornar os dados utilizáveis. Essa abordagem oferece aos usuários a mais ampla variedade de opções para exibir e analisar dados, aproveitando o padrão OTEL para simplificar as etapas anteriores (coleta, agregação e assim por diante).
Desenvolvemos a implementação em duas etapas:
- Implante o OpenTelemetry Operator for Kubernetes para gerenciar um coletor OTEL no ambiente
- Instrumente o Bank of Sirius para que o aplicativo emita rastreamentos e métricas
A versão original do MARA usava o Elasticsearch com o Filebeat para registro de logs e, embora tenhamos considerado substituí-los pelo Grafana Loki, decidimos manter a escolha original por enquanto. Quanto às métricas, percebemos que precisávamos revisar a implantação original baseada no Prometheus e no Grafana, substituindo a configuração personalizada do Prometheus que havíamos usado inicialmente pelo chart Helm kube-prometheus-stack, mantido pela comunidade, que implanta um ambiente Prometheus completo, incluindo o Grafana, exportadores de nós e uma série de painéis e alvos de coleta pré-configurados, adequados para gerenciar um ambiente Kubernetes. Também adicionamos alguns painéis extras para o F5 NGINX Ingress Controller e para a aplicação Bank of Sirius.
Este é apenas um breve resumo da enorme quantidade de trabalho necessária para implementar o OTEL. Para poupar outras pessoas do esforço de enfrentar a mesma curva de aprendizado acentuada, documentamos todo o processo em Integração do OpenTelemetry à arquitetura de referência de aplicações modernas – um relatório de progresso em nosso blog.
Opções de implantação – Kubeconfig
Na versão inicial do MARA, escolhemos o Amazon Elastic Kubernetes Service (EKS) como ambiente de implantação. Desde então, muitos usuários nos disseram que, por questões de custo, desejam executar o MARA em ambientes “locais” que exijam menos recursos, como um laboratório ou uma estação de trabalho. A portabilidade era um dos principais objetivos do projeto original (e continua sendo), então essa foi a nossa oportunidade de provar que conseguiríamos alcançá-lo. Para facilitar a tarefa, decidimos criar um procedimento de implantação que pudesse ser executado em qualquer cluster Kubernetes que atendesse a alguns requisitos mínimos.
Como primeira etapa, adicionamos ao MARA um novo projeto Pulumi que lê um arquivo kubeconfig para se comunicar com o cluster Kubernetes. Esse projeto fica entre os projetos Pulumi Kubernetes e os projetos de infraestrutura (como os projetos para AWS e Digital Ocean). Na prática, a criação do projeto kubeconfig facilita a integração de um novo projeto de infraestrutura. Se um projeto de infraestrutura puder fornecer ao projeto kubeconfig um arquivo kubeconfig, o nome do cluster e o contexto do cluster, o restante do procedimento de implantação do MARA funcionará perfeitamente.
Para nossos testes, usamos várias distribuições Kubernetes fáceis de instalar e com baixos requisitos de CPU e memória, incluindo K3s, Canonical MicroK8s e minikube. Todas as distribuições foram implantadas em uma máquina virtual (VM) executando o Ubuntu 21.10, com 2 CPUs e 16 GB de RAM. Além disso, todas as distribuições foram configuradas para oferecer volumes persistentes e suporte ao Kubernetes LoadBalancer.
A parte mais difícil desse processo foi trabalhar com o registro privado usado pelo NGINX Ingress Controller personalizado que faz parte do projeto. (Observe que, ao implantar o MARA, você pode usar o NGINX Ingress Controller padrão baseado no NGINX Open Source ou no NGINX Plus, bem como esse NGINX Ingress Controller personalizado.) Descobrimos que precisávamos desvincular nossa lógica de registro do Amazon Elastic Container Registry (ECR) em favor de uma abordagem mais independente de plataforma, uma tarefa que está em andamento. Também percebemos que nossa lógica para obter o nome do host do endereço de saída era muito específica para o AWS Elastic Load Balancing (ELB) e precisava ser reescrita para se aplicar a outros casos de uso.
Os scripts de gerenciamento do MARA e os projetos do Pulumi atualmente usam uma lógica específica para contornar os problemas descritos acima. Por enquanto, as implantações baseadas na configuração do Kubernetes devem usar o NGINX Ingress Controller (baseado no NGINX Open Source ou no NGINX Plus) dos registros oficiais da NGINX.
Adicionamos vários parâmetros de ajuste aos arquivos de configuração do MARA para viabilizar implantações locais que não oferecem os recursos necessários para uma implantação baseada em nuvem. A maioria dos parâmetros está relacionada ao número de réplicas solicitadas para os diversos componentes do Elastic Stack. À medida que os testes avançarem, serão adicionados outros parâmetros para ajustar o MARA com base nas limitações de recursos do ambiente de implantação.
Com essas alterações implementadas, podemos realizar implantações com sucesso no K3s, MicroK8s e Minikube, e testamos a lógica com sucesso no Azure Kubernetes Service (AKS), na Digital Ocean, no Google Kubernetes Engine, na Linode e no Harvester da Rancher. Para obter mais informações, consulte a página de status dos provedores do MARA e o artigo MARA: agora em execução em uma estação de trabalho perto de você em nosso blog.
Colaboração com parceiros
Nossos parceiros têm sido muito receptivos e apoiado bastante nosso trabalho com o MARA. Muitos deles entraram em contato para saber mais sobre o projeto, entender como podem aproveitá-lo em seus produtos ou até mesmo adicionar funcionalidades.
Escolhemos a Pulumi como parte central do MARA por sua facilidade de uso e compatibilidade com Python. Por ser uma linguagem tão popular, o Python torna o código do MARA facilmente compreensível para uma ampla comunidade. Além disso, a comunidade ativa da Pulumi e seu envolvimento no projeto serviram de modelo para a participação da comunidade que esperamos alcançar com o MARA.
No final de 2021, trabalhamos com a Sumo Logic para integrar o MARA à sua solução de monitoramento de nuvem com o NGINX Ingress Controller. Essa foi uma oportunidade de colocar à prova nossa afirmação de que o MARA é modular. O desafio era substituir o Grafana, o Prometheus e o Elastic no MARA pela solução da Sumo Logic. Ficamos satisfeitos por termos conseguido implantar a solução usando a mesma lógica empregada em outras implantações e configurá-la não apenas para se conectar ao SaaS da Sumo Logic, mas também para coletar métricas do nosso ambiente.
Como parte do nosso trabalho com o OpenTelemetry, colaboramos com a Lightstep e reconfiguramos facilmente nosso coletor OTEL para exportar rastreamentos e métricas para a oferta de SaaS da Lightstep. Essa é uma área que temos grande interesse em explorar mais a fundo, pois acreditamos firmemente que o OTEL é o futuro da observabilidade.
Lições aprendidas… até agora
A maior lição que aprendemos até agora é a importância de uma abordagem modular. O trabalho com o Sumo Logic mostra que podemos combinar componentes do MARA com sucesso. Esperamos obter mais confirmações à medida que integramos o OTEL de forma mais completa ao ambiente. Mencionamos anteriormente que estamos considerando substituir o Elasticsearch pelo Grafana Loki como ambiente de gerenciamento de logs, pois isso reduz o consumo de recursos da stack. Dito isso, defendemos uma “modularidade pragmática”, em vez de levar tudo ao extremo e transformar cada componente em um microsserviço. Por exemplo, embora faça sentido ter um serviço especializado capaz de processar logs de várias aplicações, não é tão evidente que sejam necessários microsserviços separados para coleta, armazenamento e visualização de logs.
Também aprendemos que é útil definir valores padrão incluindo-os explicitamente na configuração, em vez de simplesmente omitir o parâmetro relevante. Isso facilita o trabalho dos administradores de duas maneiras: eles não precisam se lembrar dos valores padrão e podem alterá-los facilmente, bastando modificar um parâmetro que já aparece com a sintaxe correta no local apropriado da configuração.
Outra lição dolorosa que aprendemos é que algumas soluções são populares não por serem as melhores, mas por serem as mais fáceis de instalar ou por terem o melhor tutorial. Por isso, é tão importante questionar suas premissas e consultar os colegas durante o processo de design — uma cultura de comunicação aberta contribui muito para identificar e corrigir problemas logo no início.
Dito isso, em várias ocasiões implementamos uma lógica que funcionava, mas que acabou nos deixando sem saída ou causando outros problemas. Por exemplo, quando começamos a implantar aplicações por meio do Pulumi, usamos manifestos YAML para ConfigMaps, recorrendo a transformações do Pulumi para atualizar variáveis. Isso funcionava, mas não era o ideal por vários motivos, entre eles a dificuldade de manutenção. Na iteração seguinte, melhoramos a legibilidade e a facilidade de manutenção do código usando o kube2pulumi para transformar os manifestos em código Pulumi, que então pudemos usar para criar os ConfigMaps.
Outra lição surgiu quando um merge inseriu configurações inválidas no YAML de implantação. Fomos obrigados a reescrever e revisar cuidadosamente grandes partes do YAML para garantir que o código estivesse sintaticamente correto e fizesse o que queríamos, um processo frustrante e demorado. Para evitar problemas futuros, agora automatizamos tanto a análise estática e a validação de YAML genérico quanto as específicas do Kuberneteslinting durante o processo de push para o GitHub.
Por fim, desde o início, nosso objetivo tem sido garantir que nossa branch principal esteja sempre pronta para execução. É frustrante quando você faz checkout de um novo projeto e precisa resolver um problema introduzido pelos mantenedores na branch principal. Infelizmente, falhamos nisso algumas vezes, inclusive nestes exemplos envolvendo o submódulo Bank of Sirius:
- Por engano, esquecemos de alterar o esquema da URL de ssh:// para https://. Isso não foi um problema para nós, pois todos usamos
sshpara nos conectar ao GitHub. No entanto, os usuários que não tinham uma chave SSH para o GitHub foram inundados com mensagens de erro ao tentar inicializar o submódulo. - Uma das versões dos scripts de gerenciamento dependia de um pacote comum que, equivocadamente, presumimos estar instalado nas máquinas de todos, assim como está nas nossas.
- Esquecemos de incluir uma verificação da origem do submódulo durante uma reescrita da lógica de inicialização. O submódulo inclui os manifestos necessários para implantar o Bank of Sirius e, infelizmente, os erros e avisos gerados quando esses manifestos não estavam disponíveis eram obscuros o suficiente para nos levar a uma odisseia de vários dias depurando comportamentos estranhos antes de descobrirmos a causa raiz.
O que vem a seguir
Temos grandes planos para os próximos meses de desenvolvimento, incluindo a refatoração da compilação do NGINX Ingress Controller, do envio para o registro e da lógica de nome do host/endereço IP do Ingress.
Uma coisa que percebemos a cada implantação do MARA é a rapidez com que começamos a observar varreduras e ataques ao NGINX Ingress Controller. Isso nos levou a começar a integrar o NGINX Ingress Controller ao NGINX App Protect WAF no MARA. Com isso, surgem o desafio e a oportunidade de determinar a melhor forma de gerenciar os logs gerados pelo App Protect.
Outra mudança que planejamos implementar nos próximos meses é fazer com que todos os módulos obtenham os segredos do Kubernetes, em vez de obtê-los tanto do Pulumi quanto do Kubernetes. Isso significa que todos os módulos usarão um repositório comum de segredos, dando ao administrador controle sobre como eles são preenchidos. Estamos desenvolvendo um novo módulo para ler os segredos de um repositório escolhido pelo usuário e criar os segredos correspondentes no Kubernetes.
Atualmente, o MARA inclui uma ferramenta de geração de carga que é uma versão aprimorada e ligeiramente modificada da ferramenta baseada no Locust que acompanha o aplicativo original Bank of Anthos, do qual derivamos o Bank of Sirius. A nova ferramenta de testes que estamos desenvolvendo, Cicada Swarm, não apenas gera carga, mas também monitora e informa quando as métricas ultrapassam os limites definidos por você, tornando-se uma estrutura para testes rápidos de desempenho de produtos de software na nuvem. Ela usa técnicas de paralelização para fornecer resultados de testes com o nível de confiança de que você precisa, maior precisão e análise de regressão personalizável para determinar o sucesso ou a falha das compilações em seus pipelines de CI/CD.
Por fim, não podemos falar de testes de carga sem abordar como mediremos o impacto desses testes, o que nos leva de volta à telemetria. Estamos entusiasmados com o potencial do OpenTelemetry e esperamos implementar em breve uma solução mais abrangente. Mesmo sem uma implementação completa, nosso objetivo é conseguir executar um teste, medir seu impacto e tomar decisões operacionais com base no que os dados nos mostram.
Como sempre, agradecemos seus pull requests, suas issues e seus comentários. Nosso objetivo com o MARA é inspirar a comunidade a colaborar para discutir, experimentar, testar e aprimorar diferentes soluções possíveis, ampliando nossa compreensão sobre a melhor forma de implantar e gerenciar uma aplicação moderna.
Posts relacionados
Esta publicação faz parte de uma série. À medida que adicionamos novos recursos ao MARA, publicamos os detalhes no blog:
- Uma nova arquitetura de referência de código aberto para aplicações modernas
- Integração do OpenTelemetry à arquitetura de referência de aplicações modernas – um relatório de progresso
- MARA: agora em execução em uma estação de trabalho perto de você
- Anunciando a versão 1.0.0 da Arquitetura de Referência para Aplicações Modernas do NGINX (esta publicação)
Sobre o autor
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.