Velocidade — ela é fundamental no cenário digital atual, em que os consumidores podem facilmente migrar para um concorrente se o desempenho do seu aplicativo for muito lento. Em última análise, a velocidade do aplicativo depende de APIs responsivas, robustas e adaptáveis, e um dos fatores críticos para a capacidade de resposta das APIs é a latência introduzida pelo gateway de API. Mas nem todos os gateways de API oferecem o mesmo nível de desempenho.
Isso ficou evidente para nós no segundo semestre do ano passado, quando um cliente da NGINX — uma grande empresa do setor de crédito ao consumidor — nos falou sobre a importância cada vez maior do desempenho das APIs em “tempo real”, à medida que mais aplicativos e outros componentes precisam se comunicar para proporcionar a experiência digital que os usuários esperam. Ficamos muito satisfeitos ao saber que o NGINX Plus foi o único gateway de API a alcançar as latências extremamente baixas de que o cliente precisava — chegando a apenas 10 milissegundos (ms). Muitos outros clientes, como a Capital One, também nos contaram como reduziram a latência e aumentaram a taxa de transferência usando o NGINX Open Source ou o NGINX Plus como gateway de API.
Decidimos analisar mais a fundo o ecossistema de APIs e tentar entender o que torna uma API “em tempo real”. Com base em diversos fatores, determinamos que uma API em tempo real deve processar chamadas de API de ponta a ponta em menos de 30 ms em todos os percentis até o 99º (o que significa que, em média, apenas 1 chamada em cada 100 leva mais de 30 ms).
Comparação de soluções de gerenciamento de APIs
Nossos próprios testes mostram consistentemente que é fácil obter desempenho de API em tempo real com nossa solução de gerenciamento de APIs, que combina o NGINX Plus como gateway de API para processar chamadas de API e o Módulo de Gerenciamento de APIs do NGINX Controller para gerenciar tanto as instâncias do NGINX Plus quanto suas APIs à medida que você as define, publica, gerencia e monitora durante todo o ciclo de vida.
Mas entendemos que talvez você não queira simplesmente acreditar no que dizemos. Por isso, contratamos a GigaOm, uma empresa independente de pesquisa e análise técnica, para realizar uma avaliação comparativa objetiva e transparente da nossa solução de gerenciamento de APIs e de outras soluções populares no mercado: duas soluções que, assim como o NGINX, podem ser implantadas localmente ou na nuvem, Apigee e Kong Enterprise, além de duas ofertas de nuvem totalmente gerenciadas, Amazon API Gateway e Kong Cloud.
Neste blog, resumimos os resultados dos testes da GigaOm (spoiler: o NGINX Plus forneceu APIs em tempo real em todas as condições testadas, enquanto as outras soluções não). Para saber todos os detalhes sobre as soluções, a metodologia de teste e os resultados, entre em contato com um membro da nossa equipe.
Observação: O contrato de licença de usuário final (EULA) do Apigee proíbe a publicação de resultados de testes sem a autorização expressa do Google. Portanto, infelizmente, nem o relatório nem este blog incluem informações sobre o Apigee.
Visão geral do benchmark
A GigaOm usou a ferramenta de teste de carga HTTP Vegeta para gerar solicitações (chamadas de API) e mediu a latência adicional — o tempo necessário para retornar a resposta a uma chamada de API — introduzida pelo gateway de API em diferentes números de solicitações por segundo (RPS), que a GigaOm chama de “taxas de ataque”. A GigaOm executou testes com taxas de ataque começando em 1.000 RPS e aumentando para 5.000, 10.000, 20.000 e assim por diante, até que o Vegeta retornasse códigos de status de erro. Cada teste durou 60 segundos e foi repetido 3 vezes. Como mostram os gráficos abaixo, a GigaOm registrou as latências nos percentis 50, 90, 95, 99, 99,9 e 99,99, além da maior latência observada durante o teste (Máx. nos gráficos).
Resultados: NGINX vs. Kong Enterprise
A GigaOm realizou dois benchmarks comparando o NGINX Plus (implantado usando o NGINX Controller) e o Kong Node (implantado usando o Kong Enterprise). No primeiro benchmark, havia um único nó de trabalho (uma instância do NGINX Plus ou do Kong Node). No segundo, havia três nós de trabalho com balanceamento de carga feito pelo NGINX Open Source no modo Round‑Robin. (A GigaOm ressalta que o uso do NGINX Open Source como balanceador de carga não criou uma vantagem para o NGINX Plus e que até mesmo a Kong o recomenda como balanceador de carga para instâncias do Kong Node em cluster.)
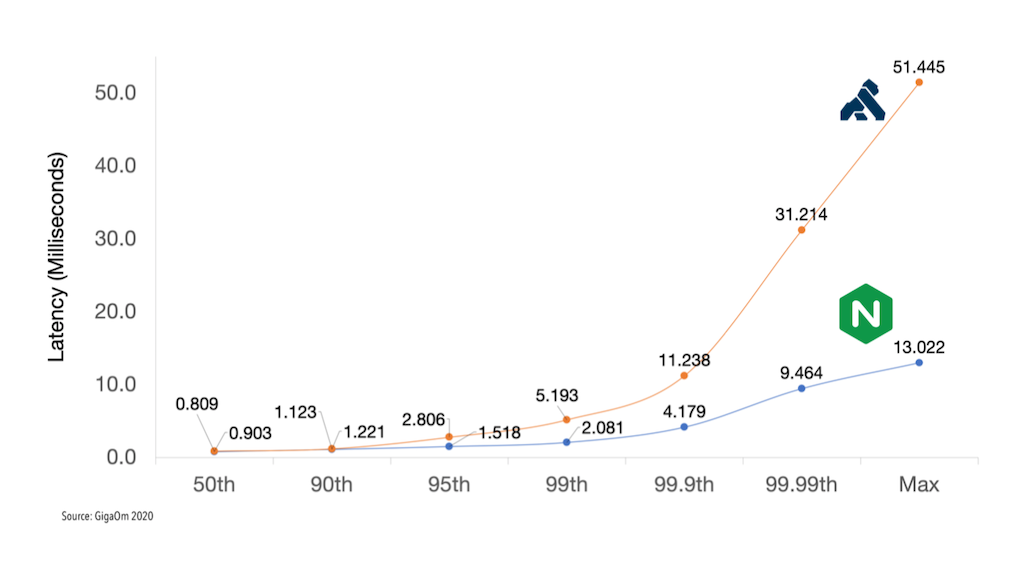
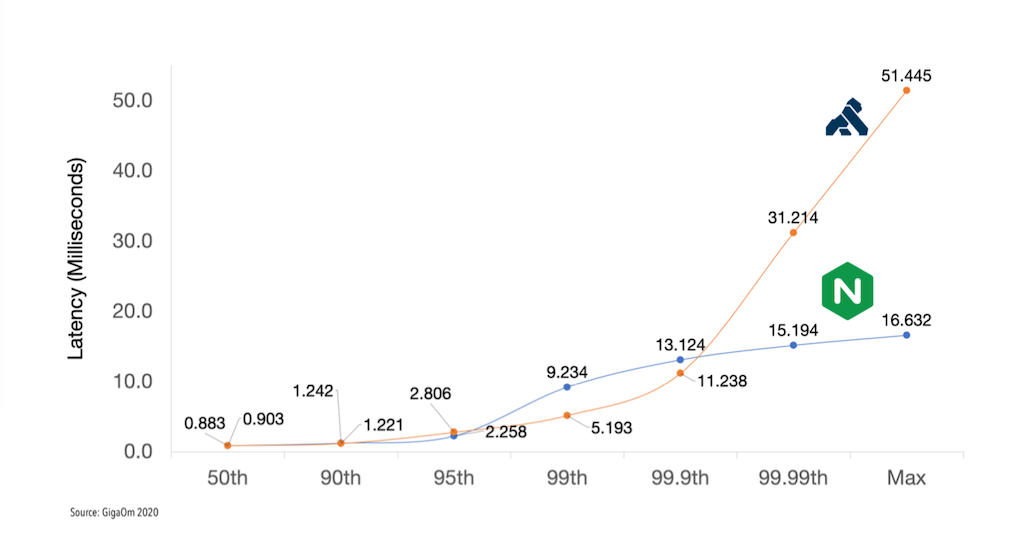
Como mostram os gráficos a seguir, a diferença de latência entre o NGINX e o Kong é insignificante até o 99º percentil, ponto a partir do qual a latência do Kong começa a crescer exponencialmente. No 99,99º percentil, a latência do Kong é, respectivamente, três e duas vezes maior que a do NGINX nos dois benchmarks.
O 99º percentil é um valor mínimo razoável para definir uma API como sendo em tempo real, mas a GigaOm observa que, em implantações no mundo real, é “extremamente importante” manter uma baixa latência em percentis mais altos, como o 99,9º e o 99,99º. O relatório explica:
Os resultados de latência tendem a apresentar uma distribuição multimodal ao longo do tempo, com os picos mais altos representando “engasgos” nos tempos de resposta.
Esses engasgos são importantes. Se o tempo de resposta mediano ou a latência for inferior a 30 ms, mas houver engasgos de 1 segundo ou latências maiores, haverá, na verdade, um efeito cumulativo na experiência dos usuários subsequentes. Por exemplo, se você for ao drive-thru de uma lanchonete onde o tempo mediano de espera pela comida é de 1 minuto, provavelmente considerará essa uma boa experiência. No entanto, e se o cliente à sua frente tiver um problema com o pedido e levar 10 minutos para resolvê-lo? Seu tempo de espera será, na verdade, de 11 minutos. Como sua solicitação entrou na fila depois do engasgo, o atraso do percentil 99,99 também pode se tornar o seu atraso.
O efeito negativo de latências excepcionalmente altas nos percentis superiores torna-se ainda mais significativo em aplicações distribuídas, nas quais uma única solicitação de cliente pode, na verdade, gerar várias chamadas de API subsequentes. Por exemplo, suponha que uma solicitação de cliente crie 10 chamadas de API para um subsistema com 1% de probabilidade de responder lentamente. É possível demonstrar matematicamente que, como resultado, há quase 10% de probabilidade de essa solicitação de cliente ser afetada por uma resposta lenta. Para obter detalhes sobre os cálculos, consulte Quem alterou a latência do meu 99º percentil?
A Figura 1 mostra os resultados para a taxa de ataque de 30.000 RPS com um único nó de trabalho. No percentil 99,99, a latência do Kong é mais de 3 vezes maior que a do NGINX e ultrapassa o limite de 30 ms para APIs em tempo real. Em contrapartida, o NGINX Plus alcança latência em tempo real em todos os percentis – até mesmo sua maior latência registrada (Máx.), de 13 ms, é inferior à metade do limite para tempo real.
A Figura 2 mostra resultados muito semelhantes para o benchmark com três nós de trabalho, também com uma taxa de ataque de 30.000 RPS. Curiosamente, o Kong supera o NGINX nos percentis 99 e 99,9, mas novamente apresenta um enorme pico de latência no percentil 99,99, desta vez atingindo uma latência cerca de duas vezes maior que a do NGINX. Assim como no primeiro benchmark, o NGINX permanece abaixo do limite de tempo real de 30 ms em todos os percentis.
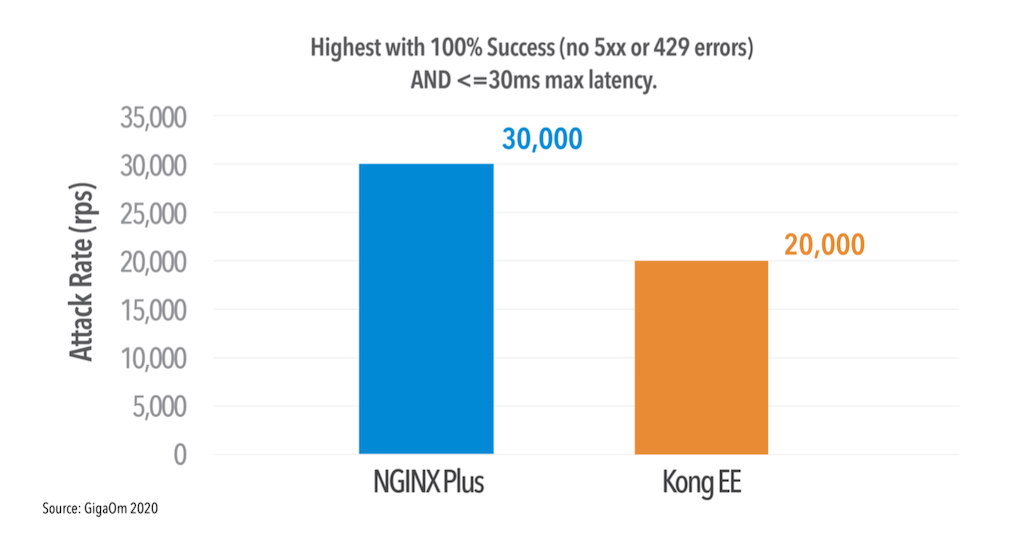
Outra forma de avaliar o desempenho de um gateway de API é determinar o máximo de RPS que ele consegue processar com 100% de sucesso (sem erros 5xx ou 429 [Too Many Requests]) e com latência abaixo de 30 ms em todos os percentis, tanto nas configurações de nó único quanto nas de três nós. A Figura 3 mostra que, segundo esse critério, o NGINX mantém um RPS 50% maior que o Kong: 30.000 contra 20.000.
Resultados: NGINX vs. Kong Cloud e Amazon API Gateway
No terceiro conjunto de benchmarks, a GigaOm comparou o NGINX Plus ao Kong Cloud e ao Amazon API Gateway. A GigaOm ressalta que uma comparação direta é bastante problemática, pois o Kong Cloud e o Amazon API Gateway são ofertas de SaaS totalmente gerenciadas, enquanto o NGINX Controller é uma oferta de PaaS e, atualmente, não está disponível como SaaS. Em particular, nenhuma das ofertas de SaaS revela o tipo de instância, a capacidade de processamento, a memória ou os recursos de rede utilizados. Portanto, a GigaOm teve que fazer a melhor estimativa possível das configurações equivalentes a serem usadas no NGINX Plus.
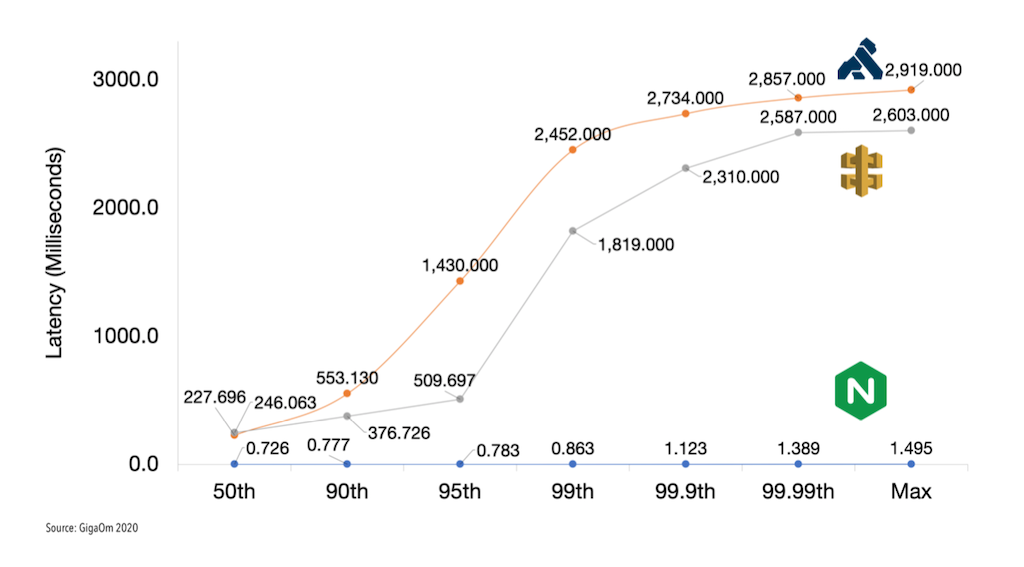
Mesmo deixando de lado a comparação com o NGINX Plus, fica imediatamente claro que as ofertas de SaaS não conseguem fornecer APIs em tempo real em nenhum dos percentis testados, nem mesmo na segunda menor taxa de ataque (5.000 RPS) mostrada na Figura 4. No 50º percentil, a latência das ofertas de SaaS já é mais de 7 vezes superior ao limite de 30 ms; no 99,99º percentil, ela ultrapassa esse limite em mais de 8.000%. A conclusão óbvia é que não há condições em que o Kong Cloud ou o Amazon API Gateway alcance 100% de sucesso com latência inferior a 30 ms.
Validando o NGINX como a única solução de API em tempo real
Em resumo, o NGINX é a única solução testada pela GigaOm que atendeu aos padrões de processamento de APIs em tempo real, alcançando latência inferior a 30 ms em todos os percentis. O Kong Enterprise apresenta desempenho em tempo real no 99º percentil, mas sua latência aumenta significativamente nos percentis mais altos, tornando-o inadequado para ambientes de produção que exigem até mesmo um volume moderado de processamento de APIs em tempo real. Nenhuma das soluções SaaS testadas pode ser classificada como de tempo real.
O relatório da GigaOm confirma tanto nossos benchmarks anteriores quanto o que ouvimos de nossos clientes. O NGINX Plus é o gateway de API mais rápido do mercado e a única solução de API capaz de manter uma latência inferior a 30 ms em todos os percentis. E, ao combiná-lo com o NGINX Controller, você obtém acesso a uma solução de gerenciamento de APIs com uma arquitetura única, na qual, graças à cuidadosa separação dos componentes, o plano de controle de gerenciamento de APIs (NGINX Controller) não causa nenhum impacto no desempenho do plano de dados do gateway de API (NGINX Plus).
Você pode testar o desempenho das suas próprias APIs com nossa ferramenta de medição de latência rtapi. Confira e entre em contato conosco para conversarmos sobre como podemos ajudar você a tornar suas APIs em tempo real.
Sobre o autor
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.