As diretrizes conhecidas como aplicativo de doze fatores foram publicadas pela primeira vez há mais de dez anos. Desde então, quase todas as práticas que elas prescrevem se tornaram o padrão de fato para desenvolver e implantar aplicações web. Embora continuem válidas diante das mudanças na forma como as aplicações são organizadas e implantadas, em alguns casos é necessário considerar nuances adicionais para entender como essas práticas se aplicam aos padrões de microsserviços usados no desenvolvimento e na implantação de aplicações.
Este blog se concentra no Fator 3, Armazene as configurações no ambiente, que afirma:
- Configuração é tudo aquilo que varia entre ambientes de implantação (que a metodologia de aplicativos de doze fatores chama de implantações).
- A configuração deve ser rigorosamente separada do código da aplicação — caso contrário, como ela poderia variar entre as implantações?
- Os dados de configuração são armazenados em variáveis de ambiente.
Ao migrar para microsserviços, você ainda pode seguir essas diretrizes, embora nem sempre de uma forma que corresponda exatamente a uma interpretação literal do aplicativo de doze fatores. Algumas diretrizes, como disponibilizar dados de configuração por meio de variáveis de ambiente, se aplicam muito bem. Outras práticas comuns de microsserviços, embora respeitem os princípios fundamentais do aplicativo de doze fatores, funcionam mais como extensões dele. Neste post, analisaremos três conceitos fundamentais do gerenciamento de configurações para microsserviços sob a perspectiva do Fator 3:
- Defina claramente a configuração do seu serviço
- Como a configuração é fornecida a um serviço
- Disponibilizando um serviço como configuração
Principais termos e conceitos de microsserviços
Antes de entrar na discussão sobre a adaptação do Fator 3 para microsserviços, é útil entender alguns termos e conceitos importantes.
- Arquitetura de aplicativo monolítico – Um modelo arquitetural tradicional que separa as funções do aplicativo em módulos de componentes, mas inclui todos os módulos em uma única base de código.
- Arquitetura de aplicativos de microsserviços – Um modelo arquitetural que cria um aplicativo grande e complexo a partir de vários componentes pequenos, cada um responsável por um conjunto bem definido de operações (como autenticação, notificações ou processamento de pagamentos). “Microsserviço” também é o nome dado a esses pequenos componentes. Na prática, alguns “microsserviços” podem ser bastante grandes.
- Serviço – Termo genérico para um único aplicativo ou microsserviço em um sistema.
- Sistema – No contexto deste blog, o conjunto completo de microsserviços e da infraestrutura de suporte que, juntos, compõem todas as funcionalidades oferecidas pela organização.
- Artefato – Um objeto criado por um pipeline de testes e build. Ele pode assumir várias formas, como uma imagem do Docker contendo o código de um aplicativo.
- Implantação – Uma “instância” em execução de um artefato, que roda em um ambiente como homologação, integração ou produção.
Microsserviços versus monólitos
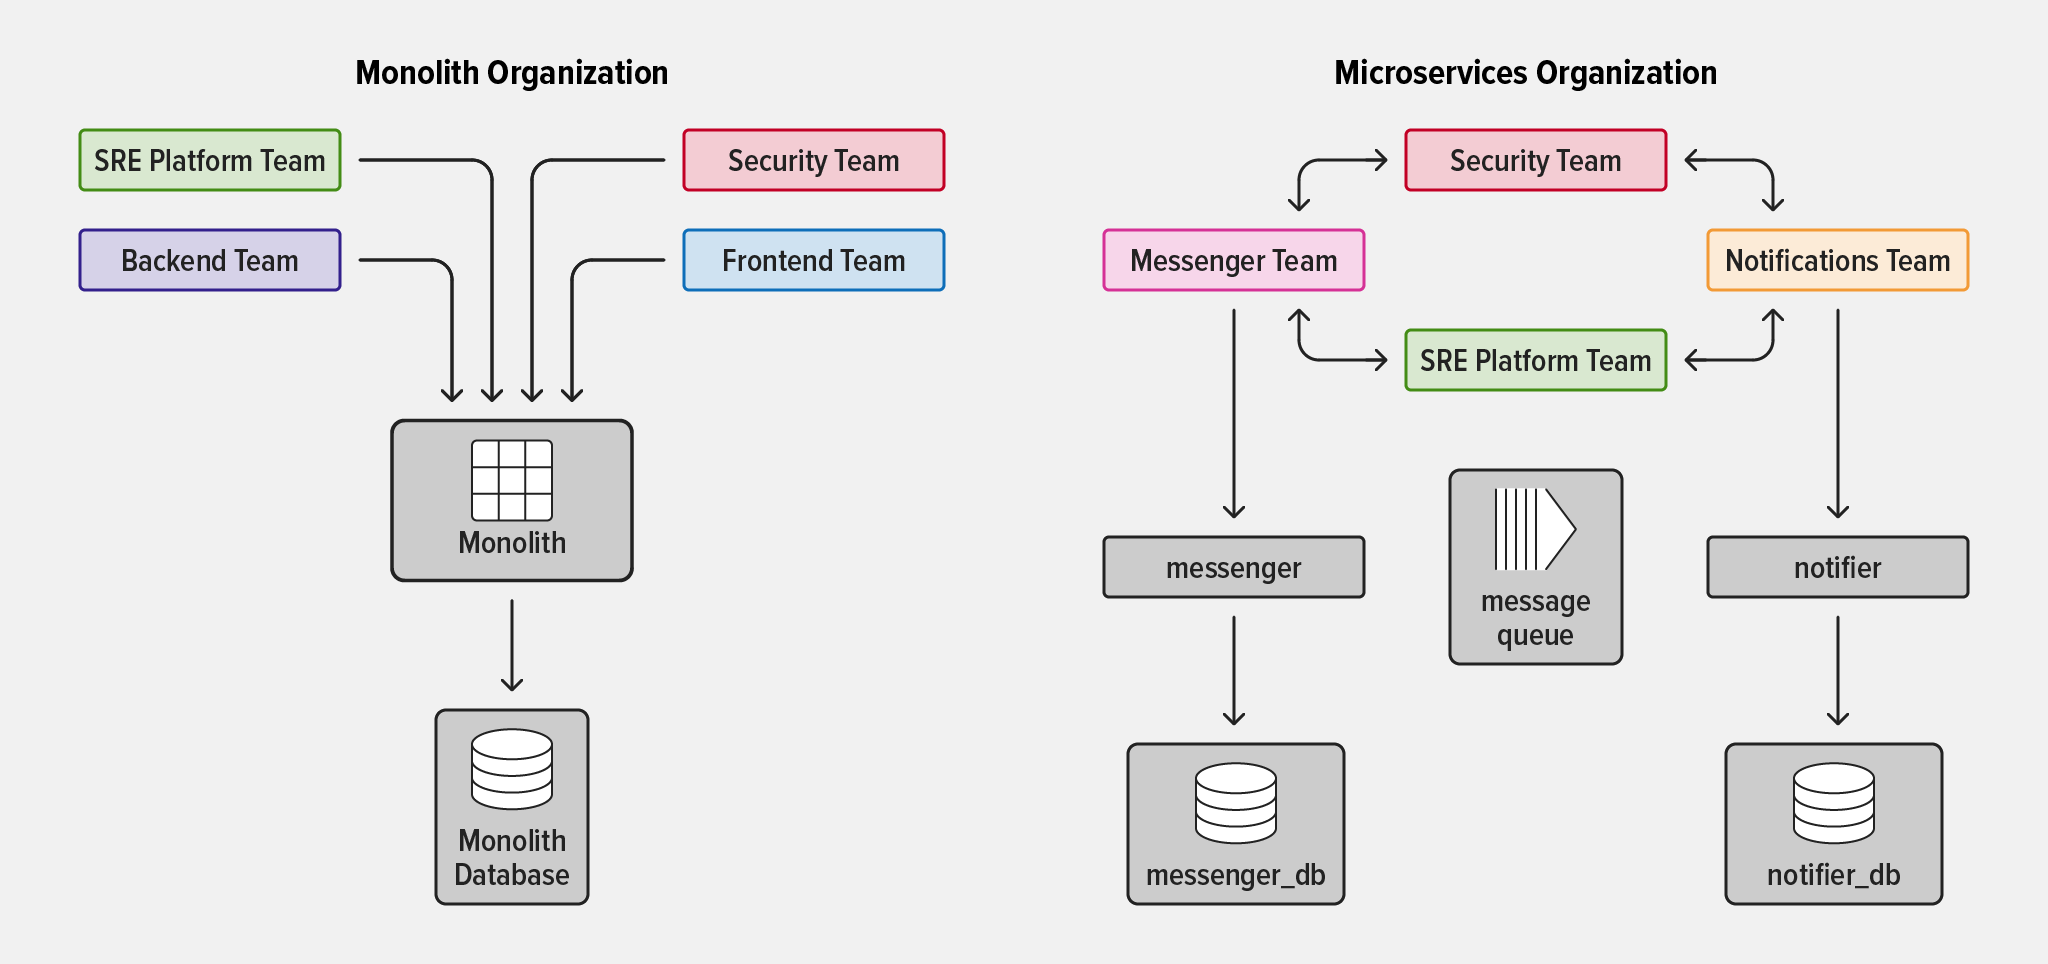
Com uma aplicação monolítica, todas as equipes da organização trabalham na mesma aplicação e na infraestrutura que a sustenta. Embora, em teoria, as aplicações monolíticas geralmente pareçam mais simples do que os microsserviços, há vários motivos comuns pelos quais as organizações decidem migrar para microsserviços:
- Autonomia das equipes – Pode ser difícil definir a responsabilidade por funcionalidades e subsistemas em um monólito. À medida que as organizações crescem e amadurecem, a responsabilidade pelas funcionalidades do aplicativo costuma ser distribuída entre um número cada vez maior de equipes. Isso cria dependências entre as equipes, pois a equipe responsável por uma funcionalidade não controla todos os subsistemas relacionados no monólito.
- Redução do “raio de impacto” – Quando um aplicativo de grande porte é desenvolvido e implantado como uma única unidade, um erro em um subsistema pode comprometer a funcionalidade de todo o aplicativo.
- Escalabilidade independente das funcionalidades – Mesmo que apenas um módulo de um aplicativo monolítico esteja sob alta carga, a organização precisa implantar várias instâncias do aplicativo inteiro para evitar falhas ou degradação do sistema.
É claro que os microsserviços trazem seus próprios desafios — incluindo maior complexidade, menor observabilidade e a necessidade de novos modelos de segurança —, mas muitas organizações, especialmente as de grande porte ou em rápido crescimento, consideram que vale a pena enfrentá-los para dar às suas equipes mais autonomia e flexibilidade na criação de bases confiáveis e estáveis para as experiências que oferecem aos clientes.
Mudanças necessárias para arquiteturas de microsserviços
Ao refatorar uma aplicação monolítica em microsserviços, seus serviços devem:
- Aceitar alterações de configuração de forma previsível
- Tornar-se conhecido pelo sistema mais amplo de maneira previsível
- Ser bem documentado
Para uma aplicação monolítica, pequenas inconsistências nos processos e a dependência de premissas compartilhadas não são críticas. No entanto, com muitos microsserviços separados, essas inconsistências e premissas podem gerar muitos problemas e caos. Muitas das mudanças necessárias ao trabalhar com microsserviços são exigências técnicas, mas um número surpreendente delas diz respeito à forma como as equipes trabalham internamente e interagem com outras equipes.
Entre as principais mudanças organizacionais decorrentes de uma arquitetura de microsserviços estão:
- Em vez de trabalharem juntas na mesma base de código, as equipes tornam-se totalmente independentes, e cada uma assume a responsabilidade integral por um ou mais serviços. Na implementação mais comum de microsserviços, as equipes também são reorganizadas para serem “multifuncionais”, ou seja, passam a contar com integrantes que reúnem todas as competências necessárias para atingir os objetivos da equipe com o mínimo de dependência de outras equipes.
- As equipes de plataforma (responsáveis pela integridade geral do sistema) agora precisam coordenar vários serviços pertencentes a diferentes equipes, em vez de lidar com uma única aplicação.
- As equipes de ferramentas devem continuar sendo capazes de fornecer ferramentas e orientações às diversas equipes responsáveis pelos serviços, ajudando-as a alcançar seus objetivos rapidamente e, ao mesmo tempo, mantendo a estabilidade do sistema.
Definindo claramente a configuração do seu serviço
Uma área da arquitetura de microsserviços em que precisamos ampliar o Fator 3 diz respeito à necessidade de definir claramente determinadas informações essenciais sobre um serviço, incluindo sua configuração, e de pressupor um mínimo de contexto compartilhado com outros serviços. O Fator 3 não aborda isso diretamente, mas essa questão é especialmente importante quando há um grande número de microsserviços distintos contribuindo para as funcionalidades da aplicação.
Como responsável por um serviço em uma arquitetura de microsserviços, sua equipe é proprietária de serviços que desempenham funções específicas no sistema como um todo. Outras equipes cujos serviços interagem com os seus precisam acessar o repositório do seu serviço para consultar o código e a documentação, além de fazer contribuições.
Além disso, é uma realidade lamentável na área de desenvolvimento de software que a composição das equipes mude com frequência, não apenas porque desenvolvedores entram e saem da empresa, mas também devido a reorganizações internas. A responsabilidade por um determinado serviço também costuma ser transferida entre equipes.
Diante dessas realidades, sua base de código e sua documentação precisam ser extremamente claras e consistentes, o que se consegue por meio de:
- Definir claramente a finalidade de cada opção de configuração
- Definir claramente o formato esperado do valor de configuração
- Definir claramente como o aplicativo espera que os valores de configuração sejam fornecidos
- Registrar essas informações em um número limitado de arquivos
Muitos frameworks de aplicações oferecem uma maneira de definir a configuração necessária. Por exemplo, o pacote NPM convict para aplicações Node.js usa um “esquema” de configuração completo armazenado em um único arquivo. Ele funciona como a fonte oficial de toda a configuração necessária para executar uma aplicação Node.js.
Um esquema robusto e fácil de encontrar permite que tanto os membros da sua equipe quanto outras pessoas interajam com confiança com o seu serviço.
Como a configuração é fornecida a um serviço
Depois de definir claramente quais valores de configuração sua aplicação precisa, você também deve respeitar a importante distinção entre as duas principais fontes das quais uma aplicação de microsserviços implantada obtém sua configuração:
- Scripts de implantação que definem explicitamente as configurações e acompanham o código-fonte da aplicação
- Fontes externas consultadas no momento da implantação
Scripts de implantação são um padrão comum de organização de código em arquiteturas de microsserviços. Como surgiram após a publicação original do aplicativo de doze fatores, eles necessariamente representam uma extensão desse modelo.
Padrão: configuração de implantação e infraestrutura junto à aplicação
Nos últimos anos, tornou-se comum ter uma pasta chamada infrastructure (ou alguma variação desse nome) no mesmo repositório que o código da sua aplicação. Ela geralmente contém:
- Infraestrutura como código (Terraform é um exemplo comum) que descreve a infraestrutura da qual o serviço depende, como um banco de dados
- Configuração do seu sistema de orquestração de contêineres, como charts do Helm e manifestos do Kubernetes
- Quaisquer outros arquivos relacionados à implantação da aplicação
À primeira vista, isso pode parecer uma violação da recomendação do Fator 3 de que a configuração deve ser estritamente separada do código.
Na verdade, o fato de ela estar localizada ao lado da sua aplicação significa que uma pasta de infraestrutura respeita a regra e, ao mesmo tempo, possibilita melhorias valiosas nos processos, essenciais para equipes que trabalham em ambientes de microsserviços.
Os benefícios desse padrão incluem:
- A equipe responsável pelo serviço também é responsável pela implantação do serviço e da infraestrutura específica dele (como bancos de dados).
- A equipe responsável pode garantir que as alterações em qualquer um desses elementos passem pelo seu processo de desenvolvimento (revisão de código, CI).
- A equipe pode alterar facilmente a forma como seu serviço e a infraestrutura de suporte são implantados, sem depender de equipes externas para realizar o trabalho.
Observe que os benefícios proporcionados por esse padrão reforçam a autonomia de cada equipe e, ao mesmo tempo, garantem maior rigor no processo de implantação e configuração.
Que tipo de configuração vai em cada lugar?
Na prática, você usa os scripts de implantação armazenados na pasta de infraestrutura para gerenciar tanto as configurações definidas explicitamente nos próprios scripts quanto a obtenção de configurações de fontes externas no momento da implantação, fazendo com que o script de implantação de um serviço:
- Definir determinados valores de configuração diretamente
- Defina onde o processo que executa o script de implantação pode procurar os valores de configuração desejados em fontes externas
Os valores de configuração específicos de uma determinada implantação do seu serviço e que estão totalmente sob o controle da sua equipe podem ser definidos diretamente nos arquivos da pasta de infraestrutura. Um exemplo seria um limite para o tempo de execução permitido de uma consulta ao banco de dados iniciada pelo aplicativo. Esse valor pode ser alterado modificando o arquivo de implantação e reimplantando o aplicativo.
Um dos benefícios desse esquema é que as alterações nesse tipo de configuração necessariamente passam por revisão de código e testes automatizados, reduzindo a probabilidade de que um valor configurado incorretamente cause uma indisponibilidade. As alterações nos valores que passam por revisão de código e os valores das chaves de configuração em qualquer momento podem ser consultados no histórico da sua ferramenta de controle de versão.
Os valores necessários para a execução da aplicação, mas que não estão sob o controle da sua equipe, devem ser fornecidos pelo ambiente em que a aplicação é implantada. Um exemplo é o nome do host e a porta usados pelo serviço para se conectar a outro microsserviço do qual ele depende.
Como esse serviço não pertence à sua equipe, não é possível fazer suposições sobre valores como o número da porta. Esses valores podem mudar a qualquer momento e precisam ser registrados em algum repositório central de configurações quando forem alterados, seja manualmente ou por algum processo automático. Assim, eles podem ser consultados pelos aplicativos que dependem deles.
Podemos resumir essas diretrizes em duas práticas recomendadas para a configuração de microsserviços.
Uma prática a evitar na configuração de microsserviços: depender de valores fixos no código ou acordados entre as partes
Pode parecer mais simples codificar diretamente determinados valores nos seus scripts de implantação, como a localização de um serviço com o qual o seu serviço interage. Na prática, codificar diretamente esse tipo de configuração é perigoso, especialmente em ambientes modernos, nos quais a localização dos serviços costuma mudar com frequência. E isso é particularmente perigoso se o segundo serviço não estiver sob sua responsabilidade.
Você pode achar que basta confiar na sua própria diligência para manter a localização de um serviço atualizada nos seus scripts ou, pior ainda, que pode contar com a equipe responsável para avisar quando ela mudar. Em momentos de estresse, é comum que essa diligência falhe, e depender do rigor humano expõe seu sistema ao risco de parar de funcionar sem aviso prévio.
Uma boa prática de configuração de microsserviços: faça o serviço perguntar “Onde está meu banco de dados?”
Independentemente de as informações de localização estarem codificadas diretamente ou não, sua aplicação não deve depender de uma infraestrutura crítica estar em um local específico. Em vez disso, um serviço recém-implantado precisa fazer perguntas a uma fonte comum dentro do sistema, como “onde está meu banco de dados?”, e receber uma resposta precisa sobre a localização atual desse recurso externo. Fazer com que cada serviço se registre no sistema durante a implantação simplifica muito as coisas.
Disponibilizando um serviço como configuração
Assim como o sistema precisa responder às perguntas “onde está meu banco de dados?” e “onde está o ‘serviço X’ do qual dependo?”, um serviço deve ser disponibilizado no sistema de modo que outros serviços possam encontrá-lo e se comunicar com ele facilmente, sem precisar saber como ele foi implantado.
Uma prática fundamental de configuração em arquiteturas de microsserviços é a descoberta de serviços: o registro de informações sobre novos serviços e a atualização dinâmica dessas informações à medida que são acessadas por outros serviços. Depois de explicar por que a descoberta de serviços é necessária para os microsserviços, vamos explorar um exemplo de como implementá-la com o NGINX Open Source e o Consul.
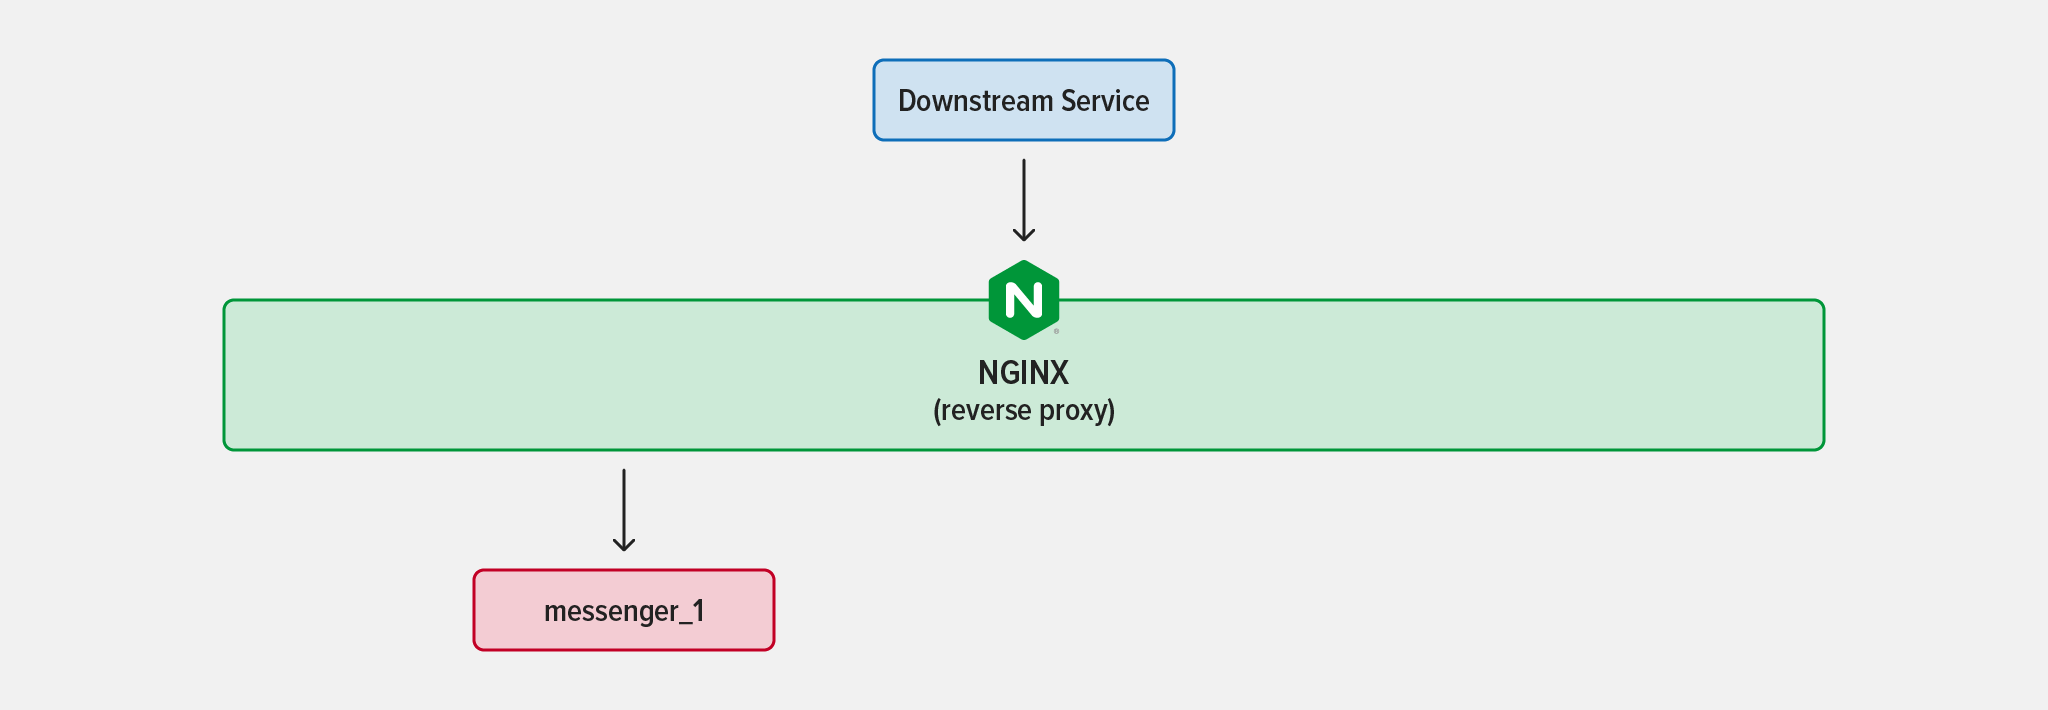
É uma prática comum manter várias instâncias (implantações) de um serviço em execução simultaneamente. Isso permite não apenas processar tráfego adicional, mas também atualizar um serviço sem tempo de inatividade por meio do lançamento de uma nova implantação. Atuando como proxy reverso e balanceador de carga, ferramentas como o NGINX processam o tráfego de entrada e o encaminham para a instância mais adequada. Esse é um bom padrão, pois os serviços que dependem do seu serviço enviam solicitações apenas ao NGINX e não precisam saber nada sobre suas implantações.
Por exemplo, digamos que você tenha uma única instância de um serviço chamado messenger em execução por trás do NGINX, que atua como proxy reverso.
Agora, e se o seu aplicativo se tornar popular? Isso é considerado uma boa notícia, mas então você percebe que, devido ao aumento do tráfego, a instância do messenger está consumindo muita CPU e demorando mais para processar as solicitações, enquanto o banco de dados parece estar funcionando perfeitamente. Isso indica que talvez seja possível resolver o problema implantando outra instância do serviço messenger.
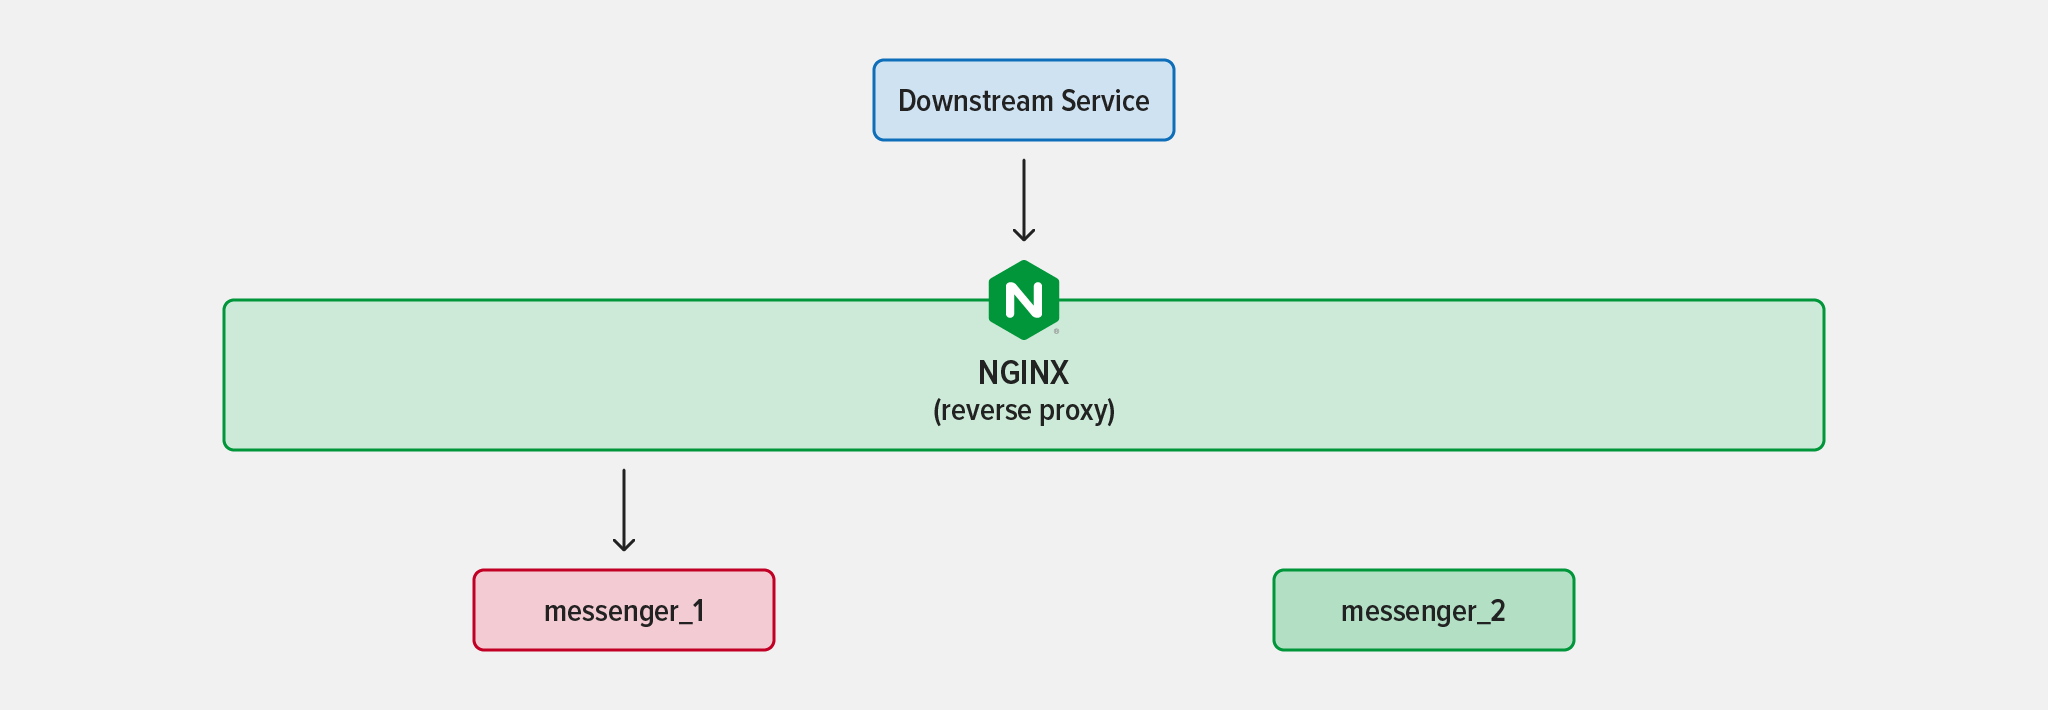
Quando você implanta a segunda instância do serviço messenger, como o NGINX sabe que ela está ativa e começa a direcionar tráfego para ela? Adicionar manualmente novas instâncias à configuração do NGINX é uma opção, mas isso rapidamente se torna inviável à medida que mais serviços aumentam e reduzem sua escala.
Uma solução comum é monitorar os serviços de um sistema usando um registro de serviços de alta disponibilidade, como o Consul. As novas instâncias de serviço se registram no Consul à medida que são implantadas. O Consul monitora o status das instâncias realizando verificações de integridade periódicas. Quando uma instância não passa nessas verificações, ela é removida da lista de serviços disponíveis.
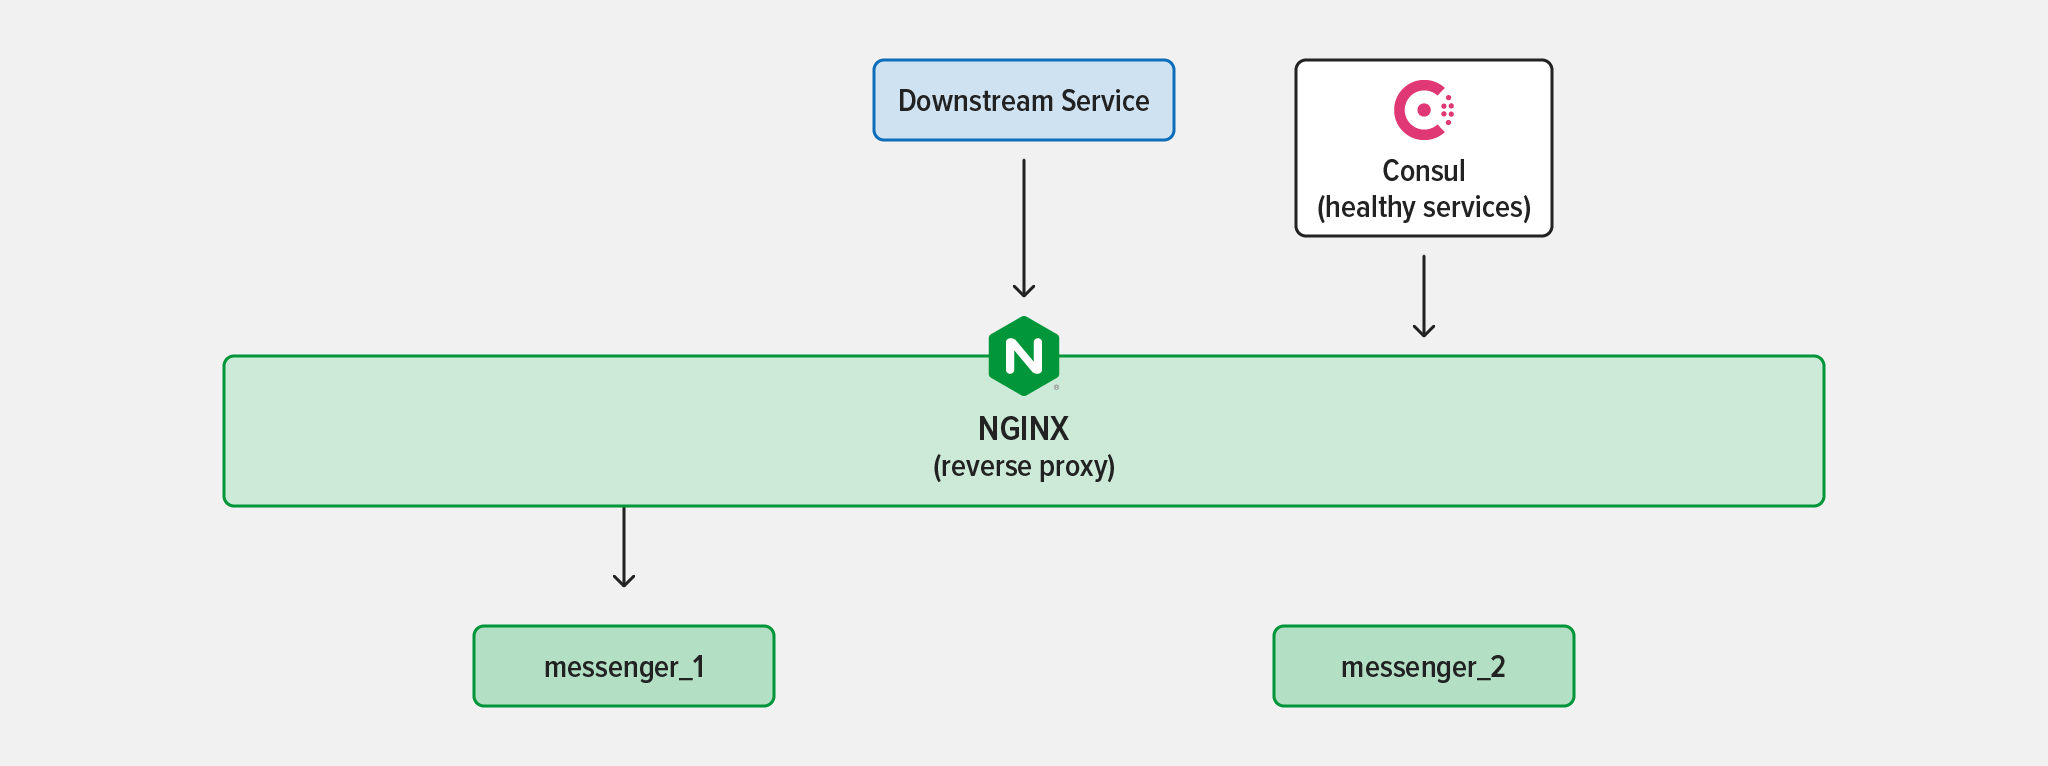
O NGINX pode consultar um registro como o Consul usando diversos métodos e ajustar seu roteamento de acordo. Lembre-se de que, ao atuar como proxy reverso ou balanceador de carga, o NGINX encaminha o tráfego para servidores “upstream”. Considere esta configuração simples:
# Define an upstream group called "messenger_service"
upstream messenger_service {
    server 172.18.0.7:4000;
    server 172.18.0.8:4000;
}

server {
    listen 80;

    location /api {
        # Proxy HTTP traffic with paths starting with '/api' to the
        # 'upstream' block above. The default load-balancing algorithm,
        # Round-Robin, alternates requests between the two servers
        # in the block.
        proxy_pass http://messenger_service;
        proxy_set_header X-Forwarded-For $remote_addr;
    }
}
Por padrão, o NGINX precisa saber o endereço IP e a porta exatos de cada instância do messenger para encaminhar o tráfego até ela. Nesse caso, é a porta 4000 tanto em 172.18.0.7 quanto em 172.18.0.8.
É aí que entram o Consul e o Consul template. O Consul template é executado no mesmo contêiner que o NGINX e se comunica com o cliente Consul, que mantém o registro de serviços.
Quando as informações do registro são alteradas, o Consul template gera uma nova versão do arquivo de configuração do NGINX com os endereços IP e as portas corretos, grava-a no diretório de configuração do NGINX e instrui o NGINX a recarregar sua configuração. Não há indisponibilidade quando o NGINX recarrega sua configuração, e a nova instância começa a receber tráfego assim que o recarregamento é concluído.
Com um proxy reverso como o NGINX nesse tipo de situação, há um único ponto de contato a ser registrado no sistema como o local de acesso para outros serviços. Sua equipe tem a flexibilidade de gerenciar instâncias individuais do serviço sem precisar se preocupar com a possibilidade de outros serviços perderem o acesso ao serviço como um todo.
Coloque a mão na massa com o NGINX e a Marcha dos Microsserviços
É fato que os microsserviços aumentam a complexidade, tanto em termos técnicos para seus serviços quanto em termos organizacionais para o relacionamento com outras equipes. Para aproveitar os benefícios de uma arquitetura de microsserviços, é importante reavaliar de forma crítica as práticas desenvolvidas para monólitos, a fim de garantir que elas continuem oferecendo os mesmos benefícios quando aplicadas a um ambiente muito diferente. Neste blog, exploramos como o Fator 3 do aplicativo de doze fatores continua agregando valor no contexto de microsserviços, mas pode se beneficiar de pequenos ajustes na forma como é aplicado na prática.
Para saber mais sobre como aplicar a metodologia de aplicativos de doze fatores a arquiteturas de microsserviços, confira a Unidade 1 do Microservices March 2023 (em breve no blog). Inscreva-se gratuitamente para ter acesso a um webinar sobre esse tema e a um laboratório prático.

Sobre o autor
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.