Editor – Este post faz parte de uma série de 10 partes:
- Reduza a complexidade com Kubernetes pronto para produção
- Como aumentar a resiliência no Kubernetes com o gerenciamento avançado de tráfego
- Como melhorar a visibilidade no Kubernetes (este artigo)
- Seis maneiras de proteger o Kubernetes usando ferramentas de gerenciamento de tráfego
- Guia para escolher um controlador de Ingress, Parte 1: identifique seus requisitos
- Guia para escolher um controlador de Ingress, Parte 2: riscos e preparação para o futuro
- Um guia para escolher um controlador de Ingress, parte 3: código aberto vs. padrão vs. comercial
- Guia para escolher um controlador de Ingress, Parte 4: opções de controladores de Ingress da NGINX
- Como escolher uma malha de serviços
- Teste de desempenho de controladores de Ingress NGINX em um ambiente de nuvem Kubernetes dinâmico
Você também pode baixar gratuitamente a coleção completa de artigos como um eBook – Levando o Kubernetes do teste à produção.
A adoção de microsserviços acelera as experiências digitais, mas as arquiteturas de microsserviços também podem torná-las mais frágeis. Enquanto seus desenvolvedores trabalham rapidamente para lançar novos aplicativos, sua arquitetura pode aumentar o risco de interrupções, vulnerabilidades de segurança e perda de tempo com soluções de problemas ineficientes ou com a correção de problemas que poderiam ter sido evitados. Neste segundo artigo da nossa série sobre Kubernetes pronto para produção, analisamos como os componentes que proporcionam visibilidade do tráfego podem reduzir a complexidade e melhorar a segurança em seus ambientes de microsserviços.
Obtenha visibilidade para alcançar insights
Primeiro, vamos analisar algumas definições:
- Visibilidade – O estado de poder ver ou ser visto
- Insight – Uma compreensão profunda de uma pessoa ou coisa
Em uma pesquisa de 2020 da StackRox, 75% dos usuários do Kubernetes identificaram a visibilidade como um recurso “indispensável”. Concordamos que a visibilidade é fundamental no Kubernetes, pois pode ser especialmente difícil saber o que está implantado. Ainda assim, 95% dos participantes da pesquisa State of Application Strategy (SOAS) de 2021 da F5 relataram que, embora tenham uma grande quantidade de dados, faltam a eles os insights sobre desempenho, segurança e disponibilidade das aplicações de que precisam para proteger e aprimorar sua infraestrutura e seus negócios. Então, por que os insights são importantes e como obtê-los?
Com insights, você pode:
- Reforce a segurança e a conformidade detectando vulnerabilidades e possíveis vetores de ataque
- Reduza interrupções e períodos de inatividade identificando problemas antes que seus clientes os percebam
- Aumente a eficiência da solução de problemas identificando a causa raiz dos problemas do aplicativo
- Confirme se o tráfego está sendo direcionado apenas para onde você deseja
- Saiba exatamente o que está sendo executado em seus ambientes Kubernetes e se está configurado e protegido corretamente
- Determine se você está usando a quantidade adequada de recursos com base no histórico de latência e desempenho
- Preveja as necessidades sazonais com base nos padrões de tráfego anteriores
- Meça o desempenho em termos de tempo de resposta para monitorá-lo em relação aos acordos de nível de serviço (SLAs) e atuar como um sistema de alerta antecipado antes que os problemas afetem a experiência do usuário
Para obter insights, você precisa de dois tipos de dados de visibilidade: em tempo real e históricos. Os dados em tempo real permitem diagnosticar a origem de um problema que está ocorrendo neste exato momento, enquanto os dados históricos fornecem uma perspectiva sobre o que é “normal” e o que é um valor atípico. Combinados, esses dois tipos de fontes de visibilidade podem fornecer insights cruciais sobre o desempenho de aplicativos e do Kubernetes.
Assim como ocorre com outros investimentos em tecnologia, você também precisa de uma estratégia para aproveitar os benefícios. O relatório SOAS também indica que as pessoas não conseguem obter insights valiosos devido a fatores organizacionais relacionados à contratação e ao desenvolvimento de funcionários, à estratégia e aos processos, bem como à falta de consenso sobre para que, quando e por quem os dados devem ser usados. Essas conclusões incluem:
- Competências relacionadas – Não é segredo que há uma escassez de profissionais de tecnologia qualificados, como confirma o fato de 47% dos entrevistados relatarem dificuldades para encontrar os talentos de que precisam.
- Iniciativas de compartilhamento de dados – Apenas 12% dos entrevistados contam com processos e estratégias para apresentar os dados aos responsáveis pelas decisões de negócios, conscientizando-os sobre os impactos da tecnologia resiliente (ou da falta dela) nos negócios.
- A finalidade da visibilidade – A maioria dos entrevistados usa a telemetria de forma reativa (ou seja, para solucionar problemas), enquanto apenas 24% usam dados e insights de forma proativa para monitorar possíveis degradações de desempenho e 16% para acompanhar o desempenho dos SLAs.
O restante deste post se concentra nos aspectos técnicos dos insights. Fique de olho em futuros posts sobre estratégia, processos e outros tópicos.
Como o NGINX pode ajudar
Sabemos que a maioria das implantações do Kubernetes já usa uma ferramenta de monitoramento e não precisa de mais uma. Por isso, instrumentamos a API do NGINX Plus para facilitar a exportação de métricas e oferecemos integrações com ferramentas populares, como OpenTracing e Grafana e Prometheus, para que você tenha uma visão completa do desempenho dentro dos seus clusters. Você obtém insights específicos sobre o desempenho e a disponibilidade dos aplicativos, com rastreamentos detalhados que permitem entender como as solicitações são processadas nos seus aplicativos de microsserviços.
- Visibilidade do tráfego de entrada e saída (norte-sul)
NGINX Ingress Controller oferece visibilidade do tráfego que entra e sai dos seus clusters do Kubernetes. Você sabia que existem três controladores Ingress populares baseados no NGINX? Nem todos estão prontos para uso em produção, e uma escolha errada pode acabar complicando sua estratégia de microsserviços em vez de aprimorá-la. Nosso post no blog Espere, qual NGINX Ingress Controller para Kubernetes estou usando? apresenta uma comparação das opções para que você possa tomar a melhor decisão de acordo com suas necessidades. - Visibilidade do tráfego leste-oeste
NGINX Service Mesh oferece visibilidade do tráfego entre aplicações em contêineres.
Continue lendo para descobrir como podemos ajudar com dois problemas comuns:
Se você está pronto para ver a tecnologia em ação, confira esta demonstração ao vivo e a sessão de perguntas e respostas com especialistas da NGINX e da Grafana. Você verá como monitorar em tempo real as principais métricas de balanceamento de carga e desempenho, exportar as métricas para o Prometheus e criar painéis no Grafana para visualizar o desempenho acumulado.
Problema: meu aplicativo está lento (ou fora do ar!)
Você suspeita de um ataque DDoS? Os usuários estão relatando erros no seu site? Você só poderá começar a resolver o problema depois de identificar exatamente onde ele está.
- Monitoramento em tempo real com o NGINX Ingress Controller
Com o NGINX Plus, o painel de monitoramento de atividades em tempo real, baseado na API do NGINX Plus, exibe centenas de métricas importantes de carga e desempenho. Obtenha informações detalhadas até o nível de um único pod para medir com rapidez e facilidade os tempos de resposta dos aplicativos e diagnosticar a origem de um problema. Caso seu ambiente Kubernetes cresça, você receberá automaticamente painéis para cada instância adicional do NGINX Ingress Controller. Por exemplo, duas colunas na guia HTTP Upstreams fornecem uma visão imediata do status dos aplicativos e da infraestrutura: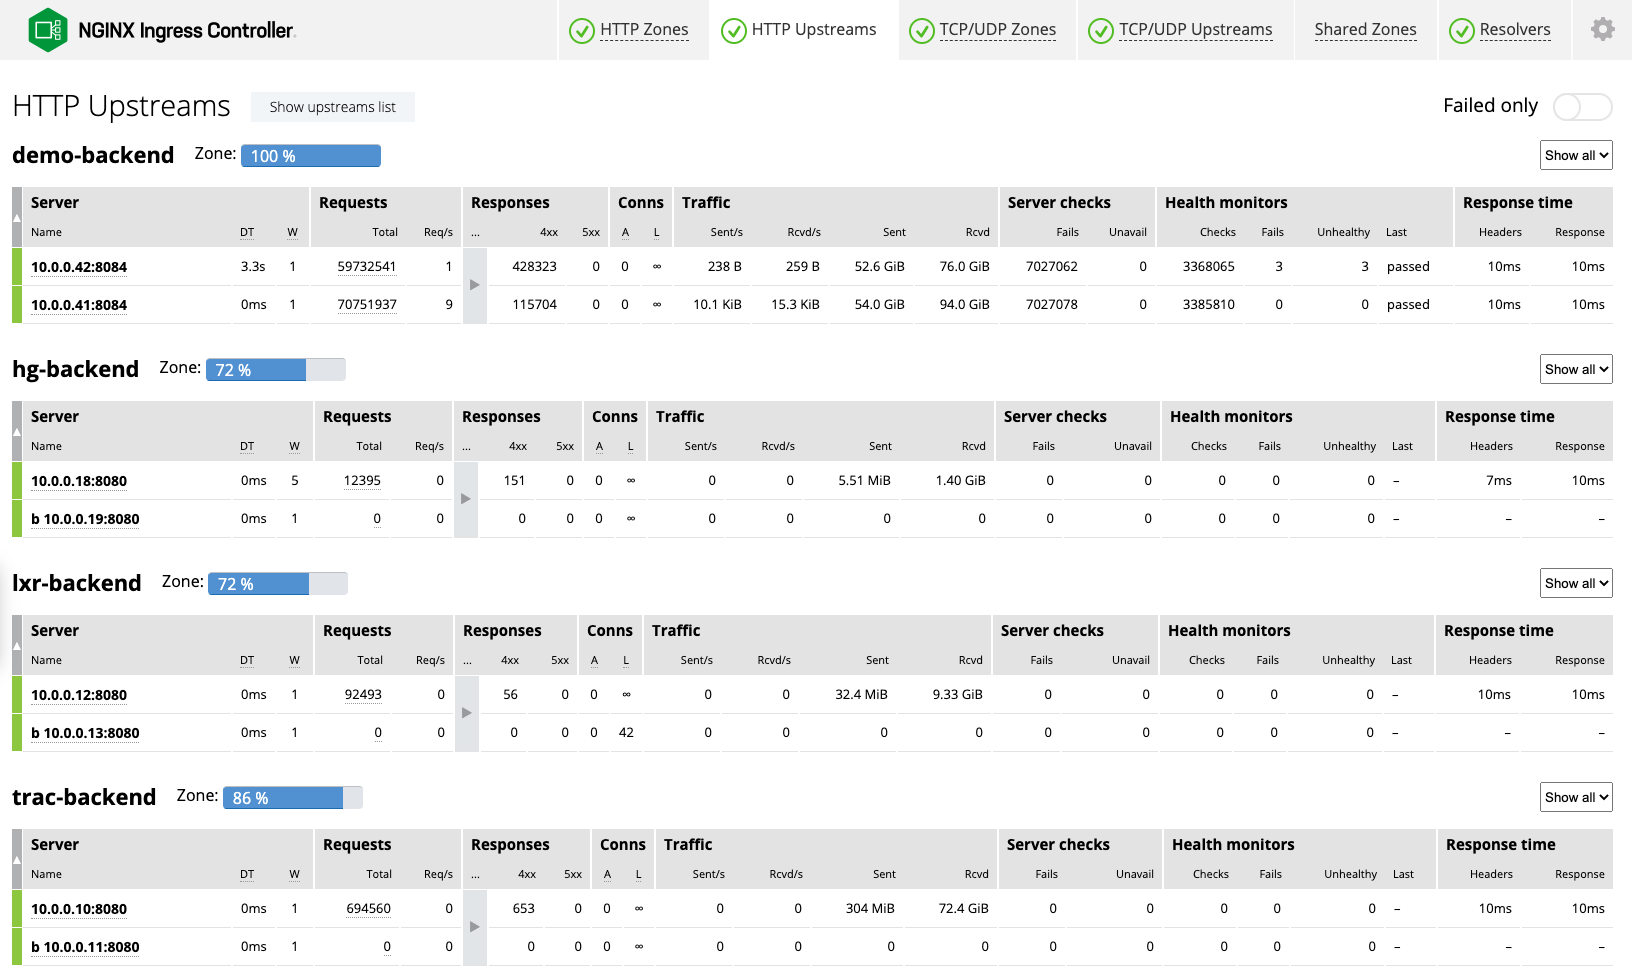
- Solicitações – Se o número de solicitações por segundo (solicitações/s) estiver abaixo do normal para o aplicativo em questão (por exemplo, 5 solicitações por segundo quando o normal é 40), o Ingress Controller ou o aplicativo pode estar configurado incorretamente.
- Tempo de resposta – Se os tempos de resposta forem de 10 milissegundos (ms) ou menos, está tudo ótimo. Uma latência acima de 30–40 ms é sinal de problemas com suas aplicações upstream.
- Status do stub para o NGINX Ingress Controller
Com o NGINX Open Source, o NGINX Ingress Controller inclui uma página de status que apresenta oito métricas básicas. - OpenTracing com o NGINX Service Mesh
O NGINX Service Mesh oferece suporte ao OpenTracing com o módulo NGINX OpenTracing. No momento da redação deste texto, o módulo oferece suporte a Datadog, LightStep, Jaeger e Zipkin.
Problema: meu cluster ou plataforma está ficando sem recursos
Está recebendo erros HTTP? 503 e 40x indicam que há um problema com seus recursos, enquanto os erros 502 indicam que uma alteração de configuração não funcionou. Use dados históricos para diagnosticar onde os recursos podem estar se esgotando.
- Registro de logs com o NGINX Ingress Controller
A primeira etapa para diagnosticar problemas de rede é consultar os logs do NGINX Ingress Controller, nos quais cada entrada de log é identificada com o serviço relevante do Kubernetes. As entradas de erro identificam o serviço associado. Os logs incluem informações detalhadas sobre todo o tráfego que passou pelo Ingress Controller, incluindo data e hora, endereço IP de origem e código de status da resposta. Você também pode exportar os logs para agregadores populares, como Datadog, Grafana e Splunk. - Métricas do Prometheus
Um dos recursos mais populares do NGINX Ingress Controller é sua lista cada vez maior de métricas do Prometheus, que incluem métricas de desempenho da rede e do tráfego do Ingress Controller. Com o NGINX Plus, o NGINX Ingress Controller exporta métricas sobre conexões, armazenamento em cache, tráfego HTTP e TCP/UDP processado por grupos de workers do NGINX que compartilham dados em uma zona de memória, tráfego HTTP e TCP/UDP processado por grupos de servidores de backend e muito mais. O NGINX Service Mesh implanta um servidor Prometheus que usa a API do NGINX Plus para coletar métricas dos sidecars do NGINX Service Mesh e dos pods do NGINX Ingress Controller. Se preferir usar uma implantação existente do Prometheus, também fornecemos configurações de coleta para adicionar ao arquivo de configuração do Prometheus. - Painéis do Grafana
Fornecemos painéis oficiais do Grafana para o NGINX Ingress Controller e o NGINX Service Mesh que exibem as métricas disponibilizadas pelo Prometheus Exporter. Os usuários valorizam a granularidade dos dados, que incluem detalhes em nível de milissegundos, sobreposições comparativas entre dias e picos de tráfego. Por exemplo, o painel do NGINX Service Mesh pode indicar que seus pods atingiram a capacidade máxima, exibindo o volume de tráfego em um determinado serviço ou pod e o número de pods ativos que estão sendo monitorados.
Preparando-se para a produção com o NGINX
O NGINX Ingress Controller pronto para produção (baseado no NGINX Plus) está disponível para uma avaliação gratuita de 30 dias que inclui o NGINX App Protect para proteger seus aplicativos em contêineres. O NGINX Service Mesh, que é sempre gratuito, está disponível para download em f5.com.
Sobre o autor

Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.