Quando apresentamos a NGINX Modern Apps Reference Architecture (MARA) no último outono, durante o Sprint 2.0, enfatizamos nossa intenção de que o projeto não fosse um “brinquedo”, como algumas arquiteturas, mas sim uma solução “sólida, testada e pronta para implantação em aplicações reais de produção executadas em ambientes Kubernetes”. Para um projeto como esse, ferramentas de observabilidade são um requisito indispensável. Todos os integrantes da equipe MARA já vivenciaram em primeira mão como a falta de visibilidade sobre o status e o desempenho torna o desenvolvimento e a entrega de aplicações uma experiência frustrante. Chegamos imediatamente ao consenso de que a MARA precisa incluir instrumentação para depuração e rastreamento em um ambiente de produção.
Outro princípio norteador da MARA é a preferência por soluções de código aberto. Neste post, descrevemos como nossa busca por uma ferramenta de observabilidade multifuncional e de código aberto nos levou ao OpenTelemetry e, em seguida, detalhamos as concessões, decisões de projeto, técnicas e tecnologias que utilizamos para integrar o OpenTelemetry a uma aplicação de microsserviços desenvolvida com Python, Java e NGINX.
Esperamos que conhecer nossas experiências ajude você a evitar possíveis armadilhas e acelerar sua adoção do OpenTelemetry. Observe que esta publicação é um relatório de progresso que pode ficar desatualizado com o tempo — prevemos que as tecnologias discutidas aqui amadureçam dentro de um ano. Além disso, embora apontemos limitações atuais em alguns projetos, somos imensamente gratos por todo o trabalho de código aberto que está sendo realizado e estamos entusiasmados em acompanhar sua evolução.
Nossa aplicação
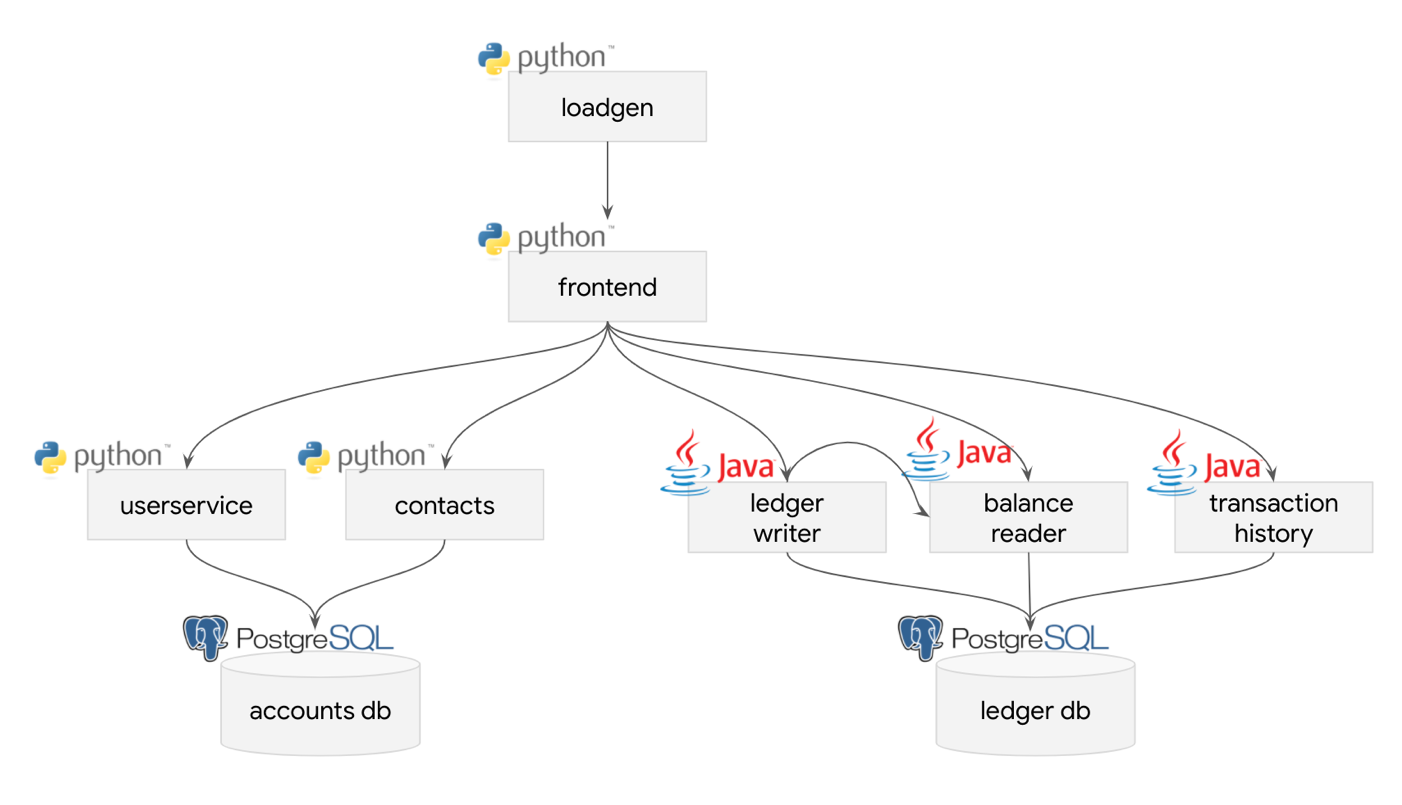
Como aplicação para integrar a uma solução de observabilidade, escolhemos o Bank of Sirius, nosso fork do Bank of Anthos, aplicativo de exemplo do Google. Trata-se de uma aplicação web com arquitetura de microsserviços que pode ser implantada por meio de infraestrutura como código. Há diversas maneiras de melhorar o desempenho e a confiabilidade dessa aplicação, mas ela já é madura o suficiente para ser considerada uma aplicação brownfield. Por isso, acreditamos que ela seja um bom exemplo para mostrar como integrar o OpenTelemetry a uma aplicação, pois, em teoria, o rastreamento distribuído fornece insights valiosos sobre as deficiências da arquitetura de uma aplicação.
Como mostra o diagrama, os serviços que dão suporte à aplicação são relativamente simples.
Como escolhemos o OpenTelemetry
Nosso caminho até a escolha do OpenTelemetry foi cheio de reviravoltas e passou por várias etapas.
Criando uma lista de funcionalidades desejadas
Antes de avaliar as ferramentas de observabilidade de código aberto disponíveis, identificamos quais aspectos da observabilidade são importantes para nós. Com base em nossas experiências anteriores, elaboramos a lista a seguir.
- Registro de logs – No sentido em que usamos o termo, isso significa a geração de conjuntos tradicionais de mensagens de aplicações, separadas por quebras de linha; o aplicativo Bank of Sirius estrutura seus logs no formato Bunyan
- Rastreamento distribuído – Tempos de execução e metadados de cada componente em toda a aplicação, como os que os fornecedores de gerenciamento de desempenho de aplicações (APM) oferecem
- Métricas – Medições coletadas ao longo de um período e representadas graficamente como dados de séries temporais
- Agregação e notificação de exceções/erros – Uma coleção agregada das exceções e dos erros mais comuns, que deve permitir buscas para que possamos determinar quais erros da aplicação são mais frequentes
- Verificações de integridade – Sondagens periódicas enviadas aos serviços para determinar se estão funcionando corretamente na aplicação
- Introspecção do estado de execução – Um conjunto de APIs visíveis apenas para administradores que retornam informações sobre o estado de execução da aplicação
- Dumps de heap/core – Retratos abrangentes do estado de execução de um serviço; o fator importante para nossos propósitos é a facilidade de obter esses dumps sob demanda ou quando um serviço falha
Comparando os recursos das ferramentas com a lista de desejos
É claro que não esperávamos que uma única ferramenta ou abordagem de código aberto incluísse todos esses recursos, mas ao menos essa lista nos deu uma referência ideal para comparar as ferramentas disponíveis. Consultamos a documentação de cada ferramenta para descobrir quais dos sete recursos da nossa lista de desejos ela oferece. A tabela resume nossas conclusões.
Tecnologia Registro de logs Rastreamento distribuído Métricas Agregação de erros Verificações de integridade Introspecção em tempo de execução Dumps de heap/coreELK + Elastic APM ✅ ✅ ✅ ✅ ✅ ❌ ❌Grafana ✅ ✅ ✅ ✅ ✅ ❌ ❌Graylog ✅ ❌ ❌ ❌ ❌ ❌ ❌Jaeger ❌ ✅ ❌ ✅ ❌ ❌ ❌OpenCensus ❌ ❌ ✅ ❌ ❌ ❌ ❌OpenTelemetry Beta ✅ ✅ ✅ ✅ * ❌ ❌Prometheus ❌ ❌ ✅ ❌ ❌ ❌ ❌StatsD ❌ ❌ ✅ ❌ ❌ ❌ ❌Zipkin ❌ ✅ ❌ ✅ ❌ ❌ ❌
* Como uma extensão
Montar esta tabela foi um choque de realidade. As diversas ferramentas diferem tanto em suas funcionalidades e finalidades que não podíamos considerá-las todas parte da mesma categoria – era como comparar maçãs com torradeiras!
Por exemplo, ELK (Elasticsearch-Logstash-Kibana, mais o Filebeat) e Zipkin fazem coisas tão fundamentalmente diferentes que tentar compará-los só gera mais confusão. Infelizmente, a ampliação do escopo original só torna a situação ainda mais confusa – sem dúvida em resposta a solicitações dos usuários, foram adicionados recursos secundários à finalidade principal de cada ferramenta, criando sobreposições com outras ferramentas. À primeira vista, o ELK armazena e visualiza logs, enquanto o Zipkin faz rastreamento distribuído. Mas, ao explorar um pouco mais o portfólio de produtos da Elastic, você logo se depara com o Elastic APM, que oferece suporte a rastreamento distribuído e é até compatível com o Jaeger.
Além da questão da ampliação do escopo original, muitas das ferramentas podem ser integradas entre si, resultando em diferentes combinações de coletores, agregadores, painéis e assim por diante. Algumas tecnologias são compatíveis entre si, enquanto outras não.
Realizando uma investigação qualitativa
Assim, essa tabela comparativa não nos deu uma visão precisa o suficiente para embasar nossa escolha. Precisávamos fazer uma análise qualitativa dos objetivos, dos princípios norteadores e dos possíveis rumos de cada projeto, considerando que, quanto mais os valores de um projeto se assemelhassem aos nossos, maior seria a probabilidade de continuarmos compatíveis ao longo do tempo. Ao visitar as páginas dos projetos, logo notamos isso na página do OpenCensus.
O OpenCensus e o OpenTracing se uniram para formar o OpenTelemetry, que será a próxima versão principal do OpenCensus e do OpenTracing. O OpenTelemetry oferecerá compatibilidade com as integrações existentes do OpenCensus, e continuaremos a fornecer correções de segurança para as bibliotecas existentes do OpenCensus por dois anos.
Para nós, essa era uma informação fundamental. Sabíamos que não podíamos garantir que nossa escolha continuaria sendo adequada no futuro, mas queríamos pelo menos ter a certeza de que ela contaria com um forte apoio da comunidade dali em diante. Com essa informação, pudemos riscar o OpenCensus da nossa lista de candidatos. Provavelmente também não seria uma boa ideia usar o Jaeger, pois ele é a implementação de referência do projeto OpenTracing, que agora está oficialmente obsoleto — a maior parte das novas contribuições será direcionada ao OpenTelemetry.
Então, nos aprofundamos no OpenTelemetry Collector.
O OpenTelemetry Collector oferece uma implementação independente de fornecedor para receber, processar e exportar dados de telemetria. Além disso, elimina a necessidade de executar, operar e manter vários agentes/coletores para oferecer suporte a formatos de dados de telemetria de código aberto (por exemplo, Jaeger, Prometheus etc.) e enviá-los a vários back-ends de código aberto ou comerciais.
O OpenTelemetry Collector atua como um agregador que nos permite combinar diferentes métodos de coleta de dados de observabilidade e de instrumentação com diferentes backends. Basicamente, nossa aplicação pode coletar traces com o Zipkin e métricas do Prometheus, que podemos então enviar para um backend configurável e visualizar com o Grafana. Várias outras combinações dessa arquitetura são possíveis, então podemos testar diferentes abordagens para ver quais tecnologias são adequadas ao nosso caso de uso.
Integração com o OpenTelemetry como caminho a seguir
Basicamente, o OpenTelemetry Collector nos conquistou porque, em teoria, ele nos permite alternar entre tecnologias de observabilidade. Apesar da relativa imaturidade do projeto, decidimos mergulhar de cabeça e usar o OpenTelemetry apenas com integrações de código aberto, porque a única maneira de entender esse cenário é usar as tecnologias.
No entanto, ainda faltam alguns recursos no OpenTelemetry Collector, por isso precisamos recorrer a outras tecnologias para suprir essas necessidades. As seções a seguir resumem nossas escolhas e os motivos por trás delas.
- Implementação de logs
- Implementando rastreamento distribuído
- Implementando a coleta de métricas
- Implementando a agregação de erros
- Implementando verificações de integridade e introspecção em tempo de execução
- Implementando dumps de heap e de memória
Implementando o registro de logs
O registro de logs é uma parte da observabilidade que parece simples, mas logo leva a decisões complexas. É simples porque basta coletar os logs gerados pelos seus contêineres, mas é complexo porque, em seguida, você precisa decidir onde armazenar os dados, como transferi-los para esse local, como indexá-los para torná-los úteis e por quanto tempo mantê-los. Para serem úteis, os arquivos de log precisam permitir buscas fáceis por uma variedade suficiente de critérios para atender às necessidades de diferentes usuários.
Analisamos o suporte a logs do OpenTelemetry Collector e, no momento da redação deste texto, ele ainda está em uma fase beta bastante inicial. Decidimos usar o ELK para logs no curto prazo, enquanto continuamos a investigar outras opções.
Na ausência de motivos convincentes para não fazê-lo, optamos por usar as ferramentas do Elasticsearch, o que nos permitiu dividir a implantação em nós de ingestão, coordenação, mestre e dados. Para facilitar a implantação, usamos um chart do Bitnami. Para transportar dados, implantamos o Filebeat como parte de um DaemonSet do Kubernetes. A funcionalidade de pesquisa foi adicionada com a implantação do Kibana e o uso dos índices, pesquisas, visualizações e dashboards pré-carregados.
Logo ficou claro que, embora essa solução funcionasse, a configuração padrão consumia muitos recursos, o que dificultava sua execução em ambientes com menos recursos, como K3S ou Microk8s. A possibilidade de ajustar o número de réplicas de cada componente resolveu esse problema, mas acabou causando algumas falhas, possivelmente devido ao esgotamento de recursos ou ao volume excessivo de dados.
Longe de ficarmos decepcionados com isso, estamos encarando a situação como uma oportunidade de avaliar o desempenho do nosso sistema de logs com diferentes configurações, além de investigar outras opções, como Grafana Loki e Graylog. É bem possível que descubramos que soluções de logs mais leves não oferecem todos os recursos de que alguns usuários precisam e que estão disponíveis em ferramentas que consomem mais recursos. Dada a natureza modular do MARA, provavelmente desenvolveremos módulos adicionais para essas opções, oferecendo mais alternativas aos usuários.
Implementando o rastreamento distribuído
Além de determinar qual ferramenta oferece a funcionalidade de rastreamento que desejamos, precisávamos considerar como implementar a solução e quais tecnologias precisam ser integradas a ela.
Primeiro, queríamos garantir que nenhuma instrumentação afetasse negativamente a qualidade do serviço da própria aplicação. Todos nós já havíamos trabalhado com sistemas em que o desempenho caía de forma previsível uma vez por hora durante a exportação de logs, e não queríamos reviver essa experiência. A arquitetura do OpenTelemetry Collector era atraente nesse aspecto, pois permite executar uma instância por host. Cada coletor recebe dados de clientes e agentes de todas as aplicações em execução no host (em contêineres ou não). O coletor agrega os dados e pode compactá-los antes de enviá-los a um backend de armazenamento, o que parecia ideal.
Em seguida, avaliamos o suporte ao OpenTelemetry nas diferentes linguagens de programação e frameworks que usamos na aplicação. Nesse ponto, as coisas ficaram um pouco mais complicadas. Apesar de usarmos apenas as duas linguagens de programação e os frameworks associados mostrados na tabela, o nível de complexidade foi surpreendentemente alto.
Linguagem Framework Número de serviçosJava Spring Boot 3Python Flask 3
Para adicionar rastreamento no nível da linguagem, primeiro testamos os agentes de instrumentação automática do OpenTelemetry, mas achamos os resultados deles desorganizados e confusos. Temos certeza de que isso vai melhorar à medida que as bibliotecas de instrumentação automática amadurecerem, mas, por enquanto, descartamos os agentes do OpenTelemetry e decidimos incorporar o rastreamento ao nosso código.
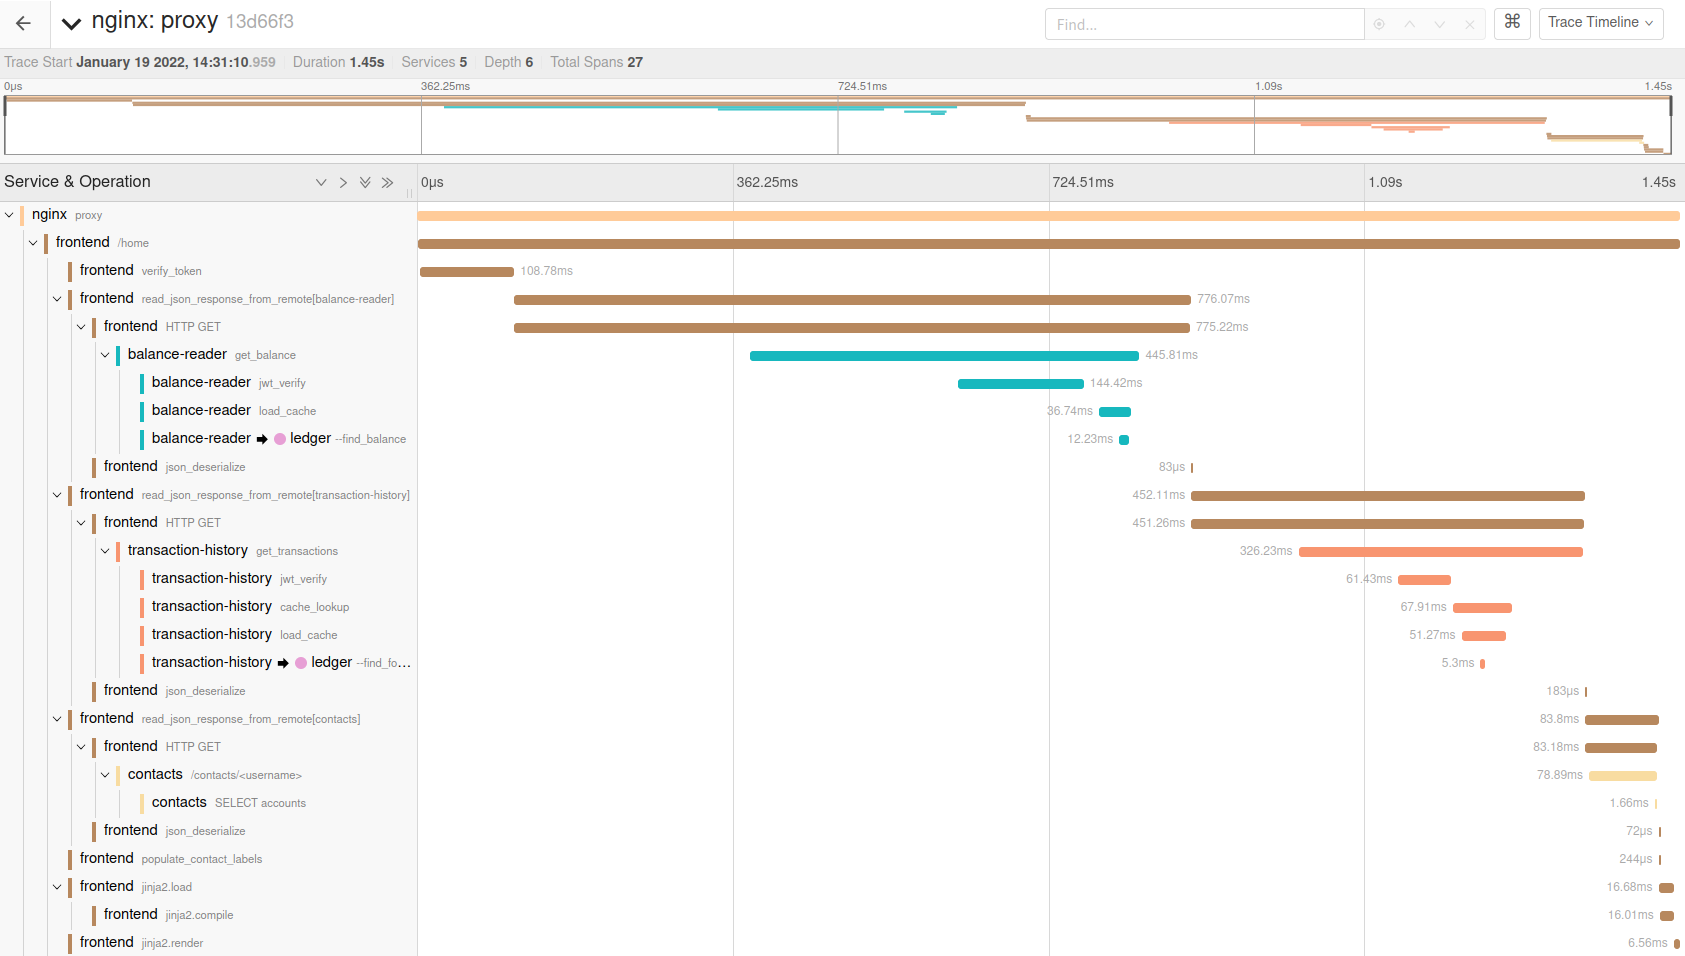
Antes de partir para a implementação do rastreamento diretamente no código, configuramos o OpenTelemetry Collector para enviar todos os dados de rastreamento a uma instância do Jaeger em execução local, onde podíamos visualizar os resultados com mais facilidade. Isso foi bastante útil, pois pudemos experimentar a apresentação visual dos dados de rastreamento enquanto descobríamos como integrar o OpenTelemetry por completo. Por exemplo, se percebêssemos que uma biblioteca cliente HTTP não incluía dados de rastreamento ao fazer chamadas a um serviço do qual dependíamos, adicionávamos o problema imediatamente à nossa lista de correções. O Jaeger oferece uma boa visualização de todos os diferentes spans em um único trace:
Rastreamento distribuído para Python
Adicionar rastreamento ao nosso código Python foi relativamente simples. Adicionamos dois arquivos de código-fonte Python que são referenciados por todos os nossos serviços e atualizamos os respectivos arquivos requirements.txt para incluir as dependências opentelemetry-instrumentation-* relevantes. Isso nos permitiu usar a mesma configuração de rastreamento para todos os serviços Python, além de incluir o ID de rastreamento de cada requisição nas mensagens de log e incorporar esse ID nas requisições aos serviços dos quais dependemos.
Rastreamento distribuído para Java
Em seguida, voltamos nossa atenção para os serviços Java. Usar as bibliotecas Java do OpenTelemetry diretamente em um projeto criado do zero é relativamente simples – basta importar as bibliotecas necessárias e usar a API de rastreamento diretamente. No entanto, se você usa Spring como nós, há outras decisões a tomar.
O Spring já tem uma API de rastreamento distribuído, o Spring Cloud Sleuth. Ela fornece uma fachada sobre a implementação subjacente de rastreamento distribuído que faz o seguinte, conforme descrito na documentação:
- Adiciona os IDs de trace e span ao MDC do Slf4J, permitindo extrair todos os logs de um determinado trace ou span em um agregador de logs.
- Instrumenta os pontos comuns de entrada e saída de aplicações Spring (filtro de servlet, RestTemplate, ações agendadas, canais de mensagens, cliente Feign).
- Se
spring-cloud-sleuth-zipkinestiver disponível, … [gera e reporta] rastros compatíveis com o Zipkin via HTTP. Por padrão, eles são enviados a um serviço coletor do Zipkin no localhost (porta 9411). Configure o endereço do serviço usandospring.zipkin.baseUrl.
A API também nos permite adicionar rastreamentos a tarefas anotadas com @Scheduled.
Em outras palavras, usando apenas o Spring Cloud Sleuth, já obtemos rastreamentos no nível dos endpoints dos serviços HTTP sem precisar de configurações adicionais, o que é uma boa vantagem. Como nosso projeto já usa Spring, decidimos manter tudo nesse framework e aproveitar os recursos disponíveis. No entanto, encontramos alguns problemas ao integrar tudo com o Maven:
- O módulo Spring Cloud Sleuth Autoconfigure ainda está em uma versão milestone.
- O módulo Spring Cloud Sleuth Autoconfigure depende de uma versão alfa desatualizada de
opentelemetry-instrumentation-api. Atualmente, não há nenhuma versão 1.x recente dessa biblioteca que não seja alfa. - O projeto precisa obter o modelo de objeto do projeto (POM) pai
spring-cloud-builddos repositórios Spring Snapshot devido à forma como o Spring Cloud Sleuth define suas referências de dependências para versões milestone.
Isso tornou a definição do nosso projeto Maven um pouco mais complicada, pois precisávamos fazer com que o Maven buscasse dependências tanto nos repositórios do Spring quanto no Maven Central, um sinal claro de como o suporte ao OpenTelemetry no Spring Cloud ainda estava em estágio inicial. Mesmo assim, seguimos em frente e criamos um módulo comum de telemetria para configurar o rastreamento distribuído usando Spring Cloud Sleuth e OpenTelemetry, com diversas funções auxiliares e extensões relacionadas à telemetria.
No módulo comum de telemetria, ampliamos a funcionalidade de rastreamento oferecida pelas bibliotecas Spring Cloud Sleuth e OpenTelemetry, fornecendo:
- Compatíveis com Spring, as classes
Autoconfigurationclasses configuram o rastreamento e as funcionalidades adicionais do projeto e carregam atributos adicionais de recursos de rastreamento. - Implementações de interface NoOp, para que possamos desativar o rastreamento na inicialização injetando instâncias de NoOp em todas as interfaces do Spring Cloud Sleuth.
- Um interceptador de nomenclatura de rastreamentos para padronizar os nomes dos rastreamentos.
- Um manipulador de erros que registra erros por meio do slf4j e do rastreamento do Spring Cloud Sleuth.
- Uma implementação aprimorada de atributos de rastreamento que codifica informações adicionais em cada rastreamento emitido, incluindo a versão do serviço, o ID da instância do serviço, o ID da máquina, o nome do pod, o ID do contêiner, o nome do contêiner e o nome do namespace.
- Um inspetor de instruções para rastreamento que injeta IDs de rastreamento nos comentários que precedem as instruções SQL emitidas pelo Hibernate. Aparentemente, agora isso pode ser feito com o SQLCommenter, mas ainda não migramos para ele.
Além disso, implementamos um cliente HTTP compatível com o Spring baseado no Apache HTTP Client, pois queríamos mais métricas e possibilidades de personalização ao fazer chamadas HTTP entre serviços. Nessa implementação, os identificadores de trace e span são enviados como cabeçalhos nas chamadas aos serviços dependentes, permitindo que sejam incluídos na saída do rastreamento. Além disso, essa implementação fornece métricas do pool de conexões HTTP que são agregadas pelo OpenTelemetry.
No fim das contas, integrar o rastreamento com o Spring Cloud Sleuth e o OpenTelemetry deu bastante trabalho, mas acreditamos que valeu a pena. Esperamos que este projeto e este post ajudem a iluminar o caminho para outras pessoas que queiram seguir por essa direção.
Rastreamento distribuído para NGINX
Para obter traces que conectem todos os serviços durante todo o ciclo de vida de uma solicitação, precisamos integrar o OpenTelemetry ao NGINX. Para isso, usamos o módulo OpenTelemetry para NGINX (ainda em versão beta). Prevendo possíveis dificuldades para obter binários funcionais do módulo compatíveis com todas as versões do NGINX, criamos um repositório no GitHub com imagens de contêiner que incorporam módulos do NGINX sem suporte. Executamos builds noturnos e distribuímos o binário do módulo por meio de imagens Docker que facilitam sua importação.
Ainda não integramos esse processo ao processo de compilação do NGINX Ingress Controller no projeto MARA, mas planejamos fazer isso em breve.
Implementação da coleta de métricas
Após concluir a integração de rastreamento com o OpenTelemetry, passamos a nos concentrar nas métricas. Não havia métricas para nossas aplicações baseadas em Python, e decidimos adiar sua adição por enquanto. Para as aplicações Java, o código-fonte original do Bank of Anthos, que usa o Micrometer em conjunto com o Stackdriver do Google Cloud, oferece suporte a métricas. No entanto, removemos esse código do Bank of Sirius após criar um fork do Bank of Anthos, pois ele não nos permitia configurar um backend de métricas. Ainda assim, o fato de já existirem pontos de instrumentação para métricas evidenciava a necessidade de uma integração adequada de métricas.
Para chegar a uma solução configurável e pragmática, primeiro analisamos o suporte a métricas nas bibliotecas Java do OpenTelemetry e no Micrometer. Ao pesquisar comparações entre as tecnologias, vários resultados enumeraram as limitações do OpenTelemetry como API de métricas na JVM, embora o suporte a métricas do OpenTelemetry ainda esteja em fase alfa no momento em que este texto é escrito. O Micrometer é uma camada de fachada de métricas madura para a JVM, semelhante ao slf4j por fornecer um wrapper de API comum para uma implementação de métricas configurável, em vez de fornecer sua própria implementação de métricas. Curiosamente, ele é a API de métricas padrão do Spring.
Nesse momento, estávamos ponderando os seguintes fatos:
- O OpenTelemetry Collector pode consumir métricas de praticamente qualquer fonte, incluindo Prometheus, StatsD e o protocolo nativo OpenTelemetry Protocol (OTLP)
- O Micrometer também oferece suporte a um grande número de backends de métricas, incluindo Prometheus e StatsD
- O SDK de métricas do OpenTelemetry para a JVM permite enviar métricas via OTLP
Após alguns experimentos, decidimos que a abordagem mais pragmática seria usar a fachada do Micrometer com uma implementação subjacente do Prometheus e configurar o OpenTelemetry Collector para usar a API do Prometheus para coletar métricas da aplicação. Sabíamos, por diversos artigos, que a falta de alguns tipos de métricas no OpenTelemetry pode causar problemas, mas nossos casos de uso não precisam desses tipos, então essa limitação era aceitável.
Descobrimos algo interessante sobre o OpenTelemetry Collector: mesmo tendo sido configurado para receber traces via OTLP e métricas pela API do Prometheus, ele ainda pode ser configurado para enviar ambos os tipos de dados a um receptor de dados externo usando OTLP ou qualquer outro protocolo compatível. Isso nos permitiu testar facilmente nossa aplicação com o LightStep.
No geral, implementar métricas em Java foi bastante simples porque seguimos a API do Micrometer, que conta com inúmeros exemplos e tutoriais disponíveis. Provavelmente, a parte mais difícil, tanto para métricas quanto para rastreamento, foi acertar o grafo de dependências do Maven no arquivo pom.xml do telemetry-common.
Implementando a agregação de erros
O projeto OpenTelemetry não inclui a agregação de erros em sua missão propriamente dita e não oferece uma implementação de marcação de erros tão elegante quanto a de soluções como Sentry ou Honeybadger.io. Ainda assim, decidimos usar o OpenTelemetry para agregação de erros no curto prazo, em vez de adicionar outra ferramenta. Com uma ferramenta como o Jaeger, podemos pesquisar por error=true para encontrar todos os rastreamentos com uma condição de erro. Isso pelo menos nos dá uma ideia do que costuma dar errado. No futuro, podemos considerar adicionar uma integração com o Sentry.
Implementando verificações de integridade e introspecção em tempo de execução
No contexto da nossa aplicação, as verificações de integridade informam ao Kubernetes se um serviço está íntegro ou se concluiu sua fase de inicialização. Nos casos em que o serviço não está íntegro, o Kubernetes pode ser configurado para encerrar ou reiniciar instâncias. Na nossa aplicação, decidimos não usar as verificações de integridade do OpenTelemetry porque consideramos a documentação insuficiente.
Em vez disso, para os serviços JVM, usamos um projeto Spring chamado Spring Boot Actuator, que fornece não apenas endpoints de verificação de integridade, mas também endpoints de introspecção em tempo de execução e de dump de heap. Para os serviços Python, usamos o módulo Flask Management Endpoints, que oferece um subconjunto dos recursos do Spring Boot Actuator. Atualmente, ele fornece apenas informações personalizáveis sobre a aplicação e verificações de integridade.
O Spring Boot Actuator se integra à JVM e ao Spring para fornecer endpoints de introspecção, monitoramento e verificação de integridade. Além disso, oferece um framework para adicionar informações personalizadas aos dados padrão apresentados em seus endpoints. Os endpoints permitem a introspecção em tempo de execução de itens como estado do cache, ambiente de execução, migrações de banco de dados, verificações de integridade, informações personalizáveis da aplicação, métricas, tarefas periódicas, estado da sessão HTTP e dumps de threads.
Os endpoints de verificação de integridade implementados pelo Spring Boot Actuator têm uma configuração modular que permite compor a avaliação da integridade de um serviço com várias verificações individuais, categorizadas como liveness ou readiness. Também está disponível uma verificação de integridade completa que exibe todos os módulos de verificação e geralmente tem uma aparência como esta.
Os endpoints informativos são definidos em um documento JSON como um único objeto JSON de alto nível e uma série de chaves e valores hierárquicos. Normalmente, o documento especifica o nome e a versão do serviço, a arquitetura, o nome do host, informações sobre o sistema operacional, o ID do processo, o nome do executável e detalhes sobre o host, como um ID de máquina ou um ID exclusivo do serviço.
Implementação de dumps de heap e de memória
Você deve se lembrar, pela tabela em Comparação dos recursos das ferramentas com a lista de desejos, de que nenhuma das ferramentas oferece suporte à introspecção em tempo de execução ou a dumps de heap/core. No entanto, o Spring, que usamos como framework base, oferece suporte a ambos — embora tenha dado um pouco de trabalho integrar os recursos de observabilidade à aplicação. Conforme detalhado na seção anterior, para a introspecção em tempo de execução, usamos um módulo Python em conjunto com o Spring Boot Actuator.
Da mesma forma, para os dumps de heap, usamos os endpoints de dump de threads fornecidos pelo Spring Boot Actuator para implementar parte dos recursos que queríamos. Não conseguimos obter core dumps sob demanda nem dumps de heap da JVM com o nível de granularidade que seria ideal, mas conseguimos parte da funcionalidade desejada com pouco esforço adicional. Infelizmente, os core dumps dos serviços Python exigirão uma quantidade considerável de trabalho adicional, que adiamos para mais tarde.
Resumo
Depois de muito chorar e questionar nossas escolhas de vida, chegamos a um consenso sobre o uso das seguintes tecnologias para observabilidade no MARA (a seguir, OTel significa OpenTelemetry):
- Registro de logs (para todos os contêineres) – Filebeat → Elasticsearch / Kibana
- Rastreamento distribuído
- Java – Spring Cloud Sleuth → exportador do Spring Cloud Sleuth para OTel → OTel Collector → exportadores plugáveis como Jaeger, Lightstep, Splunk etc.
- Python – Bibliotecas OTel para Python → OTel Collector → armazenamento intercambiável
- NGINX e NGINX Plus (o NGINX Ingress Controller ainda não é compatível) – módulo OTel do NGINX → OTel Collector → exportador conectável
- Coleta de métricas
- Java – Micrometer via Spring → exportador do Prometheus → OTel Collector
- Python – Ainda não há implementação
- Python WSGI – GUnicorn StatsD → Prometheus (via StatsD / ServiceMonitor)
- NGINX – Endpoint do Prometheus → Prometheus (via ServiceMonitor)
- Agregação de erros – rastros distribuídos do OTel → exportador plugável → funcionalidade de busca do exportador para encontrar rastros marcados com
error - Verificações de integridade
- Java – Spring Boot Actuator → Kubernetes
- Python – módulo Flask Management Endpoints → Kubernetes
- Introspecção em tempo de execução
- Java – Spring Boot Actuator
- Python – módulo Flask Management Endpoints
- Despejos de heap/core
- Java – Suporte do Spring Boot Actuator para dumps de threads
- Python – Ainda sem suporte
Esta implementação reflete o estado atual do projeto. Ela certamente mudará e evoluirá à medida que o desenvolvimento avançar. Em breve, submeteremos a aplicação a testes de carga extensivos. Esperamos aprender muito sobre as limitações da nossa abordagem de observabilidade e adicionar novos recursos de observabilidade.
Experimente a Arquitetura de Referência para Aplicações Modernas e a aplicação de exemplo (Bank of Sirius). Se você tiver ideias de como podemos melhorar, suas contribuições serão bem-vindas em nosso repositório no GitHub!
Publicações relacionadas
Este post faz parte de uma série. À medida que adicionamos funcionalidades à MARA, publicamos os detalhes no blog:
- Uma nova arquitetura de referência de código aberto para aplicações modernas
- Integrando o OpenTelemetry à arquitetura de referência de aplicações modernas – Um relatório de progresso (este post)
- MARA: agora em uma estação de trabalho perto de você
- Anunciamos a versão 1.0.0 da arquitetura de referência de aplicações modernas do NGINX
Publicações relacionadas no blog
Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.
Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.
Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.
Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.