NGINX Plus R9 introduz a capacidade de usar proxy reverso e balancear a carga do tráfego UDP, um aprimoramento significativo dos recursos de balanceamento de carga da Camada 4 do NGINX Plus.
Esta publicação do blog analisa os desafios de executar um servidor DNS em uma infraestrutura moderna de aplicações para mostrar como o NGINX Open Source e o NGINX Plus podem balancear a carga do tráfego UDP e TCP de forma eficaz e eficiente. (As verificações [ativas] da integridade das aplicações são exclusivas do NGINX Plus, mas, fora isso, as informações deste blog se aplicam igualmente ao NGINX Open Source; para simplificar, usaremos NGINX Plus no restante da publicação).
[Editor – Para ter uma visão geral de todos os novos recursos do NGINX Plus R9, consulte Anúncio do NGINX Plus R9 em nosso blog.]
Por que balancear a carga do tráfego UDP?
Ao contrário do TCP, o UDP, por definição, não garante a entrega de dados de ponta a ponta. É como enviar uma mensagem por pombo-correio: você sabe que a mensagem foi enviada, mas não pode ter certeza de que ela chegou. Essa abordagem “sem conexão” oferece vários benefícios, principalmente uma latência menor do que a do TCP, tanto porque as mensagens individuais menores do UDP consomem menos largura de banda quanto porque não há um processo de handshake para estabelecer uma conexão. O UDP deixa a cargo do desenvolvedor da aplicação a detecção de timeouts e outros problemas no nível da rede. Mas o que isso significa para o DNS?
Assim como vários outros protocolos baseados em UDP, o DNS usa um fluxo de dados de solicitação e resposta. Por exemplo, um cliente DNS solicita o endereço IP correspondente a um nome de host e recebe uma resposta. Se a resposta não chegar dentro de um determinado período de tempo limite, o cliente DNS enviará a mesma solicitação a um servidor DNS “reserva”. No entanto, ter que aguardar o período de tempo limite antes de tentar novamente pode transformar o que normalmente é um processo extremamente rápido (medido em milissegundos) em um processo muito lento (medido em segundos).
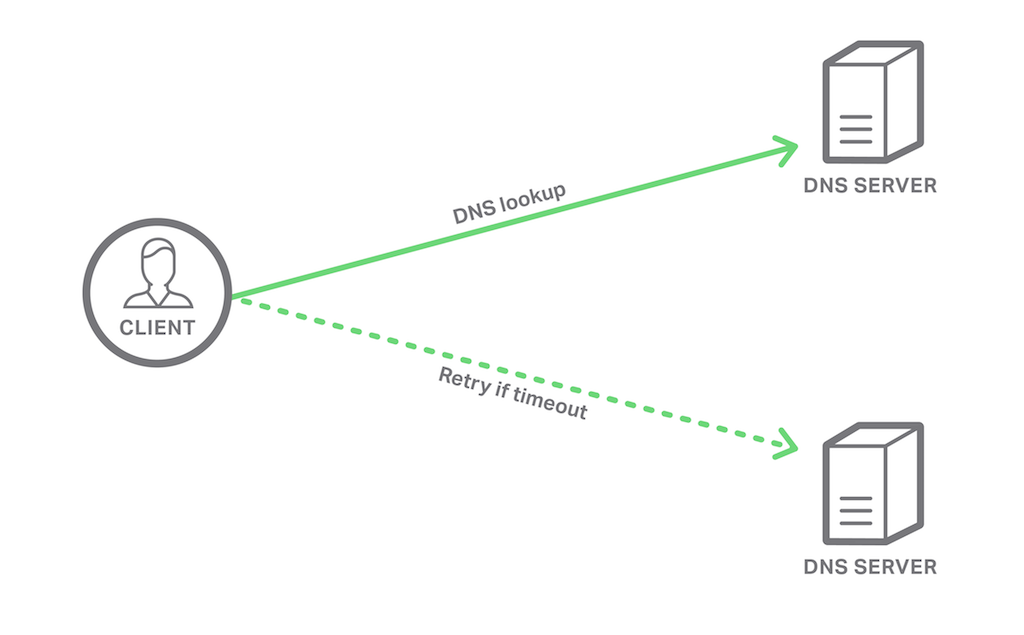
Usar o NGINX Plus para atuar como proxy e fazer o balanceamento de carga do tráfego DNS reduz o número de situações em que o cliente enfrenta um tempo limite. Com vários servidores DNS por trás do balanceador de carga NGINX Plus, os clientes só enfrentam um tempo limite quando há uma partição de rede entre o cliente e o NGINX Plus. Quando o NGINX Plus usa verificações de integridade da aplicação, os problemas nos próprios servidores DNS não afetam o cliente. Ao monitorar a disponibilidade e o tempo de resposta de cada servidor, o NGINX Plus evita enviar solicitações de clientes a um servidor com problemas.
DNS não é apenas um protocolo UDP
Embora a grande maioria do tráfego DNS ocorra via UDP, há operações comuns de DNS que usam TCP. O DNS usa UDP para mensagens pequenas (de até 512 bytes), mas usa TCP para operações que exigem (ou provavelmente exigirão) mensagens maiores. Historicamente, o TCP era usado com o DNS apenas para transferências de zona de um servidor de nomes primário autoritativo para seus servidores de nomes secundários. No entanto, com a adoção de contêineres e infraestrutura imutável, o DNS é cada vez mais usado como o principal mecanismo de descoberta de serviços, por meio do uso de registros SRV.
Os registros DNS SRV records foram originalmente introduzidos para que aparelhos de voz sobre IP (VoIP) que usam SIP pudessem localizar seus servidores, mas podem ser usados para qualquer tipo de serviço. No entanto, os registros SRV contêm muito mais informações do que a maioria dos outros tipos de registro DNS. Como resultado, apenas cerca de 10 registros SRV cabem na resposta UDP padrão de 512 bytes, em comparação com cerca de 30 registros A. Quando uma resposta DNS excede o limite de 512 bytes, os primeiros 512 bytes são retornados, mas a resposta é marcada como “truncada”. Nesse ponto, um cliente DNS pode lidar com a resposta truncada da melhor forma possível ou repetir a mesma solicitação usando TCP.
Isso significa que, ao fazer o balanceamento de carga de servidores DNS em uma infraestrutura de rede moderna, o NGINX Plus pode esperar receber uma combinação de tráfego UDP e TCP.
DNS em um ambiente de microsserviços
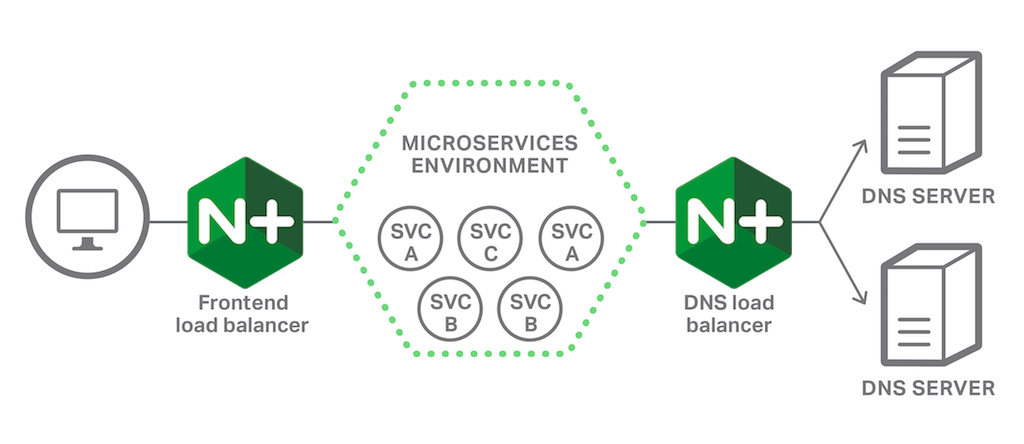
A ilustração a seguir mostra uma visão simplificada de um ambiente de microsserviços com dois balanceadores de carga. O balanceador de carga de frontend atua como proxy das solicitações dos clientes públicos da aplicação, selecionando a melhor instância de microsserviço e executando muitas outras funções que não abordaremos aqui. Vamos nos concentrar no balanceador de carga de DNS, que fica entre o ambiente de microsserviços e os servidores DNS que fornecem informações de descoberta de serviços aos microsserviços.
Configurando o balanceamento de carga básico de DNS
O NGINX Plus implementa o balanceamento de carga da Camada 4 no módulo Stream, portanto, o balanceamento de carga UDP e TCP é configurado no bloco stream, conforme mostrado no trecho a seguir.
Aviso: Não é possível simplesmente adicionar este trecho de configuração como um novo arquivo no diretório /etc/nginx/conf.d. Isso resulta em um erro de validação (“a diretiva stream não é permitida aqui”), pois o arquivo de configuração padrão do NGINX Plus, nginx.conf, inclui o conteúdo dos arquivos do diretório conf.d no bloco http. A solução mais simples é incluir o bloco stream completo diretamente no arquivo nginx.conf.
stream {    upstream dns_servers {
        server 192.168.136.130:53;
        server 192.168.136.131:53;
    }

    server {
        listen 53  udp;
        listen 53; #tcp
        proxy_pass dns_servers;
        error_log  /var/log/nginx/dns.log info;
    }
}
Primeiro, definimos o grupo upstream de servidores DNS. As diretivas server especificam o número da porta em que nossos servidores upstream estão escutando: 53 (a porta padrão do DNS).
O bloco server{} define como o NGINX Plus processa o tráfego DNS de entrada. As duas diretivas listen instruem o NGINX Plus a escutar na porta 53 o tráfego UDP e TCP. O TCP é o protocolo padrão da Camada 4 para o módulo Stream, portanto, não o especificamos explicitamente como parâmetro, como fazemos com o UDP.
A diretiva proxy_pass informa ao NGINX Plus o que fazer com o tráfego que está sendo monitorado. Nesse caso, encaminhamos esse tráfego por proxy para o grupo upstream dns_servers. O NGINX Plus usa UDP automaticamente ao encaminhar solicitações UDP de clientes para servidores upstream (e TCP para solicitações TCP de clientes), portanto, não precisamos especificar explicitamente o protocolo da Camada 4 no grupo upstream.
Não há uma diretiva access_log no módulo Stream, pois o NGINX Plus não inspeciona a carga útil de segmentos TCP nem de datagramas UDP (como faz com pacotes HTTP). No entanto, podemos usar o parâmetro info na diretiva error_log para registrar o processamento de conexões e os eventos de proxy.
[Editor – O registro de acesso foi habilitado no módulo Stream após a publicação deste blog, no NGINX Open Source 1.11.4 e no NGINX Plus R11.]
Ajustes para alta disponibilidade
Para melhorar a disponibilidade dos nossos servidores DNS, podemos adicionar mais algumas diretivas e configurar verificações ativas de integridade (da aplicação).
Configurando o número de respostas do proxy e a duração do tempo limite
A primeira diretiva adicional é proxy_responses, que especifica quantas respostas o NGINX Plus espera para cada solicitação UDP encaminhada por proxy. No nosso caso, após receber uma única resposta, o NGINX Plus para imediatamente de aguardar outras respostas, liberando a memória e o soquete usados nessa sessão.
A segunda diretiva adicional, proxy_timeout, determina por quanto tempo o NGINX Plus aguarda uma resposta do servidor (aqui, estamos reduzindo o padrão de 10 minutos para 1 segundo). Se o NGINX Plus não receber nenhuma resposta nesse período, ele tentará o próximo servidor no grupo upstream e marcará o servidor upstream que não respondeu como indisponível por um período definido (10 segundos por padrão), para que nenhum outro cliente sofra atrasos causados por timeout durante esse intervalo.
server {    listen 53  udp;
    listen 53; #tcp
    proxy_pass      dns_servers;
    error_log       /var/log/nginx/dns.log info;
    proxy_responses 1;
    proxy_timeout 1s;
}
Também podemos alterar o período durante o qual um servidor é marcado como indisponível incluindo a opção fail_timeout na diretiva server do grupo upstream. Com a configuração a seguir, o NGINX Plus marca os servidores upstream com falha como indisponíveis por 60 segundos:
upstream dns_servers {    server 192.168.136.130:53 fail_timeout=60s;
    server 192.168.136.131:53 fail_timeout=60s;
}
Isso nos permite controlar o tempo de atraso que um cliente enfrenta caso um de nossos servidores DNS falhe. No entanto, se houver uma tentativa de solicitação TCP a um servidor DNS com falha, a verificação de erros inerente ao TCP permitirá que o NGINX Plus o marque automaticamente como indisponível, evitando que solicitações TCP ou UDP subsequentes sejam enviadas a esse servidor.
Configurando verificações de integridade ativas
O recurso de verificação ativa de integridade do NGINX Plus é uma ferramenta adicional e extremamente valiosa para garantir a alta disponibilidade de qualquer serviço com balanceamento de carga, incluindo DNS. Em vez de esperar que uma solicitação TCP real de um cliente DNS falhe para só então marcar o servidor DNS como indisponível, fazemos com que o NGINX Plus tente periodicamente estabelecer uma conexão TCP na porta 53 para verificar se o servidor DNS está ativo e funcionando corretamente. Para isso, incluímos a diretiva health_check com o parâmetro port=53 no bloco server{}. (Por padrão, o NGINX Plus envia verificações de integridade para a porta especificada pela diretiva listen, que, no nosso caso, é a 53. Portanto, aqui usamos o parâmetro para configurar explicitamente o valor padrão, mas poderíamos especificar outra porta se também modificássemos nossos servidores DNS para responder ao tráfego nela.)
Com UDP, podemos ir um passo além e configurar uma verificação de integridade ativa que faça uma consulta DNS real para um registro conhecido. Por exemplo, podemos inserir o seguinte registro CNAME no arquivo de zona do mesmo subdomínio usado para a descoberta de serviços no ambiente de microsserviços.
healthcheck IN CNAME healthy.svcs.example.com.Dada a natureza leve do UDP, podemos monitorar o tráfego de rede e extrair facilmente a sequência de bytes que representa uma consulta DNS. Em seguida, criamos um bloco de configuração match usando essa sequência como parâmetro da diretiva send. A diretiva expect especifica a resposta que o servidor deve retornar para ser considerado íntegro.
match dns_lookup {
    send x00x01x00x00x00x01x00x00x00x00x00x00x06x68x65x61 ...;
    expect ~* "healthy.svcs.example.com.";
}
A vantagem dessa verificação de integridade aprofundada, no nível da aplicação, é que, mesmo que seu servidor de nomes esteja em funcionamento, realizar uma consulta DNS real para o seu domínio de produção revela problemas de configuração e corrupção de dados que, de outra forma, poderiam causar problemas em etapas posteriores.
A equipe de Suporte do NGINX Plus pode ajudar a preparar verificações de integridade UDP para consultas DNS e outros protocolos.
O trecho a seguir destaca as diretivas adicionais necessárias para as verificações de integridade ativas.
stream {    upstream dns_servers {
        zone dns_mem 64k;
        server 192.168.136.130:53 fail_timeout=60s;
        server 192.168.136.131:53 fail_timeout=60s;
    }

    match dns_lookup { send x00x01x00x00x00x01x00x00x00x00x00x00x06x68x65x61 ...; expect ~* "healthy.svcs.example.com."; }

    server {
        listen 53  udp;
        listen 53; #tcp
        health_check match=dns_lookup interval=20 fails=2 passes=2 udp;
        health_check interval=20 fails=1 passes=2 port=53; #tcp
        proxy_pass      dns_servers;
        error_log       /var/log/nginx/dns.log debug;
        proxy_responses 1;
        proxy_timeout   1s;

    }
}
A diretiva zone define uma zona de memória compartilhada chamada dns_mem, que disponibiliza os resultados das verificações de integridade (e outras informações de estado) para todos os processos de trabalho do NGINX Plus.
A diretiva match é abordada logo acima.
A diretiva health_check tem vários parâmetros que você pode ajustar para o seu ambiente. Aqui, definimos verificações de integridade separadas para UDP e TCP, respectivamente. Devido à diferença entre UDP e TCP, exigimos duas falhas consecutivas na verificação de integridade via UDP antes de marcar o servidor DNS como não íntegro, mas apenas uma falha via TCP. Para ambos os protocolos, exigimos duas respostas bem-sucedidas antes de marcar um servidor novamente como íntegro, evitando assim o envio de solicitações a um servidor instável, que fica alternando de estado.
Uma vantagem de definir um único grupo upstream de servidores DNS para o tráfego UDP e TCP é que, se a verificação de integridade falhar em qualquer um dos protocolos, o servidor será marcado como não íntegro e removido do pool com balanceamento de carga.
Ajuste para escalabilidade
Embora a implantação de apenas dois servidores de backend possa ser uma solução eficaz de alta disponibilidade, os recursos de balanceamento de carga do NGINX Plus permitem escalar horizontalmente os servidores de backend sem que o cliente perceba.
É pouco provável que o ambiente de microsserviços de exemplo descrito acima exija o dimensionamento dos servidores DNS de backend. No entanto, um provedor de serviços de Internet que fornece serviços de DNS a todos os seus assinantes enfrenta uma carga constante e a possibilidade de grandes picos, o que gera a necessidade de um grande número de servidores DNS e de um proxy de frontend para balancear a carga do tráfego entre eles.
Todos os algoritmos de balanceamento de carga do NGINX e do NGINX Plus estão disponíveis para TCP e UDP, bem como para HTTP:
- Round Robin (padrão)
- Hash genérico e sua variante consistente (algoritmo ketama)
- Hash de IP
- Menor número de conexões
- Menor tempo (somente NGINX Plus)
(Você também pode configurar pesos em todos os algoritmos para aumentar ainda mais a eficiência deles. Para saber mais, consulte a seção sobre pesos no artigo Como escolher uma técnica de balanceamento de carga do NGINX Plus em nosso blog.)
Embora as solicitações HTTP possam variar enormemente em termos da carga e das demandas de processamento impostas aos servidores de backend, as solicitações DNS normalmente geram todas a mesma carga. Por esse motivo, é improvável que os algoritmos Menor Número de Conexões e Menor Tempo ofereçam alguma vantagem em relação ao Round Robin. Especificamente, o Menor Número de Conexões inclui em sua contagem de conexões todas as solicitações UDP para as quais o NGINX Plus ainda aguarda uma resposta do servidor upstream. Enquanto os valores de proxy_responses e proxy_timeout não forem atingidos, o NGINX Plus continuará contabilizando conexões para servidores upstream que talvez já tenham concluído seu trabalho.
Quando há um grande número de clientes e um protocolo que envolve muito “diálogo” – várias mensagens trocadas entre o cliente e o servidor, como no fluxo de desafio-resposta do RADIUS –, o uso de um hash do IP de origem permite que esse diálogo ocorra com um único servidor de backend. Em outras palavras, isso estabelece a persistência de sessão, o que significa que o NGINX Plus direciona todas as solicitações de um determinado cliente para o mesmo servidor. O exemplo a seguir configura o algoritmo de balanceamento de carga Hash para um par de servidores de autenticação RADIUS, usando como chave o endereço IP de origem (cliente), capturado pela variável $remote_addr.
upstream radius_servers {    hash $remote_addr; # Source-IP hash
    server 192.168.136.201:1812;
    server 192.168.136.202:1812;
}
Mais informações
Para mais informações sobre balanceamento de carga UDP e TCP, consulte os seguintes recursos:
- Balanceamento de carga TCP e UDP no Guia do Administrador do NGINX Plus
- NGINX Stream e contexto de configuração
upstreamconfiguration context - Guia de implantação para balanceamento de carga de servidores Microsoft® Exchange™, que precisam processar tráfego baseado em TCP e em HTTP
- Alta disponibilidade do MySQL com NGINX Plus e Galera Cluster<.htmla> (caso de uso de balanceamento de carga TCP)
Para conhecer os outros excelentes recursos do NGINX Plus R9, confira Anúncio do NGINX Plus R9 em nosso blog e assista ao nosso webinar sob demanda, Novidades do NGINX Plus R9.
Para experimentar o NGINX Plus, comece hoje mesmo sua avaliação gratuita de 30 dias ou entre em contato conosco para falar sobre seus casos de uso.
Sobre o autor

Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.