Lançamos a versão 3.0 do NGINX Ingress Controller em janeiro de 2023, com uma série de novos recursos importantes e funcionalidades aprimoradas. Um novo recurso que acreditamos que você considerará especialmente valioso é o Deep Service Insight, disponível na edição NGINX Plus do NGINX Ingress Controller.
O Deep Service Insight soluciona uma limitação que impede o funcionamento ideal quando um sistema de decisão de roteamento, como um balanceador de carga, fica à frente de um ou mais clusters do Kubernetes. Essa limitação ocorre porque o sistema não tem acesso a informações sobre a integridade dos serviços individuais executados nos clusters por trás do controlador Ingress. Isso impede que ele encaminhe o tráfego apenas para clusters com serviços íntegros, o que pode expor seus usuários a indisponibilidades e erros como 404 e 500.
O Deep Service Insight elimina esse problema ao disponibilizar o status de integridade dos pods de serviço de backend (conforme coletado pelo NGINX Ingress Controller) em um endpoint dedicado, no qual seus sistemas podem acessá-lo e utilizá-lo para tomar melhores decisões de roteamento.
Neste post, analisamos em detalhes o problema resolvido pelo Deep Service Insight, explicamos como ele funciona em alguns casos de uso comuns e mostramos como configurá-lo.
Por que usar o Deep Service Insight?
As sondagens padrão de atividade, prontidão e inicialização do Kubernetes fornecem algumas informações sobre os serviços de backend em execução nos seus clusters, mas não o suficiente para oferecer o nível de visibilidade necessário para tomar melhores decisões de roteamento em todas as camadas da sua stack. A falta das informações certas se torna ainda mais problemática à medida que suas implantações do Kubernetes ficam mais complexas e os requisitos da sua empresa para manter a disponibilidade ininterrupta se tornam mais urgentes.
Uma abordagem comum para aumentar a disponibilidade à medida que seu ambiente Kubernetes cresce é implantar balanceadores de carga, gerenciadores de DNS e outros sistemas automatizados de tomada de decisão à frente dos clusters. No entanto, devido ao funcionamento dos controladores Ingress, um balanceador de carga posicionado à frente de um cluster Kubernetes normalmente não tem acesso às informações de status dos serviços que estão por trás do controlador Ingress no cluster – ele só consegue verificar se os próprios pods do controlador Ingress estão íntegros e aceitando tráfego.
O NGINX Ingress Controller, por outro lado, tem informações sobre a integridade dos serviços. Ele já monitora a integridade dos pods upstream em um cluster por meio do envio periódico de verificações passivas de integridade para serviços HTTP, TCP, UDP e gRPC, monitorando a capacidade de resposta às solicitações e acompanhando códigos de resposta bem-sucedidos e outras métricas. Ele usa essas informações para decidir como distribuir o tráfego entre os pods dos seus serviços, proporcionando uma experiência de usuário consistente e previsível. Normalmente, o NGINX Ingress Controller realiza toda essa mágica silenciosamente em segundo plano, e talvez você nunca pare para pensar no que acontece nos bastidores. O Deep Service Insight traz essas informações valiosas à tona para que você possa usá-las com mais eficiência em outras camadas da sua stack.
Como funciona o Deep Service Insight?
O Deep Service Insight está disponível para os serviços implantados usando os recursos personalizados VirtualServer e TransportServer do NGINX (para HTTP e TCP/UDP, respectivamente). O Deep Service Insight usa a API do NGINX Plus para compartilhar a visão do NGINX Ingress Controller sobre os pods individuais de um serviço de back-end em um endpoint dedicado e exclusivo do Deep Service Insight:
- Para VirtualServer – <IP_address> :<port> /probe/<hostname>
- Para TransportServer – <IP_address> :<port> /probe/ts/<service_name>
onde
- <IP_address> pertence ao NGINX Ingress Controller
- <port> é o número da porta do Deep Service Insight (9114 por padrão)
- <hostname> é o nome de domínio do serviço, conforme definido no campo
spec.hostdo recurso VirtualServer - <service_name> é o nome do serviço conforme definido no campo
spec.upstreams.servicedo recurso TransportServer
A saída inclui dois tipos de informação:
- Um código de status HTTP para o nome do host ou do serviço:
200OK– Pelo menos um pod está íntegro418Eu souumbule de chá– Nenhum pod está íntegro404NãoEncontrado– Não há pods correspondentes ao nome do host ou ao nome do serviço especificado
- Três contadores para o nome do host ou nome do serviço especificado:
Totalde instâncias de serviço (pods)- Número de pods no estado
Up(íntegro) - Número de pods no estado
Não íntegrostate
Veja um exemplo em que todos os três pods de um serviço estão íntegros:
HTTP/1.1 200 OKContent-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":3,"Unhealthy":0}
Para mais detalhes, consulte a documentação do NGINX Ingress Controller.
Você pode personalizar ainda mais os critérios usados pelo NGINX Ingress Controller para determinar se um pod está íntegro configurando verificações de integridade ativas. É possível configurar o caminho e a porta para os quais a verificação de integridade é enviada, o número de verificações com falha que devem ocorrer em um período especificado para que um pod seja considerado não íntegro, o código de status esperado, os tempos limite para conexão ou recebimento de uma resposta, entre outras opções. Inclua o campo Upstream.Healthcheck no recurso VirtualServer ou TransportServer.
Exemplos de casos de uso para insights detalhados sobre serviços
Um caso de uso em que o Deep Service Insight é particularmente valioso ocorre quando um balanceador de carga direciona o tráfego para um serviço executado em dois clusters, por exemplo, para garantir alta disponibilidade. Em cada cluster, o NGINX Ingress Controller monitora a integridade dos pods upstream conforme descrito acima. Quando você habilita o Deep Service Insight, as informações sobre a quantidade de pods upstream íntegros e não íntegros também são disponibilizadas em um endpoint dedicado. Seu sistema de decisão de roteamento pode acessar o endpoint e usar essas informações para desviar o tráfego da aplicação dos pods não íntegros para os íntegros.
O diagrama ilustra como o Deep Service Insight funciona nesse cenário.
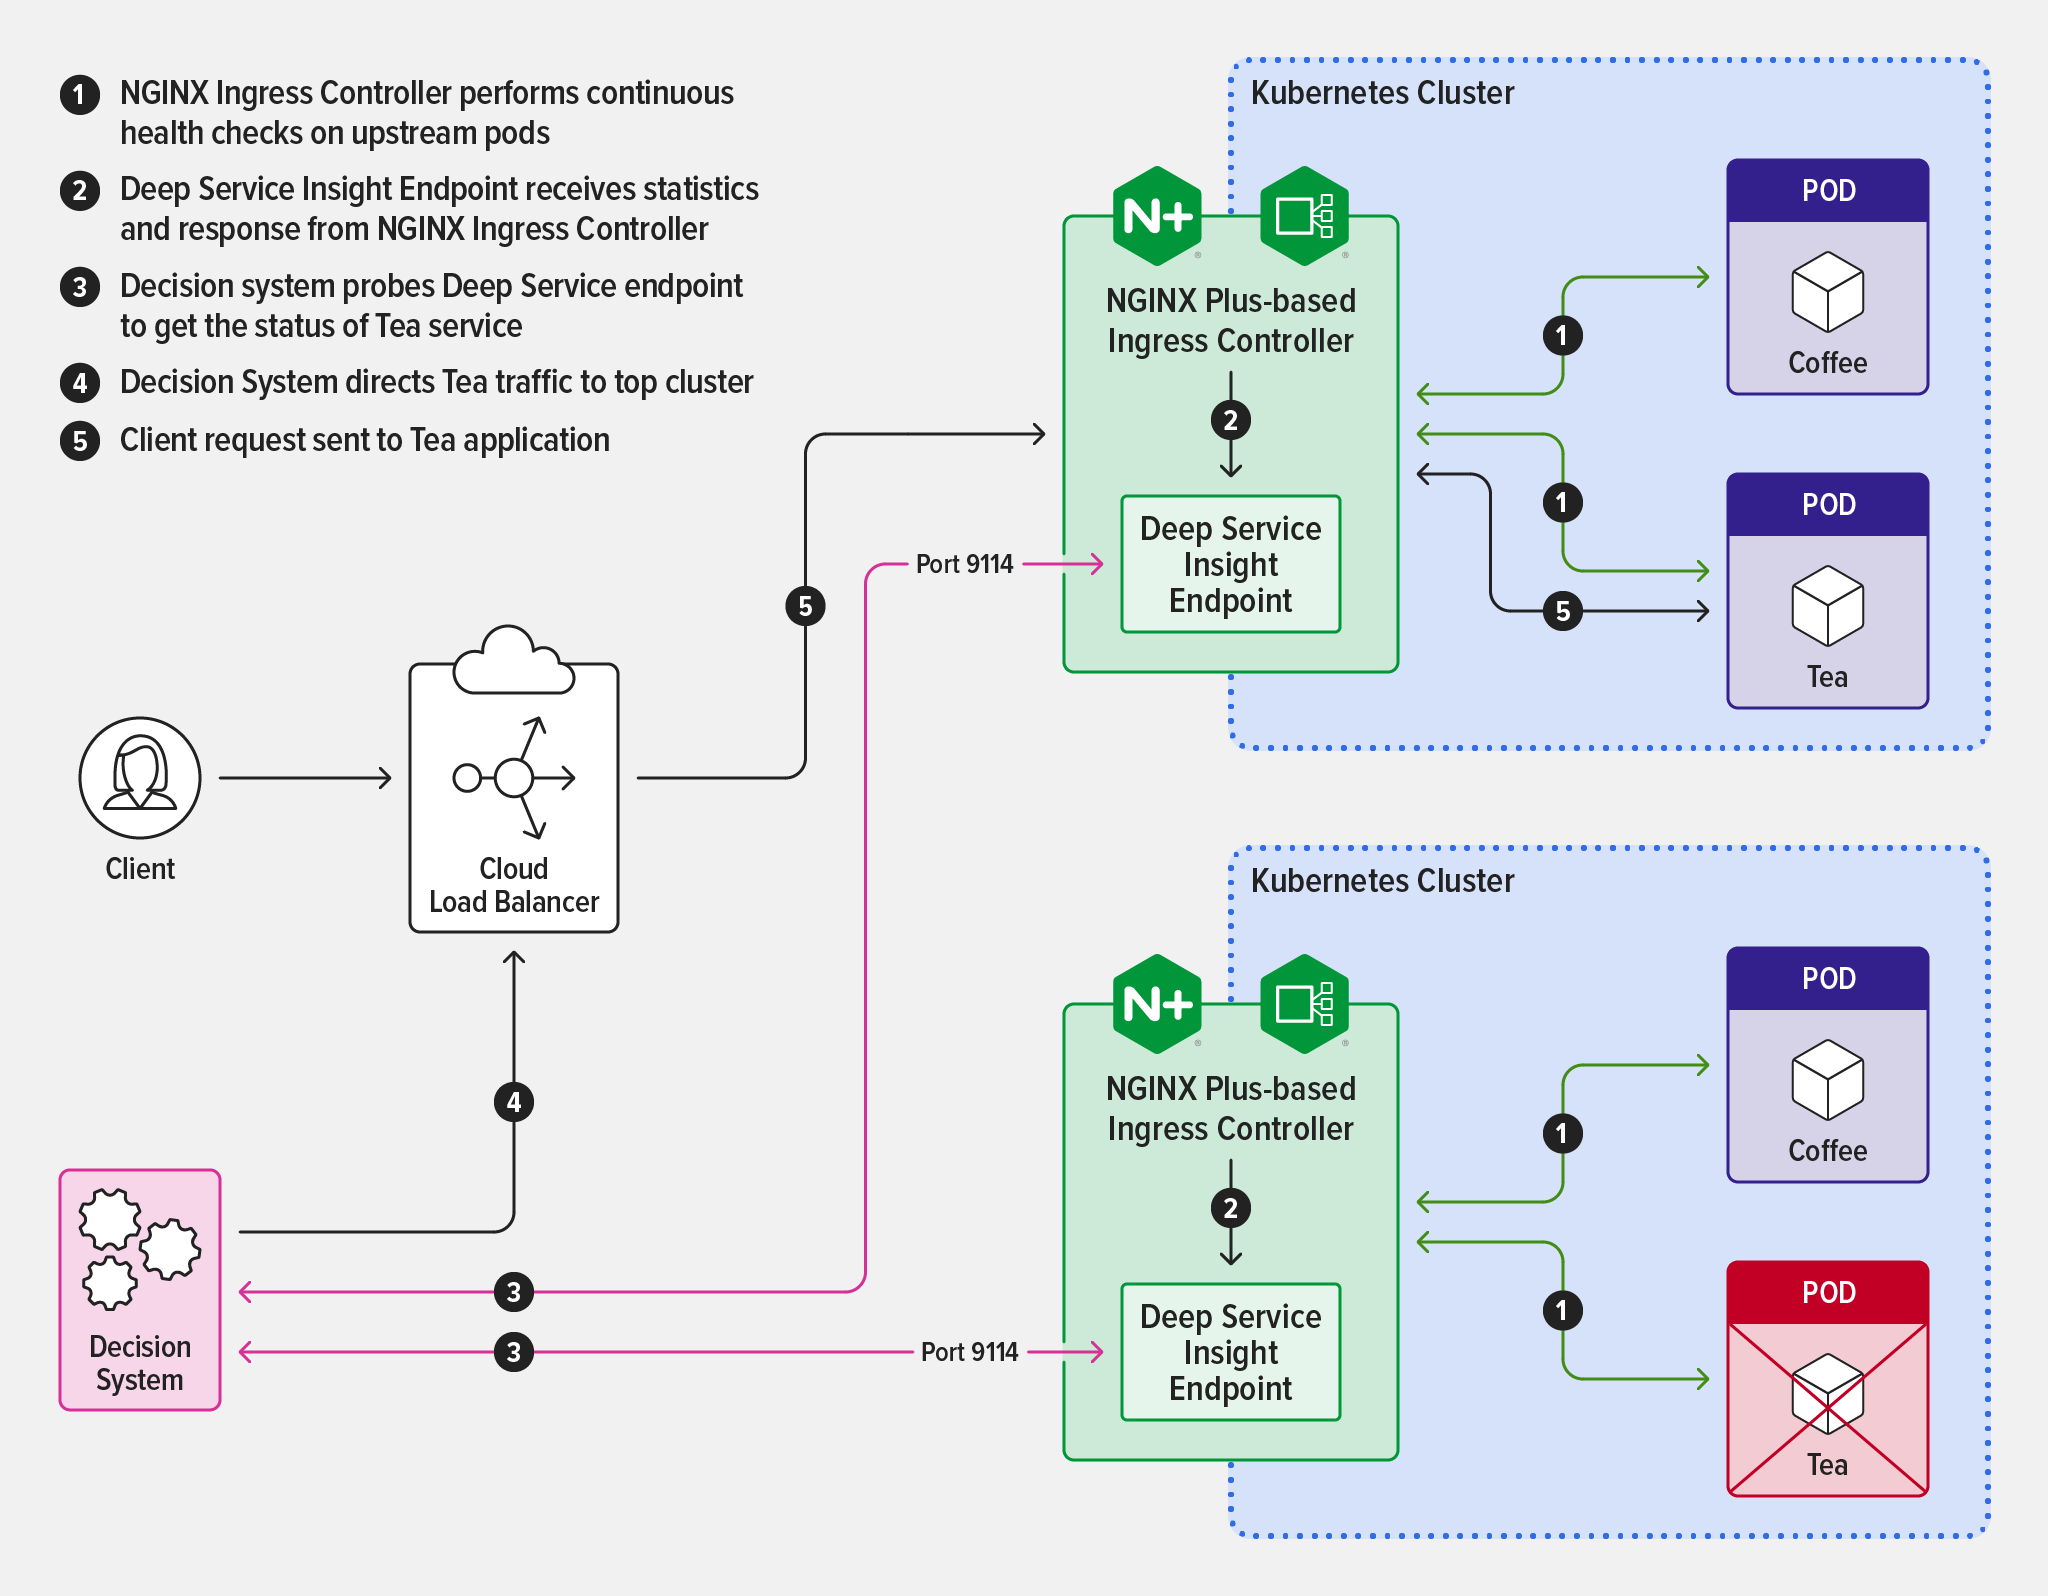
Você também pode aproveitar o Deep Service Insight ao realizar a manutenção de um cluster em um cenário de alta disponibilidade. Basta reduzir para zero o número de pods de um serviço no cluster em que a manutenção está sendo realizada. A ausência de pods íntegros é exibida automaticamente no endpoint do Deep Service Insight, e o sistema de decisão de roteamento usa essas informações para direcionar o tráfego aos pods íntegros do outro cluster. Assim, você obtém failover automático sem precisar alterar a configuração do NGINX Ingress Controller nem do sistema, e seus clientes não enfrentam nenhuma interrupção do serviço.
Habilitando o Deep Service Insight
Para habilitar o Deep Service Insight, inclua o argumento de linha de comando -enable-service-insight no manifesto do Kubernetes ou defina o parâmetro serviceInsight.create como true se estiver usando o Helm.
Há dois argumentos opcionais que você pode incluir para ajustar o endpoint ao seu ambiente:
-service-insight-listen-port<port>– Altere o número da porta do Deep Service Insight do valor padrão, 9114 (<port>é um número inteiro no intervalo de 1024 a 65535). O equivalente no Helm é o parâmetroserviceInsight.port.-service-insight-tls-string<secret>– Um segredo do Kubernetes (certificado e chave TLS) para o encerramento TLS do endpoint do Deep Service Insight (<secret>é uma cadeia de caracteres no formato<namespace>/<secret_name>). O equivalente no Helm é o parâmetroserviceInsight.secret.
Exemplo: habilitar o Deep Service Insight para o aplicativo Cafe
Para ver o Deep Service Insight em ação, você pode habilitá-lo para o aplicativo Cafe frequentemente usado como exemplo na documentação do NGINX Ingress Controller.
- Instale a edição NGINX Plus do NGINX Ingress Controller com suporte a recursos personalizados do NGINX e habilite o Deep Service Insight:
- Se estiver usando o Helm, defina o parâmetro
serviceInsight.createcomotrue. - Se estiver usando um manifesto do Kubernetes (Deployment ou DaemonSet), inclua o argumento
-enable-service-insightno arquivo de manifesto.
- Se estiver usando o Helm, defina o parâmetro
- Verifique se o NGINX Ingress Controller está em execução:
$ kubectl get pods -n nginx-ingressNAME                                          READY ...
ingress-plus-nginx-ingress-6db8dc5c6d-cb5hp   1/1   ...

    ...  STATUS   RESTARTS   AGE
... Running 0 9d- Implante a aplicação Cafe de acordo com as instruções no README.
- Verifique se o recurso personalizado VirtualServer do NGINX está implantado para a aplicação Cafe (o endereço IP foi omitido para facilitar a leitura):
$ kubectl get vs NAME   STATE   HOST               IP    PORTS      AGE
cafe Valid cafe.example.com ... [80,443] 7h1m- Verifique se há três pods upstream para o serviço Cafe em execução em cafe.example.com:
$ kubectl get pods NAME                     READY   STATUS    RESTARTS   AGE
coffee-87cf76b96-5b85h   1/1     Running   0          7h39m
coffee-87cf76b96-lqjrp   1/1     Running   0          7h39m
tea-55bc9d5586-9z26v 1/1 Running 0 111m- Acesse o endpoint do Deep Service Insight:
$ curl -i <NIC_IP_address>:9114/probe/cafe.example.com- O código de resposta
200OKindica que o serviço está pronto para receber tráfego (pelo menos um pod está íntegro). Nesse caso, todos os três pods estão no estado Up.
HTTP/1.1 200 OK
Content-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":3,"Unhealthy":0}- O código de status
418I’mateapotindica que o serviço está indisponível (todos os pods estão com problemas de integridade).
HTTP/1.1 418 I'm a teapotContent-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":0,"Unhealthy":3}- O código de status
404NotFoundindica que não há nenhum serviço em execução no nome de host especificado.
HTTP/1.1 404 Not FoundDate: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 0
Recursos
Para ver o changelog completo da versão 3.0.0 do NGINX Ingress Controller, consulte as Notas de versão.
Para experimentar o NGINX Ingress Controller com o NGINX Plus e o NGINX App Protect, comece sua avaliação gratuita de 30 dias hoje mesmo ou entre em contato conosco para conversar sobre seus casos de uso.
Sobre o autor

Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.