Nota do autor – Este post é o sexto de uma série:
- Apresentando a arquitetura de referência de microsserviços da NGINX
- MRA, Parte 2: O modelo de proxy
- MRA, Parte 3: O modelo de malha de roteadores
- MRA, Parte 4: O Modelo de Fabric
- MRA, Parte 5: Adaptando o aplicativo de doze fatores para microsserviços
- MRA, Parte 6: Implementando o padrão Circuit Breaker com o NGINX Plus (este post)
Todos os seis posts, além de um post sobre front-ends web para aplicações de microsserviços<.htmla>, foram reunidos em um e-book gratuito.
Confira também estes outros recursos da NGINX sobre microsserviços:
- Uma série muito útil e popular de Chris Richardson sobre design de aplicações de microsserviços
- Os artigos de Chris Richardson reunidos em um e-book gratuito, com dicas adicionais sobre a implementação de microsserviços com o NGINX e o NGINX Plus
- Outras publicações de blog sobre microsserviços
- Webinars sobre microsserviços
O design de aplicações de microsserviços provocou uma mudança radical na forma como as aplicações funcionam. Em uma arquitetura de microsserviços, uma “aplicação” passa a ser uma coleção de serviços que dependem uns dos outros para executar tarefas e oferecer funcionalidades. Em aplicações complexas, o grafo de serviços pode ser bastante profundo e apresentar diversas interdependências entre os vários serviços.
Por exemplo, um serviço de usuários pode ser essencial para muitos outros serviços que dependem dos dados fornecidos por ele. Nesse cenário, uma falha no serviço de usuários pode causar uma cascata de falhas em toda a aplicação.
O padrão Circuit Breaker — termo popularizado por Martin Fowler — vem ganhando espaço entre arquitetos de microsserviços como um padrão de projeto de aplicações para evitar falhas em cascata nos serviços. A ideia do padrão Circuit Breaker é monitorar os serviços da sua aplicação e o tráfego entre eles para prevenir falhas e, quando elas ocorrerem, minimizar seu impacto nas aplicações.
Para microsserviços, o padrão Circuit Breaker é especialmente valioso, pois proporciona resiliência de baixo para cima. Quando implementado corretamente, ele pode ajudar a evitar falhas em cascata, garantindo a continuidade do serviço mesmo quando alguns serviços estão indisponíveis. O padrão Circuit Breaker foi adotado de forma mais notória pela Netflix como um componente essencial de sua filosofia de design de aplicações.
Não evite as falhas, aceite-as
Um princípio fundamental do design de aplicações modernas é que falhas ocorrerão. A arquitetura em camadas da qual as aplicações modernas dependem — desde máquinas virtuais hospedadas na nuvem até contêineres, bibliotecas de aplicações e redes dinâmicas — faz com que qualquer aplicação tenha uma infinidade de componentes em constante movimento. É preciso partir do pressuposto de que uma ou mais partes da aplicação falharão de alguma forma em algum momento. Prever falhas e incorporar mecanismos para mitigar seus efeitos contribui muito para tornar a aplicação mais resiliente.
Um dos objetivos mais importantes do padrão circuit breaker é, antes de tudo, tentar evitar falhas. Em alguns tipos de condição de erro, como a falta de memória, é possível reconhecer que uma falha é iminente e tomar medidas para evitá-la. Normalmente, isso é feito quando o serviço sinaliza que não está íntegro, e o circuit breaker dá a ele a oportunidade de se recuperar, reduzindo o número de solicitações ou redirecionando-as por completo. Depois que o serviço se recupera, também é prudente que o circuit breaker aumente gradualmente o número de solicitações enviadas a ele, para não sobrecarregá-lo de imediato e correr o risco de deixá-lo sem integridade novamente.
Na Arquitetura de Referência de Microsserviços da NGINX, temos um serviço chamado redimensionador. Quando uma foto grande é carregada no sistema, o redimensionador a descompacta, corrige sua rotação, reduz seu tamanho e depois o reduz novamente, salvando a imagem original corrigida e as duas imagens redimensionadas em um armazenamento de objetos. Devido à natureza desses processos, o redimensionador é a parte da aplicação que mais consome recursos de processamento e memória.
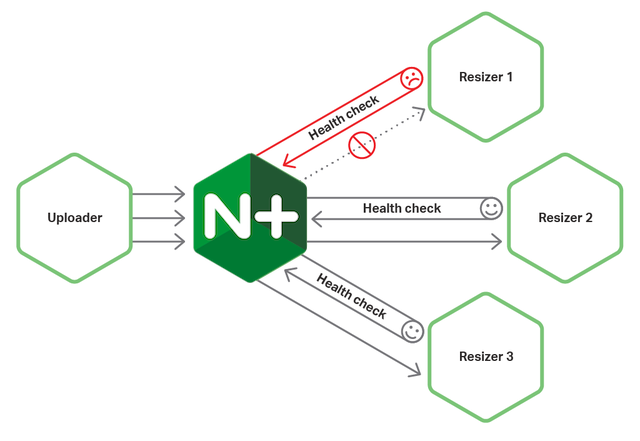
Quando muitas imagens estão sendo redimensionadas simultaneamente, o resizer pode ficar sem memória e, em alguns cenários, falhar completamente. Para evitar problemas, colocamos um circuit breaker entre as instâncias do serviço resizer e o serviço uploader que envia imagens a elas. O uploader consulta regularmente o status de integridade das instâncias do resizer. A consulta faz com que o resizer avalie, entre outras verificações de integridade, se utilizou mais de 80% da memória disponível e responda ao uploader com seu status de integridade.
Se uma instância do redimensionador indicar que não está íntegra, o uploader encaminhará as solicitações para outras instâncias – conforme mostrado na Figura 1 –, mas continuará verificando se essa instância do redimensionador se recuperou. Quando a instância do redimensionador indicar que está íntegra novamente, ela será reinserida no pool com balanceamento de carga, e o uploader aumentará gradualmente o tráfego até atingir a capacidade total da instância. Esse design evita que as instâncias do redimensionador falhem completamente, que tarefas sejam iniciadas, mas não concluídas, e que usuários cujos processos falhariam tenham de esperar excessivamente, além de ajudar o sistema a lidar da maneira mais eficiente possível com o fluxo de solicitações recebido.
O padrão Circuit Breaker melhora a consistência
Um dos benefícios de implementar o circuit breaker no nível do NGINX é a criação de uma camada universal, consistente e altamente flexível para gerenciar circuit breakers em toda a sua aplicação de microsserviços. Essa universalidade e consistência significam que você não precisa gerenciar nem contornar as particularidades e inconsistências das bibliotecas de circuit breaker de cada linguagem.
Você obtém muitas vantagens ao manter a maior parte da funcionalidade do circuit breaker fora do código de cada serviço e implementá-la no NGINX Plus:
- O circuit breaker de um serviço escrito, por exemplo, em Java é o mesmo de um serviço escrito em PHP – e o próprio circuit breaker pode ser escrito em outra linguagem, conforme necessário
- Você evita ter que reimplementar a funcionalidade de circuit breaker para as diversas linguagens e bibliotecas de suporte usadas por cada um dos seus serviços
- Cada serviço que não precisa incluir o código do circuit breaker torna-se mais simples; ele é executado com mais rapidez e é mais fácil de desenvolver, depurar, executar e manter
- O código de suporte de cada serviço é simplificado; o conjunto de bibliotecas e sistemas utilizados pode refletir apenas a funcionalidade principal do serviço
- O código do circuit breaker é simplificado; como existe em apenas um lugar, ele pode ser reduzido ao essencial, sem a necessidade de se adaptar a contextos locais
- O código do circuit breaker pode aproveitar recursos do NGINX Plus, como o armazenamento em cache, tornando-o muito mais poderoso
- Você pode ajustar com precisão o código do disjuntor no nível do NGINX Plus e reutilizá-lo em outros aplicativos e em diferentes plataformas de implantação, como ambientes locais, diferentes plataformas de nuvem e ambientes híbridos
No entanto, é importante observar que os circuit breakers não podem ser implementados apenas no NGINX Plus. Um verdadeiro circuit breaker exige que o serviço forneça uma verificação de integridade ativa e introspectiva em um URI designado (normalmente /health). A verificação de integridade deve ser adequada às necessidades específicas desse serviço.
Ao desenvolver a verificação de integridade, é necessário compreender o perfil de falhas do serviço e os tipos de condições que podem causar falhas, como uma falha na conexão com o banco de dados, falta de memória, falta de espaço em disco ou sobrecarga da CPU. Essas condições são avaliadas durante o processo de verificação de integridade, que então fornece um status binário indicando se o serviço está íntegro ou não.
O padrão Circuit Breaker oferece flexibilidade
Ao implementar o padrão circuit breaker no nível do NGINX, conforme descrito aqui, cabe ao NGINX Plus lidar com a situação em que uma instância de serviço informa que não está íntegra. Há várias opções.
A primeira opção é redirecionar as solicitações para outras instâncias íntegras e continuar consultando a instância com problemas para verificar se ela se recupera. A segunda opção é fornecer respostas armazenadas em cache aos clientes que solicitam o serviço, mantendo a estabilidade mesmo que o serviço esteja indisponível. Essa solução funciona bem com serviços voltados para leitura, como um serviço de conteúdo.
Outra opção é fornecer fontes de dados alternativas. Por exemplo, um de nossos clientes tem um servidor de anúncios personalizados que usa dados de perfil para exibir anúncios direcionados aos usuários. Se esse servidor estiver fora do ar, a solicitação do usuário será redirecionada para um servidor de backup que fornece um conjunto genérico de anúncios adequado a todos. Essa abordagem de usar uma fonte de dados alternativa pode ser bastante eficaz.
Por fim, se você tiver uma compreensão muito clara do perfil de falhas de um serviço, poderá mitigar falhas adicionando limitação de taxa ao circuit breaker. As solicitações só são encaminhadas ao serviço na taxa que ele consegue processar. Isso cria um buffer no circuit breaker, permitindo que ele absorva picos de tráfego.
A limitação de taxa pode ser particularmente eficaz em um cenário de balanceamento de carga centralizado, como o Modelo de Malha de Roteadores, no qual o tráfego das aplicações é encaminhado por um número limitado de balanceadores de carga, que podem ter uma boa compreensão do uso total do tráfego em todo o site.
Implementando o padrão Circuit Breaker no NGINX Plus
Como descrevemos acima, o padrão circuit breaker pode evitar uma falha antes que ela ocorra, reduzindo o tráfego para um serviço com problemas ou desviando as solicitações dele. Isso requer uma verificação de integridade ativa conectada a um monitor de integridade introspectivo em cada serviço. Infelizmente, uma verificação de integridade passiva não é suficiente, pois ela só detecta a falha — e, nesse ponto, já é tarde demais para tomar medidas preventivas. É por esse motivo que o NGINX Open Source não pode implementar o padrão circuit breaker — ele oferece suporte apenas a verificações de integridade passivas.
O NGINX Plus, no entanto, conta com um sistema robusto de verificações ativas de integridade, com diversas opções para detectar e responder a problemas de integridade. A análise da implementação de alguns dos tipos de serviço da Arquitetura de Referência de Microsserviços fornece bons exemplos das opções e dos casos de uso para implementar o circuit breaker.
Vamos começar com o serviço de upload que se conecta ao redimensionador. O serviço de upload coloca as imagens em um armazenamento de objetos e, em seguida, instrui o redimensionador a abrir uma imagem, corrigi-la e redimensioná-la. Essa operação exige muito processamento e memória. O serviço de upload precisa monitorar a integridade do redimensionador e evitar sobrecarregá-lo, pois ele pode literalmente derrubar o host em que está sendo executado.
A primeira coisa a fazer é criar um bloco location especificamente para a verificação de integridade do redimensionador. Esse bloco é um local internal, o que significa que ele não pode ser acessado por meio de uma solicitação à URL padrão do servidor (http://example.com/health-check-resizer). Em vez disso, ele funciona como um espaço reservado para as informações da verificação de integridade. A diretiva health_check envia uma verificação de integridade ao URI /health a cada três segundos e usa os testes definidos no bloco match chamado conditions para verificar a integridade da instância do serviço. Uma instância do serviço é marcada como não íntegra quando falha em uma única verificação. As diretivas proxy_* enviam a verificação de integridade ao grupo upstream resizer, usando TLS 1.2 sobre HTTP 1.1, com os cabeçalhos HTTP indicados definidos como nulos.
location /health-check-resizer {    internal;
    health_check uri=/health match=conditions fails=1 interval=3s;


    proxy_pass                        https://resizer;
    proxy_ssl_session_reuse           on;
    proxy_ssl_protocols               TLSv1.2;
    proxy_http_version                1.1;
    proxy_set_header Connection       "";
    proxy_set_header Accept-Encoding  "";
}
A próxima etapa é criar o bloco conditions match para especificar as respostas que representam condições íntegras e não íntegras. A primeira verificação é do código de status da resposta: se ele estiver no intervalo de 200 a 399, o teste prosseguirá para a próxima instrução de avaliação. A segunda verificação confirma se o Content-Type é application/json. Por fim, a terceira verificação faz a correspondência de uma expressão regular com o valor das métricas deadlocks, Disk e Memory. Se todas estiverem íntegras, o serviço será considerado íntegro.
match conditions {    status 200-399;
    header Content-Type ~ "application/json";
    body ~ '{
        "deadlocks":{"healthy":true},
        "Disk":{"healthy":true},
        "Memory":{"healthy":true}
    }';
}
O sistema de circuit breaker/verificação de integridade do NGINX Plus também conta com um recurso de inicialização lenta. O parâmetro slow_start da diretiva server para o serviço de redimensionamento no bloco upstream instrui o NGINX Plus a moderar o fluxo de tráfego quando uma instância do serviço de redimensionamento se recupera de um estado não íntegro. Em vez de simplesmente sobrecarregar o serviço com a mesma quantidade de solicitações enviadas aos serviços íntegros, o tráfego para o serviço em recuperação aumenta gradualmente até atingir a taxa normal durante o período indicado pelo parâmetro slow_start — neste caso, 30 segundos. A inicialização lenta aumenta as chances de o serviço recuperar sua capacidade total e, ao mesmo tempo, reduz o impacto caso isso não aconteça.
upstream resizer {    server        resizer slow_start=30s;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}
A limitação de requisições gerencia e modera o fluxo de requisições para o serviço. Se você compreender o perfil de falhas da aplicação suficientemente bem para saber quantas requisições ela pode processar a qualquer momento, implementar a limitação de requisições pode ser muito benéfico para o processo. No entanto, esse recurso só funciona se o NGINX Plus tiver conhecimento completo do número total de conexões encaminhadas ao serviço. Por isso, é mais útil implementar o circuit breaker de limitação de requisições em uma instância do NGINX Plus executada em um contêiner com o próprio serviço, como no Modelo de Malha, ou em um balanceador de carga centralizado responsável por gerenciar todo o tráfego de um cluster.
O trecho de código de configuração a seguir define um limite de taxa de solicitações a ser aplicado às instâncias do serviço de redimensionamento em seus contêineres. A diretiva limit_req_zone define o limite de taxa em 100 solicitações por segundo. A variável $server_addr é usada como chave, o que significa que todas as solicitações recebidas pelo contêiner do serviço de redimensionamento são contabilizadas nesse limite. O nome da zona é moderateReqs e o período de retenção da contagem de solicitações é de 1 minuto. A diretiva limit_req permite que o NGINX Plus armazene em buffer picos de até 150 solicitações. Quando esse número é excedido, os clientes recebem o código de erro 503 conforme especificado pela diretiva limit_req_status, indicando que o serviço está indisponível.
http {    # Moderated delivery
    limit_req_zone $server_addr zone=moderateReqs:1m rate=100r/s;
    # ...
    server {
        # ...
        limit_req zone=moderateReqs burst=150;
        limit_req_status 503;
        # ...
    }
}
Outro grande benefício de executar o circuit breaker no NGINX Plus é a possibilidade de incorporar cache e manter os dados em cache de forma centralizada, para uso em todo o sistema. Isso é particularmente valioso para serviços voltados à leitura, como servidores de conteúdo, nos quais os dados lidos do backend não mudam com frequência.
proxy_cache_path /app/cache levels=1:2 keys_zone=oauth_cache:10m max_size=10m inactive=15s use_temp_path=off;
upstream user-manager {
    server        user-manager;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}

server {
    listen 443 ssl;
    location /v1/users {
        proxy_pass http://user-manager;
        proxy_cache            oauth_cache;
        proxy_cache_valid      200  30s;
        proxy_cache_use_stale  error timeout invalid_header updating
                               http_500 http_502 http_503 http_504;
    }
}
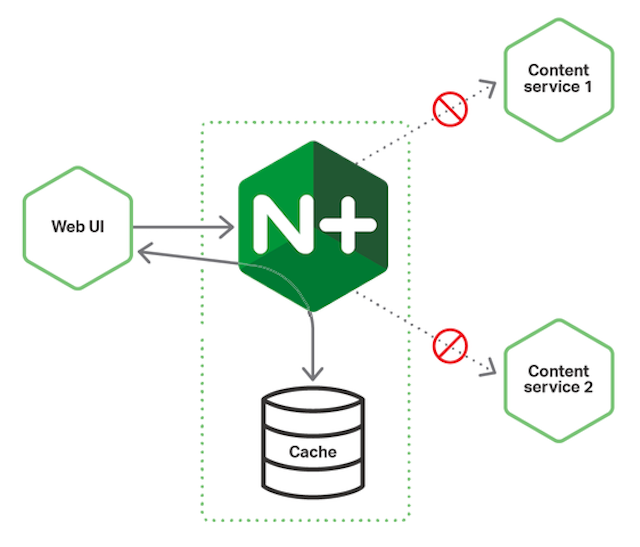
Como mostrado na Figura 2, o armazenamento de dados em cache faz com que muitas solicitações de dados de clientes nunca cheguem às instâncias do microsserviço, liberando capacidade para solicitações que ainda não haviam sido recebidas.
No entanto, em um serviço no qual os dados podem mudar, como um serviço de gerenciamento de usuários, o cache precisa ser administrado com cautela. Caso contrário, pode ocorrer uma situação em que um usuário altera o próprio perfil, mas vê dados antigos em alguns contextos porque eles estão armazenados em cache. Um tempo limite razoável e a adoção do princípio de alta disponibilidade com consistência eventual podem resolver esse impasse.
Um dos recursos interessantes do cache do NGINX é que ele pode continuar fornecendo dados armazenados em cache mesmo que o serviço esteja completamente indisponível – no trecho acima, caso o serviço esteja respondendo com um dos quatro códigos de erro mais comuns da série 500.
O cache não é a única opção para responder aos clientes mesmo quando um servidor está fora do ar. Como mencionamos em O padrão Circuit Breaker proporciona flexibilidade, um de nossos clientes precisava de uma solução resiliente para o caso de seu servidor de anúncios personalizados ficar fora do ar, e as respostas armazenadas em cache não eram uma boa solução. Em vez disso, ele queria que um servidor de anúncios genéricos fornecesse anúncios genéricos até que o servidor personalizado voltasse a ficar online. Isso é facilmente obtido usando o parâmetro backup na diretiva server. O trecho a seguir especifica que, quando todos os servidores definidos para o domínio personal-ad-server estiverem indisponíveis, os servidores definidos para o domínio generic-ad-server serão usados em seu lugar.
upstream personal-ad-server {    server        personal-ad-server;
    server        generic-ad-server backup;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}
E, por fim, é possível fazer com que o NGINX avalie os códigos de resposta de um serviço e trate cada um deles individualmente. No trecho a seguir, se um serviço retornar um erro 503, o NGINX Plus encaminhará a solicitação para um serviço alternativo. Por exemplo, se o redimensionador tiver esse recurso e a instância local estiver sobrecarregada ou parar de funcionar, as solicitações serão enviadas para outra instância do redimensionador.
location / {    error_page 503 = @fallback;
}

location @fallback {
    proxy_pass http://alternative-backend;
}
Conclusão
O padrão circuit breaker é uma ferramenta poderosa para proporcionar resiliência e controle à sua aplicação de microsserviços. O NGINX Plus oferece diversos recursos e opções para implementar o circuit breaker em seu ambiente. O segredo para implementar esse padrão é compreender o perfil de falhas do serviço que você está protegendo e, em seguida, escolher as opções que melhor previnam falhas, quando possível, e que melhor reduzam seus efeitos quando elas ocorrerem.
Para experimentar o NGINX Plus, comece hoje mesmo sua avaliação gratuita de 30 dias ou entre em contato conosco para falar sobre seus casos de uso.
Sobre o autor
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.