O tempo de inatividade pode levar a consequências graves.
Essas palavras são mais verdadeiras para empresas do setor de tecnologia médica do que para as da maioria dos outros setores — no caso delas, as “consequências graves” podem literalmente incluir a morte. Recentemente, tivemos a oportunidade de analisar em detalhes a infraestrutura tecnológica de uma empresa que busca transformar a manutenção de prontuários médicos, substituindo o papel e a caneta por dados digitais seguros, acessíveis a qualquer hora e em qualquer lugar do mundo. Esses dados abrangem desde informações de pacientes até diretrizes de cuidados, marcadores biológicos, análises médicas, registros históricos e tudo o mais que é compartilhado entre as equipes de saúde.
Desde o início, a empresa buscou responder a uma pergunta aparentemente simples: “Como podemos ajudar os profissionais de saúde a registrar dados em tempo real com facilidade?” No entanto, à medida que a empresa cresceu, a necessidade de ampliar a escala e manter os dados constantemente disponíveis tornou a solução desse desafio cada vez mais complexa. Aqui, descrevemos como a jornada tecnológica da empresa a levou a adotar o Kubernetes e o NGINX Ingress Controller.
Visão geral da stack de tecnologia
- SO – Linux
- Orquestração de contêineres – Serviço de Kubernetes do Microsoft Azure
- Rede – Kubernetes, NGINX Ingress Controller baseado no NGINX Plus
- Linguagem/framework de desenvolvimento de software – .Net
- Monitoramento, observabilidade e alertas – Prometheus
- Painel de monitoramento – Grafana
- Registro de logs – Grafana Loki
- Banco de dados – Serviço SQL do Azure
- Servidor de aplicações – Azure App Service, .NET
- Mensageria e streaming – Azure Event Hubs
- Cache – Redis
- Segurança – NGINX App Protect
- Localização e infraestrutura – Duas zonas de disponibilidade, 2 clusters Kubernetes, 15–20 nós, 60–100 pods
- DevOps – Azure DevOps Services
Veja onde o NGINX se encaixa na arquitetura deles:
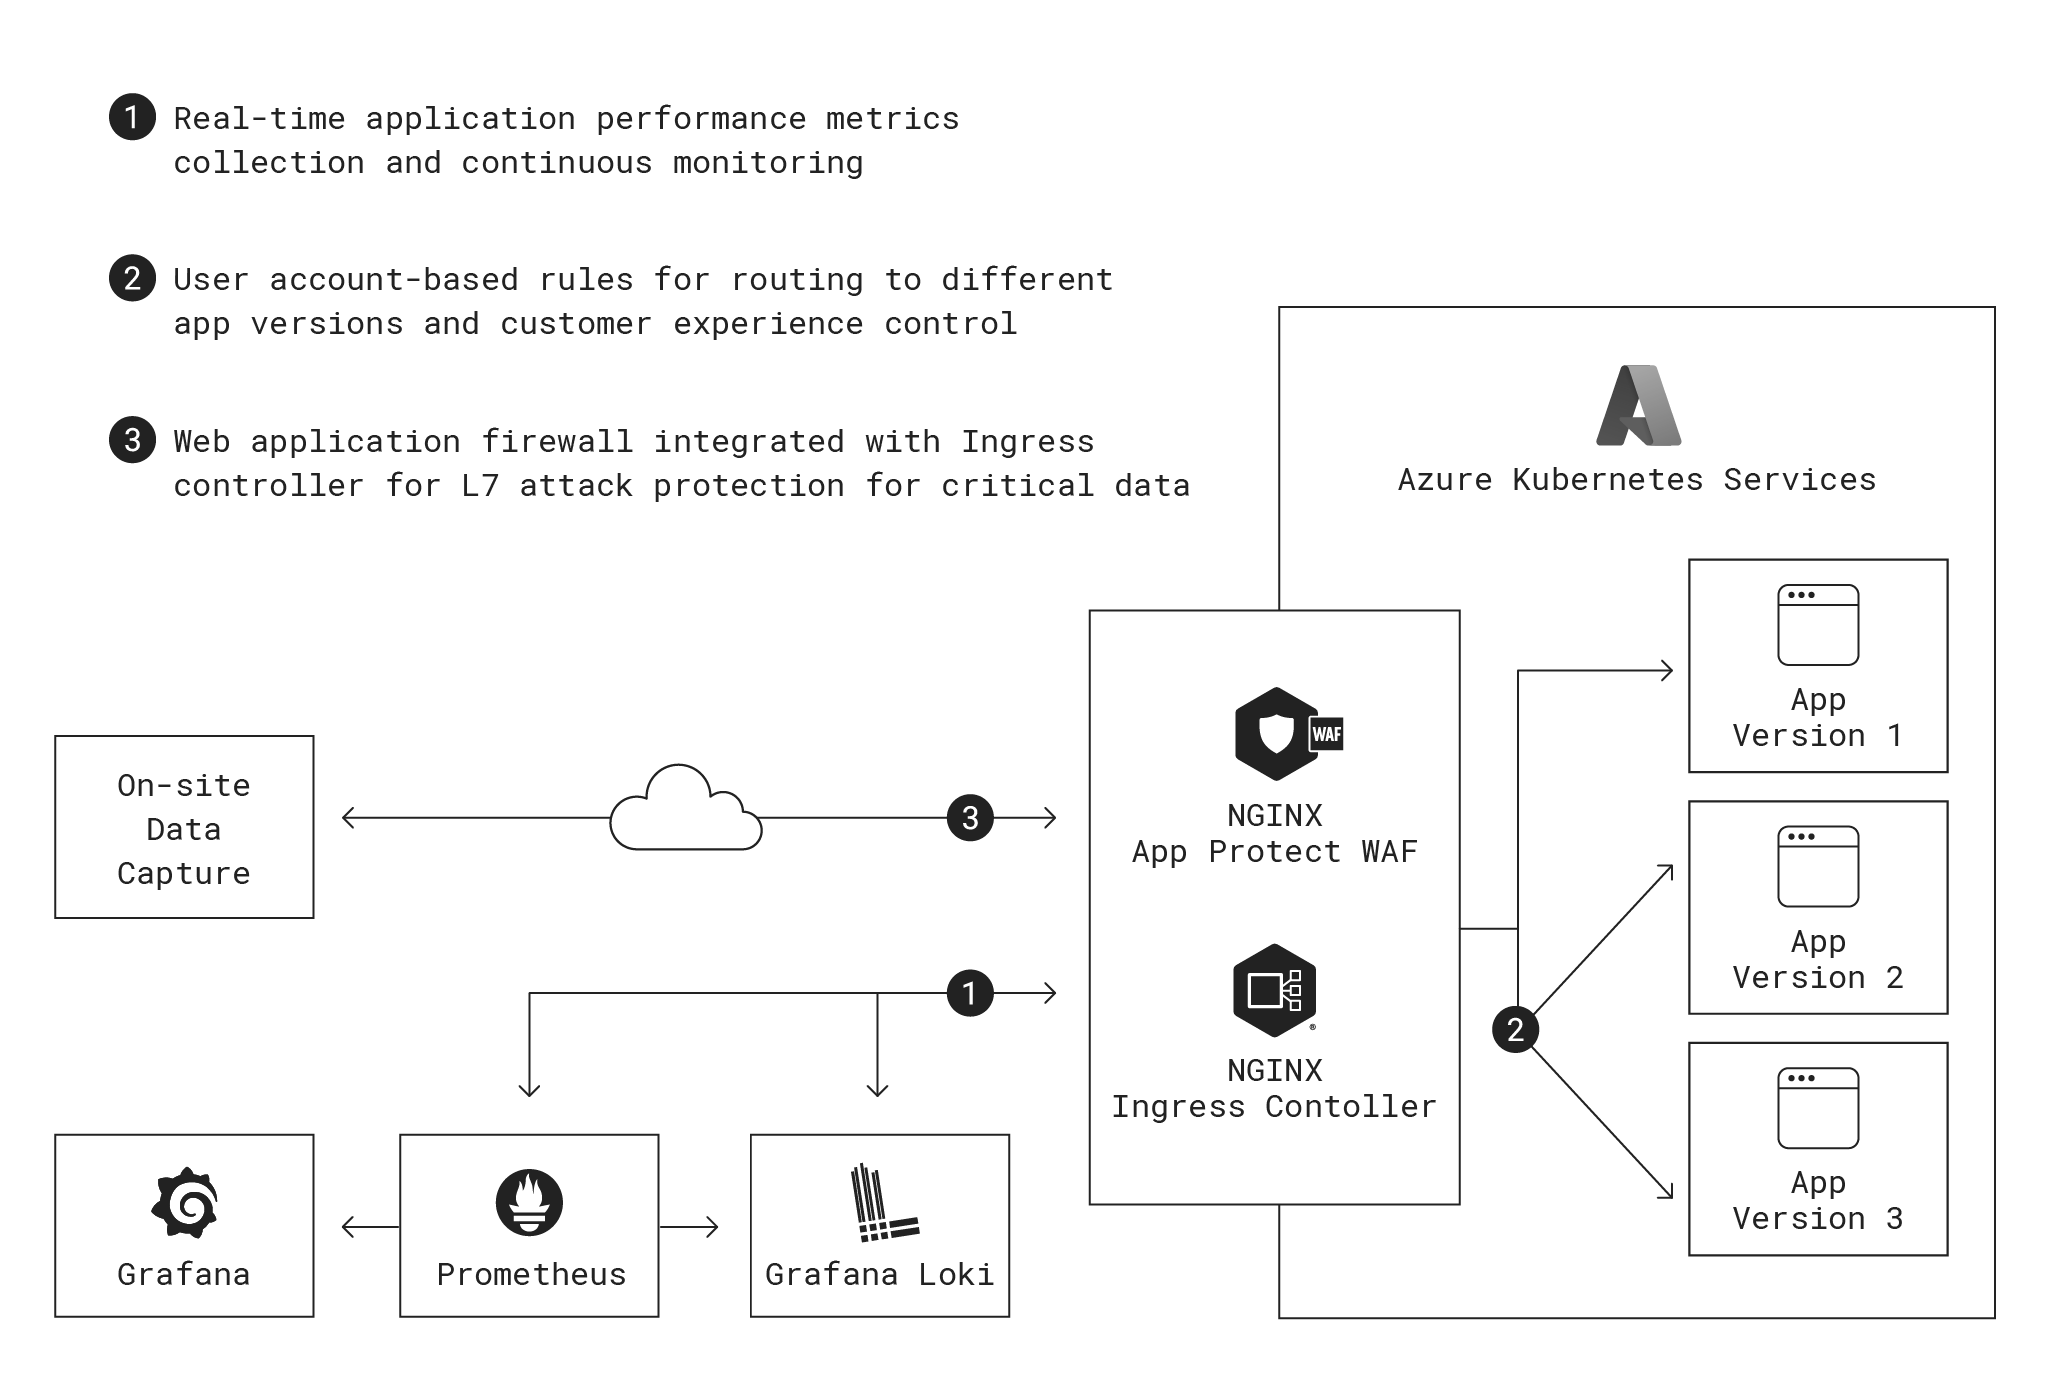
O problema do papel
Registrar regularmente o estado do paciente e as informações sobre os cuidados prestados é uma das principais atribuições dos profissionais de saúde. Tradicionalmente, essas informações eram registradas em papel ou, mais recentemente, em notebooks ou tablets. No entanto, há algumas desvantagens importantes:
- Os profissionais de saúde podem atender dezenas de pacientes por dia, por isso geralmente não é viável fazer anotações detalhadas durante o atendimento. Como resultado, eles acabam registrando suas observações ao final do turno. Nesse momento, o cansaço físico e mental pode levá-los a registrar apenas comentários genéricos.
- Os profissionais também precisam confiar na memória para se lembrar de detalhes sobre o comportamento dos pacientes. Imprecisões podem ocultar padrões que, se documentados de forma correta e consistente ao longo do tempo, poderiam facilitar o diagnóstico de problemas de saúde mais graves.
- Os registros em papel não podem ser facilmente compartilhados entre os setores de um mesmo departamento, muito menos com outras entidades, como equipes de emergência médica, profissionais de pronto-socorro e seguradoras. A situação não melhora muito com laptops ou tablets se eles não estiverem conectados a um repositório central de dados ou à nuvem.
Para enfrentar esses desafios, a empresa criou um sistema simplificado de registro de dados que oferece atalhos para acessar informações dos pacientes e registrar eventos comuns, como a administração de medicamentos. Essa facilidade de acesso e uso permite registrar as interações com os pacientes em tempo real, à medida que acontecem.
Todos os dados são armazenados em sistemas de nuvem mantidos pela empresa, e o aplicativo se integra a outros sistemas de prontuários médicos eletrônicos para oferecer uma visão longitudinal abrangente dos comportamentos dos residentes. Isso ajuda os cuidadores a garantir uma melhor continuidade do atendimento, cria um histórico seguro e permite que os dados sejam facilmente compartilhados com outros sistemas de software de saúde.
Médicos e outros especialistas também usam a plataforma ao admitir pacientes ou interagir com eles de outras formas. Há um registro de preferências e necessidades pessoais que acompanha o paciente a qualquer unidade de saúde. Essas informações podem ser usadas para ajudar os pacientes a se sentirem confortáveis em um novo ambiente, melhorando resultados como o tempo de recuperação.
Há requisitos legais rigorosos que determinam por quanto tempo as empresas devem armazenar os dados dos pacientes. Os desenvolvedores da empresa criaram o software para oferecer altíssima disponibilidade, com SLAs de tempo de atividade muito superiores aos de aplicações genéricas em nuvem. Deixar uma ambulância esperando porque o prontuário de um paciente não carrega não é uma opção.
A jornada da garagem à nuvem e ao Kubernetes
Como muitas startups, a empresa inicialmente economizou ao executar a primeira aplicação de prova de conceito em um servidor na casa de um dos cofundadores. Quando ficou claro que a ideia tinha potencial, a empresa migrou sua infraestrutura para a nuvem, em vez de gerenciar hardware em um data center. Como utilizava tecnologias da Microsoft, escolheu o Azure. A arquitetura inicial executava as aplicações em máquinas virtuais (VMs) tradicionais no Azure App Service, um serviço gerenciado de entrega de aplicações que utiliza o servidor Web IIS da Microsoft. Para armazenar e recuperar dados, a empresa optou por usar o SQL Server da Microsoft, executado em uma VM como uma aplicação gerenciada.
Após vários anos operando na nuvem, a empresa crescia rapidamente e enfrentava dificuldades de escalabilidade. Ela precisava ter capacidade de escalar indefinidamente e de forma horizontal, em vez de vertical, pois esta última é lenta e cara com máquinas virtuais (VMs). Esse requisito levou naturalmente à conteinerização e ao Kubernetes como uma possível solução. Outro ponto a favor da conteinerização era a necessidade de os desenvolvedores da empresa lançarem atualizações frequentes para a aplicação e a infraestrutura, sem correr o risco de causar indisponibilidade. Como anotações de pacientes são adicionadas constantemente em vários fusos horários, não há um período natural de inatividade para implantar alterações em produção sem o risco de os clientes serem imediatamente afetados por falhas.
Um ponto de partida lógico para a empresa foi a oferta de Kubernetes gerenciado da Microsoft, o Azure Kubernetes Services (AKS). A equipe pesquisou as práticas recomendadas do Kubernetes e percebeu que precisava de um controlador de Ingress operando à frente de seus clusters do Kubernetes para gerenciar com eficiência o tráfego e as aplicações executadas em nós e pods no AKS.
O roteamento de tráfego deve ser flexível, mas preciso
A equipe testou o controlador Ingress padrão do AKS, mas constatou que seus recursos de roteamento de tráfego simplesmente não conseguiam disponibilizar as atualizações aos clientes da empresa da maneira necessária. Quando se trata do atendimento a pacientes, não há espaço para ambiguidades ou informações conflitantes — é inaceitável, por exemplo, que um profissional de saúde veja um alerta laranja e outro veja um alerta vermelho para o mesmo evento. Portanto, todos os usuários de uma determinada organização devem usar a mesma versão do aplicativo. Isso representa um grande desafio na hora de fazer atualizações. Não há um momento ideal para migrar um cliente para uma nova versão, por isso a empresa precisava de uma forma de usar regras nos níveis de servidor e rede para direcionar diferentes clientes a diferentes versões do aplicativo.
Para isso, a empresa utiliza a mesma plataforma de backend para todos os usuários de uma organização e não oferece multilocação com segmentação na camada de infraestrutura dentro da organização. Com o Kubernetes, é possível dividir o tráfego usando rotas de rede virtual e cookies nos navegadores, além de regras detalhadas de tráfego. No entanto, a equipe técnica da empresa constatou que o controlador de Ingress padrão do AKS só consegue dividir o tráfego com base em percentuais, e não por meio de regras que operem no nível da organização do cliente ou do usuário individual, conforme necessário.
Em sua configuração básica, o NGINX Ingress Controller baseado no NGINX Open Source apresenta a mesma limitação. Por isso, a empresa decidiu migrar para o NGINX Ingress Controller mais avançado, baseado no NGINX Plus, um produto de nível empresarial que oferece controle granular do tráfego. As recomendações da Microsoft e da comunidade do Kubernetes para o NGINX Ingress Controller, devido ao seu alto nível de flexibilidade e controle, ajudaram a consolidar essa escolha. A configuração atende melhor à necessidade da empresa de gerenciar pods (em vez de realizar o gerenciamento de tráfego tradicional), garantindo que eles sejam executados nas zonas apropriadas e que o tráfego seja encaminhado para esses serviços. Às vezes, o tráfego é encaminhado internamente, mas, na maioria dos casos de uso, ele é direcionado novamente para fora por meio do NGINX Ingress Controller por motivos de observabilidade.
Aqui há dragões: monitoramento, observabilidade e desempenho de aplicações
Com o NGINX Ingress Controller, a equipe técnica tem controle total sobre a experiência dos desenvolvedores e usuários finais. Assim que os usuários fazem login e estabelecem uma sessão, eles podem ser direcionados imediatamente para uma nova versão ou retornar a uma versão anterior. As correções podem ser distribuídas simultânea e quase instantaneamente para todos os usuários de uma organização. O software não depende da propagação de DNS nem de atualizações de rede em toda a plataforma de nuvem.
O NGINX Ingress Controller também atende ao requisito da empresa de monitoramento granular e contínuo. O desempenho das aplicações é extremamente importante na área da saúde. A latência ou a indisponibilidade podem prejudicar a prestação bem-sucedida de cuidados clínicos, especialmente em situações de vida ou morte. Após a migração para o Kubernetes, os clientes começaram a relatar períodos de indisponibilidade que a empresa não havia percebido. A empresa logo descobriu a origem do problema: o Azure App Service utiliza dados por amostragem. A amostragem é adequada para médias e tendências gerais, mas deixa de detectar completamente ocorrências como solicitações rejeitadas e recursos ausentes. Ela também não mostra os picos de uso que normalmente ocorrem a cada meia hora, quando os profissionais de saúde fazem check-in e registram os dados dos pacientes. A empresa obtinha apenas uma visão incompleta da latência, das fontes de erros, das solicitações inválidas e da indisponibilidade do serviço.
Os problemas não pararam por aí. Por padrão, o Azure App Service preserva os dados armazenados por apenas um mês — muito menos do que as dezenas de anos exigidas pelas leis de muitos países. Expandir o armazenamento de dados para mantê-los por mais tempo, conforme necessário, tinha um custo proibitivo. Além disso, a solução do Azure não consegue enxergar o interior da pilha de rede do Kubernetes. O NGINX Ingress Controller pode monitorar parâmetros tanto da infraestrutura quanto da aplicação ao processar tráfego das camadas 4 e 7.
Para o monitoramento de desempenho e a observabilidade, a empresa escolheu um banco de dados de séries temporais Prometheus conectado a um mecanismo de visualização e painel do Grafana. A integração com o Prometheus e o Grafana já vem incorporada aos planos de dados e de controle do NGINX; a equipe técnica precisou fazer apenas uma pequena alteração na configuração para direcionar todo o tráfego pelos servidores do Prometheus e do Grafana. As informações também foram encaminhadas para um banco de dados de logs Grafana Loki, facilitando a análise dos logs e proporcionando à equipe de software maior controle sobre os dados ao longo do tempo.
Essa configuração também prepara o ambiente para lidar com futuros incidentes que exijam amostragem de dados extremamente frequente e em grande volume para solucionar problemas e corrigir bugs. Lidar com esses tipos de incidentes pode ser caro com os sistemas de monitoramento de aplicações oferecidos pela maioria das grandes empresas de nuvem, mas, neste caso de uso, o custo e a sobrecarga do Prometheus, Grafana e Loki são mínimos. Os três são produtos de código aberto estáveis que, em geral, após os ajustes iniciais, exigem pouco mais do que a aplicação de patches.
Mantenha o rumo: foco em alta disponibilidade e segurança
A empresa sempre teve um foco duplo: na segurança, para proteger um dos tipos de dados mais sensíveis que existem, e na alta disponibilidade para garantir que o aplicativo esteja disponível sempre que necessário. Na migração para o Kubernetes, foram feitas algumas mudanças para aprimorar ambos os recursos.
Para garantir a máxima disponibilidade, a equipe técnica implementa uma arquitetura de infraestrutura distribuída ativa-ativa, multizona e multirregional, com redundância completa e sem nenhum ponto único de falha. A equipe mantém uma infraestrutura ativa-ativa N+2, com dois clusters Kubernetes em duas regiões geográficas distintas. Em cada região, o software é distribuído por vários data centers para reduzir o risco de indisponibilidade, garantindo proteção contra falhas em qualquer camada da infraestrutura. As regras de afinidade e antiafinidade podem redirecionar instantaneamente os usuários e o tráfego para pods em execução, evitando interrupções no serviço.
Para garantir a segurança, a equipe implementa um firewall de aplicações web (WAF) para se proteger contra solicitações mal-intencionadas e agentes maliciosos. A proteção contra o OWASP Top 10 é um recurso básico oferecido pela maioria dos WAFs. Durante o desenvolvimento do aplicativo, a equipe avaliou diversos WAFs, incluindo o WAF nativo do Azure e o ModSecurity. Por fim, a equipe escolheu o NGINX App Protect, com seu WAF em linha e proteção contra negação de serviço distribuída (DDoS).
Uma grande vantagem do NGINX App Protect é estar localizado junto ao NGINX Ingress Controller, o que elimina um ponto de redundância e reduz a latência. Outros WAFs precisam ser implantados fora do ambiente Kubernetes, aumentando a latência e os custos. Mesmo atrasos mínimos (por exemplo, 1 milissegundo adicional por solicitação) se acumulam rapidamente ao longo do tempo.
Missão paralela surpresa: zero tempo de inatividade para os desenvolvedores
Após concluir a migração para o AKS da maior parte de sua infraestrutura de aplicações e rede, a empresa também obteve melhorias significativas na experiência dos desenvolvedores (DevEx). Agora, os desenvolvedores quase sempre identificam os problemas antes mesmo que os clientes percebam qualquer falha. Desde a migração, o volume de chamados de suporte relacionados a erros caiu cerca de 80%!
As equipes de segurança e desempenho de aplicações da empresa contam com um painel detalhado do Grafana e alertas unificados, eliminando a necessidade de verificar vários sistemas ou implementar gatilhos para mensagens e chamadas de alerta provenientes de diferentes processos. As equipes de desenvolvimento e DevOps agora podem disponibilizar atualizações de código e infraestrutura diariamente, ou até várias vezes ao dia, e usar padrões blue-green extremamente granulares. Antes, elas disponibilizavam atualizações uma ou duas vezes por semana e precisavam programá-las para períodos de baixa utilização, o que era estressante. Agora, o código é disponibilizado assim que está pronto, e os desenvolvedores podem monitorar o impacto diretamente, observando o comportamento da aplicação.
Os resultados são positivos em todos os aspectos: maior agilidade no desenvolvimento de software, melhora no moral dos desenvolvedores e mais vidas salvas.
Sobre o autor

Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.