O mercado de gerenciamento de APIs (APIM) é bastante concorrido. O mais recente Quadrante Mágico do Gartner para Gerenciamento de APIs de Ciclo de Vida Completo classifica 22 fornecedores, dos quais 7 estão no quadrante de Líderes. Competir em um mercado já estabelecido exige construir um posicionamento sólido para se diferenciar e se destacar da concorrência. Então, o que torna diferente a solução de gerenciamento de APIs da NGINX?
Na NGINX, nosso objetivo é criar software leve e de alto desempenho. O NGINX Open Source tornou-se o servidor web preferido dos sites mais movimentados do mundo porque sua arquitetura orientada a eventos oferece maior escalabilidade do que servidores web que criam um processo ou uma thread para cada conexão. O NGINX Open Source também é o gateway de API mais utilizado do setor, um componente de infraestrutura que processa o tráfego de APIs em soluções de APIM como as da Apigee, Axway, IBM DataPower, Kong, Red Hat 3scale e Torry Harris.
O Módulo de Gerenciamento de APIs do NGINX Controller é uma solução de APIM de alto desempenho. Neste blog, compararemos seu desempenho ao do Kong, um concorrente conhecido por seu alto desempenho. O Kong é desenvolvido com base no NGINX e usa Lua para implementar suas funcionalidades de API, enquanto o Módulo de Gerenciamento de APIs utiliza exclusivamente recursos nativos de alto desempenho, implementados como módulos do NGINX Plus. A solução de gerenciamento de APIs da NGINX é baseada em uma arquitetura inovadora que desacopla o plano de dados do plano de controle. Todas as chamadas de API são processadas diretamente pelo NGINX Plus, que atua como gateway de API (plano de dados), sem exigir nenhuma interação com o plano de controle. Isso resulta em uma mediação de alto desempenho do tráfego de APIs, tanto no sentido norte-sul quanto no sentido leste-oeste.
Uma prévia dos resultados: o NGINX Controller API Management Module apresenta um desempenho duas vezes superior ao do Kong.
Um agradecimento especial à Intel por fornecer o hardware e o espaço de laboratório usados para realizar estes testes. Os detalhes completos dos testes e do hardware podem ser encontrados no Apêndice.
Latência adicionada a uma única solicitação
Neste teste, comparamos a latência adicional introduzida pelo gerenciador de APIs em uma única solicitação para arquivos de 0 KB e 1 KB. Usamos o curl para enviar a única solicitação HTTP (detalhes).
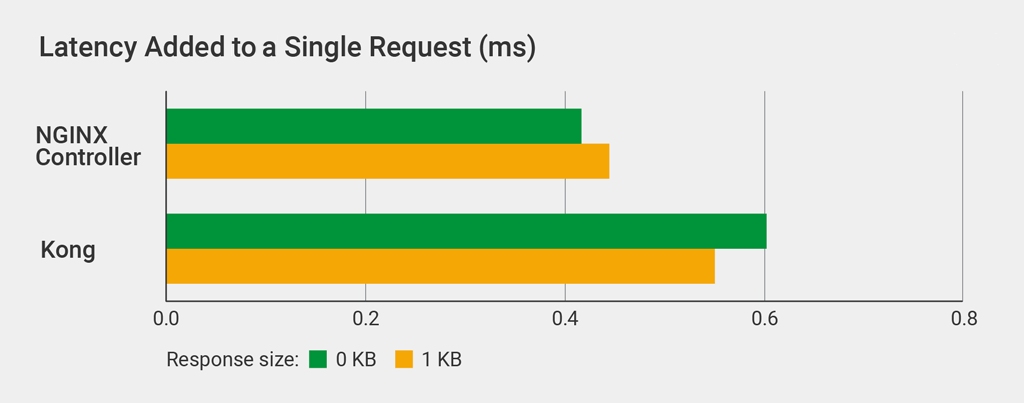
O Kong aumenta a latência em comparação com o Módulo de Gerenciamento de API: em 44% para um arquivo de 0 KB e em 24% para um arquivo de 1 KB.
Chamadas de API por segundo
Uma métrica padrão de escalabilidade HTTP é o número de solicitações por segundo (RPS). A métrica equivalente no contexto do APIM é o número de chamadas de API por segundo. Usamos o wrk para enviar um fluxo contínuo de solicitações de um arquivo de 0 KB ou 1 KB, em 300 conexões durante 3 minutos (detalhes).
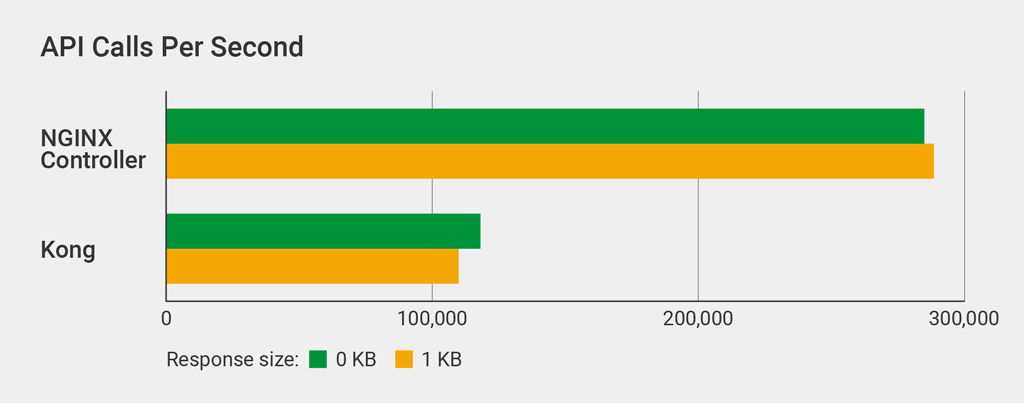
O Módulo de Gerenciamento de APIs superou o Kong, processando 2,6 vezes mais chamadas de API por segundo para respostas de 1 KB.
Uso da CPU
O Módulo de Gerenciamento de APIs apresenta menor latência e processa mais chamadas de API por segundo do que o Kong, pois utiliza a CPU com mais eficiência. Medimos o uso da CPU à medida que aumentamos o número de chamadas de API por segundo. Usamos um único núcleo, portanto, o número absoluto de chamadas de API por segundo é muito menor do que no teste anterior, no qual usamos 22 núcleos (detalhes).
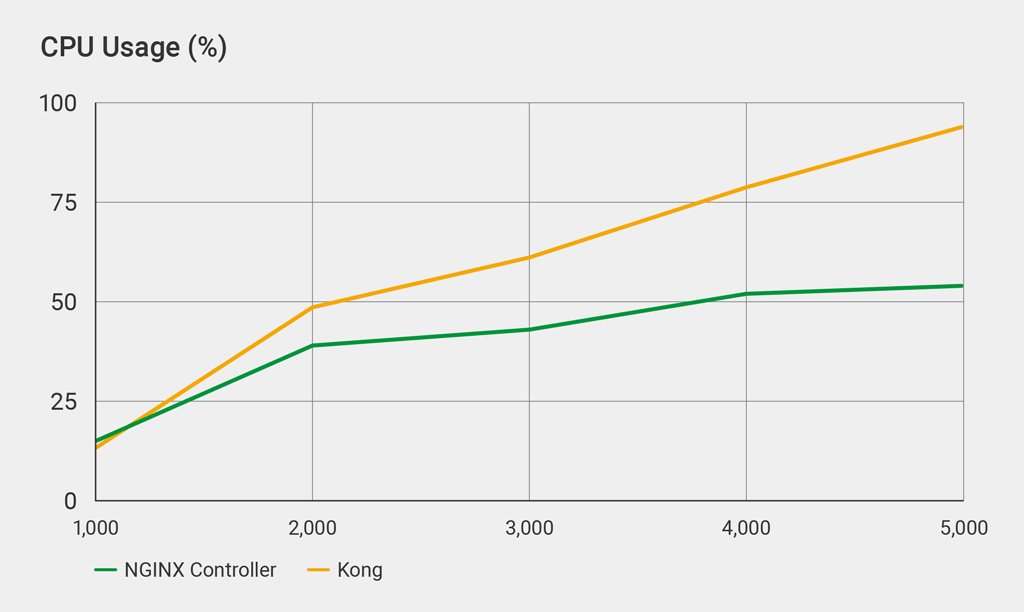
O Kong atinge efetivamente seu limite em 5.000 chamadas de API por segundo — acima desse volume, a latência aumenta consideravelmente, indicando que o sistema está operando em sua capacidade máxima. Com 5.000 chamadas por segundo, o uso da CPU é de 93%, 73% maior que o do Módulo de Gerenciamento de APIs.
Chamadas de API por segundo com JWTs
O teste final mede a eficiência de cada gateway de API na validação de JSON Web Tokens (JWTs), o método preferencial para autenticar solicitações de API. Seus endpoints de API mais importantes provavelmente exigirão autenticação, portanto, este teste se aproxima mais de uma configuração do mundo real.
Usamos o mesmo JWT, assinado com HS256, em ambos os gateways (detalhes).
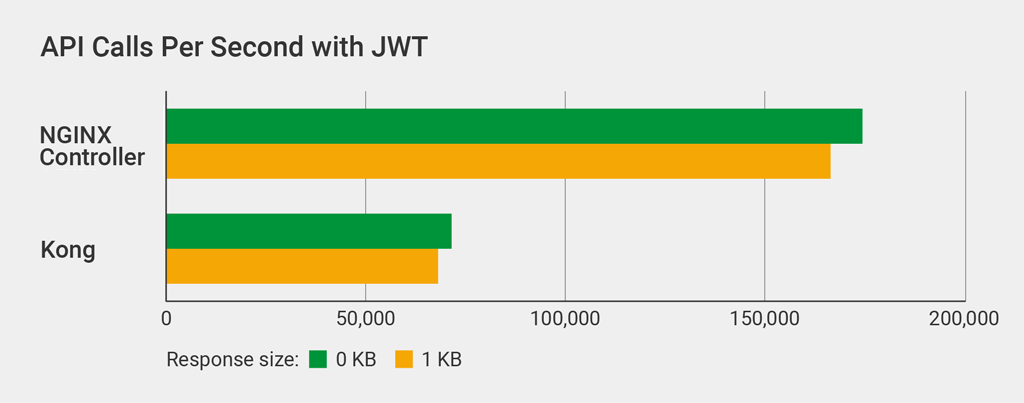
O Módulo de Gerenciamento de APIs processa mais que o dobro de chamadas de API autenticadas por JWT por segundo em comparação com o Kong.
Como o NGINX Controller funciona
O NGINX Controller é uma solução de plano de controle que gerencia o plano de dados do NGINX Plus. O NGINX Controller permite gerenciar todo o ciclo de vida do NGINX Plus como balanceador de carga, gateway de API ou proxy em um ambiente de malha de serviços. Com o módulo de gerenciamento de APIs do NGINX Controller, você pode definir, publicar, proteger, monitorar e analisar APIs.
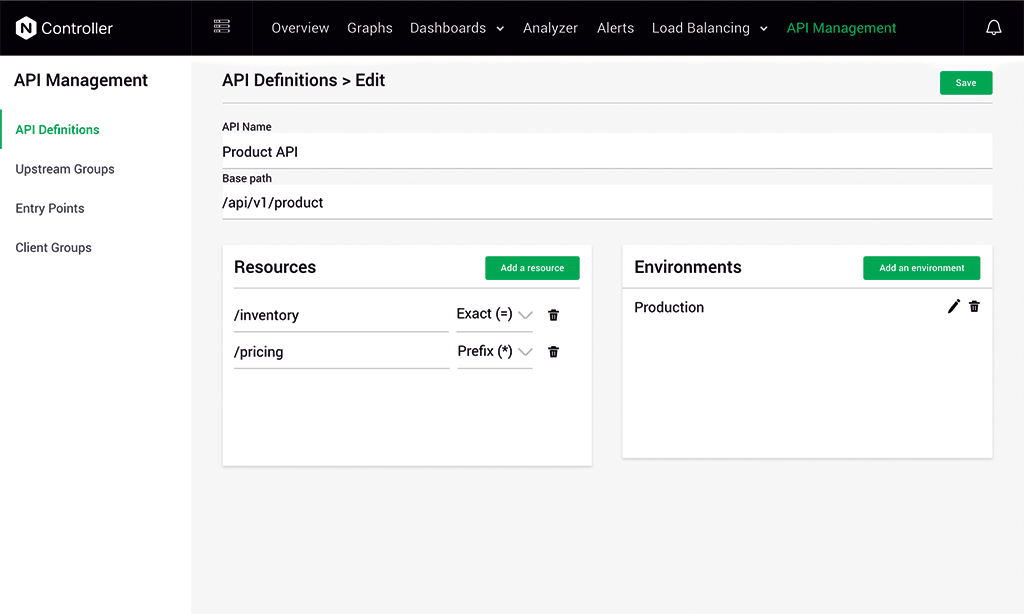
Nos bastidores, o NGINX Controller gera a configuração do NGINX Plus, que é publicada no plano de dados subjacente do NGINX Plus. O carregador de configurações principal conta com um mecanismo muito eficiente para armazenar configurações na memória, permitindo que o Módulo de Gerenciamento de APIs ofereça alto desempenho para APIs.
Conclusão
Muitas empresas já usam o NGINX Open Source como gateway de API. A Capital One conseguiu escalar para mais de 12 bilhões de chamadas de API por dia usando o NGINX Open Source. Na verdade, muitos de nossos concorrentes, incluindo a Kong, usam o NGINX Open Source como base de suas soluções de APIM. Nosso design leve – baseado na configuração nativa e de alto desempenho do NGINX, juntamente com os módulos do NGINX Plus – permite que o Módulo de Gerenciamento de APIs tenha uma escalabilidade superior à das soluções concorrentes derivadas do NGINX.
A latência é uma das métricas mais importantes para a experiência do usuário final. Uma latência alta reduz a capacidade de resposta do aplicativo, frustrando os usuários. O Módulo de Gerenciamento de APIs adiciona de 20% a 30% menos latência às solicitações dos usuários em comparação com o Kong. Ele também usa os recursos do sistema com mais eficiência, consumindo 40% menos CPU do que o Kong para a mesma carga de trabalho.
Apêndice
Topologia
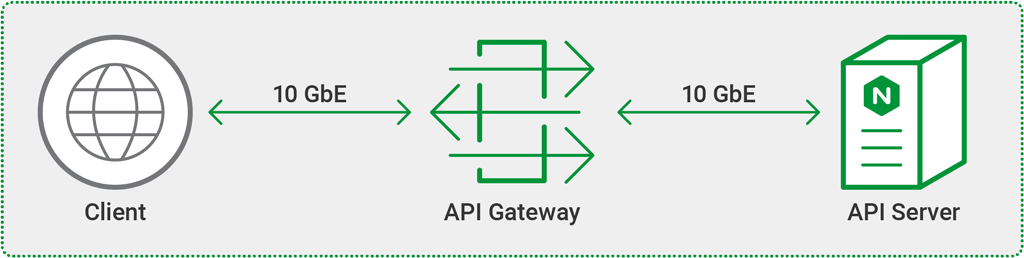
Todos os testes foram realizados usando três máquinas distintas conectadas por links de 10 GbE em uma rede simples e plana de camada 2.
Hardware utilizado
O hardware a seguir foi usado nos testes. As três máquinas eram idênticas. O Hyper-Threading não foi utilizado. Em testes anteriores, não observamos uma diferença significativa de desempenho com o uso do Hyper-Threading.
| CPU | Rede | Memória |
|---|---|---|
| CPU Intel® Xeon(R) E5‑2699 v4 a 2,20 GHz, 22 núcleos | Controlador Ethernet Intel X540‑AT2 de 10 Gigabits | 128 GB |
Software utilizado
Os seguintes softwares foram usados para realizar os testes:
- Módulo de Gerenciamento de APIs do NGINX Controller versão 2.
- Kong Open Source versão 1.0.0. Não testamos o Kong Enterprise, mas nenhum de seus recursos adicionais é relevante para nossos testes (por exemplo, o Kong Open Source e o Kong Enterprise usam o mesmo plug-in JWT).
curlversão 7.61.0.- Docker versão 18.09.1. Para facilitar o gerenciamento, executamos tanto o Kong quanto o Módulo de Gerenciamento de APIs em contêineres Docker. Constatamos que o Docker reduz o desempenho em cerca de 30%, mas, como estamos comparando o desempenho relativo, os benefícios de usar o Docker compensaram a perda de desempenho.
mpstatna versão 12.0.1 do pacotesystat.wrkversão 4.1.0, instalada de acordo com estas instruções.
Configuração do NGINX
A seguinte configuração do NGINX foi usada nos testes.
upstream my_upstream { keepalive 60; server API-server:80; keepalive_requests 3000000; keepalive_timeout 300;}server { listen 8000; access_log off; keepalive_requests 3000000; keepalive_timeout 300; tcp_nodelay on; location /test { set $apimgmt_environment 4; set $apimgmt_definition 3; set $upstream my_upstream; set $upstream_protocol http; rewrite ^ /_devel_4 last; } location = /_devel_4 { internal; set $apimgmt_definition_name my_api; set $apimgmt_environment_name devel; proxy_intercept_errors on; proxy_http_version 1.1; proxy_set_header Connection ""; proxy_pass $upstream_protocol://$upstream/0kb; # 0-KB file #proxy_pass $upstream_protocol://$upstream/1kb.bin; # 1-KB file }}Fizemos as seguintes configurações para maximizar o desempenho. Conforme detalhado na próxima seção, fizemos configurações semelhantes no Kong.
keepalive_requestsekeepalive_timeoutforam definidos com valores altos para minimizar a sobrecarga causada pelo estabelecimento de conexões TCP.tcp_nodelayfoi habilitado, melhorando ligeiramente o desempenho ao desativar o algoritmo de Nagle.access_logfoi desabilitado. Habilitá-lo reduz o desempenho em cerca de 10%.- Usamos as duas diretivas
proxy_passpara solicitar o arquivo com o tamanho adequado.
Configuração do Kong
Adicionamos as seguintes diretivas de configuração ao arquivo kong.conf.default, correspondentes às definições da configuração do NGINX abordadas na seção anterior.
nginx_http_tcp_nodelay=onnginx_http_keepalive_requests=3000000nginx_http_keepalive_timeout=300proxy_access_log=offExecutamos as seguintes chamadas à API do Kong para criar uma rota para o servidor da API. O primeiro comando cria um serviço chamado test e o segundo cria a rota /test que aponta para o servidor.
$ curl -X POST http://localhost:8001/services/ --data 'name=test' --data 'url=http://API-server:80/0kb'$ curl -X POST http://localhost:8001/services/test/routes --data 'paths[]=/test'Os comandos a seguir exibem, respectivamente, a configuração do serviço e da rota. Encaminhamos a saída para a ferramenta jq para facilitar a leitura da saída JSON.
$ curl localhost:8001/services/ | jq '.'{ "next": null, "data": [ { "host": "172.20.40.32", "created_at": 1556770191, "connect_timeout": 60000, "id": "f4629d56-550b-4b37-aa59-66d931aa6f37", "protocol": "http", "name": "test", "read_timeout": 60000, "port": 80, "path": "/0kb", "updated_at": 1556770191, "retries": 5, "write_timeout": 60000 } ]}$ curl localhost:8001/services/test/routes | jq '.'{ "next": null, "data": [ { "created_at": 1556770191, "methods": null, "id": "a7b417af-ccd4-48f7-b787-ae19490194dc", "service": { "id": "f4629d56-550b-4b37-aa59-66d931aa6f37" }, "name": null, "hosts": null, "updated_at": 1556770191, "preserve_host": false, "regex_priority": 0, "paths": [ "/test" ], "sources": null, "destinations": null, "snis": null, "protocols": [ "http", "https" ], "strip_path": true } ]}Metodologia de Testes
Latência adicionada a uma única solicitação
Usamos o curl para testar a latência de uma única requisição. Para estabelecer uma linha de base, primeiro fizemos uma requisição ao servidor de API sem um gateway de API à sua frente. Em seguida, fizemos a mesma requisição com cada gateway de API à frente do servidor de API para medir a latência introduzida por eles.
$ curl -w "@curl-latency.txt" -o /dev/null -s http://target-serverO conteúdo de curl-latency.txt:
time_namelookup: %{time_namelookup}n time_connect: %{time_connect}n time_appconnect: %{time_appconnect}n time_pretransfer: %{time_pretransfer}n time_redirect: %{time_redirect}n time_starttransfer: %{time_starttransfer}n ----------n time_total: %{time_total}nO gráfico em Latência adicionada a uma única solicitação mostra time_total, em milissegundos. Veja um exemplo de saída:
$ curl -w "@curl-latency.txt" -o /dev/null -s http://192.0.2.1/api-endpoint time_namelookup: 0.000035 time_connect: 0.000364 time_appconnect: 0.000000 time_pretransfer: 0.000401 time_redirect: 0.000000 time_starttransfer: 0.001701 ---------- time_total: 0.001727Chamadas de API por segundo
Testamos as chamadas de API por segundo com o wrk, uma ferramenta escalável de benchmarking que usamos com frequência. Testamos várias combinações de parâmetros, e esta foi a que maximizou o desempenho tanto do Módulo de Gerenciamento de APIs quanto do Kong:
$ wrk -t 22 -c 300 -d 180 http://target-serverO comando cria 22 threads do wrk (uma por núcleo) e um total de 300 conexões distribuídas entre as threads. O parâmetro -d especifica a duração do teste — no nosso caso, 180 segundos (3 minutos). Exemplo de saída:
$ wrk -t 22 -c 300 -d 180 http://192.0.2.1/api-endpointRunning 3m test @ http://192.0.2.1/api-endpoint 22 threads and 300 connections Thread Stats Avg Stdev Max +/- Stdev Latency 13.96ms 7.84ms 279.85ms 77.37% Req/Sec 0.96k 298.23 1.88k 68.55% 3769861 requests in 3.00m, 36.25GB readRequests/sec: 20934.34Transfer/sec: 206.16MBUso da CPU
Testamos o uso da CPU com o mpstat (uma ferramenta padrão do Linux para essa finalidade) enquanto executávamos o comando wrk para medir as chamadas de API por segundo. Exemplo de saída (dividido em duas linhas para facilitar a leitura):
$ mpstatLinux 4.18.0-13-generic (nbdw38) 04/29/2019 _x86_64_ (88 CPU)03:34:50 PM CPU %usr %nice %sys %iowait %irq %soft %steal ...03:34:50 PM all 0.04 0.00 0.02 0.00 0.00 0.03 0.00 ... ... %guest %gnice %idle ... 0.00 0.00 99.91Chamadas de API por segundo com JWTs
Testamos o desempenho do JWT com o comando wrk para chamadas de API por segundo, adicionando o parâmetro -H para inserir o JWT no cabeçalho HTTP Authorization: Bearer. Geramos o JWT e as chaves Web JSON (JWKs) seguindo as instruções desta publicação no blog, armazenando o JWT em um arquivo chamado test.jwt.
$ wrk -t 22 -c 300 -d 180 -H "Authorization: Bearer `cat test.jwt`" http://target-serverSobre o autor

Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.