Padrões de entrega de aplicações para escalar aplicações e APIs
Hoje, escalar aplicativos e APIs não se resume a escolher o algoritmo de balanceamento de carga certo. Em mais de duas décadas de evolução da entrega de aplicativos, os algoritmos de balanceamento de carga foram um dos poucos elementos que permaneceram relativamente constantes. Seu principal benefício é manter a disponibilidade. Seu impacto no desempenho é, na melhor das hipóteses, mínimo.
Isso não quer dizer que a escolha de um algoritmo seja irrelevante. Afinal, o round robin raramente é a melhor opção para uma API ou aplicação, mas a escolha entre menor número de conexões e resposta mais rápida tem menos probabilidade de afetar o desempenho geral e a disponibilidade de um serviço digital do que sua arquitetura.
O que apresentaremos aqui é uma perspectiva arquitetural sobre a entrega de aplicações, em resposta ao reconhecimento da entrega de aplicações como uma das seis principais capacidades necessárias para projetar e operar serviços digitais.
O que é um algoritmo de balanceamento de carga?
Um algoritmo de balanceamento de carga é uma abordagem programática para distribuir a carga entre um conjunto de recursos, a fim de garantir a disponibilidade e melhorar o desempenho.
Um algoritmo de balanceamento de carga especifica como determinados recursos são escolhidos e quais variáveis são consideradas.
Round Robin é o algoritmo mais simples e apenas percorre sequencialmente um conjunto conhecido de recursos. Se houver três recursos — A, B e C —, o Round Robin encaminhará a primeira solicitação para A, a segunda para B e a terceira para C. Em seguida, o processo de seleção recomeça.
Menor número de conexões é um algoritmo baseado no segundo axioma operacional, segundo o qual “à medida que a carga aumenta, o desempenho diminui”. Assim, o algoritmo de menor número de conexões escolherá o recurso com o menor número de conexões (carga). Existem variações desse algoritmo, principalmente a de menor número de conexões ponderado, que considera as diferenças de capacidade entre os recursos.
Tempo de resposta mais rápido é usado quando o desempenho é a principal prioridade. O balanceador de carga determinará, de forma passiva ou ativa, o tempo de resposta de cada recurso e, para cada solicitação, escolherá o mais rápido. Esse algoritmo não garante o tempo de resposta do usuário, pois não tem efeito sobre a última milha nem sobre as condições da rede do usuário.
IP de origem é um algoritmo herdado do balanceamento de carga de rede que usa um valor de hash simples do IP de origem (cliente) para escolher um recurso. Esse algoritmo sempre selecionará o mesmo recurso para um determinado IP de origem. Ele caiu em desuso por estar sujeito ao problema do “megaproxy”, em que todos os usuários provenientes de um único proxy/endereço IP são direcionados ao mesmo recurso. Isso tende a sobrecarregar o recurso de destino, resultando em baixo desempenho e, por fim, falha.
Os algoritmos de balanceamento de carga são uma parte importante da arquitetura de entrega de aplicativos, mas têm menos impacto sobre o desempenho e a escalabilidade de um aplicativo ou serviço digital do que a abordagem arquitetural como um todo.
O que é entrega de aplicativos?
A entrega de aplicações é a disciplina de projetar uma arquitetura escalável e de alto desempenho para aplicações, APIs e serviços digitais. Ela depende fortemente do balanceamento de carga como componente central, mas incorpora recursos modernos, como o roteamento de camada 7, e utiliza padrões arquiteturais comuns para otimizar o desempenho e o uso eficiente dos recursos.
Usamos o termo entrega de aplicações para estabelecer deliberadamente uma distinção entre o balanceamento de carga, que é um detalhe de implementação, e a arquitetura, que é um processo de design.
Por que escalamos?
A escalabilidade é uma resposta técnica a um resultado de negócios. Mais especificamente, à necessidade de manter a disponibilidade e o desempenho das cargas de trabalho que compõem um serviço digital para melhorar os índices de satisfação dos clientes, as taxas de conversão e a geração de receita. Essa última parte é particularmente importante, pois nossa pesquisa indica que a maioria (58%) das empresas atualmente obtém pelo menos metade de sua receita com serviços digitais.
Considere também, por exemplo, o uso da nuvem pública para continuidade de negócios (BC). A BC é um dos principais usos da nuvem pública e, em sua essência, consiste em uma implementação de escala global, ou seja, balanceamento de carga global. O failover é um recurso essencial da entrega de aplicações que, quando aplicado a um site inteiro, permite redirecionar rapidamente as solicitações de um local para outro. A disponibilidade contínua da presença digital de uma empresa é um resultado de negócio viabilizado por uma resposta técnica.
Como podemos escalar?
Responder a essa pergunta marca o início da nossa jornada técnica pela arquitetura de entrega de aplicativos. Há dois modelos de escalabilidade: vertical (para cima) e horizontal (para fora).
A escalabilidade vertical baseia-se no princípio de que adicionar mais poder de processamento a um sistema aumentará sua capacidade. Esse método de escalabilidade beneficia principalmente aplicações monolíticas e sistemas autossuficientes. Com exceção da infraestrutura, a maioria das organizações já não depende da escalabilidade vertical, pois ela exige alterações no ambiente físico, como adicionar CPUs ou RAM ou ampliar a capacidade da rede. Embora a escalabilidade vertical seja muito mais rápida graças à virtualização, especialmente em ambientes de nuvem pública, a necessidade de migrar softwares e sistemas — até mesmo para uma nova máquina virtual — pode causar interrupções.
Escalabilidade horizontal é uma abordagem arquitetural para aumentar o poder de processamento por meio da ampliação do total de recursos disponíveis. Isso é feito distribuindo o poder de processamento entre várias instâncias de uma aplicação, serviço ou sistema. Atualmente, esse é o método de escalabilidade mais comum, pois se baseia na duplicação de recursos em vez de sua migração. Além disso, a escalabilidade horizontal oferece uma variedade maior de opções arquiteturais do que a escalabilidade vertical, o que a torna mais adequada para todas as aplicações e APIs.
Portanto, não é de surpreender que os padrões modernos de entrega de aplicativos se baseiem no princípio da escalabilidade horizontal.
Padrões de entrega de aplicativos
Simplesmente optar pelo escalonamento horizontal não encerra a discussão.
Depois que a decisão é tomada (geralmente, essa é a decisão padrão), considerações adicionais devem orientar a decisão arquitetural sobre a implementação. A maneira mais simples de abordar essa decisão é pela perspectiva do cubo de escalabilidade descrito no livro A Arte da Escalabilidade.
De forma bem simples, há três eixos no cubo de escalabilidade: x, y e z. Cada um corresponde a um padrão arquitetural de balanceamento de carga. Cada um desses padrões é adequado para alcançar resultados específicos relacionados a desempenho e disponibilidade, considerando diferentes tipos de aplicações e APIs.
É provável que um serviço digital use uma arquitetura que incorpore vários padrões para otimizar simultaneamente o desempenho e o consumo de recursos. Essa abordagem exige uma visão sistêmica, pois deve considerar todos os componentes, como eles interagirão e como as solicitações fluirão do usuário para o aplicativo e vice-versa.
Escala do eixo X
O padrão do Eixo X é o mais básico. Ele se baseia na duplicação horizontal, e a maior parte do trabalho é realizada por meio de um algoritmo de balanceamento de carga. É o padrão mais simples e resulta no que chamo de Balanceamento de Carga Tradicional (POLB).
Nós o chamamos assim devido à simplicidade da arquitetura, que não aproveita os recursos avançados dos balanceadores de carga modernos para interagir com solicitações e respostas na camada de aplicação.
Nesse padrão, as aplicações são duplicadas, e as solicitações são encaminhadas para uma instância com base na decisão do algoritmo de balanceamento de carga configurado.
Como esse padrão costuma ser usado em conjunto com o TCP (camada 4), ele oferece vantagens de desempenho em relação a outros padrões que dependem da inspeção do HTTP (camada 7). Principalmente, as conexões podem ser interligadas em vez de passar por proxy, o que efetivamente transforma o balanceador de carga em um salto de rede após a conexão inicial. Isso resulta em um desempenho geral superior, mas elimina a capacidade do balanceador de carga de inspecionar ou atuar sobre solicitações e respostas após a conexão inicial. Como as arquiteturas de eixo X se destacam por garantir a disponibilidade e podem oferecer alto desempenho, elas são frequentemente usadas para dimensionar serviços de infraestrutura e segurança, como firewalls e gateways de aplicações.
Diversos aplicativos tradicionais (monolíticos, web de três camadas e cliente-servidor) tendem a ser dimensionados usando esse padrão, pois raramente são decompostos em componentes mais distintos que possam ser aproveitados em arquiteturas modernas de entrega de aplicativos.
Escalabilidade no eixo Y
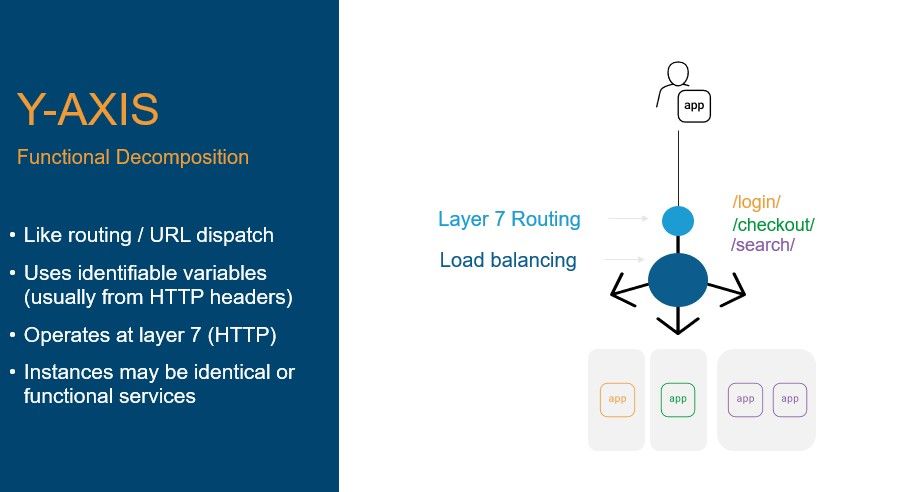
Esse padrão se baseia na decomposição funcional e aproveita os recursos da camada de aplicação (camada 7) da entrega de aplicativos para permitir o escalonamento com base em funções, em vez de sistemas inteiros. O padrão do eixo Y é o primeiro em que o roteamento da camada 7 se torna uma ferramenta essencial no conjunto de recursos da arquitetura de entrega de aplicativos.
Em geral, os padrões baseados nos eixos y e z aproveitam o roteamento da camada 7 para escolher um pool e, em seguida, usam um algoritmo de balanceamento de carga para selecionar um recurso específico. Isso difere do padrão básico do eixo x, no qual não se utiliza o roteamento da camada 7.
Esse padrão pressupõe a operação na camada 7, normalmente HTTP, e usa alguma variável para distribuir o tráfego entre instâncias específicas de uma aplicação ou serviço. Por exemplo, se o padrão /login for encontrado no URI, o balanceador de carga escolherá uma instância, com base no algoritmo de balanceamento de carga configurado, em um pool de instâncias da aplicação que processam apenas solicitações de login. A variável pode ser qualquer elemento do cabeçalho ou do conteúdo da solicitação. Isso permite o roteamento baseado em agente, em API e em conteúdo (imagens, scripts etc.).
As instâncias do aplicativo podem ser clones. Isso costuma ocorrer quando há uma disparidade no uso de um aplicativo que pode ser identificada por uma variável na solicitação. Por exemplo, as funções de login e checkout podem ser identificadas em uma solicitação com base no URI, em um valor no cabeçalho HTTP ou em um valor no payload da solicitação. A aplicação de um padrão de eixo Y permite que aplicativos tradicionais sejam dimensionados com base na função, o que resulta em maior eficiência na utilização de recursos, pois mais recursos podem ser alocados para processar funções de alto volume, mantendo o desempenho esperado das demais funções.
O uso do padrão do eixo Y para escalar funcionalmente aplicações tradicionais surgiu antes da popularização dos microsserviços, que hoje decompõem funcionalmente as aplicações. O padrão do eixo Y continua aplicável aos microsserviços e, de fato, é implementado atualmente por controladores de ingresso (ingress controllers). Leitores atentos perceberão que esse padrão também se aplica às APIs, pois elas dependem de elementos do HTTP (camada 7), portanto não surpreende que os gateways de API utilizem esse padrão fundamental.
Esse padrão foi popularizado pelo eBay nos primórdios da Web 2.0. Na época, sua arquitetura de escalabilidade incluía a segmentação de funções em pools de aplicações separados. A funcionalidade de vendas era atendida por um conjunto de servidores de aplicações, a de lances por outro e a de pesquisa por mais um. No total, cerca de 16.000 servidores de aplicações foram organizados em 220 pools diferentes. Isso permitiu dimensionar cada pool de forma independente, de acordo com as demandas e o consumo de recursos de sua função. Também possibilitou isolar e racionalizar as dependências de recursos — o pool de vendas, por exemplo, só precisava se comunicar com um subconjunto relativamente pequeno de recursos de back-end.
O padrão do eixo y também pode ser usado para distribuir diferentes tipos de solicitações de conteúdo, como imagens, para um pool de recursos e outros tipos de conteúdo para outros pools.
Usar o eixo y para distribuir a carga permite que os componentes de um serviço digital sejam dimensionados individualmente, o que é muito mais eficiente em termos de utilização de recursos do que um padrão de eixo x. Isso permite otimizar a configuração na camada de serviço ou de aplicação, melhorando seu desempenho por meio do ajuste de variáveis específicas no servidor web ou de aplicativos para um determinado tipo de conteúdo.
Escalabilidade no eixo Z
O padrão de eixo Z se popularizou por pura necessidade, com o crescimento explosivo das redes sociais e da Internet como um todo. Em essência, trata-se de um padrão de escalabilidade no eixo Y com segmentação adicional, geralmente baseada em uma variável específica, como o nome de usuário ou um identificador de dispositivo.
Esse padrão permite a diferenciação arquitetural por meio de uma técnica derivada do particionamento de dados.
“Um fragmento de banco de dados, ou simplesmente shard, é uma partição horizontal dos dados de um banco de dados ou mecanismo de busca. Cada shard é armazenado em uma instância separada do servidor de banco de dados para distribuir a carga. Alguns dados do banco de dados permanecem presentes em todos os shards, enquanto outros aparecem em apenas um deles.”
Wikipedia1
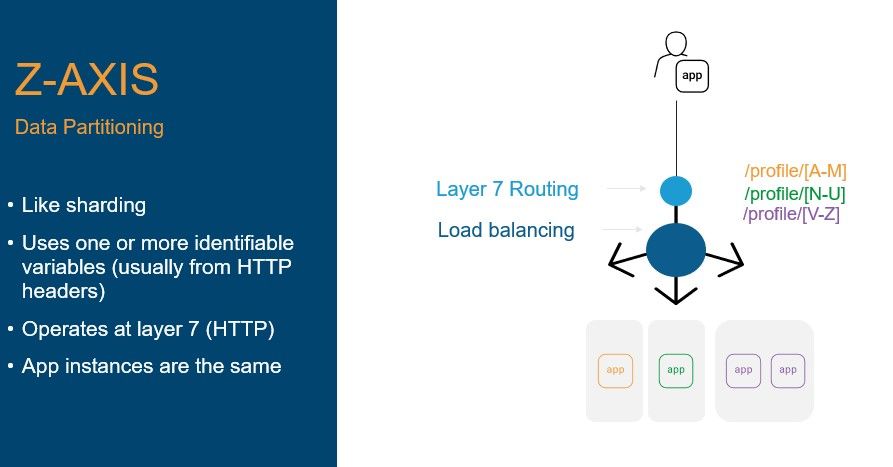
Esse padrão aplica os princípios usados em bancos de dados para distribuir solicitações com base em algum dado contido na solicitação. Ele pode ajudar a solucionar gargalos na camada de dados, além de garantir a conformidade com as regras de soberania de dados. O padrão usa uma variável identificável — e geralmente exclusiva — para encaminhar solicitações entre um conjunto de recursos dimensionado horizontalmente. Em geral, esse padrão é usado quando é necessário um alto volume de processamento, como no caso de grandes volumes de solicitações para um serviço ou aplicativo específico.
O padrão do eixo Z é particularmente útil para gerenciar dispositivos de borda e de IoT, que podem chegar à casa dos milhões. Ao usar identificadores de dispositivos como padrão-base para o particionamento de solicitações, é possível aumentar significativamente a velocidade de transferência dos dados. Isso pode ser especialmente útil para dispositivos que armazenam suas configurações em um local remoto (na nuvem ou em um data center), pois esses dados são exclusivos de cada dispositivo e podem ser particionados com segurança.
Esse padrão tende a melhorar o desempenho, pois o acesso aos dados sob alta carga pode prejudicá-lo significativamente. Assim, ao distribuir o acesso aos dados entre mais instâncias, a carga diminui e, consequentemente, o desempenho melhora. Isso exige atenção especial à integridade dos dados e pode resultar em problemas de consistência quando usado para fragmentar dados compartilhados. A Meta deu destaque ao tema do sharding ao desenvolver o sharding de serviços como parte de sua arquitetura geral. A atenção especial dedicada ao desenvolvimento de uma arquitetura de entrega de aplicativos altamente eficiente e escalável é um excelente exemplo de como reconhecer a entrega de aplicativos como uma camada formal dentro de uma arquitetura mais ampla pode gerar benefícios significativos.
Para serviços que acessam fontes de dados não primárias, um padrão de eixo Z pode aumentar a taxa de transferência sem afetar significativamente a qualidade dos dados em todo o sistema. Essa abordagem elimina a necessidade de adicionar código para vincular uma instância específica de um aplicativo ou uma API a uma fonte de dados. Em vez disso, ela se baseia na combinação da configuração dos conectores de dados no nível da instância com o roteamento da entrega de aplicativos para garantir o uso da fonte de dados correta.
O segredo para ganhar escala está na arquitetura de entrega de aplicativos
Hoje em dia, em um mundo no qual serviços digitais são disponibilizados, é raro usar apenas um padrão de entrega de aplicativos para projetar um serviço digital confiável e de alto desempenho. Isso se deve à complexidade inerente dos serviços digitais e à crescente diversidade de “usuários”, que podem incluir dispositivos, pessoas e softwares.
Assim, uma abordagem arquitetural considera a melhor forma de utilizar padrões de entrega de aplicativos em todo o serviço digital para proporcionar uma experiência ideal aos usuários.
Não existe uma solução arquitetural “certa” ou “errada”, pois ela depende muito dos serviços e aplicativos que compõem um serviço digital. No entanto, essa solução não deve se basear apenas em algoritmos de balanceamento de carga.
De fato, vale observar que não houve menção à seleção de algoritmos, pois a escolha de como a carga é distribuída em um padrão de balanceamento de carga não é tão relevante quanto fazer a escolha arquitetural correta para um aplicativo ou uma API específica.
Esse é um dos fatores que estão impulsionando a entrega de aplicações como disciplina. A forma como a entrega e a segurança de aplicações são usadas e implementadas atualmente vai muito além do simples dimensionamento de um servidor web. Sua implementação pode afetar o desempenho e a disponibilidade e, em última análise, determinar o sucesso ou o fracasso dos resultados de negócios. Portanto, é importante que as organizações tratem a entrega de aplicações como uma ferramenta estratégica e arquitetônica em seu conjunto de recursos de design.
O balanceamento de carga continua sendo o principal requisito técnico para garantir a escalabilidade. Compreender os padrões de entrega de aplicações e como eles utilizam o balanceamento de carga proporcionará uma perspectiva melhor para projetar serviços digitais visando escalabilidade e desempenho, especialmente quando esses serviços provavelmente serão híbridos e incluirão uma combinação de APIs e aplicações modernas e tradicionais.
NOTA DE RODAPÉ