Considerações sobre técnicas e tecnologias para a adoção do Zero Trust
Por Mudit Tyagi e Ken Arora
Partindo do “porquê” —os princípios orientadores1 — da confiança zero, a próxima questão é “como” — as técnicas e tecnologias usadas para implementar esses princípios.
Em uma perspectiva mais ampla, os princípios de confiança zero podem ser aplicados a todo o ciclo de vida de desenvolvimento de aplicações, incluindo o projeto do sistema, as plataformas de hardware utilizadas e os procedimentos de aquisição.2 No entanto, este artigo aborda os aspectos operacionais da implementação da confiança zero para proteger aplicações e dados durante a execução.
Técnicas e tecnologias
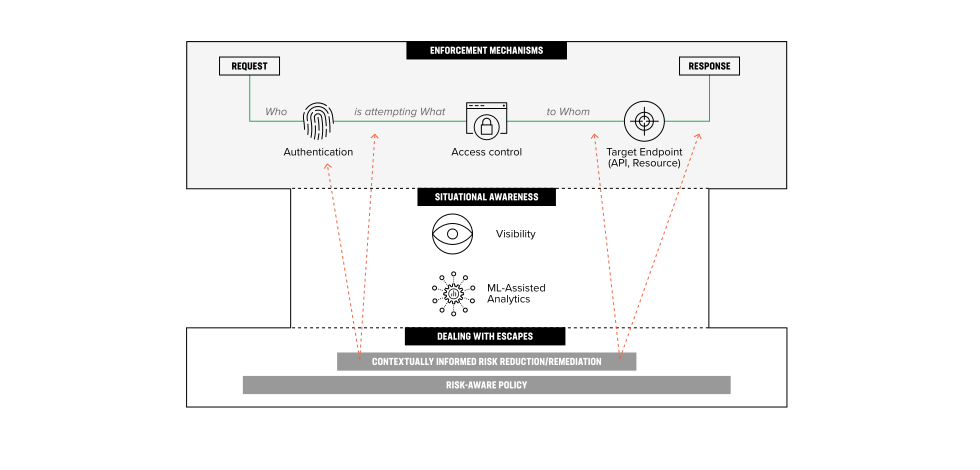
Em termos gerais, a segurança de confiança zero usa tecnologias para alcançar um de três objetivos distintos:
- Aplicar restrições às transações: Quem pode fazer O quê a Quem.
- Forneça consciência situacional ao operador humano do sistema.
- Realizar ações mais avançadas de redução/correção de riscos, com base nos indicadores de suspeita auxiliados por aprendizado de máquina (ML) e no perfil de risco-retorno da(s) transação(ões) em questão.
O gráfico a seguir ilustra esse modelo transacional geral de segurança de confiança zero, e as próximas seções apresentam uma análise mais detalhada de cada classe de tecnologias.
Aplicação: autenticação e controle de acesso
Motivações
As duas primeiras tecnologias — autenticação e controle de acesso — estão intimamente relacionadas e são diretamente orientadas pelos princípios de “verificar explicitamente” e “privilégio mínimo”, pois estão no cerne da aplicação de “Quem pode fazer O quê”. Implementações mais sofisticadas de autenticação monitoram continuamente o comportamento de um agente, incorporando a mentalidade de “avaliar continuamente”.
Autenticação
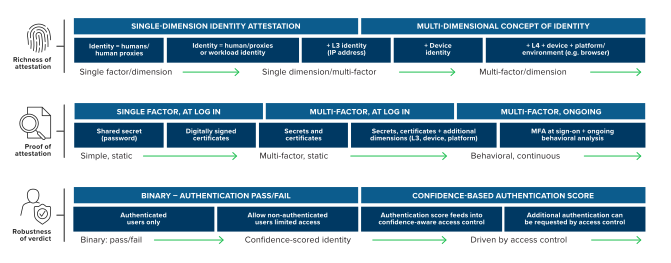
As tecnologias de autenticação têm como objetivo gerar confiança em uma identidade comprovada: Quem está realizando uma transação. O processo de autenticação tem três componentes:
- Há uma declaração, ou alegação, feita pelo agente, informando sua identidade.
- Há alguns dados, normalmente fornecidos pelo agente, que comprovam a veracidade da declaração.
- O sistema emite um veredito ou toma uma decisão sobre a probabilidade de a declaração ser verdadeira — ou seja, de o agente ser quem afirma ser. O gráfico abaixo apresenta os diferentes aspectos da autenticação e os respectivos modelos de maturidade, seguido de uma discussão mais aprofundada sobre cada aspecto.
Atestado
A forma mais básica de atestação costuma ser chamada de “usuário” — um ser humano, ou um agente que atua em nome de um ser humano, que deseja realizar uma transação. No entanto, no caso do uso de confiança zero em uma aplicação, um ator pode ser uma carga de trabalho (como um processo, serviço ou contêiner), portanto, o conceito generalizado de identidade deve incluir esses atores. Em outros casos, a noção de Quem inclui não apenas o ser humano ou a carga de trabalho, mas também considerações ou dimensões adicionais da identidade. Sob essa perspectiva, outras dimensões da identidade podem incluir o dispositivo ou a plataforma do usuário/da carga de trabalho, o ecossistema usado para a interação ou a localização do agente. Por exemplo, uma usuária chamada “Alice” pode estar em um PC identificado como “ABC- 0001”, usando uma instância específica e identificada por impressão digital de um navegador, com origem no endereço IPv4 10.11.12.13.
Comprovação de identidade
Alguns sistemas permitem que usuários não autenticados, às vezes chamados de usuários “convidados” ou “anônimos”, realizem um conjunto limitado de transações. Para esses sistemas, as etapas adicionais de comprovação de identidade e de emissão de um parecer pelo sistema não são relevantes. No entanto, para qualquer identidade específica declarada, os métodos a seguir são comumente usados para fundamentar essa declaração:
- Conhecimento de um segredo compartilhado, como uma senha.
- Algum tipo de credencial emitida por um terceiro confiável, como um certificado assinado.
- Interrogação — automatizada (como a identificação do dispositivo por impressão digital) ou ativa (como um desafio CAPTCHA) — do usuário, da carga de trabalho ou da plataforma.
- Metadados relacionados ao agente, como geolocalização, reputação do IP ou horário de acesso.
- Análise comportamental, como análise biométrica passiva ou padrões de fluxo de trabalho na interação com o aplicativo.
Muitas vezes, quando é necessário um alto grau de confiança, vários métodos são utilizados. Isso fica evidente no modelo Google BeyondCorp,3 que exige autenticação multifator (MFA) antes de permitir transações de maior valor. As soluções de autenticação mais sofisticadas associam um “grau de confiança” a cada identidade e especificam um nível mínimo de confiança para cada tipo de transação, com base no valor e no risco da transação.
Autenticação estática vs. dinâmica
Por fim, vale observar que alguns desses métodos não são ações estáticas e pontuais, mas podem e devem ser contínuos, de acordo com o princípio de “avaliar continuamente”. Nesses casos, a pontuação de confiança atribuída à atestação de identidade pode aumentar ou diminuir ao longo do tempo. Por exemplo, a impressão digital do navegador ou o endereço IP podem mudar durante uma única sessão do usuário, o que pode ser considerado suspeito e reduzir a confiança. Por outro lado, à medida que mais dados sobre o comportamento do agente durante uma sessão são coletados, a pontuação de confiança pode aumentar ou diminuir, dependendo de como o comportamento atual se compara às observações anteriores.
A autenticação dinâmica pode funcionar em conjunto com o controle de acesso em sistemas mais avançados. No primeiro nível dessa interação, a política de controle de acesso pode especificar uma pontuação mínima de confiança para diferentes classes de transações, conforme mencionado anteriormente. O nível seguinte da interação permite que o subsistema de controle de acesso forneça feedback ao subsistema de autenticação, normalmente solicitando uma autenticação adicional para elevar a pontuação de confiança até o limite mínimo.
Controle de acesso
Depois de usar técnicas de autenticação para determinar Quem está agindo em uma transação, as próximas perguntas são: O que esse agente tem permissão para fazer? E para Quem? Esse é o domínio das tecnologias de controle de acesso.
Fazendo uma analogia com a segurança física, imagine que você quisesse visitar uma base militar. Depois que os guardas determinassem com segurança se você é um civil, político ou militar, eles usariam essa informação para decidir em quais prédios você poderia entrar e se poderia levar uma câmera para cada um deles. A política que rege essas decisões poderia ser bastante genérica e se aplicar a todos os prédios (por exemplo, “políticos podem entrar em qualquer prédio”) ou ser mais específica (como “políticos só podem entrar nos prédios <A> e <B>, mas só podem levar câmeras para o <A>”).
Aplicadas ao contexto da segurança cibernética, as técnicas de controle de acesso devem incorporar o princípio do “privilégio mínimo” da confiança zero. Em outras palavras, a política ideal de controle de acesso permitiria apenas os privilégios estritamente necessários ao agente e bloquearia todos os demais. Além disso, uma política robusta ideal estaria condicionada a um nível mínimo específico de confiança na autenticidade da identidade do agente, com o limite de confiança definido individualmente para cada privilégio permitido.
Portanto, o valor de uma solução de controle de acesso pode ser avaliado pelo grau de alinhamento com esses ideais. Especificamente, uma solução de segurança de confiança zero deve incluir controle de acesso, e a tecnologia utilizada deve ser avaliada segundo as dimensões apresentadas abaixo e descritas em seguida.
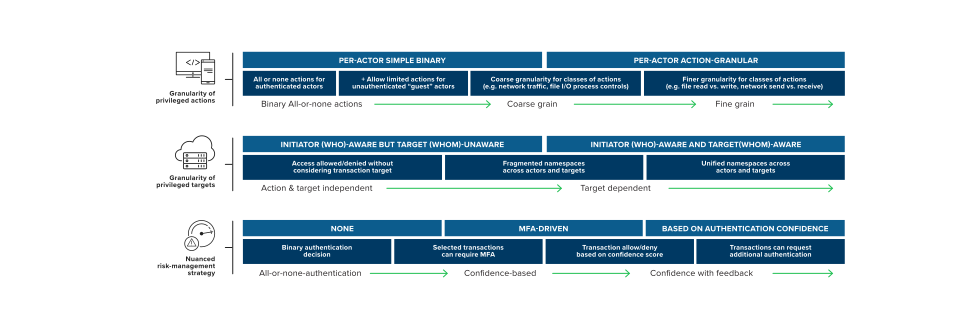
- Qual é o nível de granularidade dos privilégios de controle de acesso?
- Qual é a granularidade da ação — o quê na transação? Trata-se de:
- Binário: Permitir “todas” as transações ou “nenhuma”. Na analogia da base militar, isso corresponderia a “todos os soldados podem entrar em qualquer edifício e fazer o que quiserem” e “civis não podem entrar em nenhum edifício”.
- Grosseiro: Granular no nível do endpoint da API ou do “tipo” de transação (como E/S de arquivos, comunicação de rede e controles de processos). Em nosso exemplo, isso permitiria um nível de nuance em relação à ação permitida, como “políticos podem entrar nos prédios, mas não podem tirar fotos”.
- Fino: No nível da sub-API (ou seja, dependendo dos parâmetros ou da versão da API) ou do “subtipo” de transação (como E/S de arquivo somente leitura ou recebimento TCP somente leitura). Retomando nossa analogia mais uma vez, isso permitiria controles mais granulares, como “civis só podem entrar em edifícios se estiverem acompanhados por um soldado”.
- Há granularidade quanto ao alvo da ação — o Quem na transação? Trata-se de:
- Sem granularidade de alvo: a política de controle de acesso não considera o alvo da ação. Em nosso exemplo, essa abordagem corresponderia à granularidade de permitir a entrada em alguns edifícios, mas não em outros — sendo os edifícios o alvo da ação de “entrar”.
- Granular por alvo, nível de infraestrutura: A política de controle de acesso pode incluir o alvo da ação, mas usa alguma tag/algum rótulo específico da infraestrutura, como o endereço IP, o nome DNS ou o nome do contêiner Kubernetes (K8S) do alvo. Isso permitiria que a política tivesse granularidade por edifício, mas cada base militar poderia ter uma convenção diferente para nomear os edifícios.
- Granular por alvo, com reconhecimento de identidade: A política de controle de acesso pode incluir o alvo da ação, identificando-o por meio do mesmo espaço de nomes de identidade (por exemplo, SPIFFE) usado para o agente (Quem). A vantagem em relação à abordagem anterior é que todas as bases militares usariam um esquema consistente para identificar os edifícios, tornando a política mais portável.
- Qual é a granularidade da ação — o quê na transação? Trata-se de:
- Como a solução de controle de acesso lida com o conceito de ações de menor ou maior risco?
- Não considera o risco: A solução de controle de acesso trata todos os privilégios de controle de acesso da mesma forma ao decidir se permite ou impede a ação.
- Gerenciamento de riscos por meio de MFA: a solução de controle de acesso gerencia os riscos permitindo que a política especifique que algumas transações autorizadas ainda exijam autenticação multifator, com base no agente (Quem), na ação (O quê), ou no alvo (Quem) envolvido na transação.
- Gerenciamento de riscos por meio do nível de confiança: a solução de controle de acesso gerencia os riscos permitindo que a política especifique que qualquer transação ainda pode exigir um nível mínimo de confiança na autenticidade do agente, com base na ação (O quê) e no alvo (Quem) envolvidos na transação. A MFA pode aumentar o nível de confiança, embora outros meios possam ser usados; em outros casos, a transação pode não ser permitida se for de alto valor e houver incerteza suficiente quanto à autenticidade do agente.
Considerando o princípio de “avaliar (e reavaliar) continuamente”, qualquer grau de confiança na autenticidade do agente deve ser ajustado ao longo do tempo. Em uma solução simples, isso pode se resumir a um tempo limite; em sistemas mais sofisticados, o nível de confiança pode variar com base nas observações do comportamento do agente ao longo do tempo.
Consciência situacional: motivações para visibilidade e análise contextual assistida por ML
Se a autenticação e o controle de acesso são implementações da mentalidade de “sempre verificar” e “privilégio mínimo”, então a visibilidade e a análise contextual são fundamentais para os princípios de “avaliação contínua” e “presunção de violação”.
A visibilidade é o pré-requisito necessário para a análise — um sistema não pode mitigar aquilo que não consegue enxergar. Portanto, a eficácia da solução de segurança de confiança zero será diretamente proporcional à profundidade e à abrangência da telemetria que puder ser coletada das operações do sistema e do contexto externo. No entanto, uma infraestrutura moderna de visibilidade será capaz de fornecer muito mais dados, metadados e contexto potencialmente úteis do que qualquer pessoa sem assistência conseguiria processar em tempo hábil. Diante da necessidade de obter mais dados e transformá-los em insights com maior rapidez, um requisito fundamental é o uso de assistência automatizada para os operadores humanos.
Essa assistência geralmente é implementada por meio de algoritmos automatizados que abrangem desde análises baseadas em regras e métodos estatísticos até algoritmos avançados de aprendizado de máquina. Esses algoritmos são responsáveis por transformar o enorme fluxo de dados brutos em uma percepção situacional compreensível e operacional, que pode ser usada pelos operadores humanos para avaliar a situação e, se necessário, tomar medidas corretivas. Por esse motivo, a análise assistida por aprendizado de máquina anda de mãos dadas com a visibilidade.
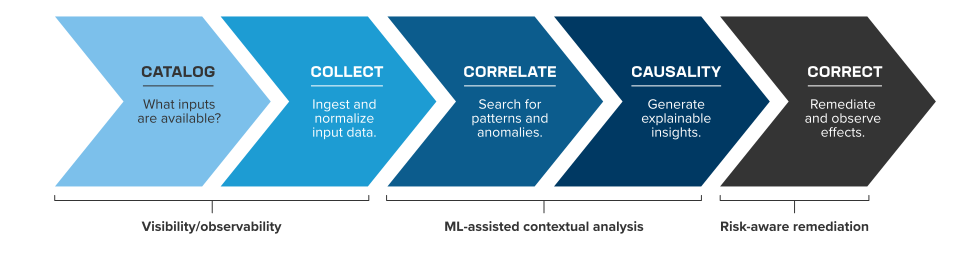
O pipeline generalizado que vai dos dados brutos (visibilidade) à ação (remediação) é mostrado abaixo:
Visibilidade
A visibilidade é a implementação — o “como” — do princípio de confiança zero de “avaliação contínua”. Ela inclui a manutenção de um inventário das entradas de dados disponíveis (Catalogar), além de telemetria em tempo real e retenção de dados históricos (Coletar).
A maturidade de uma implementação de visibilidade de confiança zero deve considerar quatro fatores:
- Latência: Quão próximos do tempo real estão os dados?
A latência estabelece o limite mínimo de rapidez com que se pode responder a uma possível ameaça. A latência de uma solução de confiança zero deve ser medida em segundos ou menos; caso contrário, é bastante provável que qualquer análise — por mais precisa que seja — seja concluída tarde demais para evitar o impacto da exploração, como exfiltração/criptografia de dados ou indisponibilidade devido ao esgotamento de recursos. Sistemas mais sofisticados podem permitir mitigações síncronas e assíncronas. A mitigação síncrona impediria a conclusão da transação até que a visibilidade e a análise completas fossem concluídas. Como a mitigação síncrona provavelmente adicionará latência à transação, esse modo de operação seria reservado para transações particularmente anômalas ou arriscadas, enquanto todas as demais transações poderiam enviar telemetria e ser analisadas de forma assíncrona. - Consumibilidade: Com que facilidade os dados podem ser consumidos?
Essa questão é relevante quando os dados são provenientes de várias fontes ou de diferentes tipos de sensores de dados, o que é um cenário comum. Esse fator geralmente se divide em duas questões secundárias.
No nível sintático, trata-se de como os dados podem ser extraídos e representados. Por exemplo, se a reputação de um IP de origem chega como um campo de texto (como “malicioso”, “suspeito”, “desconhecido” etc.) em uma mensagem syslog de uma fonte e como um campo numérico codificado em binário em um arquivo de dados de outra, deve-se definir uma representação canônica. Será necessário serializar os dados para extrair e transformar os dados recebidos nessa representação.
No nível semântico, diferentes fontes podem variar não apenas em sua sintaxe e forma de transmissão, mas também em sua semântica. Retomando o exemplo da reputação de IP, um provedor pode fornecer uma pontuação de ameaça como um número, enquanto outro pode classificar o IP em uma categoria como “nó TOR”, “controle de DNS” ou “phishing”. A solução de visibilidade também deve fornecer um mecanismo para normalizar os dados recebidos em uma sintaxe consistente. - Completude: Qual é a abrangência e a profundidade dos dados disponíveis?
Um dos principais benefícios proporcionados por uma solução de visibilidade de alta qualidade é a capacidade de identificar atividades suspeitas como indício de uma possível violação. Para fazer isso de forma eficaz, a solução deve receber telemetria de todas as “camadas” relevantes da entrega de aplicações: a própria aplicação, naturalmente, mas também a infraestrutura da aplicação, a infraestrutura de rede, quaisquer serviços aplicados à aplicação ou utilizados por ela e até mesmo os eventos no dispositivo cliente. Por exemplo, identificar um usuário acessando por meio de um novo dispositivo, nunca visto antes, pode ser, por si só, ligeiramente suspeito; porém, quando isso é combinado com informações de rede (como o mapeamento GeoIP indicando um país estrangeiro), o nível de suspeita aumenta. Esse nível de suspeita se manifesta como uma pontuação de confiança mais baixa na identidade do usuário. No contexto de uma política de segurança de confiança zero, quando esse agente tenta realizar uma transação de alto valor (como a transferência de fundos para uma conta no exterior), a solução de controle de acesso pode optar por bloquear a transação com base na baixa confiança.
No que diz respeito à abordagem de confiança zero, quanto mais profunda e completa for a solução de visibilidade, mais eficaz o sistema poderá ser para limitar adequadamente as transações e detectar violações - Governança: Até que ponto os requisitos legais e de licenciamento para o uso de dados são atendidos?
Por fim, toda coleta de dados deve estar em conformidade com os requisitos legais e de licenciamento relacionados à segurança, à retenção e ao uso dos dados. Portanto, uma solução robusta de visibilidade deve atender a cada uma dessas necessidades. As restrições ao uso de dados impostas pela governança devem ser consideradas em uma solução de visibilidade de confiança zero. Por exemplo, se um endereço IP for considerado uma Informação de Identificação Pessoal (PII), o uso e a retenção de longo prazo de endereços IP para análise deverão respeitar os usos permitidos desses endereços.
Análise contextual com o auxílio de máquinas
Além da visibilidade, o outro mecanismo necessário para implementar a “avaliação contínua” são as ferramentas analíticas necessárias para realizar uma avaliação significativa, ou seja, uma avaliação que possa ser operacionalizada por uma solução de confiança zero.
Um aspecto a ser considerado na análise é o escopo e a abrangência dos dados de entrada. As entradas dos algoritmos de análise podem se limitar a um único fluxo de dados proveniente de uma única fonte ou abranger vários fluxos, incluindo dados de diversas fontes e de todas as camadas da infraestrutura e da aplicação.
- A contextualização mais básica ocorre no escopo de um único “tipo” ou “fluxo” de dados (como um fluxo de eventos de “informações de login do usuário com horário e endereço IP de origem”), geralmente com contexto histórico e/ou dados de vários usuários. Essa análise pode gerar alguns insights básicos, como “este usuário <X> nunca fez login neste horário do dia” ou “este usuário <X> parece sempre fazer login imediatamente após o usuário <Y>”. O primeiro caso pode reduzir a confiança na identidade; o segundo pode indicar algum padrão de nível mais elevado, talvez mal-intencionado.
- Uma contextualização mais avançada considera o escopo temporal e de múltiplas instâncias não apenas para um único “tipo” de dado, mas também realiza a correlação temporal entre diferentes “tipos” ou “fluxos” de dados. Um exemplo seria correlacionar os dados de login do usuário com ações específicas na camada de aplicação (como transferências de dinheiro ou atualizações de contatos de e-mail) ou na camada de rede (como uma consulta de geolocalização baseada em IP).
Um segundo aspecto particularmente relevante da análise no framework de confiança zero é lidar com o volume e a velocidade dos dados ingeridos, que excederão a capacidade de processamento de qualquer ser humano. Portanto, é necessário algum tipo de assistência computacional para gerar insights compreensíveis para as pessoas. Mais uma vez, o nível de sofisticação dessa assistência pode ser descrito como uma progressão.
- Somente visualização: A primeira etapa consiste na apresentação simples de estatísticas e eventos, geralmente por meio de painéis disponíveis em um portal de gerenciamento. Os dados apresentados se baseiam nos fluxos de dados coletados (normalmente uma série temporal ou um corte transversal longitudinal de usuários/transações dentro de uma janela de tempo fixa). Painéis mais avançados permitem classificar e agrupar os dados, além de detalhá-los por meio de filtros. Nesse modelo, o ser humano realiza toda a exploração dos dados, a priorização de eventos, a análise e a correção, enquanto a automação auxilia principalmente na exploração dos dados.
- Visualização com regras estáticas configuráveis: A extensão mais comum da visualização é permitir que uma pessoa defina regras estáticas, seja para alertas ou para remediação. Alguns exemplos seriam: “notificar <John> se <a carga da CPU exceder 80% por um período de 5 minutos>” ou “exigir <MFA por e-mail> se <a API [Y] for invocada e o país não for [Estados Unidos]>”. Essas regras podem se limitar às opções predefinidas pelo fornecedor da solução, enquanto subsistemas mais avançados baseados em regras também podem permitir regras personalizadas criadas por um engenheiro de SecOps. Em ambos os casos, as regras aplicadas geralmente são controladas (e definidas, se necessário) por meio de configurações.
- Visualização com assistência de ML: O próximo nível utiliza técnicas mais avançadas que identificam anomalias comportamentais e/ou transações que correspondem aos padrões de transações maliciosas previamente identificadas. Embora muitas técnicas sejam utilizadas (e uma discussão aprofundada sobre as implicações técnicas e comerciais esteja fora do escopo deste artigo), há alguns pontos importantes a considerar:
- Esforço humano necessário: Algumas técnicas de ML exigem “treinamento” (também conhecido como aprendizado supervisionado), o que significa que um conjunto de dados de tamanho razoável deve ser previamente categorizado por meio de um “classificador” confiável. Muitas vezes, para garantir uma categorização confiável, o “classificador” acaba sendo uma pessoa ou um grupo de pessoas. Nesses casos, o esforço humano necessário deve ser levado em consideração. Outras técnicas (também conhecidas como aprendizado não supervisionado) detectam anomalias e/ou reconhecem padrões por conta própria, sem esforço humano.
- Explicabilidade: As saídas de um sistema de aprendizado de máquina resultam da avaliação dos dados de entrada com base em um modelo. Esse modelo pode se basear em uma série de perguntas simples e fáceis de responder, como: “Este usuário foi visto neste dispositivo no último mês?”. Também pode se basear em uma semelhança fácil de explicar, como: “Este usuário se enquadra no padrão geral que observei entre usuários que nunca fazem login durante o horário de trabalho”. Em outros casos, o modelo pode se basear na aplicação de um conjunto complexo de operações de álgebra vetorial aos dados de entrada, sem uma lógica de alto nível facilmente identificável. Esse último caso é claramente menos explicável — mais parecido com uma “caixa-preta” — do que os dois exemplos anteriores. Em alguns casos, a explicabilidade é um fator importante para a compreensão humana ou a auditabilidade. Nessas situações, um modelo explicável será muito mais desejável do que um modelo indecifrável.
- Disponibilidade de uma pontuação de confiança: Como mencionado anteriormente, uma métrica que indique o grau de confiança do modelo em uma decisão — em outras palavras, uma noção da probabilidade relativa de um falso positivo ou falso negativo — costuma ser muito útil. Em alguns algoritmos, uma métrica de confiança é gerada naturalmente como resultado; em outros, como os baseados em regras, um nível de confiança precisaria ser explicitamente especificado como uma das saídas. Em ambos os casos, os algoritmos capazes de fornecer uma pontuação de confiança são mais robustos do que aqueles que não conseguem.
Assim como na abordagem baseada em regras, o auxílio de ML pode ser usado apenas para detecção ou pode estar vinculado à correção automática. Além disso, o auxílio de ML pode ser usado em conjunto com um sistema baseado em regras, no qual o “veredito” (ou opinião ou nível de confiança) do ML pode ser usado como entrada para uma regra, como “execute a ação <X> se <o avaliador de ML [bot_detector_A] identificar um bot com nível de confiança superior a 90%>.”
Tratamento de evasões: remediação automatizada baseada em riscos
O princípio final da mentalidade de confiança zero é “presumir uma violação”. Para esclarecer e contextualizar, métodos de autenticação e controle de acesso implementados corretamente são eficazes na prevenção da grande maioria das transações maliciosas. No entanto, por excesso de cautela, deve-se presumir que os mecanismos de aplicação da autenticação e do controle de acesso serão burlados por algum adversário suficientemente motivado ou sortudo. A detecção de violações, necessária para responder a essas evasões em tempo hábil, exige visibilidade e análise assistida por máquinas. Portanto, como os demais mecanismos de aplicação serão ocasionalmente burlados, as tecnologias de visibilidade que alimentam a análise contextual assistida por aprendizado de máquina são essenciais para subsidiar a solução de segurança de último recurso da confiança zero: a remediação baseada em riscos.
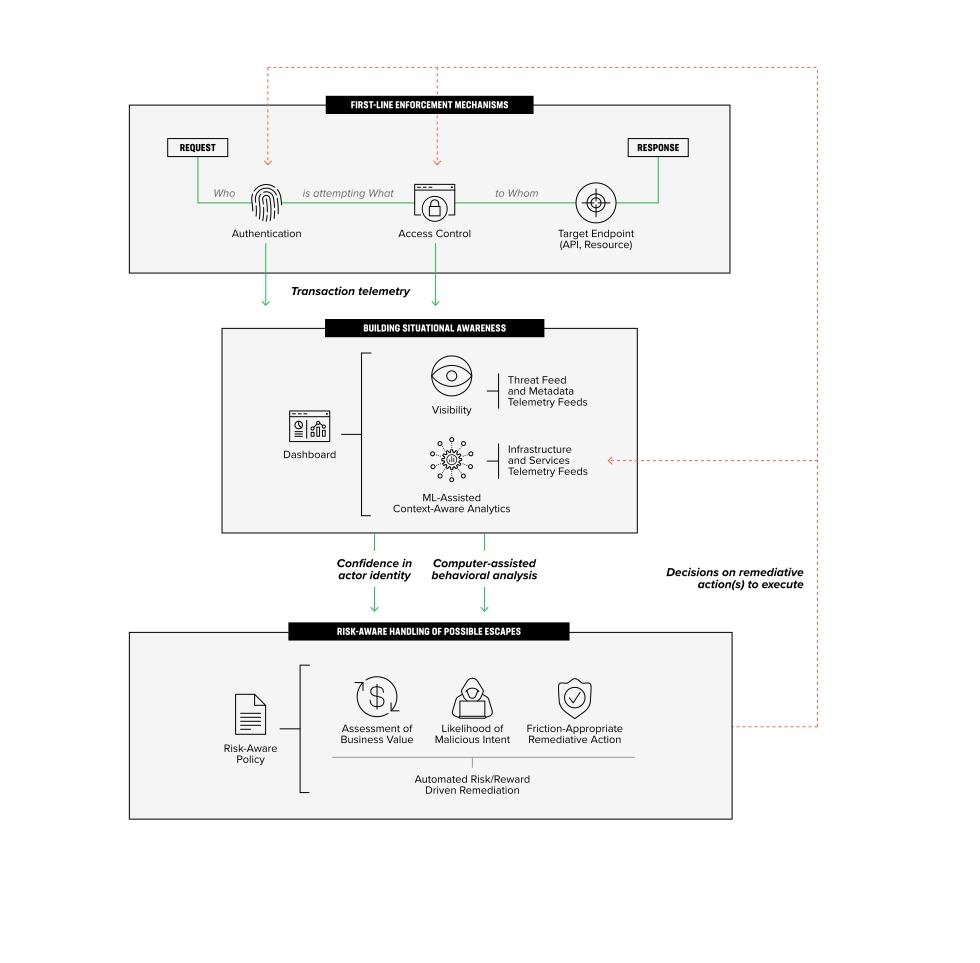
Para os casos de “falso negativo” em que uma transação realmente maliciosa conseguiu burlar a autenticação e o controle de acesso, o mecanismo de remediação automatizada baseada em riscos deve ser usado como uma proteção adicional. No entanto, como essa tecnologia é aplicada como proteção adicional contra transações que passaram pelas verificações de segurança anteriores, há uma preocupação maior com a possibilidade de classificar incorretamente o que era, na verdade, um “verdadeiro negativo” (uma transação válida e desejável) como um “falso positivo” (classificada incorretamente como uma transação maliciosa). Para mitigar essa preocupação, todas as ações de remediação acionadas pela suspeita de possível atividade maliciosa que, de alguma forma, não tenha sido detectada pela autenticação ou pelo controle de acesso devem se basear nos três fatores a seguir:4
- Valor comercial da transação: Diferentes transações terão diferentes níveis de risco e retorno. Por exemplo, uma transação de consulta a uma conta bancária apresenta menos riscos do que uma transação que transfere dinheiro para uma conta no exterior. Da mesma forma, para uma companhia aérea, a compra de uma passagem provavelmente representa uma transação com maior retorno comercial do que uma transação que apresenta os atrasos atuais dos voos. O valor comercial é o benefício do possível retorno comercial ponderado em relação ao perfil de risco da transação. É mais aceitável tolerar eventuais efeitos de “falso positivo” decorrentes de uma remediação especulativa em transações de baixo retorno e alto risco do que em transações de alto retorno e baixo risco, que têm alto valor comercial.
- Confiança na crença de “intenção maliciosa”: É claro que nem todas as sugestões de remediação especulativa são iguais. Especificamente, além da relação entre risco e recompensa mencionada acima, o outro fator fundamental é a confiança nas crenças relacionadas à transação, como a confiança na identidade atestada do agente. Em termos gerais, a probabilidade de um “falso negativo” — ou seja, a probabilidade de os mecanismos de aplicação não terem sido acionados quando deveriam — é inversamente proporcional à confiança no agente. E, como a redução de “falsos negativos” é o objetivo da remediação baseada em risco, quanto menor a confiança, maior deve ser a tendência do sistema de aplicar a remediação.
- Impacto da remediação: Por fim, nem todas as remediações se resumem a decisões binárias — permitir ou bloquear. Na verdade, há diversas técnicas possíveis para reduzir riscos, desde algumas visíveis para o usuário (por exemplo, solicitar credenciais adicionais/MFA ou apresentar um desafio, como um captcha) até outras praticamente imperceptíveis (realizar uma inspeção mais aprofundada do tráfego, como DLP, ou uma análise mais avançada e com uso intensivo de recursos computacionais). Portanto, o impacto da aplicação dessas formas adicionais de redução de riscos — medido pelo atrito enfrentado pelo usuário e pelos custos operacionais para a aplicação (como os de DLP ou de análises que exigem grande capacidade computacional) — é o terceiro fator a ser considerado. Remediações de baixo impacto e transparentes para o cliente são preferíveis a desafios de maior impacto e visíveis para o cliente, enquanto o bloqueio total da transação é a opção menos atraente. No entanto, o bloqueio pode ser adequado quando o grau de confiança é alto ou no caso de transações arriscadas em que não seja possível aumentar suficientemente a confiança por meio dos outros mecanismos de redução de riscos.
Conclusões
A segurança de confiança zero é uma abordagem mais moderna em relação a estratégias de segurança anteriores, como a defesa em profundidade, ampliando o estado da arte ao adotar uma visão da segurança centrada em transações —Quem está tentando fazer O quê a Quem. Essa abordagem permite proteger não apenas o acesso externo a uma aplicação, mas também os componentes internos da aplicação.5 Com base nessa visão transacional fundamental, a segurança de confiança zero se apoia em um conjunto de princípios essenciais usados para proteger aplicações no ambiente atual, mais complexo e desafiador. Esses princípios são então associados a um conjunto de soluções, ou métodos, no nível dos subsistemas que os incorporam. Os princípios essenciais e sua correspondência com os métodos de solução estão resumidos abaixo.
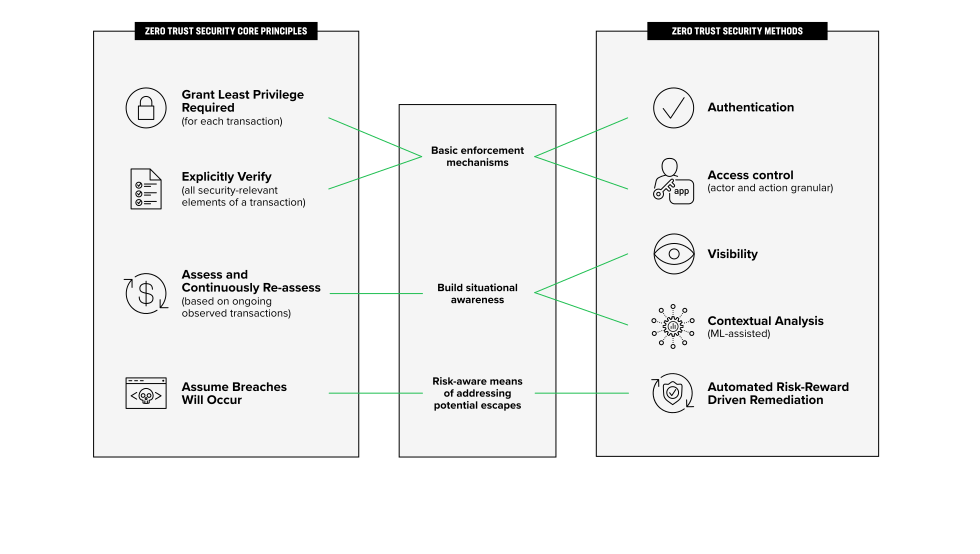
Essas ferramentas — os métodos de autenticação, controle de acesso, visibilidade, análise contextual e remediação baseada em riscos — são necessárias e suficientes para prevenir uma ampla variedade de tipos de ataque.
Recursos
1 https://www.f5.com/services/resources/white-papers/why-zero-trust-matters-for-more-than-just-access
2 A confiança zero pode, e deve, ser aplicada até mesmo “à esquerda” do pipeline de CI/CD. Ferramentas como as de avaliação de vulnerabilidades, análise estática, bancos de dados de CVE, bancos de dados de reputação de código aberto e sistemas de monitoramento da integridade da cadeia de suprimentos são compatíveis com a mentalidade de confiança zero.
3 https://cloud.google.com/beyondcorp-enterprise/docs/quickstart
4 Observe que a distinção entre o controle de acesso contextual e baseado em riscos e o tema mais amplo da remediação baseada em riscos não é muito clara, e há certa sobreposição.
5 Frequentemente chamada de proteção intra-aplicativo “Leste-Oeste”, em oposição à proteção “Norte-Sul” direcionada ao aplicativo.