Últimamente se ha hablado mucho —en consejos de administración, en presentaciones de resultados y en un flujo constante de artículos de opinión— de una única idea: la próxima gran mejora en la economía de la IA no vendrá únicamente de chips más rápidos.
El argumento es sólido, pero la lección tiene un alcance más amplio. El primer desplome del coste por token fue fruto de la combinación de avances en el silicio y el software: aceleradores más rápidos, mejores sistemas de memoria, formatos de menor precisión, PagedAttention, procesamiento continuo por lotes, optimización de la caché de claves y valores, y entornos de inferencia como vLLM. El sector mejoró drásticamente su capacidad para extraer trabajo útil de cada acelerador.
Entonces, el sector buscó el siguiente ámbito en el que aplicar el mismo rigor y lo encontró en la ruta de datos, especialmente en el almacenamiento. Esa labor es esencial, pero solo representa la mitad de la historia.
La ruta de datos es solo la mitad de la historia
El almacenamiento en una fábrica de IA ya no es pasivo. Los modelos se cargan desde él. Los puntos de control se restauran desde él. La generación aumentada por recuperación depende de él cuando existen restricciones de latencia. A una escala suficiente, los niveles de contexto y caché pueden extenderse más allá de la GPU y la memoria del sistema, ya que volver a calcular un trabajo ya completado supone un uso costoso de un acelerador.
Pero la economía de la IA está determinada por dos flujos interconectados. Uno es el movimiento de los datos que alimentan el modelo: dónde se almacenan los bytes, con qué rapidez se puede acceder a ellos y con qué frecuencia deben trasladarse. El otro es el recorrido de una solicitud de inferencia: desde un usuario, una aplicación o un agente, pasando por la gestión del tráfico y la aplicación de políticas, hasta un servidor de modelos, y de vuelta al origen.
Ese segundo flujo transporta datos en tránsito. En comparación con la computación y el almacenamiento, en muchos entornos de producción sigue midiéndose y optimizándose de forma insuficiente. Es aquí donde se decidirán las próximas mejoras —y también el próximo derroche—.
El impuesto de los tokens
En un nodo con GPU, la unidad central de procesamiento del host no está inactiva. Gestiona las comunicaciones de red, termina las conexiones de seguridad de la capa de transporte, aplica políticas, gestiona el tráfico este-oeste, genera telemetría y transfiere datos entre interfaces y aceleradores. Ninguna de estas tareas genera tokens directamente. Cuando se convierte en un cuello de botella, reduce el rendimiento útil de la inferencia.
Podríamos llamarlo el impuesto sobre los tokens: la sobrecarga de infraestructura que consume recursos del host y merma silenciosamente el rendimiento económico del nodo. La solución no siempre pasa por utilizar un procesador de host más rápido. A gran escala, las funciones de red, cifrado, gestión del tráfico y seguridad que sean aptas pueden trasladarse a la infraestructura programable que ya se encuentra en la ruta.
En las pruebas independientes realizadas por The Tolly Group por encargo de F5, F5 BIG-IP Next for Kubernetes implementado en DPU NVIDIA BlueField-3 ofreció un rendimiento de tokens hasta un 40 % mayor, un tiempo hasta el primer token un 61 % más rápido y una latencia de las solicitudes un 34 % menor que las alternativas probadas alojadas en la CPU.
La repercusión financiera es evidente. Si una infraestructura fija produce 1,4 veces más tokens comercializables dentro de los objetivos de nivel de servicio exigidos, el coste de infraestructura por token se reduce aproximadamente un 29 %. Los ingresos por acelerador también pueden aumentar cuando existe demanda. Esta afirmación resulta más útil desde el punto de vista empresarial que limitarse a decir que la red es más rápida.
El enrutamiento se convirtió en planificación
El balanceo de carga convencional distribuye las solicitudes. Esto funciona cuando las solicitudes son más o menos intercambiables. La inferencia de modelos de lenguaje de gran tamaño rompe ese supuesto, ya que el coste de una solicitud depende de la longitud del contexto, la longitud de la salida, el estado de la caché, la selección del modelo, la profundidad de la cola y la carga actual del acelerador.
- Un prompt corto con una respuesta breve puede ser varios órdenes de magnitud más barato que un contexto muy extenso con una respuesta larga.
- Una solicitud que accede a una caché de clave-valor activa puede evitar el costoso recálculo del prefill.
- Las solicitudes con una alta carga de prefill y las que requieren mucha decodificación pueden interferir entre sí cuando se ejecutan en el mismo acelerador.
- Un servidor de modelos con ocho solicitudes en cola y otro sin ninguna pueden parecer igual de saludables para una comprobación sin estado.
Un gestor de tráfico que no tenga visibilidad sobre esas condiciones tomará, por diseño, malas decisiones de asignación. El coste se manifiesta por partida doble: en la latencia que experimenta el usuario como tiempo hasta el primer token y en el recálculo que la empresa paga en forma de trabajo duplicado.
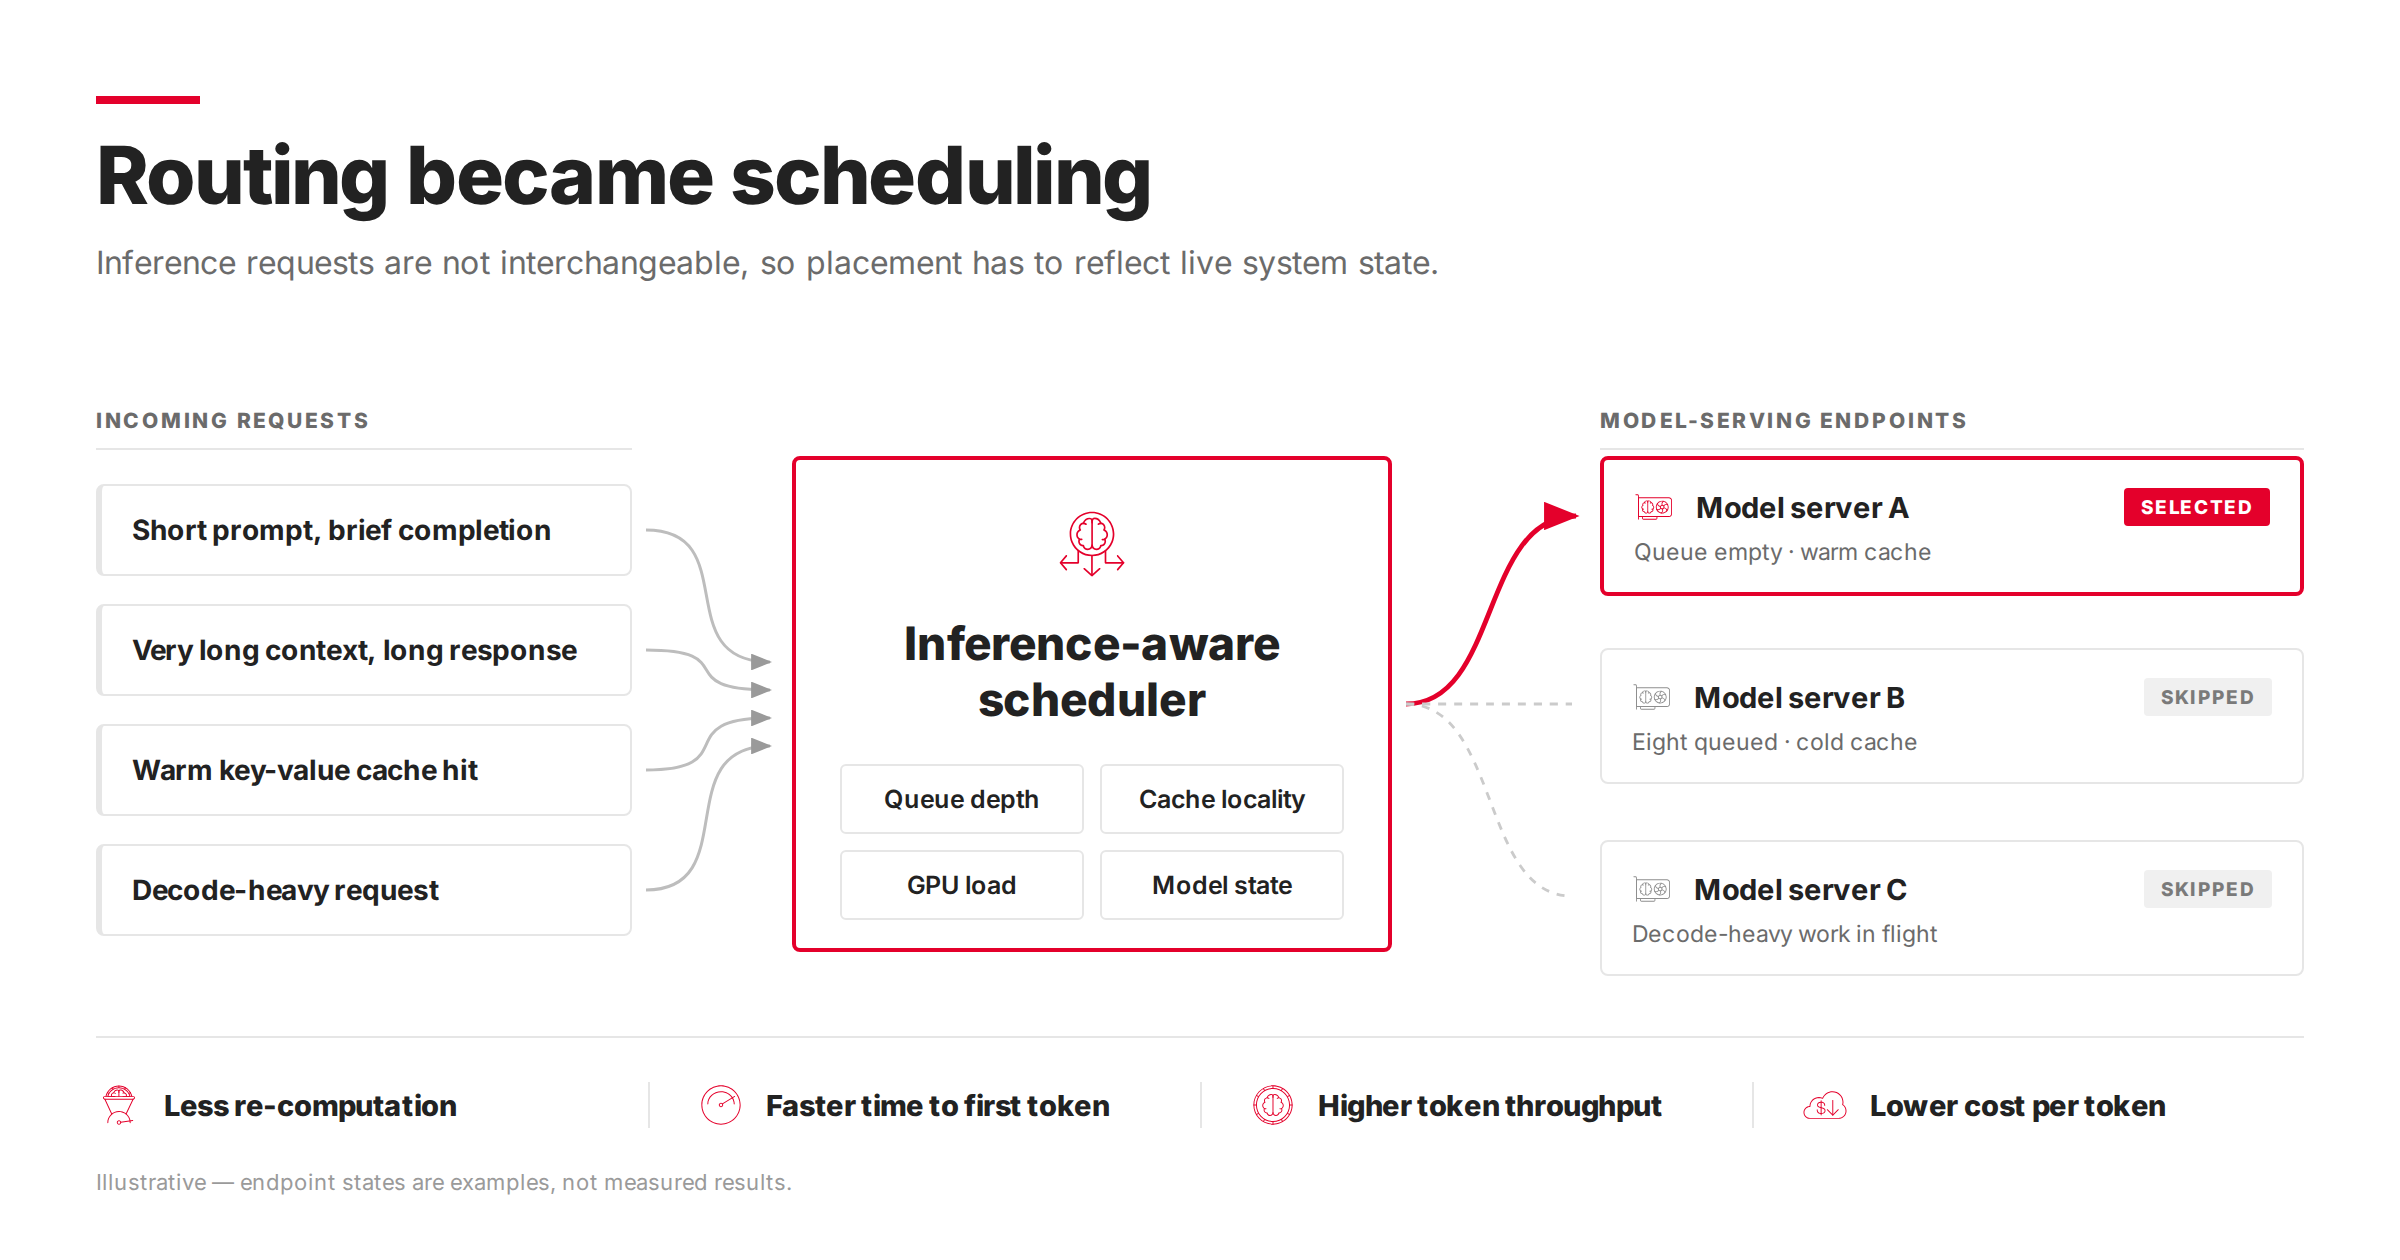
Por tanto, el enrutamiento en una fábrica de IA ya no es únicamente una función de red. Es una decisión de planificación que se toma en la red. Se beneficia de los mismos datos que necesita cualquier planificador: el estado en tiempo real del servidor de modelos, la profundidad de la cola, la telemetría de los aceleradores, la localidad de la caché y las señales en tiempo de ejecución del framework de inferencia.
La seguridad también es una función de coste
La seguridad en una fábrica de IA suele abordarse desde la perspectiva del riesgo: inyección de instrucciones, filtración de datos, agentes que exceden su autoridad y exposición a riesgos regulatorios. Todos ellos son reales. Un estudio de F5 reveló que el 88 % de las organizaciones afirma enfrentarse al menos a un reto operativo o de seguridad relacionado con la IA.
También hay un argumento relacionado con la economía unitaria. Las solicitudes bloqueadas antes de ejecutar el modelo evitan gastos de inferencia innecesarios. Las solicitudes que solo se evalúan después de generar una respuesta completa consumen recursos de computación antes de que se aplique la política. Si esto se multiplica por el tráfico de scraping, las avalanchas de reintentos, un agente atrapado en un bucle o los intentos reiterados de eludir las restricciones, la ubicación de los controles empieza a repercutir tanto en los costes como en los riesgos.
El principio no consiste en trasladar todos los controles a un único lugar. Algunas medidas de protección requieren una evaluación más exhaustiva a nivel de aplicación o de modelo, y esos controles conllevan su propio coste computacional. El objetivo es aplicar el control eficaz menos costoso lo antes posible y, después, realizar una inspección más profunda cuando aporte valor.
El tráfico generado por agentes agrava este problema. Los agentes reintentan operaciones, se ramifican y llaman a herramientas que, a su vez, llaman a modelos que llaman a otros modelos. Generan tráfico a la velocidad de las máquinas que los límites de frecuencia concebidos para una escala humana no están diseñados para absorber. El fallo no siempre se traduce en una brecha de seguridad. A veces, es simplemente una factura.
Falta la capa comercial
Si un operador no puede contabilizar los tokens por inquilino, modelo, usuario y aplicación, resulta difícil fijar precios, medir el consumo, repercutir costes, garantizar un uso equitativo o proteger el margen. La infraestructura puede ofrecer una telemetría excelente sobre el consumo eléctrico y el estado del sistema, pero una visibilidad limitada sobre la atribución de ingresos.
La multitenencia agrava el problema. Una infraestructura de GPU compartida sin un aislamiento eficaz ni una contabilización por inquilino implica que un pico de actividad de un inquilino puede provocar el incumplimiento del nivel de servicio de otro. Un vecino ruidoso en un clúster de IA no es una mera molestia de rendimiento. Puede provocar la pérdida de clientes.
La ruta de inferencia ofrece el punto de observación transversal más uniforme, ya que permite supervisar las solicitudes y respuestas de distintos usuarios, aplicaciones, modelos e inquilinos. Los servidores de modelos y los sistemas de facturación siguen siendo importantes, pero es en esta ruta donde la medición y la aplicación de políticas pueden llevarse a cabo de forma coherente.
El plano de servicio de inferencia
Al considerar estos problemas en conjunto, se perfila un tercer plano arquitectónico. El plano de computación está formado por las GPU y los aceleradores para los que todo el mundo reserva presupuesto. La ruta de datos abarca el almacenamiento, la recuperación, el almacenamiento en caché y la memoria. El plano de servicio de inferencia determina cómo llegan las solicitudes a los aceleradores, cómo se programan en función del estado real del sistema, qué se detiene antes de que consuma recursos de computación innecesarios, qué se contabiliza y a quién se factura.
Esta capa ya existe, pero a menudo como resultado fortuito de combinar distintos componentes: un equilibrador de carga por aquí, una puerta de enlace de API por allá, una malla de servicios, un cortafuegos de aplicaciones web, recopiladores de telemetría y, al final, una hoja de cálculo. Rara vez se ha diseñado como un sistema coherente, con telemetría compartida, políticas uniformes y puntos de aplicación definidos de forma deliberada.
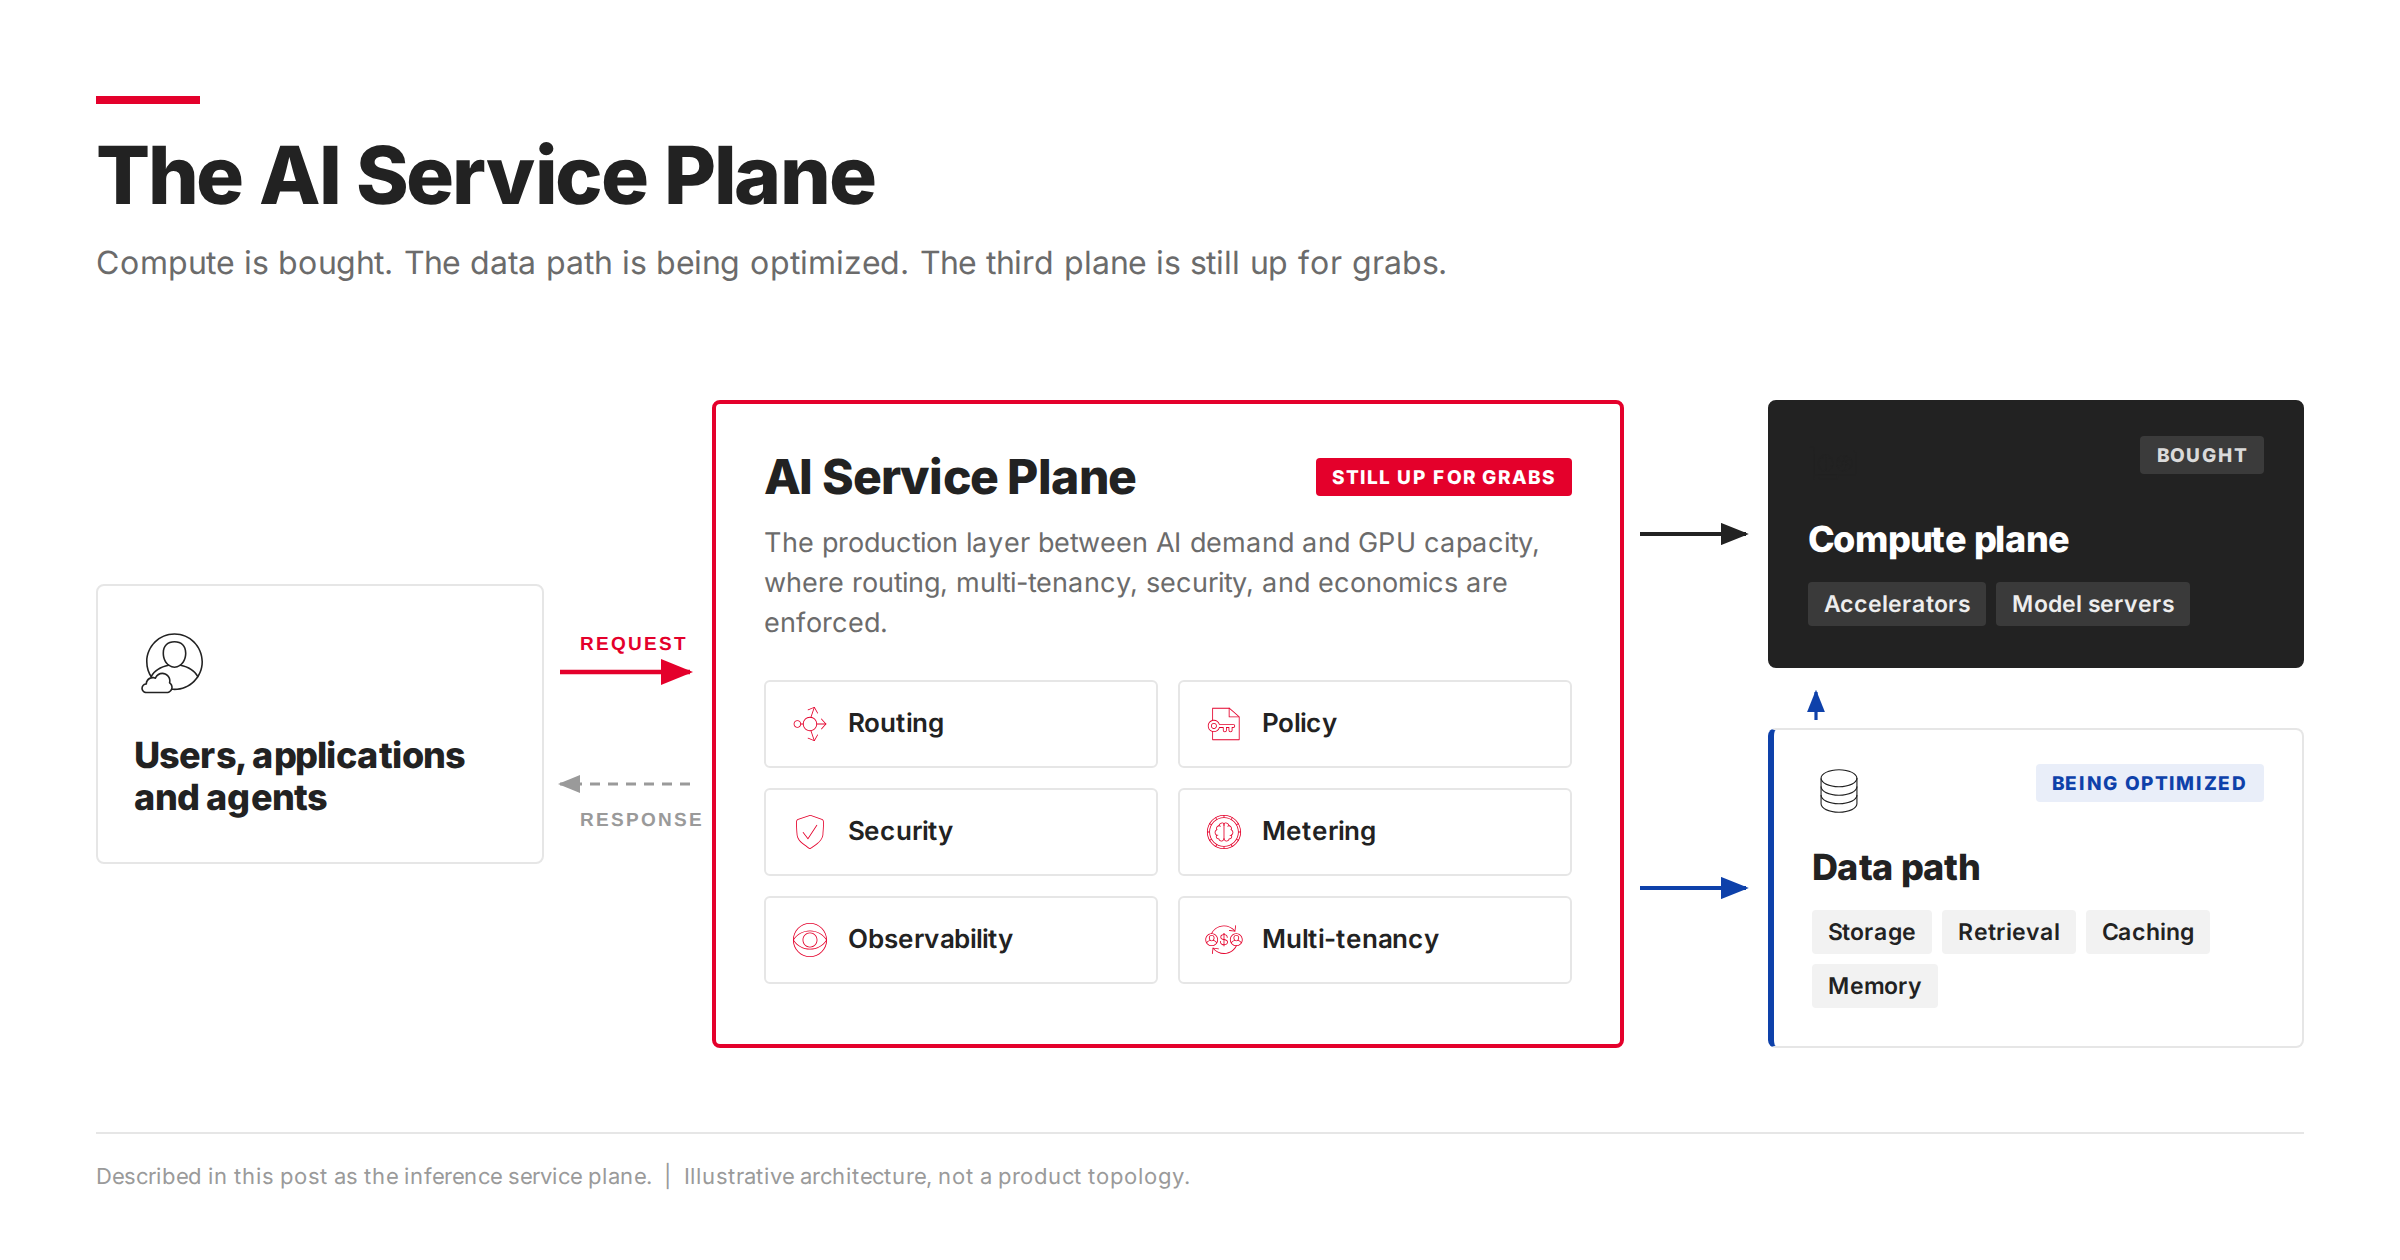
F5 BIG-IP Next for Kubernetes puede ejecutarse en el host o en DPU NVIDIA BlueField. Proporciona gestión del tráfico nativa de Kubernetes, seguridad, políticas multiinquilino, observabilidad, equilibrio de carga inteligente y gobernanza de tokens en toda la ruta de inferencia.
En la capa de aplicación, F5 AI Gateway añade gobernanza de modelos y agentes, enrutamiento, almacenamiento en caché, medición, controles de seguridad y capacidad de auditoría en prompts, respuestas, modelos y herramientas.
La orientación arquitectónica importa más que cualquier producto concreto: hay que definir claramente las políticas, aplicarlas donde resulten más eficaces y compartir la telemetría entre las capas de infraestructura y de aplicación. Así es como los operadores reducen los puntos ciegos y evitan que distintos equipos mantengan controles divergentes.
Diseña la ruta de forma deliberada
Hay tres preguntas que deben plantearse en la próxima revisión de la infraestructura de IA. ¿Cuál es el rendimiento de tokens útiles de la capacidad de aceleración ya aprovisionada? ¿Cuánto procesamiento del host se destina a tareas que no generan tokens directamente? ¿Qué coste tiene una solicitud rechazada cuando llega a la ejecución del modelo antes de que se apliquen las medidas de control?
En todo el sector, la conversación está pasando de la capacidad a la conversión: de qué infraestructura se posee a qué se puede obtener de ella de forma fiable. La próxima gran mejora en la economía de la IA no vendrá únicamente de chips más rápidos ni del almacenamiento por sí solo. Vendrá de tratar la ruta de inferencia como un sistema económico.
El plano de computación ya está adquirido. La ruta de datos se está optimizando. El plano de servicios de inferencia aún está por definir.
Para obtener más información, lea el informe sobre el rendimiento de la IA.
Sobre el autor
Artículos relacionados del blog

IA agéntica en ciberseguridad: promesas y riesgos
Descubre por qué el uso de la IA agéntica en ciberseguridad es esencial para combatir las amenazas impulsadas por IA y por qué los agentes también generan nuevos riesgos empresariales.

Cómo los clientes de F5 del sector financiero abordan la soberanía digital sin frenar la innovación
¿Cómo se materializa la soberanía digital en el mundo real? Dos proyectos recientes de F5 con clientes muestran cómo distintas empresas están afrontando estos retos.

Soberanía operativa: cómo desarrollar resiliencia en un mundo impredecible
Para muchas organizaciones, la cuestión ya no consiste únicamente en controlar los datos, sino en mantener la capacidad de operar, adaptarse y recuperarse a medida que evolucionan las leyes y las circunstancias.

No se puede proteger una conversación con un cortafuegos: cómo el red teaming de IA se volvió esencial
Dado que las implementaciones de IA avanzan a la velocidad de las máquinas, los métodos tradicionales de prueba de software ya no resultan adecuados.

Protege tu canalización de datos de IA sin ralentizarla
Proteger el flujo de datos de la IA no es opcional. Eso está claro. Lo que resulta mucho menos evidente —y mucho más difícil— es cómo protegerlo adecuadamente.

Las extranets no están muertas; solo necesitan una actualización
Modernice su extranet: descubra cómo F5 y Equinix ofrecen una conectividad para partners repetible, segura y escalable, sin la complejidad de las redes tradicionales.