En toda tendencia tecnológica siempre hay términos que rápidamente generan tantas expectativas que pueden llegar a carecer prácticamente de utilidad. Al principio, la nube fue uno de ellos. En cierto modo, todavía lo es. DevOps tardó varios años en definirse (si es que realmente lo ha hecho). Actualmente, el aprendizaje automático y la IA surfean descalzos la ola de las expectativas y no parece que vayan a caerse de ella a corto plazo.
Pisándoles los talones a todos ellos está «como código».
De repente, todo es «como código». El mercado no se cansa del «como código», aunque la mayoría ni siquiera sepa distinguir entre C, C++ y C#. El «como código» se ha convertido en la respuesta a la vida, el universo y todo lo demás. No hay problema que el «como código» no pueda resolver, y todo el mundo lo está haciendo.
Cuando se utilizan términos sin límites ni definiciones claras, es importante que nos detengamos y nos aseguremos de tener claras *nuestras* definiciones. Estaría bien que existiera un comité de normalización con una definición al estilo de las RFC que pudiéramos consultar, pero no lo hay. Lo más parecido que tenemos es el NIST, y ya vimos lo bien que consiguió resolver el dilema de la nube.
El concepto «como código» abarca mucho más que la infraestructura como código (IaC). Aiman Najjar, de Pythian, escribió un excelente resumen del panorama actual de la infraestructura como código. Aunque no estoy de acuerdo con que los contenedores deban constituir una capa propia (desde la perspectiva de la red y los servicios de aplicaciones, no son más que infraestructura) ni con que Jenkins no tenga cabida, en general su blog ofrecía una forma excelente de entender la relación entre las distintas capas «como código» y de asignar las herramientas adecuadas a cada tarea. Además, la mayoría de los debates sobre infraestructura como código se centran en la entrega continua, es decir, en el proceso que compila, prueba, integra y publica una aplicación en producción. No es lo mismo que el despliegue continuo, que se centra en tomar la aplicación publicada y desplegarla en un entorno de producción junto con los servicios de red y de aplicaciones que necesita.
NOTA En la utopía de las aplicaciones, los procesos de entrega y despliegue están integrados. Pero la mayoría de nosotros (todavía) vivimos en la realidad de las aplicaciones, donde los entornos de producción y desarrollo están separados y tienen distintos requisitos y limitaciones. De ahí la necesidad de reconocer esta separación al automatizar el proceso.
Existen tres capas diferenciadas que surgen para abordar las peculiaridades inherentes a las TI y al proceso de despliegue. La principal es la complejidad propia del entorno. Esa línea recta entre el cliente y la aplicación que dibujamos en los diagramas de red no engaña a nadie. Bajo el capó ocurren muchas más cosas de las que tenemos tiempo (y paciencia) para representar en un diagrama.
La propia diversidad de la canalización —que comprende tanto hardware diseñado específicamente como software virtual y basado en contenedores desplegado en equipos COTS— también justifica la división del enfoque «como código» en capas independientes. Si bien es cierto que el hardware más moderno puede gestionarse mediante un enfoque como código, integrar el hardware heredado (compartido) en el proceso puede resultar prácticamente imposible. Por tanto, separar las capas para reflejar mejor el propio proceso de despliegue puede permitir incluir en la canalización tanto soluciones basadas en hardware heredado y moderno como servicios basados en software.
El objetivo es crear una pila de TI continua capaz de admitir calendarios de despliegue y arquitecturas específicos para cada aplicación en un entorno multinube. Y dado que el despliegue es solo el comienzo del ciclo de vida activo de una aplicación, se necesita una cuarta capa centrada en las operaciones posteriores al despliegue. Esta se suma a las tres capas principales, que abarcan el aprovisionamiento y la incorporación de la infraestructura, la configuración y gestión de servicios y el proceso de despliegue.
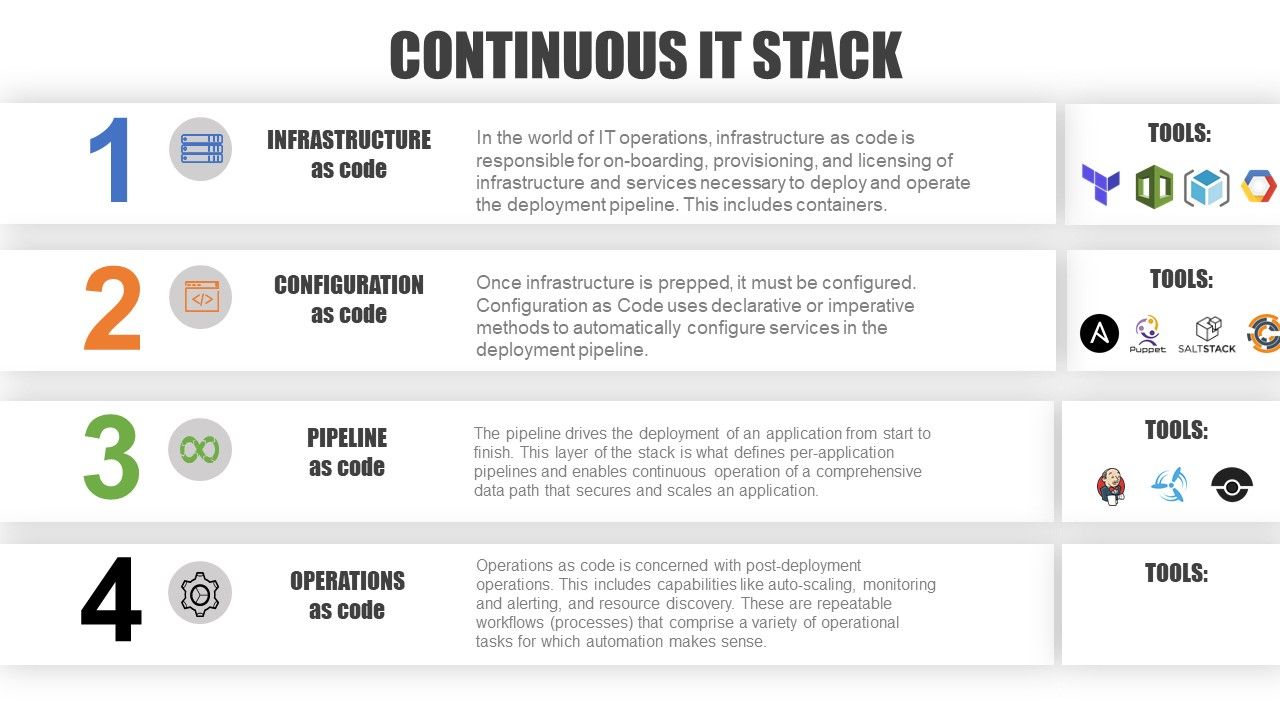
La lista de herramientas no debe considerarse exhaustiva. Existen muchas otras herramientas y conjuntos de herramientas. Por ejemplo, sabemos por múltiples encuestas y estudios que la mayoría de los profesionales de NetOps prefieren scripts de Python a medida para automatizar los servicios de red y de aplicaciones. También sabemos que los sistemas y las pilas de automatización de redes, como Cisco ACI, VMware NSX, OpenStack y Red Hat OpenShift, son medios populares para implementar muchas funciones de la pila de operaciones continuas. Sencillamente, no hay espacio suficiente en el gráfico para incluir todas las herramientas, por lo que se ha incluido una muestra basada en la popularidad de estas entre los profesionales de DevOps. Esto se debe a que la estandarización en todo el proceso de entrega y despliegue será un componente esencial para el éxito, y resulta difícil cuestionar el aprovechamiento de las competencias y la experiencia ya existentes en la organización mediante las herramientas más utilizadas para implementar procesos de entrega «como código». Cabe señalar que no he enumerado ninguna herramienta para las «operaciones como código», ya que muchas de ellas son soluciones a medida (scripts personalizados) o específicas de la tecnología de un proveedor, al menos por ahora.
NOTA Las operaciones como código son el equivalente en TI de la gestión de procesos de negocio (BPM). Con la BPM, los procesos de negocio se automatizan. Algunas soluciones de BPM se centran únicamente en flujos de trabajo muy específicos, mientras que otras pueden abarcar toda la interacción con el cliente, desde la compra hasta el pago y la entrega. Actualmente, las operaciones como código son una práctica incipiente en el ámbito de las TI, pero deberán evolucionar hacia la gestión de procesos operativos para que las empresas puedan aprovechar la optimización de dichos procesos del mismo modo que han aprendido a sacar partido de la BPM.
Pila de operaciones continuas
Infraestructura como código (IaC)
Ya sea en la nube o en el centro de datos, sigue habiendo una red que debe configurarse. Incluso los servicios de nivel superior (los que operan en las capas 4-7, también conocidos como servicios de aplicaciones) necesitan cierto conocimiento de la topología de red para funcionar. Es posible que algunos deban activarse (es decir, obtener una licencia) si se está implementando una canalización completamente nueva. La infraestructura como código es necesaria para adoptar un enfoque de autoservicio en la implementación, ya que, sin la infraestructura (software y servicios) necesaria, no hay nada que configurar ni donde implementar una aplicación.
Responsabilidades: infraestructura incorporación, concesión de licencias y aprovisionamiento
Configuración como código (CaC)
Esta es una cuestión distinta de la configuración, que se refiere específicamente a la necesidad de configurar las políticas y el comportamiento propios del servicio en cuestión. Puede ser necesario volver a configurar el servicio con cada actualización importante de la aplicación, e incluso con cada actualización menor. En el caso de los servicios relacionados con la seguridad, puede ser necesario hacerlo con carácter urgente para aplicar parches, actualizar o mejorar un servicio determinado. La configuración como código es fundamental para admitir calendarios y canalizaciones de despliegue específicos para cada aplicación, así como para garantizar el aislamiento de las rutas de datos de las aplicaciones, algo esencial para asegurar la estabilidad de la canalización de producción en su conjunto.
Responsabilidades: configuración del servicio y actualización y aplicación de parches
Pipeline como código (PaC)
Luego está el proceso global que define toda la aplicación y sus servicios de principio a fin. Se trata del pipeline completo, codificado en un proceso ejecutable que impulsa automáticamente el despliegue. El pipeline como código es el vínculo entre IaC y CaC que integra ambos conceptos para conformar lo que denominamos un pipeline de despliegue. Es en este pipeline donde se obtienen las mayores mejoras de velocidad y eficiencia, ya que permite eliminar los tiempos de espera entre los distintos pasos necesarios del proceso.
Responsabilidades: automatización del proceso de despliegue
Operaciones como código (OaC)
Esta capa es la capa operativa continua. En ella tienen lugar la supervisión y las alertas, el escalado automático y la detección. En esta capa, nos centramos en codificar los procesos operativos en un sistema capaz de ejecutarlos de forma autónoma. El escalado automático es uno de los procesos operativos que se codifican con mayor frecuencia e implica varios sistemas. Sin embargo, la recopilación de telemetría para su análisis es otro proceso operativo que requiere atención, al igual que las posibles acciones que se llevan a cabo a partir de dicha telemetría y que permiten realizar ajustes (automáticos) para optimizar la ruta de datos o el rendimiento de las aplicaciones. Estos procesos operativos tienen su propia configuración y entran en juego después de que se complete el proceso de despliegue.
Responsabilidades: automatización del flujo de trabajo operativo
Analizar el despliegue continuo desde la perspectiva de la pila de operaciones continuas puede proporcionar un enfoque estratégico para automatizar el proceso de producción. Al separar las capas y las responsabilidades, resulta más fácil abordar la abrumadora tarea de automatizar las funciones de TI de una forma que permita adoptar el modelo de autoservicio que muchas organizaciones desean y que el negocio exige cada vez más. También abre el camino hacia las operaciones continuas mediante las operaciones como código, una evolución necesaria en el uso de la automatización dentro de TI.
Ahora bien, puede que esta no sea la «única forma correcta» de entender las iniciativas de automatización asociadas al proceso de despliegue. Pero es una forma de hacerlo y permite que los actores del mercado expresen claramente qué hacen y qué no.
Significa que puede tener la certeza de a qué me refiero cuando digo «infraestructura como código» o «configuración como código», especialmente en lo que respecta a los productos de F5.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.