
Este artículo es el primero de una serie en la que abordamos distintos aspectos de lo que supuso crear y gestionar nuestro servicio SaaS :
- Plano de control para una PaaS de Kubernetes distribuida
- Malla de servicios global para aplicaciones distribuidas
- Seguridad de la plataforma para infraestructuras, aplicaciones y datos distribuidos
- Seguridad de las aplicaciones y la red de clústeres distribuidos
- Observabilidad en toda una plataforma distribuida globalmente
- Operaciones y SRE de una plataforma distribuida globalmente
- Framework de servicios en Golang para microservicios distribuidos
Como describimos en nuestro blog anterior, nuestros clientes están desarrollando conjuntos complejos y diversos de soluciones empresariales —como fabricación inteligente, análisis forense de vídeo para la seguridad pública, negociación algorítmica y redes 5G de telecomunicaciones—, por lo que debemos ofrecer una experiencia siempre disponible, conectada y fiable para estas aplicaciones y sus usuarios finales.
Dado que estas aplicaciones podían ejecutarse en varios clústeres distribuidos entre distintos proveedores de servicios en la nube o ubicaciones en el extremo de los clientes, nuestro equipo de plataforma tuvo que crear un plano de control distribuido y un servicio PaaS para desplegar, proteger y operar varios clústeres de Kubernetes multiinquilino. Este plano de control distribuido ha aportado numerosas ventajas operativas, de escalabilidad y de rendimiento que abordaremos en nuestra presentación (enlace al vídeo): por ejemplo, cómo gestionar miles de clústeres de K8s en el extremo con GitOps. También trataremos este tema en una entrada independiente del blog durante las próximas semanas.
TL;DR (Resumen)
- No encontramos en el mercado una solución fácil de usar que permitiera resolver el problema de desplegar, proteger y operar varios clústeres de aplicaciones distribuidos entre proveedores de servicios en la nube, nubes privadas o múltiples ubicaciones en el extremo de la red.
- No pudimos encontrar una distribución sólida de Kubernetes ni una PaaS (p. ej., OpenShift, Cloud Foundry, etc.) que ofreciera un conjunto completo de servicios operativos y de seguridad necesarios para clústeres distribuidos, como identidad basada en PKI, RBAC y gestión del acceso de usuarios, gestión de secretos y claves entre proveedores de nube, una malla de servicios multiclúster, observabilidad y registros de auditoría, o seguridad de aplicaciones y redes.
- Anthos (Google), Azure Arc (Microsoft) y Rancher son plataformas de gestión multiclúster que agrupan varios servicios diferentes; nuestro análisis concluyó que no habrían satisfecho los requisitos operativos, de escalabilidad, seguridad y multitenencia que teníamos para los servicios de aplicaciones e infraestructura en varios clústeres.
- Tuvimos que crear nuestro propio plano de control distribuido para nuestra PaaS gestionada, basada en Kubernetes. Partimos de una instalación estándar de Kubernetes y después introdujimos cambios importantes para ofrecer los servicios de plataforma que necesitaban nuestros equipos de DevOps y SRE. Además, tuvimos que crear un plano de control para gestionar un gran número de clústeres distribuidos y ofrecer multitenencia en infraestructuras heterogéneas (en el edge, en nuestra red y en varios proveedores de nube).
Kubernetes para la gestión de aplicaciones: por qué y cómo
Elegimos Kubernetes (K8s) como núcleo de nuestra plataforma para gestionar aplicaciones distribuidas, ya que ofrece un amplio conjunto de funcionalidades sin imponer demasiadas restricciones, lo que nos da flexibilidad para innovar en aspectos que consideramos importantes para nuestros clientes. Lo utilizamos como base sobre la que empezar a desarrollar nuestro servicio y, gracias a la creciente popularidad de K8s, también resulta más fácil encontrar desarrolladores y operadores familiarizados con esta tecnología.
Dicho esto, desplegar y gestionar un gran número de clústeres de Kubernetes aptos para producción en un entorno híbrido (varias nubes, puntos de presencia de red y ubicaciones en el extremo) no resulta sencillo, ya que Kubernetes no ofrece soluciones listas para usar que permitan:
- Armonizar recursos de infraestructura heterogéneos mediante la creación automatizada de clústeres, el escalado y el aprovisionamiento sin intervención; esto resultaba especialmente problemático en el extremo de la red y en nuestros PoP de red
- Proporcionar una conectividad fiable y de alto rendimiento entre ubicaciones dispares, especialmente al atravesar distintos proveedores de servicios en la nube y al conectarse desde ubicaciones periféricas
- Resolver el problema de seguridad de los datos en tránsito, los datos en reposo, los secretos, las claves y la red… todo ello respaldado por una identidad PKI uniforme que funciona en el extremo, la red y la nube
- Ofrezca una auténtica arquitectura multiinquilino —con aislamiento entre inquilinos y garantías de seguridad— que permita ejecutar cargas de trabajo de producción y desarrollo para satisfacer las necesidades internas y de los clientes en los mismos clústeres
- Proporcionar observabilidad y operaciones en clústeres distribuidos, vinculadas a políticas e intenciones centralizadas, sin necesidad de crear complejos sistemas de recopilación de registros y métricas
Tras realizar varias pruebas de concepto con distintos proveedores de servicios en la nube y plataformas de código abierto como GKE, AKS, EKS y RKE, además de OpenShift y Cloud Foundry, nos dimos cuenta de que ninguna de ellas podía cumplir los cinco requisitos anteriores. Por ello, decidimos crear nuestra propia PaaS, partiendo de una versión «estándar» de Kubernetes e incorporando diversas funcionalidades de identidad, redes, seguridad, multitenencia, registro, métricas, etc. Aunque utilizamos Kubernetes para satisfacer nuestras necesidades internas, tuvimos que tomar algunas decisiones difíciles, como no exponer estos clústeres de Kubernetes directamente a nuestros usuarios internos o clientes para que ejecutaran sus cargas de trabajo (hablaremos de ello más adelante, ya que la multitenencia era un objetivo clave para nosotros).
Además de las numerosas funciones nuevas que necesitábamos añadir, también teníamos que ejecutar nuestras cargas de trabajo y servicios junto con las cargas de trabajo de los clientes en numerosas ubicaciones del extremo de la red, nuestra propia red y nubes públicas y privadas. Esto implicaba desarrollar capacidades adicionales para gestionar varios clústeres en múltiples entornos, todos ellos conectados mediante nuestra red global y nuestras puertas de enlace de aplicaciones distribuidas, a fin de proporcionar conectividad de confianza cero y a nivel de aplicación entre estos clústeres.
La parte difícil: multitenencia y múltiples clústeres para Kubernetes
Crear y operar aplicaciones que se ejecutan en un único clúster de Kubernetes es una tarea compleja, incluso cuando se utiliza un clúster gestionado por un proveedor de servicios en la nube. Por eso, es habitual que los equipos de DevOps y SRE intenten reducir al mínimo la carga operativa y eviten lidiar con la complejidad que supone gestionar numerosos clústeres. Es bastante frecuente que los equipos creen un gran clúster de Kubernetes y alojen en él todo tipo de recursos. Aunque esto puede parecer una buena opción, ya que permite simplificar las operaciones y ejecutar el clúster con la máxima eficiencia de computación y costes, no es la mejor idea por varios motivos. En primer lugar, las necesidades de las cargas de trabajo de producción son muy distintas de las de desarrollo y pruebas, así como de las de preproducción: las cargas de trabajo de desarrollo inestables pueden causar problemas a las cargas de producción, que son más estables.
Además de las necesidades de las distintas cargas de trabajo, las limitaciones de seguridad y aislamiento de K8s son otro factor que impulsa el uso de varios clústeres. Un enfoque habitual para resolver los problemas de seguridad y aislamiento de recursos en K8s consiste en crear clústeres independientes para cada inquilino mediante un modelo multiinquilino. Aunque esto puede ser viable en la nube, no es posible ejecutar varios clústeres en el extremo de la red. Las ubicaciones en el extremo tienen recursos informáticos y de almacenamiento limitados, así como un ancho de banda de red restringido para enviar los registros y las métricas de cada clúster adicional a la nube central.
Para abordar el problema de tener varios clústeres de Kubernetes, evaluamos Rancher para gestionar de forma centralizada nuestros clústeres de Kubernetes (cuando empezamos, Anthos y Azure Arc no existían), así como KubeFed. Los dos enfoques disponibles en aquel momento eran los siguientes (y la situación sigue siendo la misma hoy en día):
- La gestión multiclúster (p. ej., Rancher) desde una consola central nos habría permitido desplegar varios clústeres en cualquier ubicación y realizar operaciones de gestión del ciclo de vida, como actualizaciones, reversiones, etc. Algunos de estos sistemas también permitían gestionar un clúster concreto mediante la automatización de la configuración y el despliegue de aplicaciones
- Otro enfoque consiste en desplegar un plano de control de federación de clústeres de Kubernetes (KubeFed), que permite que varios clústeres físicos parezcan uno solo. Este proyecto apenas estaba comenzando cuando lo evaluamos y, aún hoy, solo se encuentra en fase alfa.
Tras el reciente anuncio de GCP Anthos y Azure Arc, reevaluamos nuestra decisión inicial de crear un plano de control distribuido y llegamos a la conclusión de que ni siquiera estas dos nuevas soluciones habrían podido resolver dos problemas críticos de los clústeres distribuidos. Estas eran las dos capacidades clave que necesitábamos para nuestra plataforma:
- Gestionar varios clústeres como una flota para resolver el problema de realizar operaciones en todos los clústeres o en un grupo lógico de ellos, como operaciones de configuración, despliegue, métricas, etc. Esto es fundamental, ya que queremos reducir la carga operativa de nuestros equipos de SRE, facilitar la depuración para nuestros equipos de DevOps y mejorar la escalabilidad de nuestro sistema.
- Capacidad de dividir un clúster físico individual de Kubernetes para permitir la tenencia múltiple sin necesidad de poner en marcha clústeres físicos; esto resulta especialmente importante en entornos con recursos limitados, donde no queremos añadir nuevos clústeres físicos únicamente para habilitar la tenencia múltiple.
Para resolver estos dos problemas, tuvimos que idear una nueva técnica —el plano de control distribuido— que redujera la sobrecarga operativa de gestionar «varios» clústeres y ofreciera un equivalente a «varios clústeres» para entornos multiinquilino con recursos limitados.
Plano de control distribuido: cómo logramos un Kubernetes multiclúster
Nuestro equipo de plataforma decidió crear un plano de control distribuido para Kubernetes que expone las API de Kubernetes para que nuestro equipo pueda utilizarlas. Sin embargo, estas API proceden de clústeres «virtuales» que solo existen en nuestro plano de control: un servidor de API de K8s virtual (vK8s) para un clúster de K8s virtual (como se muestra en la Figura 1). Este plano de control traduce la intención del usuario en acciones sobre varios clústeres físicos de Kubernetes que se ejecutan en nuestra infraestructura perimetral, en los puntos de presencia (POP) de nuestra red y en ubicaciones de nube pública. Solo nuestro plano de control distribuido puede acceder a estos clústeres físicos; ningún inquilino o usuario individual puede hacerlo.
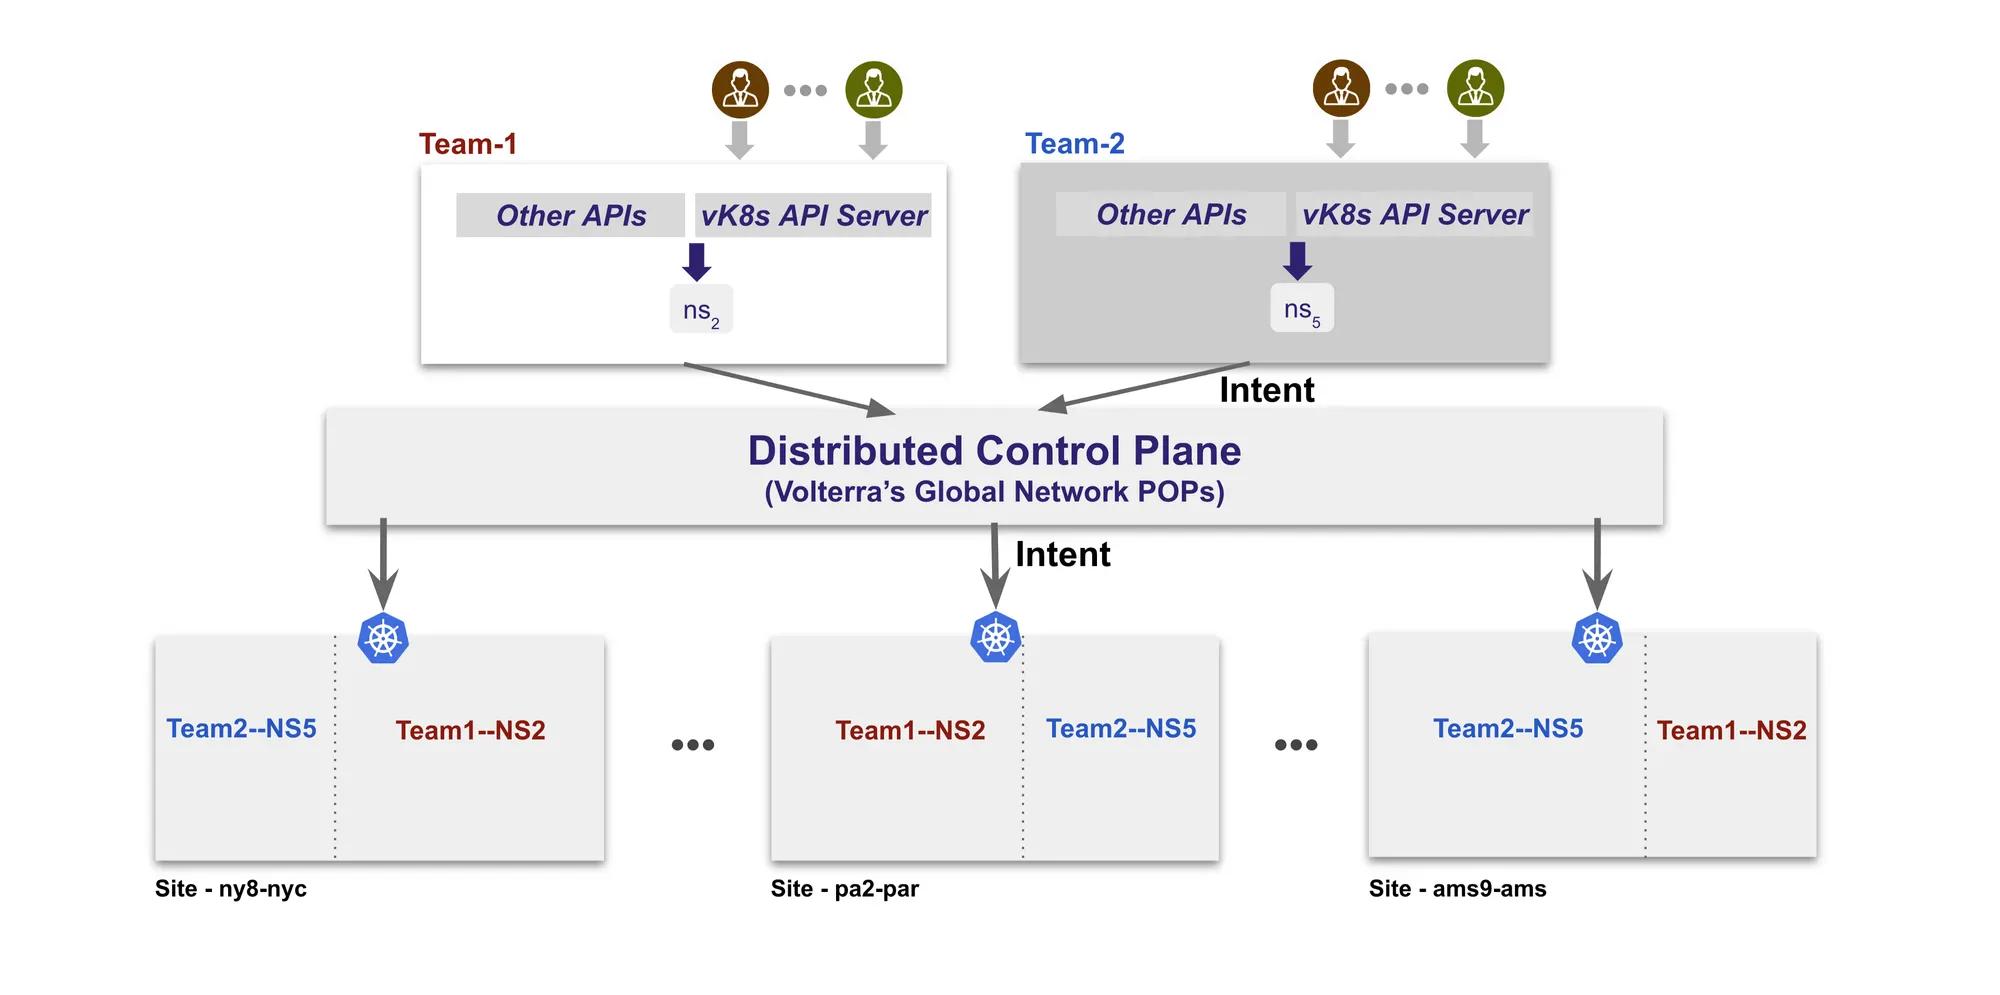
Este plano de control proporciona a cada inquilino uno o varios clústeres de aplicaciones «virtuales» en los que puede desplegar sus aplicaciones. En función de la configuración, el plano de control las replicará y gestionará en varios clústeres físicos de Kubernetes. Además de las operaciones de configuración y despliegue, las operaciones de supervisión también se realizan sobre este clúster «virtual», sin necesidad de crear herramientas para recopilar y analizar datos de varios clústeres físicos.
Tomemos como ejemplo una aplicación de interfaz de usuario llamada productpage, que el usuario quiere ejecutar de forma distribuida en tres ubicaciones —pa2-par, ny8-nyc y ams9-ams—, con dos réplicas en cada una. Cuando el usuario crea un objeto vK8s y lo vincula a un clúster virtual, se aprovisiona inmediatamente un servidor de API de vK8s que puede utilizarse con el kubectl estándar.
Como siguiente paso, el usuario descarga el kubeconfig de este clúster virtual y crea un archivo YAML estándar para describir un despliegue de K8s para productpage.
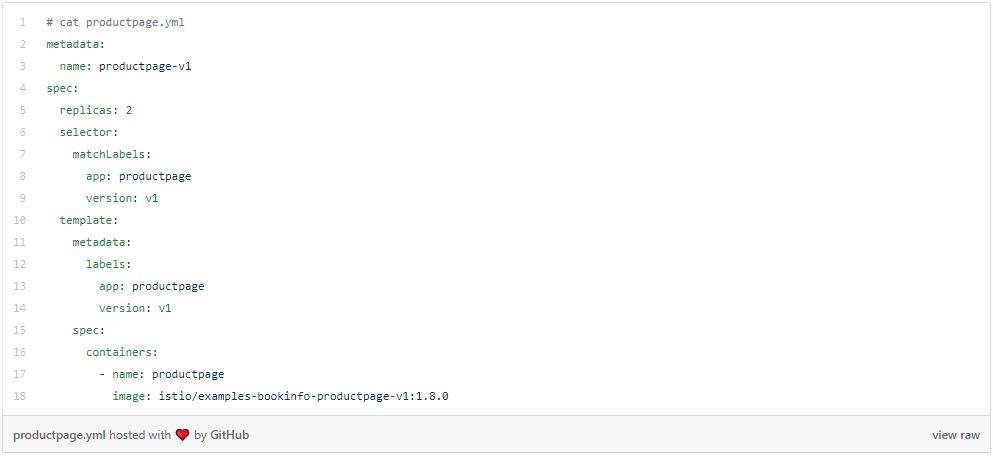
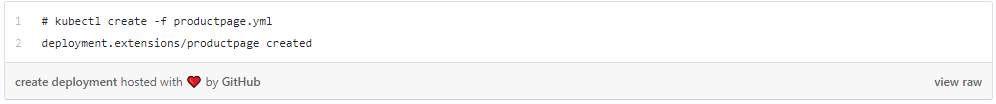
Tras crear la especificación de despliegue, el usuario puede proceder a crear un despliegue en este clúster virtual:
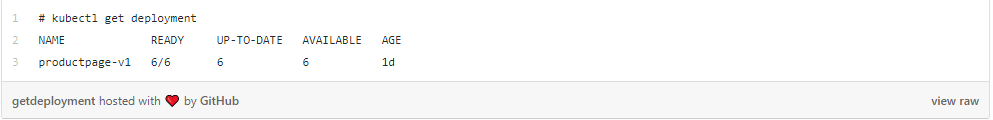
Ahora, si el usuario comprueba su despliegue, verá que se han iniciado 6 réplicas, 2 en cada ubicación (pa2-par, ny8-nyc y ams9-ams).
La siguiente salida muestra dos pods ejecutándose en cada ubicación y su correspondencia con un nodo físico concreto
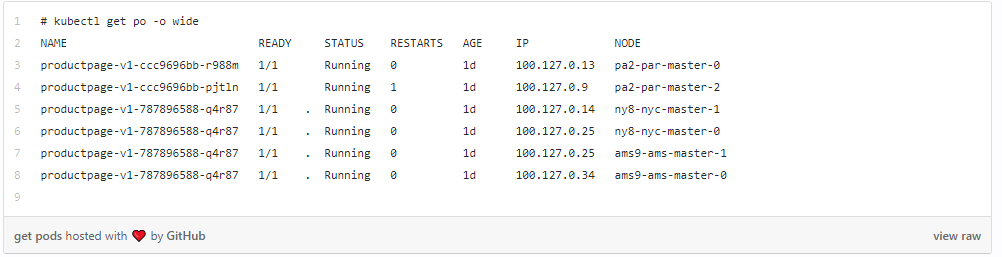
Este sencillo ejemplo demuestra lo fácil que es replicar cualquier aplicación en varios clústeres en cuestión de minutos, sin la carga que suponen la instalación y la gestión. Además de plasmar la intención, el plano de control distribuido también proporciona observabilidad para el clúster virtual en su conjunto, en lugar de hacerlo para cada clúster por separado.
Control distribuido y gestión centralizada para entornos multiinquilino
Como puede verse en la Figura 2, nuestro plano de gestión centralizado se ejecuta en dos proveedores de nube pública (una región en cada uno): uno en AWS y otro en Azure (para garantizar la redundancia). Este plano de gestión permite a nuestro equipo de SRE crear tenants con aislamiento estricto; por ejemplo, un equipo de desarrollo que trabaje en nuestro servicio VoltMesh puede ser un tenant, mientras que un equipo de soluciones para clientes que trabaje en pruebas de concepto (POC) para clientes puede ser otro tenant independiente con su propio conjunto de usuarios.
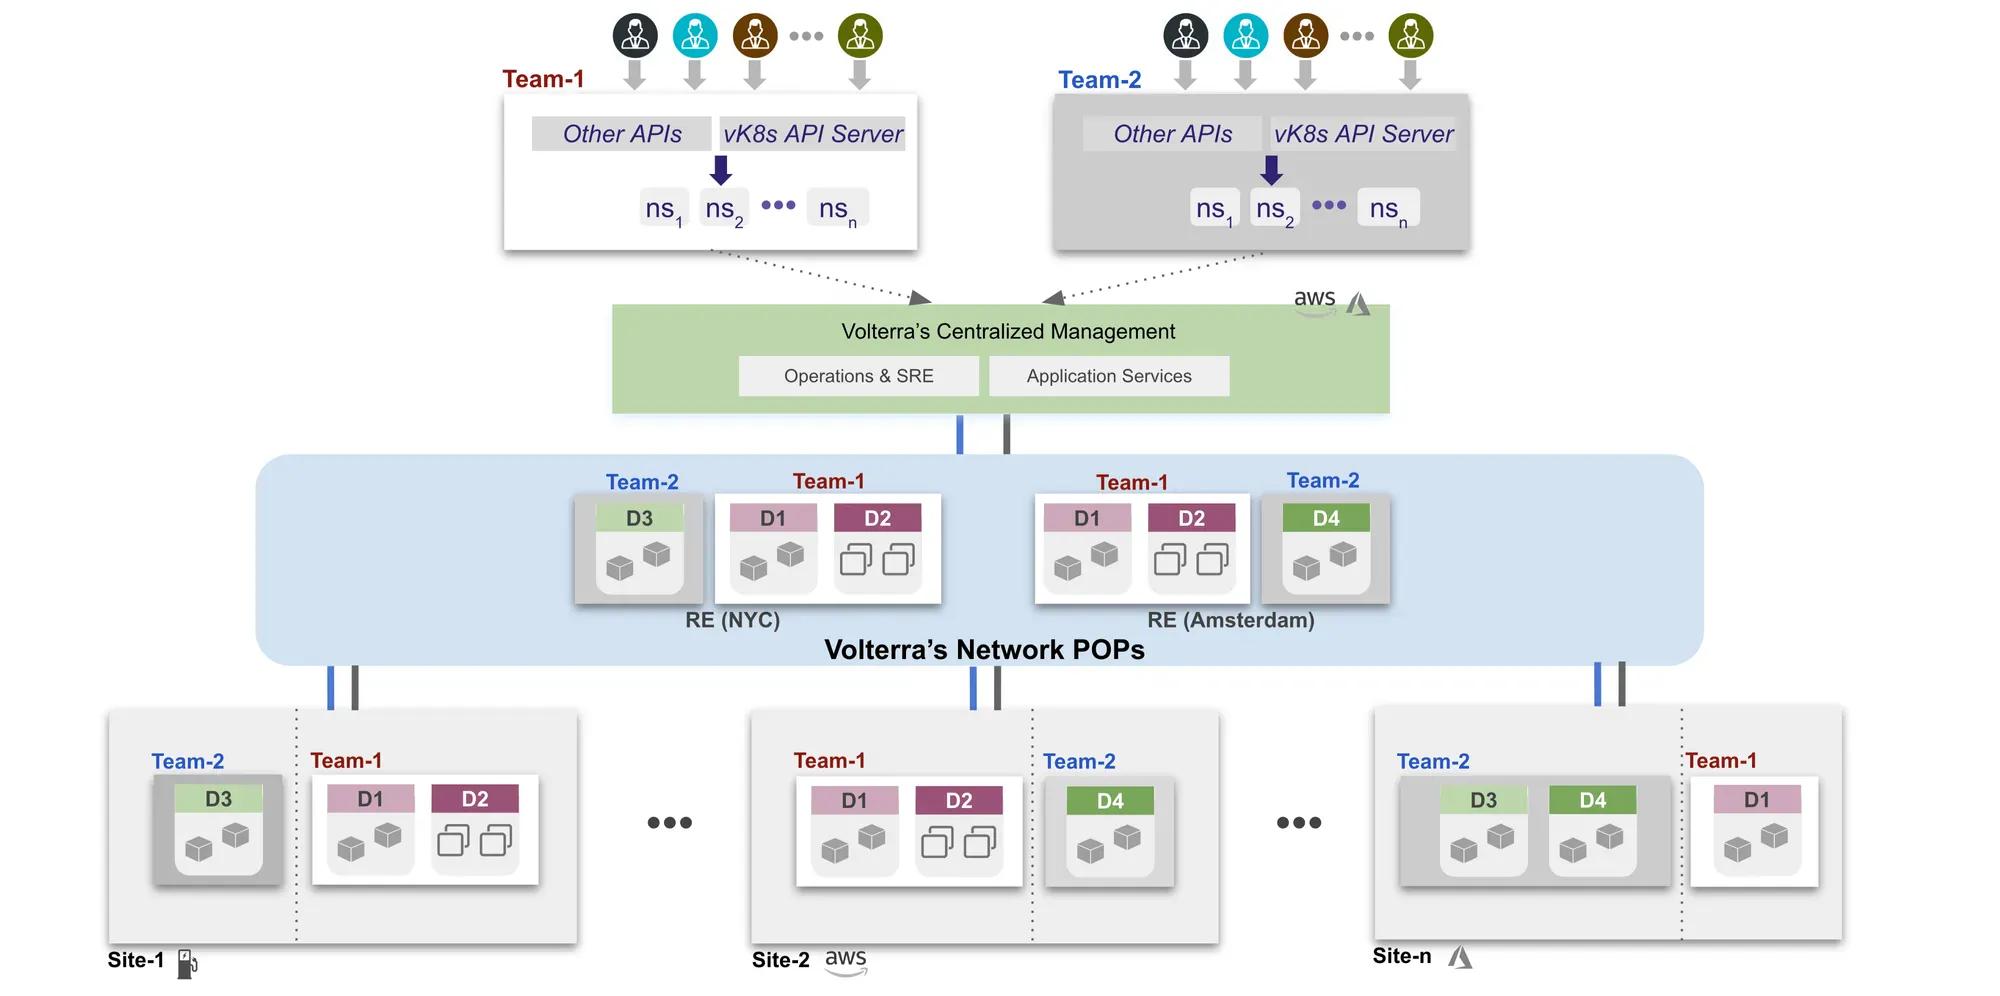
Cada uno de estos inquilinos puede crear numerosos espacios de nombres y asignar un grupo de usuarios para que colaboren en ellos. Estos espacios de nombres no son espacios de nombres de Kubernetes, sino que constituyen un límite de aislamiento en nuestra plataforma, con reglas de RBAC y políticas de IAM para los usuarios.
Cuando un usuario de un espacio de nombres quiere crear un clúster de aplicaciones, crea un objeto vK8s que, a su vez, crea un servidor de API de vK8s en nuestro plano de gestión. Mediante este objeto vK8s, el usuario puede crear despliegues, StatefulSets, PVC, etc., y el plano de control garantizará que estas operaciones se lleven a cabo en uno o varios clústeres físicos, en función de los sitios asociados al objeto vK8s.
Dado que cada inquilino y usuario utiliza operaciones estándar de K8s sin ninguna modificación, el sistema es compatible con diversas herramientas populares entre los operadores, como Spinnaker, Helm, Jenkins, etc.
Beneficios obtenidos de un plano de control distribuido
La gran ventaja de un plano de control distribuido es que ha eliminado la sobrecarga operativa de nuestros equipos de SRE y DevOps. Ahora pueden realizar operaciones (configuración, despliegue, supervisión, políticas, etc.) en un clúster virtual, y el plano de control las asignará automáticamente a varios clústeres físicos. Además de simplificar la gestión de varios clústeres, el plano de control también ha resuelto el problema de la seguridad y el aislamiento en entornos multiinquilino.
Este plano de control distribuido también ha mejorado la productividad de los desarrolladores que quieren añadir nuevas funcionalidades a nuestra plataforma: no tienen que crear nuevas automatizaciones cada vez que incorporan funcionalidades que afectan a la configuración o las operaciones en varios clústeres. Utilizan el modelo de configuración basado en intenciones y el plano de control sabe qué debe hacer. Además, pueden seguir interactuando con este objeto distribuido y compuesto por varios clústeres —kubernetes virtual— mediante kubectl, sin tener que utilizar otra CLI.
Tras utilizarlo durante más de un año en nuestros entornos de desarrollo y pruebas, preproducción y producción, nos dimos cuenta de que este plano de control distribuido globalmente (que se ejecuta en los puntos de presencia de nuestra red) también ofrece importantes ventajas en cuanto a escalabilidad, rendimiento y fiabilidad, algo que no habíamos llegado a imaginar del todo en nuestros inicios. Abordaremos este hallazgo en nuestra próxima presentación en KubeCon y en una entrada independiente del blog que publicaremos en las próximas semanas.
Continuará…
Esta serie de artículos abordará diversos aspectos de lo que supuso para nosotros crear y operar nuestro servicio SaaS distribuido globalmente, con numerosos clústeres de aplicaciones en la nube pública, nuestros PoP de red privada y ubicaciones en el extremo de la red. El próximo artículo será Malla de servicios global para aplicaciones distribuidas…
Sobre el autor
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.