Y la escala conduce a la velocidad. Y la velocidad conduce al éxito.
Supongamos que un ingeniero puede procesar una solicitud de cambio en dos horas. Supongamos que otro ingeniero puede procesar esa misma solicitud en 1,5 horas. Si trabajan juntos, ¿cuánto tardarán en procesar doscientas solicitudes de cambio?
Sí, la respuesta es obviamente cerveza.
Probablemente todo el mundo recuerde (con no poco miedo y aversión) los tristemente célebres problemas de matemáticas sobre «trenes» o «pintores», concebidos para enseñarnos las relaciones entre fracciones. En serio, esa era su finalidad, aunque muchos de nosotros lo que sacamos de ellos fue cierta aversión a pintar y a viajar en tren. Y un montón de memes. No nos olvidemos de los memes.
La cuestión es que este tipo de mediciones basadas en fórmulas se está convirtiendo en un requisito en el centro de datos, especialmente en la red. Esto se debe a que los presupuestos son limitados (lo sé, ¿verdad? ¡Qué locura!) y solo se puede contratar a X ingenieros para realizar Y trabajo. En un mundo de aplicaciones donde los ciclos de lanzamiento rápidos y frecuentes son la norma, el número de «X» que se puede contratar para garantizar lanzamientos puntuales es limitado.
Por eso, la escalabilidad es uno de los principales impulsores del «DevOps» en la red, también conocido como «NetOps». Al aplicar los principios operativos de DevOps a la red, se considera que NetOps puede alcanzar la escala operativa necesaria para que «X» ingenieros puedan realizar «Y» trabajo a tiempo y dentro de las limitaciones presupuestarias, incluso cuando la relación entre X e Y es exponencial (en términos sencillos: muy desproporcionada).
El problema de las solicitudes de cambio es real; lo planteó un ingeniero de redes que se enfrentaba a un número cada vez mayor de solicitudes de cambio (definidas como crear un punto de conexión de balanceador de carga para una aplicación, añadirlo al DNS y crear una regla de cortafuegos para permitir el acceso), lo que acabó amenazando con desbordar al personal disponible y, al mismo tiempo, aumentar el tiempo necesario para completarlas.
La solución se encontró, por supuesto, en la automatización, en la aplicación de los principios de DevOps y en la creación de una interfaz de autoservicio que permitía a otros ingenieros realizar solicitudes, que posteriormente se documentaban en el sistema de gestión de incidencias y se ejecutaban mediante diversas API de servicios de red y de aplicaciones.
Esta adopción de la automatización (y de la orquestación, porque también se está automatizando todo el proceso) no solo permite a los ingenieros actuales ampliar la capacidad operativa, sino que además ha hecho que el proceso sea más rápido. Ya no se tardan hasta dos horas en procesar una solicitud de cambio; ahora puede hacerse en tan solo cinco minutos.
Sí, has leído bien. Cinco minutos en lugar de hasta dos horas.
Se trata de una mejora significativa de la velocidad gracias a la capacidad de escalar mediante la automatización y la orquestación. Y, aunque no es un proyecto ambicioso que abarque «todo el centro de datos», sí resuelve un problema concreto que tanto los ingenieros como los responsables de las aplicaciones sufrían con frecuencia. En este caso, al parecer, hasta 200 veces por semana.
Así es exactamente como los equipos de operaciones de red deben abordar la automatización y la orquestación en la red de producción. Identificar aquellas tareas que son repetitivas y que el comité de revisión de cambios considera triviales (es decir, que se ha demostrado que no causan interrupciones y que la mayoría de los ingenieros pueden realizar con los ojos cerrados) puede brindar importantes oportunidades de escalabilidad y aportar la velocidad que, según nos indican tanto los responsables de negocio como los de las aplicaciones, debemos alcanzar en la red.
Identificar esas pequeñas tareas que pueden automatizarse con el menor riesgo de interrupción posible permite a los ingenieros centrarse en aquellas que aún no se consideran aptas para la automatización. Este enfoque también agiliza la implementación de otros servicios, ya que evita que dediquen una cantidad desproporcionada de tiempo a tareas más sencillas y repetitivas.
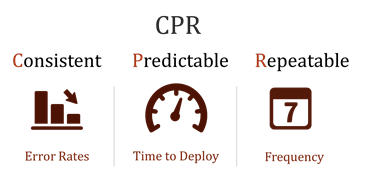
No puedo insistir lo suficiente en lo crucial que resulta adoptar un enfoque CPR para la automatización de redes: una automatización coherente, predecible y repetible permitirá escalar de forma más eficiente y agilizar los plazos de entrega, con un menor riesgo de interrupciones provocadas por errores. Esto supone aunar los modelos operativos conocidos como «modo 1» y «modo 2», en los que priman la fiabilidad y la estabilidad, pero sin renunciar a la agilidad. Al aplicar un enfoque CPR a la automatización y la orquestación de la red, las organizaciones pueden mejorar su agilidad con un riesgo mucho menor de comprometer la fiabilidad de una red encargada de prestar servicio a muchas otras aplicaciones (unas 200 de media, aproximadamente).
Las redes de los centros de datos están formadas por tecnologías heredadas y emergentes, a menudo conectadas entre sí mediante técnicas al más puro estilo MacGyver que requieren chicle e hilo de pescar. Estas redes deben admitir simultáneamente aplicaciones que llevan casi cincuenta años en producción (los mainframes aún existen) y aplicaciones emergentes creadas con tecnologías que apenas acaban de salir de la cuna (como los contenedores). Deben ofrecer todas las aplicaciones, y hacerlo de forma fiable y segura. Estos estándares no pueden dejarse de lado en favor de la velocidad y la frecuencia que exigen las aplicaciones más nuevas y atractivas.
Pero el equipo de operaciones de red puede lograr un equilibrio que permita que ambos coexistan si logra identificar y, posteriormente, automatizar al máximo aquellas tareas y opciones de prestación de servicios que no causen interrupciones y que el control de cambios y otros responsables de aprobación consideren meros trámites.
Al fin y al cabo, nuestra ecuación favorita para calcular el tiempo necesario para pintar una casa cambia radicalmente cuando los pintores disponen de rodillos automáticos en lugar de brochas manuales.
No te preocupes tanto por cambiar la red; cambia la ecuación.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.