Pídele a un arquitecto de telecomunicaciones que dibuje un clúster de IA y obtendrás bastidores, GPU, la red de interconexión, el almacenamiento, todo. Pídele que dibuje cómo llega una solicitud a ese clúster y se quedará con el bolígrafo en el aire. El tráfico simplemente llega. Aparece a las puertas del clúster y, a partir de ahí, este se encarga de todo.
Ese punto ciego está a punto de salir caro. En la inferencia distribuida, esa carencia puede traducirse en GPU inactivas en una ubicación y colas saturadas en otra. Un proveedor de servicios con 50 instalaciones repartidas por todo un país dispone de algo que un hiperescalador con solo dos no puede comprar: proximidad a los usuarios, diversidad de fuentes de energía, presencia soberana y fibra ya desplegada.
Ese es el argumento más sólido a favor de la inferencia distribuida: servir modelos desde una red de ubicaciones en lugar de hacerlo desde una sola. Pero 50 ubicaciones solo se convierten en un único servicio de inferencia si algo decide, para cada solicitud, cuál de las 50 debe responder. Hoy en día, nada lo hace. Esa es la carencia que F5 está subsanando junto con NVIDIA, AMD y otros proveedores de infraestructura de IA, para que la decisión se base en la telemetría de los aceleradores y las pilas de inferencia que los proveedores de servicios utilizan realmente.
El tráfico no llega por arte de magia
Esto es lo que ocurre en realidad. Una consulta DNS selecciona un sitio. Un balanceador de carga global de servidores evalúa la proximidad, el estado y la capacidad, y devuelve una dirección. Dentro del sitio, un proxy finaliza la conexión, comprueba quién realiza la solicitud, aplica las políticas y un balanceador de carga selecciona un servidor. Esta cadena se denomina enrutamiento basado en el conocimiento de las aplicaciones. Durante dos décadas, ha sustentado discretamente todos los servicios web y móviles, y F5 ha desarrollado gran parte de ella.
La cadena sigue funcionando para la IA. El problema es que toma sus decisiones basándose en criterios equivocados. El balanceador global de carga de servidores (GSLB) sabe qué centro está más cerca y cuál está operativo. No sabe qué centro tiene cargado el modelo, si sus GPU están saturadas ni si la solicitud corresponde a una interacción de voz que no puede atravesar el país o a una tarea agéntica de larga duración que puede ejecutarse allí donde la capacidad sea más barata. Por eso elige el centro operativo más cercano, que puede estar funcionando al límite mientras un clúster idéntico situado a 200 kilómetros está medio vacío.
Del enrutamiento consciente de las aplicaciones al enrutamiento consciente de la IA
El salto consiste en lo siguiente: el enrutamiento basado en el conocimiento de las aplicaciones debe pasar a tener en cuenta las aplicaciones de IA. La misma cadena, el mismo DNS y los mismos proxies. Dos nuevas entradas.
La primera es la telemetría procedente del interior de la infraestructura de IA. Cada clúster sabe qué modelos está sirviendo, la profundidad de sus colas, cuánta caché KV está en uso, cuántas solicitudes están en curso y cuánto tendrá que esperar una nueva solicitud hasta recibir su primer token. F5 BIG-IP Next for Kubernetes ya se encuentra en el punto de entrada de esos clústeres y tiene visibilidad de todo ello, incluso del número de tokens por solicitud. Al enviar esa información a un nivel superior, las soluciones DNS de F5 dejan de mantener un mapa de dónde se encuentran los sitios y pasan a ofrecer una imagen en tiempo real de lo que cada sitio puede hacer en ese preciso momento.
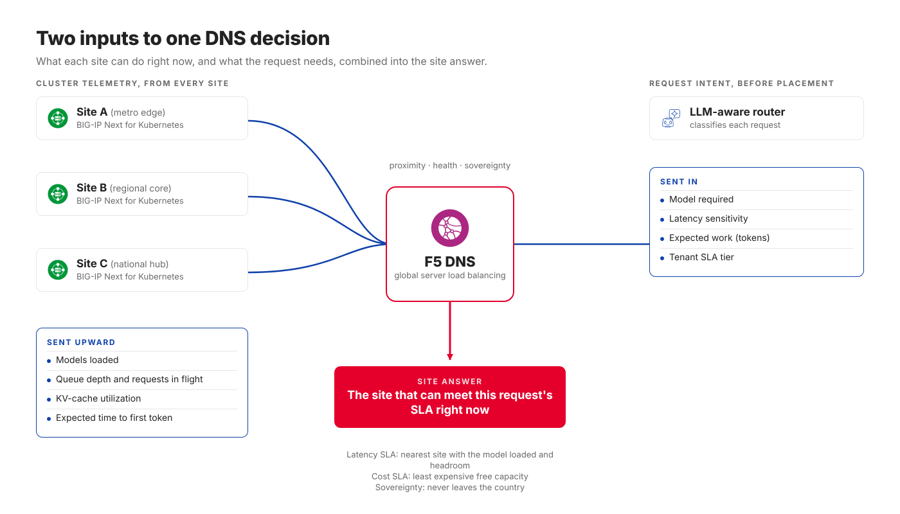
El segundo es la intención de la solicitud. Un enrutador compatible con LLM puede clasificar una solicitud antes de dirigirla: qué modelo necesita, hasta qué punto es sensible a la latencia, cuánto trabajo supone aproximadamente y qué nivel de SLA está pagando el cliente. Esa intención pasa a ser un dato de entrada para la respuesta DNS, en lugar de algo que se descubre después de que la solicitud haya llegado al lugar equivocado.
Al combinar ambos elementos, un acuerdo de nivel de servicio (SLA) deja de ser un párrafo de un contrato y se convierte en una regla de enrutamiento. Un SLA de latencia dirige la solicitud al sitio más cercano que tenga el modelo cargado y capacidad de sobra. Un SLA de costes la dirige a la capacidad disponible más económica. Un requisito de soberanía garantiza que nunca salga del país. El GSLB toma la decisión que siempre pudo tomar, pero ahora con la información de la que nunca había dispuesto.
Tres niveles de decisión, una sola respuesta
La ubicación no es una única decisión, sino tres decisiones anidadas entre sí.
- A escala global, las soluciones DNS de F5 eligen el centro o la fábrica de IA basándose ahora tanto en la telemetría de inferencia en tiempo real y la intención de la solicitud como en la proximidad, el estado y la soberanía.
- A nivel regional, la solicitud se dirige a un clúster que dispone del modelo adecuado y de capacidad disponible, y atraviesa un perímetro de seguridad específico del inquilino que garantiza el aislamiento antes de acceder a cualquier GPU.
- A nivel local, dentro del clúster, BIG-IP Next for Kubernetes aplica las políticas de identidad, acceso y tráfico, y Endpoint Picker selecciona el nodo de trabajo.
En ese último nivel, el enrutamiento deja de ser una mera vía de acceso a la GPU y pasa a formar parte del rendimiento de la inferencia. Cuando un motor procesa un prompt, la fase de prefill llena la caché KV de la GPU. Si la siguiente solicitud comparte ese prefijo y se dirige a un worker que aún lo conserva, se reutiliza el trabajo realizado. Si se dirige a cualquier otro, la GPU vuelve a calcularlo. Con poca carga, nadie lo nota. Con la concurrencia propia de un entorno de producción, el conjunto de trabajo supera la capacidad de la caché y la asignación empieza a determinar si el trabajo se reutiliza o se vuelve a realizar.
Con BIG-IP Next for Kubernetes 2.4, Endpoint Picker tiene en cuenta el prefijo almacenado en caché, la profundidad de la cola, las solicitudes en curso, el uso de la caché KV y el tiempo estimado hasta el primer token antes de elegir un nodo de procesamiento. Admite la desagregación de las fases de prefill y decode, así como tecnologías de inferencia abiertas como llm-d y Kubernetes Gateway API Inference Extension. Lo importante es que los tres niveles comparten el contexto. Un sitio elegido por su capacidad no deriva la solicitud a un clúster saturado. Un clúster elegido para un modelo no envía la solicitud a un nodo de procesamiento que tenga que reconstruir su contexto desde cero.
La red que sabe lo que saben las GPU
Nada de esto requiere una nueva plataforma adicional a la infraestructura de IA. La capa de direccionamiento global ya existe. La inteligencia a nivel de clúster también existe y actualmente está en producción para clientes de F5. El trabajo que se está llevando a cabo ahora consiste en conectar estos elementos para que la telemetría del clúster y la intención de la solicitud sirvan de base para una única decisión de DNS.
Volvamos, pues, al arquitecto con el bolígrafo en la mano. Cincuenta centros de datos sí superan a dos para la inferencia de IA, pero solo si la red que los conecta sabe lo que saben las GPU. Así, los 50 emplazamientos dejan de ser 50 islas de capacidad y se comportan como un único servicio de inferencia capaz de cumplir un SLA, respetar una frontera y aprovechar todas las GPU que ya se han pagado.
Considere esto un avance. Próximamente llegará el reportaje completo, en el que explicaremos cómo se ha creado, qué herramientas se han utilizado y qué resultados se han obtenido.
Descubre cómo F5 ayuda a las organizaciones a mejorar la inferencia distribuida, la gestión del tráfico de IA y el aprovechamiento de las GPU en las infraestructuras modernas de IA.
Sobre el autor
.jpg)
Artículos relacionados del blog
El imperativo empresarial de la IA en un mundo de nube híbrida y multinube
Cómo la IA redefine los patrones de tráfico, el riesgo de las API y el cumplimiento normativo, y por qué el paquete Distributed Cloud Services Enterprise ofrece la profundidad necesaria en entornos híbridos multicloud.
STIG de F5 NGINX: un plan de seguridad para el sector público y los entornos regulados
Descubra cómo las STIG de F5 NGINX proporcionan un modelo de seguridad para el Departamento de Defensa de EE. UU. y los entornos regulados, ayudándole a cumplir la normativa mientras crea una infraestructura sólida de confianza cero con mayor visibilidad y resiliencia.

Cómo el marco AEGIS de Forrester valida un enfoque centrado en la inferencia
El auge de la IA agéntica está transformando el panorama de la seguridad empresarial. Estos agentes de IA autodirigidos funcionan de forma autónoma, toman decisiones en tiempo real y pueden interactuar entre distintos sistemas de maneras para las que las arquitecturas tradicionales de ciberseguridad no fueron diseñadas. Aunque esto abre nuevas posibilidades, también introduce riesgos sistémicos: fallos en cascada, secuestro de objetivos y superficies de ataque hasta ahora invisibles. El reciente […] de Forrester
La nueva superficie de riesgo de la IA: invisible, autónoma y ya está dentro
James White, vicepresidente de Ingeniería de F5 A mediados de 2025, es un buen momento para hacer balance de la adopción de la IA en las empresas y del estado de la seguridad de la IA. El uso de la IA generativa ya es habitual en las empresas En general, las empresas cuentan al menos con unos conocimientos básicos sobre la IA generativa. Entienden qué es y dónde puede […]
Protegiendo el futuro: cómo CalypsoAI se alinea con el Top 10 de OWASP para los LLM
Cuando OWASP publicó su Top 10 de 2025 para grandes modelos de lenguaje (LLM), proporcionó al sector un referente de seguridad muy necesario. Pero los referentes no sirven de nada si no se actúa. CalypsoAI aborda el 80 % del Top 10 de OWASP, dando prioridad a los riesgos reales más urgentes. La plataforma combina protección en tiempo real durante la ejecución y pruebas adversariales exhaustivas, ofreciendo una cobertura inigualable frente a las […]
Implementación de LLM en la empresa: mediante una API local
Por sí solos, sin medidas de protección ni protocolos adicionales de seguridad para la IA, el despliegue de modelos de IA generativa —en particular, modelos de lenguaje de gran tamaño (LLM)— en toda la empresa supone una oportunidad de alto riesgo y grandes beneficios para cualquier organización. Sin embargo, determinar exactamente cómo debe dar su organización este gran paso hacia el ámbito de la IA generativa requiere una planificación minuciosa. Quizá […]